 You know maize mean?
Arbitrary Style Transfer in Real-time with Adaptive Instance Normalization
0. Summary
기본 정보 : ArXiv,2017.03.20 (ICCV 2017), Arbitrary Style Transfer in Real-time with Adaptive Instance Normalization
연구 배경
Gatys et al.의 신경망 스타일 변환은 임의의 스타일을 다룰 수 있지만 이미지마다 느린 최적화가 필요하고, Johnson·Ulyanov 류의 피드포워드 방법은 실시간이지만 네트워크 하나가 스타일 하나(또는 Dumoulin et al.의 조건부 인스턴스 정규화로 32개)에 묶여 있었다. 즉 속도·유연성·품질 세 가지를 동시에 만족하는 방법이 없었다. 한편 Ulyanov et al.이 피드포워드 스타일 변환에서 배치 정규화(BN)를 인스턴스 정규화(IN)로 바꾸기만 해도 결과가 크게 좋아진다고 보고했지만, 왜 IN이 효과적인지는 설명되지 않은 채였다. “IN이 콘텐츠 이미지의 대비(contrast)에 불변하게 만든다”는 추측이 있었을 뿐이다.
제안 방법
논문은 먼저 IN의 효과를 실험으로 재해석한다. IN은 대비 정규화가 아니라 스타일 정규화를 수행하며, 특징 맵의 채널별 평균과 분산 같은 아핀 통계가 곧 이미지의 스타일을 담고 있다는 것이다. 이 관점에서 적응형 인스턴스 정규화(Adaptive Instance Normalization, AdaIN) 를 제안한다. AdaIN은 학습 가능한 아핀 파라미터 없이, 콘텐츠 특징 $x$ 를 정규화한 뒤 스타일 특징 $y$ 의 채널별 표준편차와 평균으로 스케일·시프트한다(Eq. 8). 전체 네트워크는 고정된 VGG-19 인코더(relu4_1까지), AdaIN 층, 학습되는 디코더로 구성되며, 디코더는 AdaIN 출력 $t$ 를 이미지로 되돌리도록 학습된다. 손실은 AdaIN 출력 $t$ 를 목표로 하는 콘텐츠 손실(Eq. 12)과, Gram 행렬 대신 VGG 여러 층의 채널별 평균·표준편차 차이로 정의한 스타일 손실(Eq. 13)의 가중합이다.
발견 사실
AdaIN은 학습 중 본 적 없는 임의의 스타일·콘텐츠 쌍에 대해 256×256 이미지를 0.018초(약 56 FPS), 512×512를 0.065초(약 15 FPS)에 변환했다(Table 1, Pascal Titan X). 이는 단일 스타일 피드포워드 방법(0.011초)과 같은 자릿수이고, 역시 임의 스타일을 지원하는 Chen & Schmidt의 패치 교환 방식(0.171초, 512에서 3.214초)보다 훨씬 빠르며, Gatys 최적화(14.17초)보다 세 자릿수 빠르다. 콘텐츠·스타일 손실은 Ulyanov의 단일 스타일 네트워크보다 약간 높지만 비슷했고, 스타일 손실은 Gatys 최적화의 50~100회 반복 수준과 비슷했다(Figure 3). Figure 1 실험에서 IN의 BN 대비 우위는 콘텐츠 이미지의 대비를 정규화해도 그대로 유지되었지만, 스타일을 미리 정규화한 데이터에서는 크게 줄어들어 IN이 스타일 정규화를 수행한다는 해석을 뒷받침했다. 디코더에 BN이나 IN을 넣거나 AdaIN 대신 특징 연결(concat)을 쓰면 결과가 나빠졌다(Figure 5, 6).
핵심 기여
- IN에 대한 새로운 해석 : 인스턴스 정규화는 대비 정규화가 아니라 스타일 정규화이며, 특징 통계(채널별 평균·분산)가 스타일을 담는다는 것을 통제 실험(Figure 1)으로 보였다.
- AdaIN 층 : 학습 파라미터 없이 스타일 특징의 통계를 콘텐츠 특징에 옮기는 한 줄짜리 연산으로, 피드포워드 네트워크가 임의의 스타일을 실시간으로 처리할 수 있게 했다.
- 유연한 런타임 제어 : 학습을 다시 하지 않고도 콘텐츠-스타일 절충(Eq. 14), 다중 스타일 보간(Eq. 15), 색 보존, 공간별 스타일 적용이 가능함을 보였다. AdaIN은 이후 StyleGAN의 스타일 주입 메커니즘으로 채택되었다.
관련 개념
정규화 층의 계보: BN → IN → CIN
스타일 변환에서 정규화 층은 단순한 학습 안정화 장치가 아니라 스타일 정보가 통과하는 길목입니다. 이 논문은 Section 3에서 배치 정규화, 인스턴스 정규화, 조건부 인스턴스 정규화를 같은 기호로 정리하고, 그 차이가 어디서 오는지 짚습니다.
📐 1. 세 정규화의 정의 (Eq. 1–7)
입력 배치 $x\in\mathbb{R}^{N\times C\times H\times W}$ 에 대해 세 방법 모두 같은 꼴의 아핀 변환을 씁니다.
\[\text{Norm}(x)=\gamma\left(\frac{x-\mu(x)}{\sigma(x)}\right)+\beta\]| 방법 | $\mu,\sigma$ 계산 축 | 아핀 파라미터 | 추론 시 |
|---|---|---|---|
| BN (Eq. 1–3) | 채널별, 배치와 공간 $(N,H,W)$ 에 대해 | $\gamma,\beta\in\mathbb{R}^C$ | 모집단 통계로 대체 |
| IN (Eq. 4–6) | 채널별·샘플별, 공간 $(H,W)$ 에 대해서만 | $\gamma,\beta\in\mathbb{R}^C$ | 학습과 동일하게 적용 |
| CIN (Eq. 7) | IN과 동일 | 스타일 $s$ 마다 $\gamma^s,\beta^s$ | 스타일 인덱스로 선택 |
IN의 통계는
\[\mu_{nc}(x)=\frac{1}{HW}\sum_{h,w}x_{nchw},\qquad \sigma_{nc}(x)=\sqrt{\frac{1}{HW}\sum_{h,w}\big(x_{nchw}-\mu_{nc}(x)\big)^2+\epsilon}\]로, 이미지 한 장의 채널 하나가 독립적으로 정규화됩니다.
🔍 2. CIN의 발견과 한계
Dumoulin et al.(2017)의 CIN은 합성곱 가중치는 공유하고 $(\gamma^s,\beta^s)$ 만 스타일별로 두어 네트워크 하나로 32개 스타일을 학습했습니다. 이 결과는 스타일 간 차이가 정규화 층의 아핀 파라미터만으로 표현된다는 놀라운 사실을 보여줍니다. 그러나 추가 파라미터가 $2FS$ ($F$ = 특징 맵 수, $S$ = 스타일 수)로 스타일 수에 비례하고, 새 스타일마다 재학습이 필요해 임의 스타일로 확장되지 않습니다.
🧭 3. 이 논문의 질문
CIN이 “스타일은 $(\gamma,\beta)$ 에 있다”는 것을 보였다면, 다음 질문은 자연스럽습니다. $(\gamma,\beta)$ 를 학습하지 않고 스타일 이미지에서 직접 계산할 수는 없는가? 그 답이 가능하려면 먼저 IN이 하는 일이 정확히 무엇인지 알아야 합니다. Section 4가 그 분석입니다.
💡 Key Takeaway BN, IN, CIN은 같은 아핀 변환의 통계 계산 축과 파라미터 공유 방식만 다릅니다. CIN이 “스타일 = 아핀 파라미터”임을 보였고, AdaIN은 그 파라미터를 학습 대신 계산으로 바꾸려 합니다.
인스턴스 정규화는 스타일 정규화다
Section 4는 이 논문의 이론적 기여에 해당합니다. “IN이 왜 스타일 변환에 효과적인가”라는 질문에 대해 기존 가설을 반박하고 새 가설을 제시하는 통제 실험을 설계했습니다.
🧪 1. 기존 가설과 실험 설계 (Figure 1)
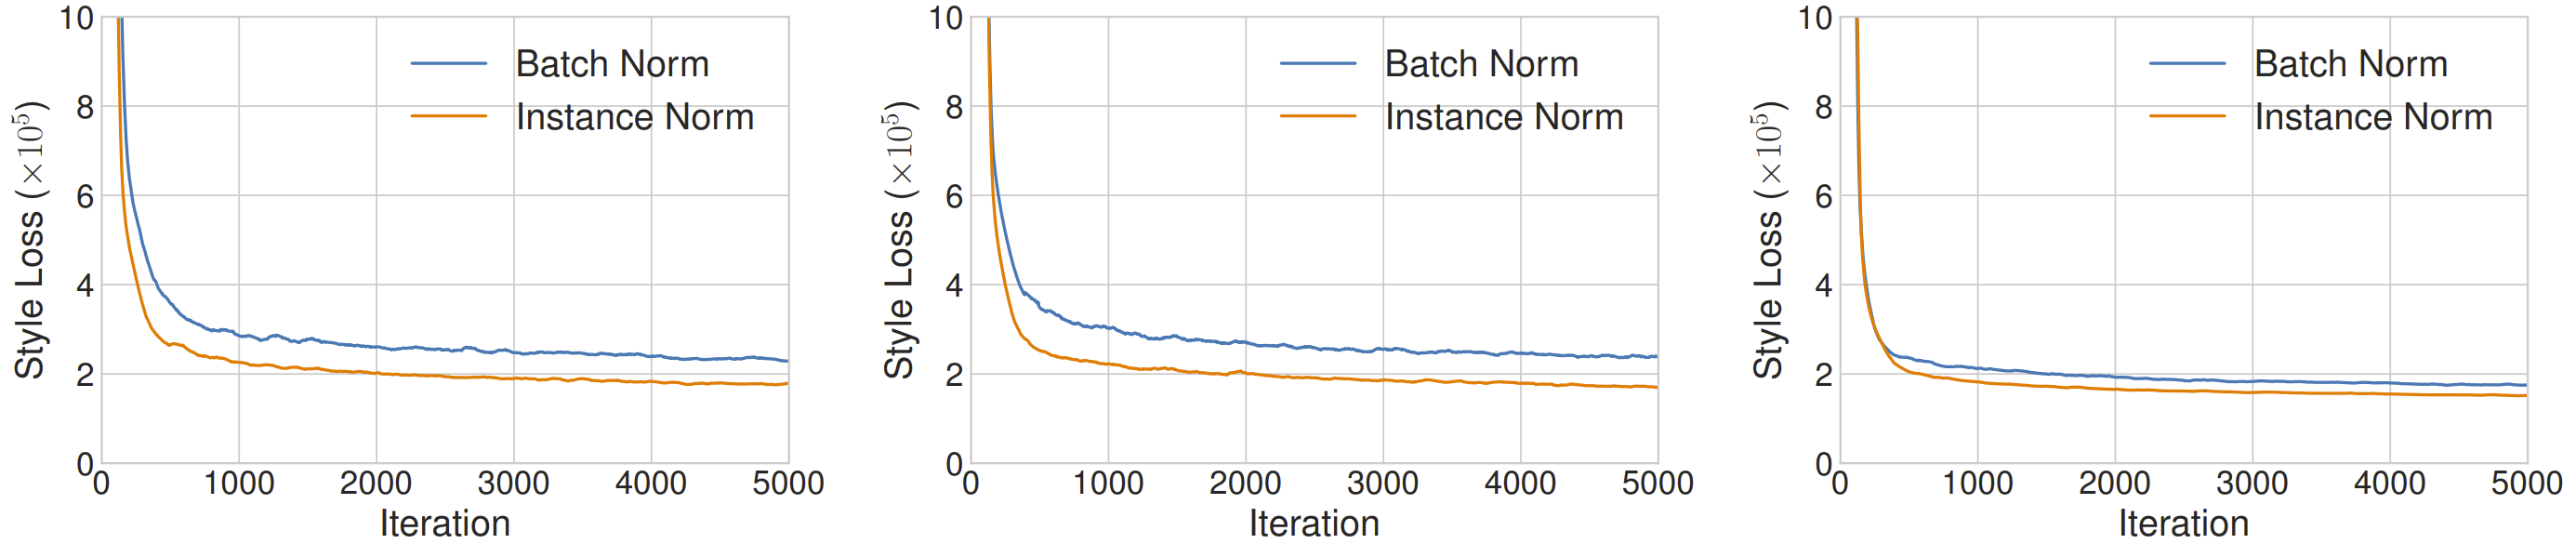
Ulyanov et al.은 IN이 콘텐츠 이미지의 대비(contrast) 에 불변하게 만들어 효과적이라고 추측했습니다. 저자들은 이를 검증하기 위해 세 종류의 학습 데이터로 IN 네트워크와 BN 네트워크를 각각 학습하고 스타일 손실 곡선을 비교했습니다.
| 학습 데이터 | 조작 | 대비 가설의 예측 | 스타일 가설의 예측 |
|---|---|---|---|
| (a) 원본 | 없음 | IN 우위 | IN 우위 |
| (b) 대비 정규화 | 모든 콘텐츠 이미지의 밝기 채널을 히스토그램 평활화 | IN 우위 사라짐 | IN 우위 유지 |
| (c) 스타일 정규화 | 모든 콘텐츠 이미지를 Gatys 방법으로 같은 스타일로 변환 | IN 우위 유지 | IN 우위 사라짐 |
📊 2. 결과와 해석
- (b) 대비 정규화에서도 IN의 우위가 그대로 남았습니다. 대비 불변성은 IN의 효과를 설명하지 못합니다.
- (c) 스타일 정규화에서는 IN과 BN의 차이가 크게 줄었습니다. 입력의 스타일이 이미 통일되어 있으면 IN이 할 일이 없어진 것입니다.
따라서 저자들은 IN이 각 샘플의 스타일을 정규화하며, 그 스타일은 특징 맵의 채널별 평균·분산 같은 아핀 통계에 담겨 있다고 결론짓습니다. 이 해석은 Gatys et al.의 Gram 행렬과 Li et al.(2017)이 보인 “Gram 행렬 매칭 = 특징 분포의 MMD 최소화” 사이의 연결과도 맞물립니다. 평균과 분산을 맞추는 것은 그 분포 매칭의 1·2차 모멘트 버전입니다.
🎯 3. 왜 BN보다 IN이 학습에 유리한가
BN은 배치 전체를 하나의 통계로 정규화하므로 배치 안의 이미지들이 서로 다른 스타일을 갖더라도 “중심 스타일” 하나로만 정규화됩니다. 각 이미지는 여전히 자신의 스타일을 일부 갖고 있어 네트워크가 이를 목표 스타일로 바꾸는 일을 떠안습니다. 반면 IN은 샘플마다 스타일을 지운 뒤 아핀 파라미터로 목표 스타일을 입히므로, 네트워크의 나머지 부분은 콘텐츠 조작에만 집중할 수 있습니다. 추론 시 BN이 모집단 통계로 바뀌는 것도 불일치를 만듭니다.
💡 Key Takeaway IN의 역할은 스타일 지우기입니다. 그렇다면 지운 자리에 아핀 파라미터로 입히는 것도 스타일이고, 그 파라미터를 스타일 이미지의 통계로 직접 채우면 임의 스타일 변환이 됩니다. 이것이 AdaIN의 논리입니다.
적응형 인스턴스 정규화(AdaIN)
AdaIN 은 IN의 아핀 파라미터 $\gamma,\beta$ 를 학습하는 대신 스타일 입력 $y$ 의 통계로 대체한 층입니다(Section 5). 학습 파라미터가 하나도 없으며, 콘텐츠 특징 $x$ 와 스타일 특징 $y$ 를 받아 “$x$ 의 내용에 $y$ 의 스타일을 입힌 특징”을 냅니다.
🧮 1. 정의 (Eq. 8)
\[\text{AdaIN}(x,y)=\sigma(y)\left(\frac{x-\mu(x)}{\sigma(x)}\right)+\mu(y)\]| 단계 | 연산 | 의미 |
|---|---|---|
| 1 | $\dfrac{x-\mu(x)}{\sigma(x)}$ | 콘텐츠 특징을 채널별·샘플별로 정규화 → 콘텐츠의 스타일을 지움 |
| 2 | $\times\,\sigma(y)$ | 스타일 특징의 채널별 표준편차로 스케일 |
| 3 | $+\,\mu(y)$ | 스타일 특징의 채널별 평균으로 시프트 → 스타일을 입힘 |
$\mu(\cdot),\sigma(\cdot)$ 는 IN과 같이 공간 축에 대해 계산합니다. 직관적으로, 특정 종류의 붓터치를 감지하는 채널이 있다면 그 채널의 평균 활성값은 붓터치가 얼마나 많은가를, 분산은 붓터치의 강약 변화를 반영합니다. AdaIN은 이 두 통계를 스타일 이미지에 맞춥니다.
🆚 2. CIN·IN과의 비교
| 항목 | IN | CIN | AdaIN |
|---|---|---|---|
| $\gamma,\beta$ 의 출처 | 학습 | 스타일별 학습 | 스타일 특징에서 계산 |
| 학습 파라미터 | $2F$ | $2FS$ | 0 |
| 지원 스타일 | 1 | $S$ (고정) | 임의 |
| 새 스타일 추가 | 재학습 | $(\gamma,\beta)$ 미세조정 | 불필요 |
🔗 3. 특징 통계 전이의 다른 형태들
AdaIN은 채널별 평균·분산만 맞추지만, 같은 “특징 통계 전이” 계열에 더 풍부한 방법들이 있습니다.
- Gram 행렬 / 2차 통계: Gatys et al.의 원래 손실. 채널 간 상관까지 포함합니다.
- Chen & Schmidt의 패치 교환(style swap): 콘텐츠 특징의 각 패치를 가장 가까운 스타일 패치로 교체. 국소 구조까지 옮기지만 패치 검색이 느립니다.
- WCT(Li et al., 2017): 백색화(whitening)와 채색(coloring) 변환으로 공분산 전체를 맞춥니다. AdaIN 직후에 나온 방법입니다.
AdaIN은 이 중 가장 단순하고 빠른 1·2차 모멘트 매칭이며, 저자들도 상관 정렬이나 히스토그램 매칭 같은 고차 통계 전이를 미래 과제로 남깁니다.
💡 Key Takeaway AdaIN은 “콘텐츠 특징을 정규화하고 스타일 통계로 되돌리기” 라는 한 줄짜리 연산입니다. 파라미터가 없기 때문에 어떤 스타일에도 즉시 적용되고, 그래서 임의 스타일과 실시간이 동시에 가능해집니다.
네트워크 구조와 학습
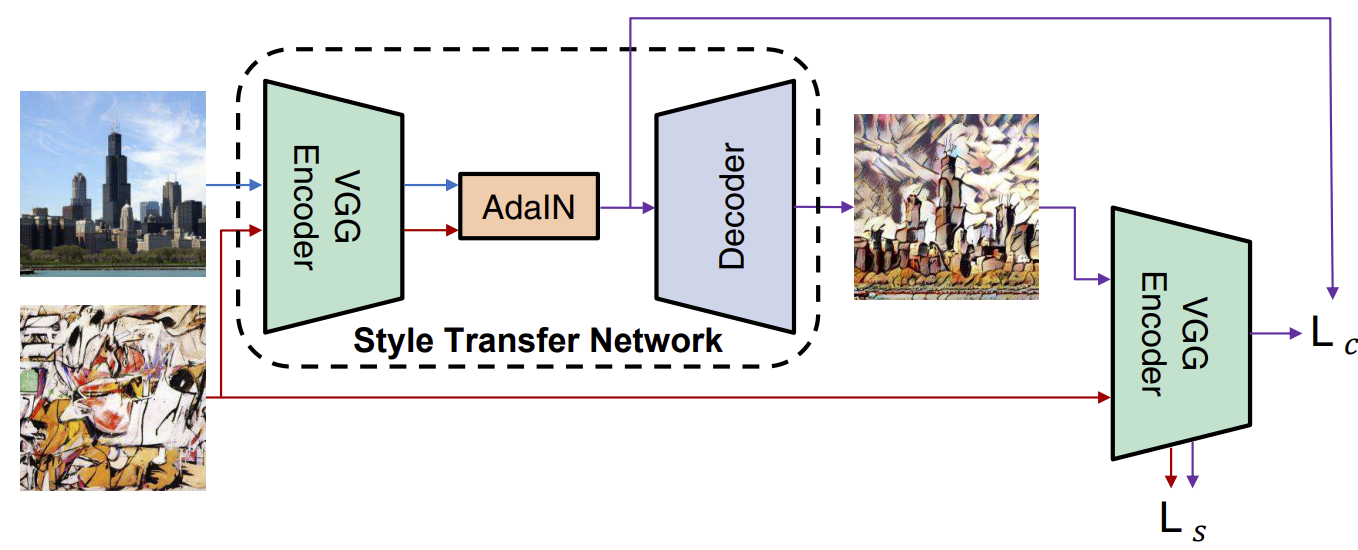
AdaIN 자체에는 학습할 것이 없으므로, 학습 대상은 AdaIN 출력 특징을 이미지로 되돌리는 디코더뿐입니다(Section 6). 구조는 Figure 2에 요약되어 있습니다.
🏗️ 1. 인코더–AdaIN–디코더 (Eq. 9, 10, Figure 2)
| 구성 | 세부 |
|---|---|
| 인코더 $f$ | 고정된 사전 학습 VGG-19, relu4_1까지 |
| AdaIN | $t=\text{AdaIN}\big(f(c),f(s)\big)$ (Eq. 9) |
| 디코더 $g$ | $T(c,s)=g(t)$ (Eq. 10). 인코더를 대략 거울상으로 뒤집은 구조, 풀링 대신 nearest 업샘플링, 경계 아티팩트를 피하기 위해 reflection padding |
| 디코더의 정규화 | 없음 (이유는 아래 ablation 참고) |
콘텐츠 이미지 $c$ 와 스타일 이미지 $s$ 를 같은 인코더에 통과시킨 뒤 AdaIN으로 통계를 맞추고, 디코더가 그 특징을 이미지 공간으로 되돌립니다.
🧮 2. 손실 함수 (Eq. 11–13)
\[\mathcal{L}=\mathcal{L}_c+\lambda\mathcal{L}_s\]콘텐츠 손실 (Eq. 12): 출력 이미지를 다시 인코딩한 특징과 AdaIN 출력 $t$ 사이의 유클리드 거리입니다.
\[\mathcal{L}_c=\big\|f(g(t))-t\big\|_2\]일반적인 콘텐츠 이미지 특징 $f(c)$ 가 아니라 $t$ 를 목표로 삼는 이유는, 디코더의 목표가 “AdaIN 출력을 뒤집는 것”이기 때문이며 수렴도 약간 빨랐다고 합니다.
스타일 손실 (Eq. 13): Gram 행렬 대신 VGG 여러 층의 채널별 평균·표준편차 차이를 씁니다.
\[\mathcal{L}_s=\sum_{i=1}^{L}\big\|\mu(\phi_i(g(t)))-\mu(\phi_i(s))\big\|_2+\sum_{i=1}^{L}\big\|\sigma(\phi_i(g(t)))-\sigma(\phi_i(s))\big\|_2\]$\phi_i$ 는 relu1_1, relu2_1, relu3_1, relu4_1 이며 가중치는 동일합니다. 이 손실은 AdaIN이 맞추는 통계와 정확히 같은 종류이므로 설계가 일관됩니다. Gram 행렬 손실로도 비슷한 결과가 나온다고 저자들은 적습니다.
⚙️ 3. 학습 설정 (Section 6.2)
| 항목 | 값 |
|---|---|
| 콘텐츠 데이터 | MS-COCO 약 80,000장 |
| 스타일 데이터 | WikiArt 회화 약 80,000장 |
| 최적화 | Adam, 배치 8 (콘텐츠-스타일 쌍) |
| 전처리 | 짧은 변이 512가 되도록 리사이즈 후 256×256 무작위 크롭 |
| 테스트 | 완전 합성곱이므로 임의 크기 입력 가능 |
학습 중 스타일 이미지가 80,000장이나 되므로 네트워크는 특정 스타일을 암기하지 못하고 “임의의 스타일 통계를 이미지로 되돌리는 법” 을 배우게 됩니다. 이것이 미지의 스타일로 일반화되는 이유입니다.
💡 Key Takeaway 학습되는 것은 디코더뿐이고, 그 디코더는 특정 스타일이 아니라 “AdaIN 통계 → 이미지” 라는 역변환을 배웁니다. 스타일 손실도 같은 통계로 정의해 목표와 메커니즘이 일치합니다.
실험: 속도·품질·설계 선택의 검증
Section 7은 정성 비교, 정량 손실 비교, 속도 비교, 그리고 디코더와 AdaIN 설계에 대한 ablation으로 구성됩니다. 모든 평가 스타일과 콘텐츠는 학습에 쓰이지 않은 것입니다.
⏱️ 1. 속도 비교 (Table 1)
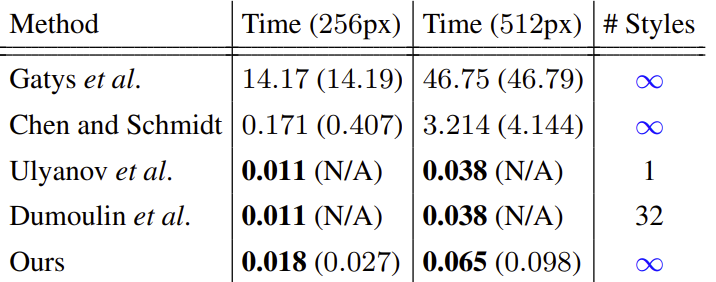
Pascal Titan X에서 100장 평균, 초/장. 괄호는 스타일 인코딩 시간 포함.
| 방법 | 256×256 | 512×512 | 스타일 수 |
|---|---|---|---|
| Gatys et al. (최적화) | 14.17 (14.19) | 46.75 (46.79) | ∞ |
| Chen & Schmidt (패치 교환) | 0.171 (0.407) | 3.214 (4.144) | ∞ |
| Ulyanov et al. | 0.011 | 0.038 | 1 |
| Dumoulin et al. (CIN) | 0.011 | 0.038 | 32 |
| AdaIN | 0.018 (0.027) | 0.065 (0.098) | ∞ |
256에서 약 56 FPS, 512에서 약 15 FPS입니다. 단일 스타일 방법보다 느린 이유는 VGG 기반 인코더가 더 크기 때문이며, 같은 “임의 스타일” 방법인 Chen & Schmidt보다는 한두 자릿수 빠릅니다.
📉 2. 품질의 정량 비교 (Figure 3) 와 정성 비교 (Figure 4)
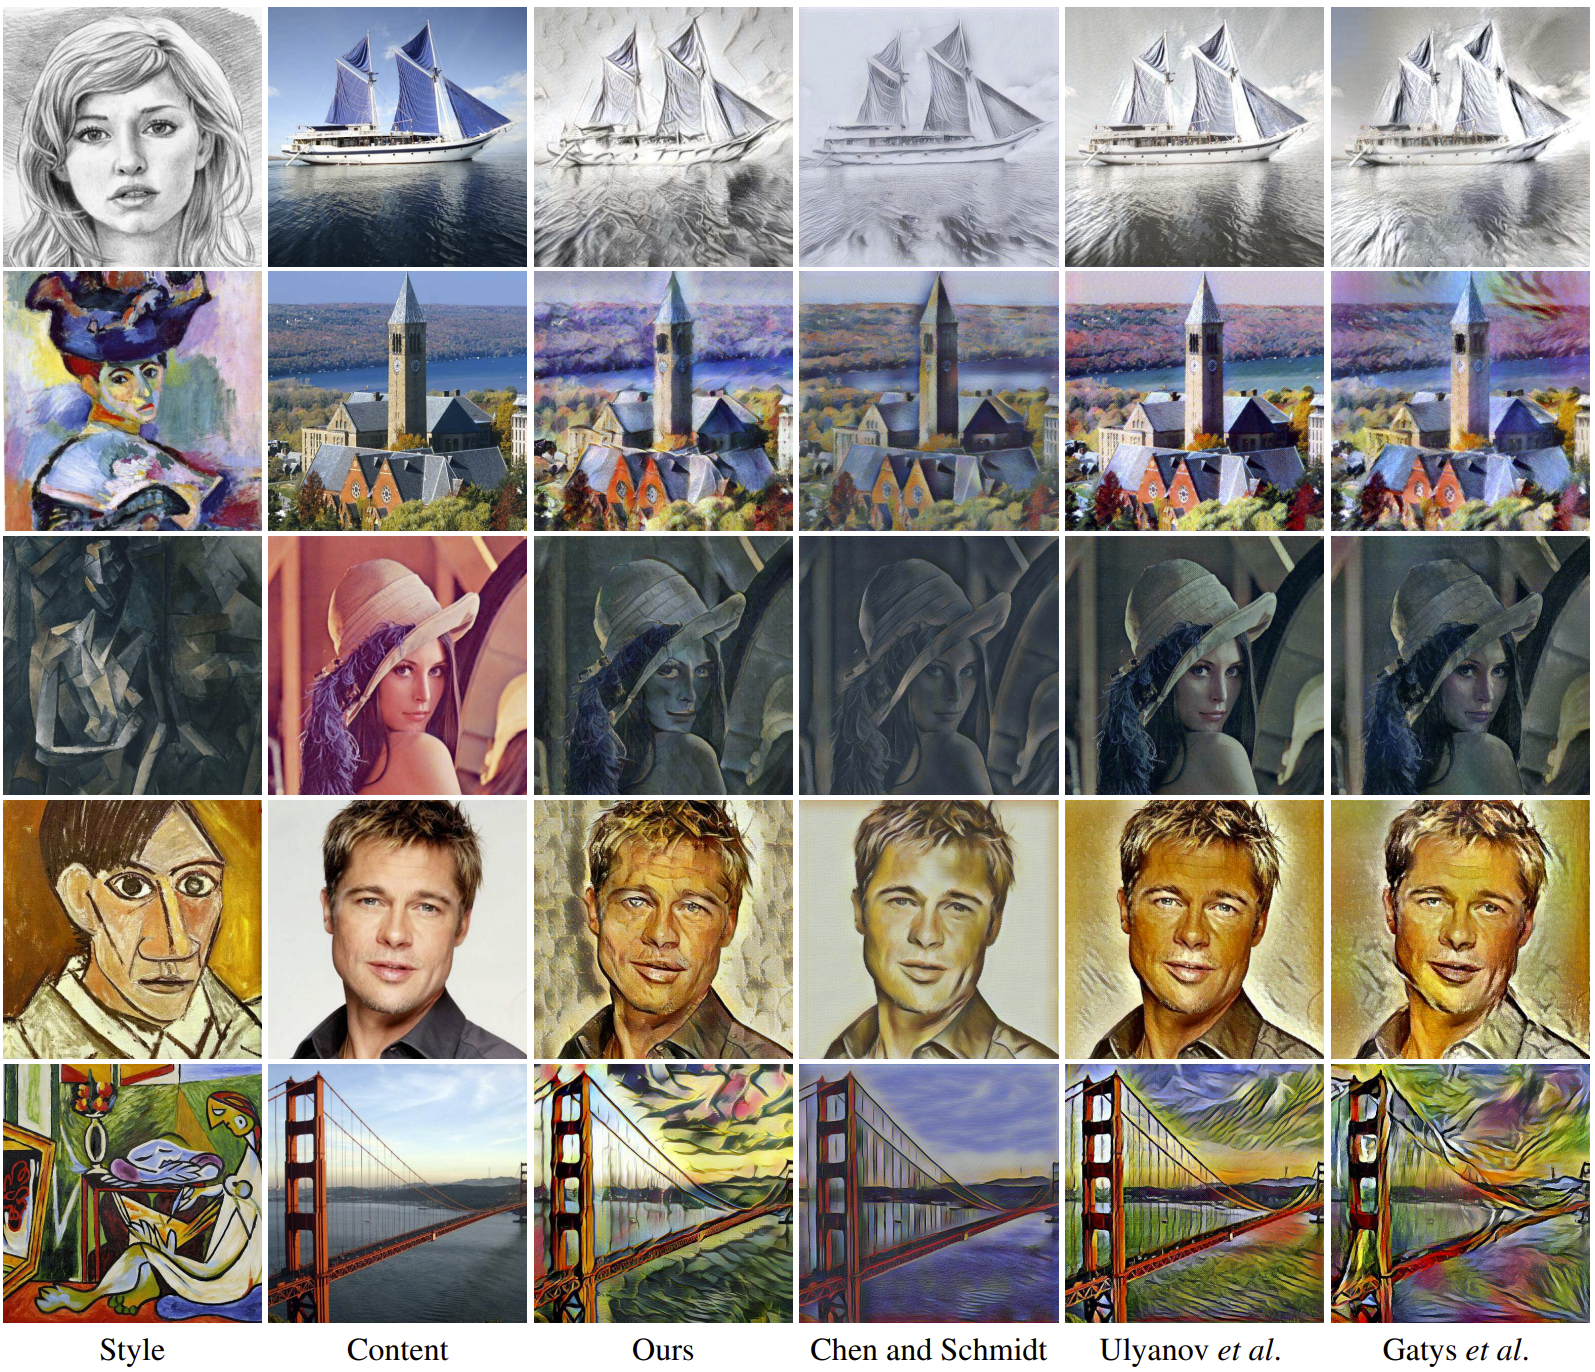
10개 스타일 × 50개 콘텐츠에 대한 평균 콘텐츠·스타일 손실을 비교했습니다. AdaIN의 손실은 Ulyanov의 단일 스타일 네트워크보다 약간 높지만 비슷했고, 스타일 손실은 Gatys 최적화의 50~100회 반복 시점과 비슷했습니다. 정성적으로는(Figure 4) 일부 스타일에서 Gatys·Ulyanov보다 약간 뒤처지지만, 학습에 없던 스타일에 대해 패치 교환 방식보다 콘텐츠 구조를 잘 보존했습니다.
🔬 3. Ablation: AdaIN과 디코더 정규화 (Figure 5, 6)
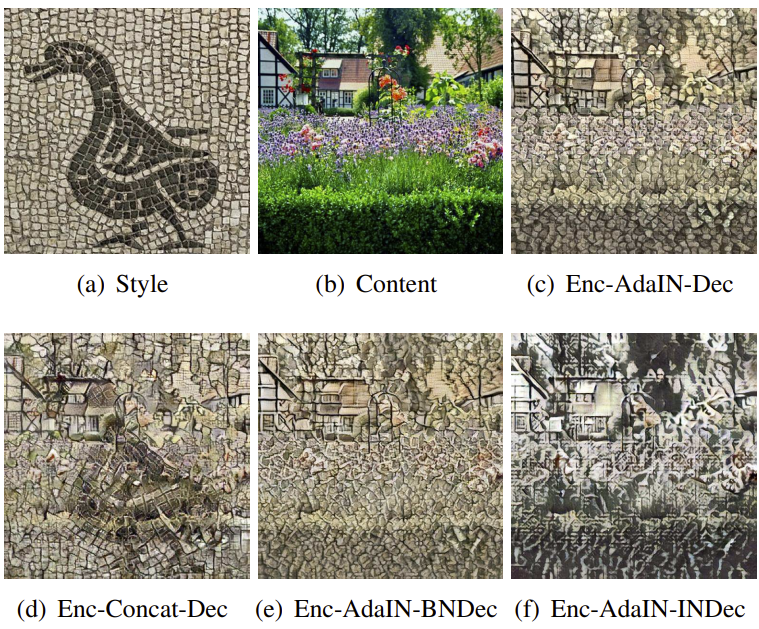
| 변형 | 결과 |
|---|---|
| Enc-Concat-Dec: AdaIN 대신 콘텐츠·스타일 특징을 채널 연결 | 스타일 손실은 낮지만 콘텐츠 손실이 높고, 스타일 이미지의 물체 윤곽이 결과에 새어 나옴 |
| Enc-AdaIN-BNDec: 디코더에 BN | 더 나쁜 결과와 높은 손실 |
| Enc-AdaIN-INDec: 디코더에 IN | 가장 나쁨 |
디코더에 IN을 넣으면 나쁜 이유는 Section 4의 해석으로 설명됩니다. IN은 모든 샘플을 하나의 스타일로 정규화하므로, AdaIN이 막 입힌 스타일 통계를 디코더의 IN이 다시 지워 버립니다. BN도 배치 단위로 같은 일을 합니다. 따라서 임의 스타일을 다루려면 디코더에 정규화 층이 없어야 합니다.
💡 Key Takeaway AdaIN은 속도는 단일 스타일 방법 수준, 유연성은 최적화 방법 수준, 품질은 그 사이에 있습니다. Ablation은 “스타일은 통계에 있다”는 해석을 역으로 확인합니다. 디코더가 통계를 다시 정규화하면 스타일이 사라집니다.
런타임 제어: 절충, 보간, 색, 공간
피드포워드 방법의 약점은 학습 후 조절이 어렵다는 것이었습니다. AdaIN은 특징 공간에서 AdaIN 파라미터를 직접 조작할 수 있으므로, 재학습 없이 여러 제어가 가능합니다(Section 7.3). 이 모든 조작은 학습 때 한 번도 본 적 없는 것입니다.
🎚️ 1. 콘텐츠-스타일 절충 (Eq. 14, Figure 7)
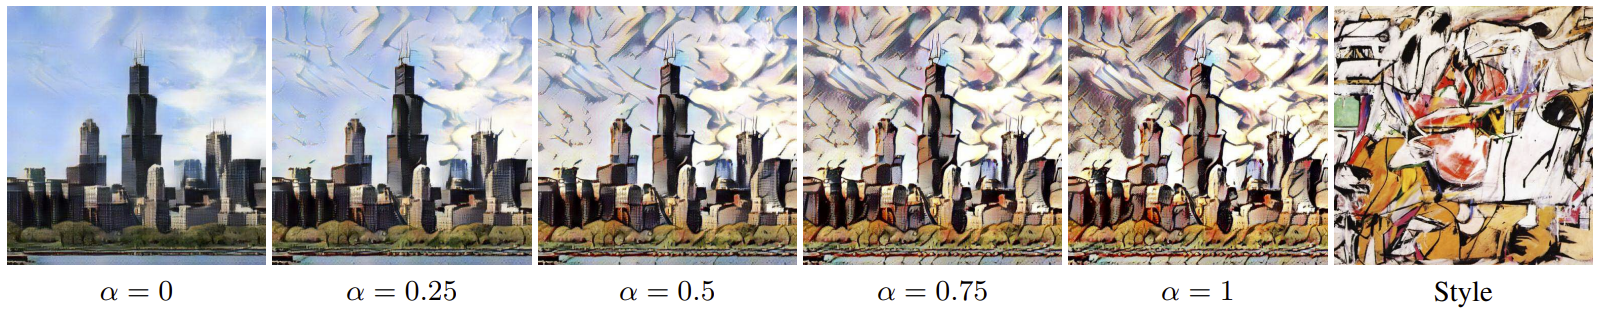
디코더에 들어가는 특징을 콘텐츠 특징과 AdaIN 출력 사이에서 보간합니다.
\[T(c,s,\alpha)=g\Big((1-\alpha)f(c)+\alpha\,\text{AdaIN}\big(f(c),f(s)\big)\Big)\]$\alpha=0$ 이면 콘텐츠 복원, $\alpha=1$ 이면 완전 스타일 변환입니다. 이는 AdaIN의 아핀 파라미터를 보간하는 것과 동치입니다. 학습 시 스타일 가중치 $\lambda$ 로 조절하던 것을 테스트 시에 할 수 있게 된 것입니다.
🎨 2. 스타일 보간 (Eq. 15, Figure 8)
$K$ 개 스타일에 가중치 $w_k$ ($\sum w_k=1$)를 주어 AdaIN 출력을 섞습니다.
\[T(c,s_{1\ldots K},w_{1\ldots K})=g\Big(\sum_{k=1}^{K}w_k\,\text{AdaIN}\big(f(c),f(s_k)\big)\Big)\]Dumoulin et al.의 CIN 보간이 학습된 $(\gamma,\beta)$ 사이에서만 가능했던 것과 달리, 여기서는 임의의 스타일 이미지 네 장을 즉석에서 섞을 수 있습니다.
🖌️ 3. 색 보존과 공간 제어 (Figure 9, 10)
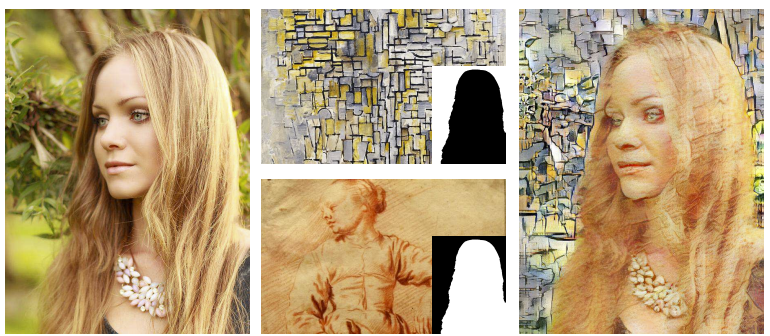
- 색 보존: Gatys et al.(2016b)을 따라 스타일 이미지의 색 분포를 먼저 콘텐츠 이미지에 맞춘 뒤 변환하면, 콘텐츠의 색을 유지한 채 질감만 옮겨집니다.
- 공간 제어: 콘텐츠 특징 맵의 영역별 마스크에 대해 서로 다른 스타일의 AdaIN 통계를 적용하면, 전경과 배경에 다른 스타일을 입힐 수 있습니다. 마스크 안의 통계만 바꾸면 되므로 추가 비용이 거의 없습니다.
💡 Key Takeaway AdaIN의 파라미터는 계산된 값이므로 테스트 시 자유롭게 섞고 가중하고 영역별로 바꿀 수 있습니다. 재학습 없는 제어는 “스타일 = 통계”라는 표현의 부산물입니다.
특징 통계와 스타일: Gram 행렬에서 평균·분산으로
AdaIN이 성립하려면 “채널별 평균과 분산이 스타일을 충분히 담는다”는 전제가 필요합니다. 이 전제는 Gatys et al.의 Gram 행렬 손실과 어떤 관계인지, 그리고 왜 더 적은 통계로도 작동하는지를 정리합니다(Section 2, 4의 논의).
🧮 1. Gram 행렬과 분포 매칭
VGG 층의 활성값을 $F\in\mathbb{R}^{C\times HW}$ 라 하면 Gram 행렬은 $G=FF^\top/(HW)\in\mathbb{R}^{C\times C}$ 입니다. 대각 성분은 각 채널의 2차 모멘트, 비대각 성분은 채널 간 상관입니다. Li et al.(2017)은 Gram 행렬 매칭이 2차 다항 커널을 쓴 최대 평균 불일치(MMD) 최소화와 같다는 것, 즉 특징 분포를 맞추는 문제라는 것을 보였습니다.
| 통계 | 담는 정보 | 대응 방법 |
|---|---|---|
| 채널별 평균 $\mu$ | 각 특징이 얼마나 “켜져” 있는가 | AdaIN, BN/IN 통계 |
| 채널별 분산 $\sigma^2$ | 각 특징의 공간적 변동 폭 | AdaIN |
| 채널 간 공분산 | 특징들이 함께 나타나는 패턴 | Gram 행렬, WCT |
| 국소 패치 구조 | 특징의 공간 배치 | 패치 교환 (Chen & Schmidt) |
AdaIN은 이 중 위 두 줄만 맞춥니다. Gram 행렬의 대각 성분과 평균에 해당합니다.
🔗 2. 왜 평균·분산만으로 충분한가
논문이 제시하는 근거는 세 가지입니다.
- 실험적 근거 (Figure 1): IN은 평균·분산만 정규화하는데도 스타일을 지웁니다. 지워진다는 것은 그 통계에 스타일이 있었다는 뜻입니다.
- CIN의 선례: Dumoulin et al.은 채널별 $(\gamma,\beta)$, 즉 평균·분산 수준의 아핀 파라미터만으로 32개 스타일을 구분했습니다.
- 손실의 일관성: AdaIN 네트워크의 스타일 손실(Eq. 13)을 평균·표준편차로 정의했을 때 결과가 Gram 행렬 손실과 비슷했습니다. 두 손실이 비슷한 최적점을 가진다는 뜻입니다.
다만 저자들은 평균·분산이 충분조건이 아니라 “잘 작동하는 근사” 라는 점을 인정하며, 상관 정렬·히스토그램 매칭 같은 고차 통계 전이를 미래 과제로 둡니다.
🎨 3. 스타일 보간과 색 보존 예시 (Figure 8, 9)
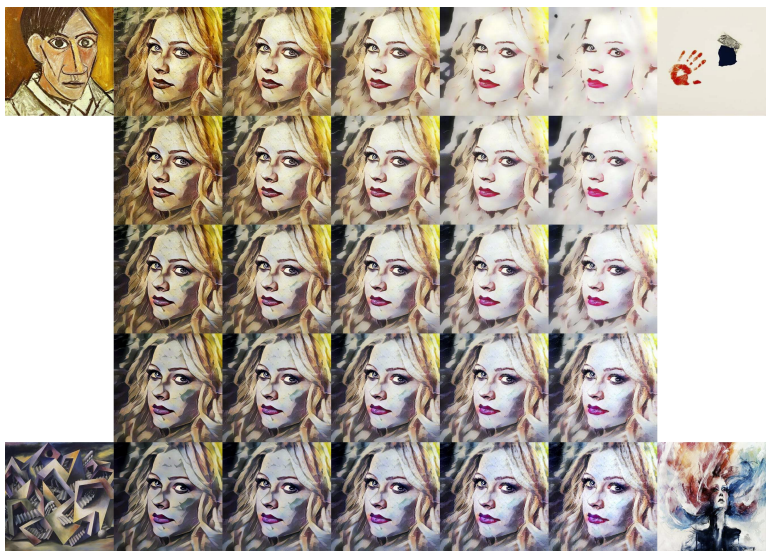
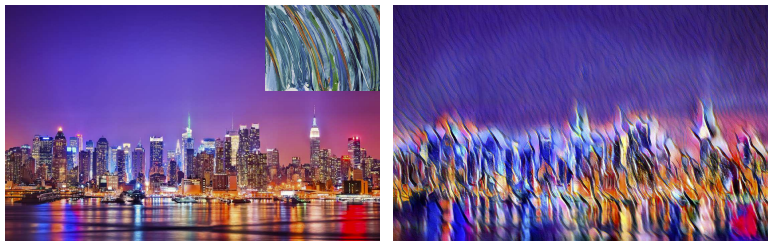
Figure 8은 네 스타일의 AdaIN 출력을 가중합한 결과로, 통계가 선형 공간처럼 섞인다는 것을 보여줍니다. Figure 9는 스타일 이미지의 색 분포를 콘텐츠에 미리 맞춘 뒤 변환해 콘텐츠의 색을 보존한 예입니다. 두 예시 모두 “스타일 = 통계”라는 표현 덕분에 특징 공간에서의 산술 연산이 이미지 공간에서 의미 있는 조작이 된다는 점을 보여줍니다.
💡 Key Takeaway AdaIN은 Gram 행렬이 담는 정보 중 평균과 분산만 옮깁니다. 그것으로 충분한 이유는 이론이 아니라 IN 실험과 CIN의 선례라는 경험적 근거이며, 부족한 부분은 WCT 같은 후속 연구가 메웠습니다.
한계와 열린 방향
AdaIN은 속도·유연성·품질의 삼각 균형에서 새로운 점을 찾았지만, 그 균형은 몇 가지를 포기한 결과이기도 합니다. 그리고 이 논문이 끝나는 지점에서 두 갈래의 후속 흐름이 시작됩니다.
⚠️ 1. 한계
- 1·2차 통계만 전이: AdaIN은 채널별 평균·분산만 맞추므로 채널 간 상관(Gram 행렬)이나 국소 패턴은 옮기지 못합니다. 복잡한 질감에서 Gatys나 Ulyanov보다 품질이 약간 떨어지는 이유입니다. 저자들도 상관 정렬, 히스토그램 매칭을 미래 과제로 적었습니다.
- 단일 층(relu4_1)에서만 변환: 통계 전이가 한 층에서만 일어나므로 저수준 질감 세부가 약할 수 있습니다. 논문은 잔차 구조나 스킵 연결로 여러 층의 정보를 디코더에 전달하는 방향을 제안합니다.
- 속도 상한: VGG-19 인코더가 커서 단일 스타일 방법(0.011초)보다 느립니다. 경량 인코더로의 교체가 필요합니다.
- 정량 평가의 한계: 품질 비교는 VGG 기반 손실과 육안에 의존합니다. 사용자 연구는 없습니다.
- 콘텐츠 누출 없음, 하지만 구조 왜곡 가능: 통계 전이는 스타일 이미지의 물체 윤곽을 새게 하지는 않지만, 강한 스타일에서는 콘텐츠의 미세 구조가 뭉개질 수 있습니다.
🔭 2. 두 갈래의 후속 연구
| 갈래 | 대표 연구 | AdaIN과의 관계 |
|---|---|---|
| 더 풍부한 통계 전이 | WCT (Li et al., 2017), Avatar-Net (2018), SANet (2019), AdaAttN (2021) | 공분산·어텐션 기반으로 2차 이상 통계와 국소 대응을 옮김 |
| 생성 모델의 스타일 주입 | MUNIT (2018), StyleGAN (2019), StarGAN v2 (2020) | AdaIN을 생성기의 정규화 층으로 써서 잠재 코드로 스타일을 제어 |
특히 StyleGAN은 매핑 네트워크 출력 $w$ 에서 각 층의 AdaIN 스케일·시프트를 생성하여, AdaIN을 “스타일 변환 층”에서 “잠재 공간을 스타일로 해석하는 생성기의 뼈대” 로 바꾸었습니다. StyleGAN2가 AdaIN의 평균 정규화가 물방울 아티팩트를 만든다고 지적하고 가중치 변조(weight demodulation)로 대체한 것도 이 계보의 일부입니다.
🧭 3. 이 논문의 위치
Dumoulin et al.이 “스타일은 정규화 아핀 파라미터에 있다”고 보였다면, 이 논문은 “그 파라미터는 스타일 이미지의 통계이며 계산으로 얻을 수 있다” 고 한 걸음 더 나아갔습니다. IN이 스타일 정규화라는 해석은 이후 “정규화 층은 스타일 정보를 담는다”는 관점으로 일반화되어, 도메인 일반화·이미지 변환·생성 모델 설계 전반에 영향을 미쳤습니다.
💡 Key Takeaway AdaIN의 한계는 “평균과 분산만” 이라는 단순함에서 오고, 영향력도 같은 단순함에서 옵니다. 더 풍부한 통계를 옮기는 연구와 AdaIN을 생성기 안에 심는 연구가 각각 그 단순함을 보완하고 활용했습니다.