 You know maize mean?
StarGAN: Unified Generative Adversarial Networks for Multi-Domain Image-to-Image Translation
0. Summary
기본 정보 : ArXiv,2017.11.24 (CVPR 2018 Oral), StarGAN: Unified Generative Adversarial Networks for Multi-Domain Image-to-Image Translation
연구 배경
pix2pix, CycleGAN, DiscoGAN 같은 이미지-이미지 변환 모델은 두 도메인 사이의 변환에서는 큰 성과를 냈지만, 도메인이 셋 이상이면 확장성이 급격히 나빠진다. 도메인 $k$ 개 사이의 모든 변환을 배우려면 $k(k-1)$ 개의 생성기가 필요하고(Figure 2a), 각 생성기는 전체 데이터 중 두 도메인의 이미지만 보고 학습하므로 모든 도메인에 공통인 얼굴 형태 같은 전역 특징을 충분히 활용하지 못한다. 또한 CelebA(속성 라벨)와 RaFD(표정 라벨)처럼 라벨 집합이 다른 데이터셋을 함께 학습하는 것은 기존 틀에서 불가능했다. 각 데이터셋은 상대 데이터셋의 라벨을 갖고 있지 않기 때문이다.
제안 방법
StarGAN은 생성기 하나와 판별기 하나로 여러 도메인 사이의 모든 변환을 처리한다. 생성기 $G$ 는 이미지 $x$ 와 목표 도메인 라벨 $c$ 를 함께 받아 $G(x,c)$ 를 내고, 라벨은 공간적으로 복제되어 입력 이미지와 채널 방향으로 연결된다. 판별기 $D$ 는 진위 판별 출력 $D_{src}$ 와 도메인 분류 출력 $D_{cls}$ 를 함께 가지는 보조 분류기 구조다. 손실은 적대 손실(Eq. 1), 진짜 이미지의 원래 도메인을 맞추도록 $D$ 를 학습하고 생성 이미지가 목표 도메인으로 분류되도록 $G$ 를 학습하는 도메인 분류 손실(Eq. 2, 3), 그리고 $G(G(x,c),c’)\approx x$ 를 요구하는 재구성(순환 일관성) 손실(Eq. 4)로 구성된다. 여러 데이터셋을 함께 학습하기 위해 마스크 벡터 $m$ 을 도입하여, 라벨 벡터를 $\tilde c=[c_1,\ldots,c_n,m]$ 으로 통합하고 현재 데이터셋의 라벨만 분류 손실에 반영한다(Eq. 7). 학습 안정화를 위해 적대 손실은 WGAN-GP 형태(Eq. 8)를 쓴다.
발견 사실
CelebA의 머리색·성별·나이 변환에 대한 Amazon Mechanical Turk 평가에서 StarGAN은 단일 속성 변환에서 머리색 66.2%, 나이 70.6%의 표를 얻어 DIAT·CycleGAN·IcGAN을 크게 앞섰고(Table 1), 다중 속성 변환에서도 47.4~61.5%로 1위였다(Table 2). RaFD 표정 합성에서는 생성 이미지를 ResNet-18 분류기(실제 이미지 정확도 99.55%)로 분류했을 때 오류율이 2.12% 로 DIAT 4.10%, CycleGAN 5.99%, IcGAN 8.07%보다 낮았으며, 파라미터는 53.2M 하나로 DIAT(52.6M×7)의 약 1/7, CycleGAN(52.6M×14)의 약 1/14이었다(Table 3). CelebA와 RaFD를 마스크 벡터로 함께 학습한 StarGAN-JNT는 RaFD만 학습한 StarGAN-SNG보다 CelebA 얼굴의 표정 합성 품질이 높았고(Figure 6), 마스크 벡터를 잘못 주면 표정 대신 나이가 바뀌는 등 마스크가 의도대로 작동함을 확인했다(Figure 7).
핵심 기여
- 단일 생성기 다중 도메인 변환 : 목표 도메인 라벨을 입력으로 받는 생성기 하나와 보조 분류기를 가진 판별기 하나로 $k$ 도메인 사이의 모든 변환을 학습하여, 모델 수를 $k(k-1)$ 에서 1로 줄였다(Figure 2b). 모든 도메인 데이터를 한 생성기가 보므로 다중 과제 학습의 정규화 효과로 품질도 올랐다.
- 마스크 벡터로 다중 데이터셋 공동 학습 : 라벨 집합이 다른 데이터셋들을 하나의 모델로 함께 학습하는 방법을 제시했고, 이를 통해 RaFD의 표정 라벨을 CelebA 얼굴에 적용하는 것처럼 한 데이터셋에 없는 라벨로의 변환이 가능해졌다.
- 정량·정성 검증 : AMT 지각 평가, 분류 오류율, 파라미터 수 비교로 기존 2-도메인 모델 대비 품질과 효율을 동시에 보였다.
관련 개념
다중 도메인 이미지 변환과 확장성 문제
이미지-이미지 변환(image-to-image translation) 은 이미지의 어떤 측면(도메인)을 바꾸면서 나머지는 보존하는 문제입니다. 여기서 도메인은 같은 속성값을 공유하는 이미지 집합(예: 여성 얼굴, 금발, 웃는 표정)을 뜻하고, 속성은 그 도메인을 정의하는 의미 있는 특징을 뜻합니다. 이 논문의 출발점은 도메인이 많아질 때 기존 모델이 어떻게 무너지는가입니다.
📐 1. 2-도메인 모델의 확장 비용 (Figure 2)
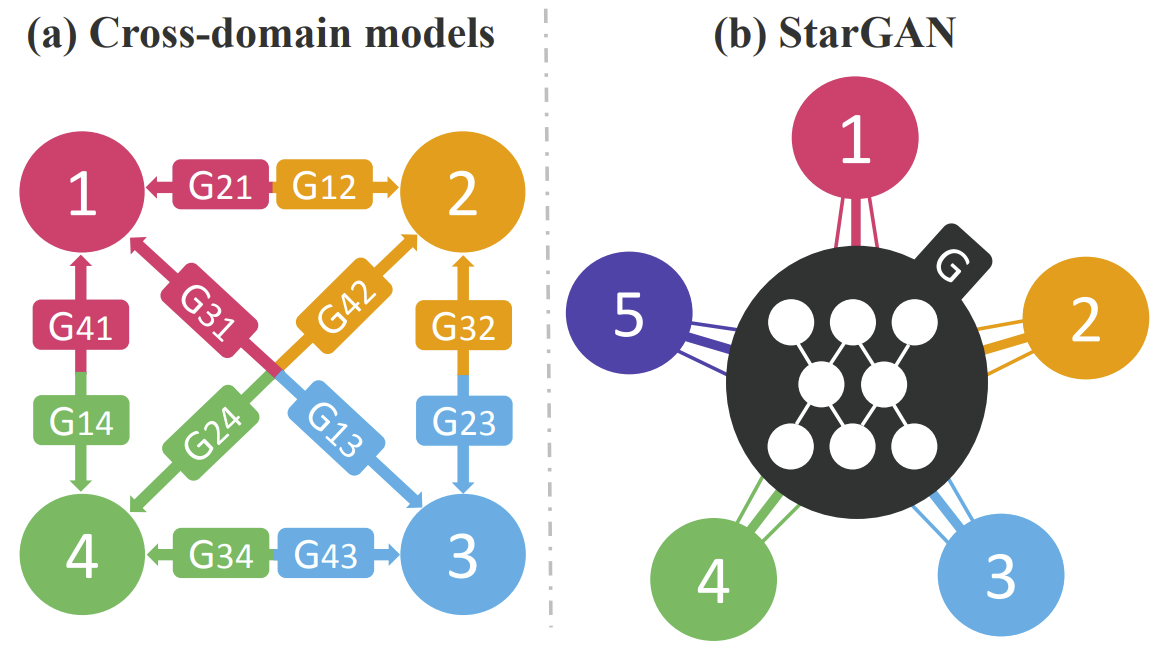
| 모델 | $k$ 도메인에 필요한 생성기 수 | 한 생성기가 보는 데이터 |
|---|---|---|
| pix2pix / CycleGAN 류 (교차 도메인) | $k(k-1)$ | 두 도메인의 이미지만 |
| StarGAN | 1 | 모든 도메인의 이미지 |
Figure 2a처럼 4개 도메인이면 12개의 생성기가 필요합니다. 문제는 수만이 아닙니다. 각 생성기가 전체 데이터의 일부만 보기 때문에 얼굴 윤곽처럼 모든 도메인에 공통인 특징을 배우지 못해 품질이 떨어집니다. StarGAN의 별(star) 모양 위상(Figure 2b)은 하나의 생성기가 중심에서 모든 도메인을 연결합니다.
🗂️ 2. 다중 데이터셋 문제
CelebA는 머리색·성별·나이 같은 속성 라벨을, RaFD는 표정 라벨을 갖습니다. 두 데이터셋을 함께 학습하고 싶지만, CelebA 이미지에는 표정 라벨이 없고 RaFD 이미지에는 속성 라벨이 없습니다. 재구성 손실 $G(G(x,c),c’)$ 를 계산하려면 원래 라벨 $c’$ 의 전체 벡터가 필요한데, 한쪽 데이터셋의 라벨은 항상 비어 있습니다. 이 “부분 라벨” 문제가 마스크 벡터의 동기입니다.
🔗 3. 관련 접근과의 차이
| 접근 | 조건 방식 | 한계 |
|---|---|---|
| 조건부 GAN (Mirza & Osindero) | 라벨을 $G$, $D$ 에 입력 | 변환이 아닌 생성 |
| AC-GAN (Odena et al.) | $D$ 에 보조 분류기 | 변환이 아닌 생성. StarGAN의 $D_{cls}$ 가 이 구조를 차용 |
| IcGAN | 인코더로 잠재 추출 후 조건부 생성 | 인코더-생성기 분리, 정체성 보존 약함 |
| CycleGAN | 순환 일관성으로 비짝 데이터 변환 | 2 도메인 한정 |
| StarGAN | 라벨 입력 + 보조 분류기 + 순환 일관성 | 위 요소들을 다중 도메인 변환에 결합 |
💡 Key Takeaway 문제는 “도메인이 많아지면 모델이 많아진다”가 아니라, “모델이 쪼개지면 각 모델이 데이터의 일부만 본다” 는 것입니다. StarGAN은 모델을 하나로 합쳐 데이터 전체를 활용하고, 마스크 벡터로 데이터셋 경계까지 넘습니다.
목적 함수: 적대·도메인 분류·재구성
StarGAN의 손실은 세 부분으로 이루어지며, 각각이 사실성, 도메인 변경, 내용 보존이라는 서로 다른 요구를 담당합니다(Section 3.1). 생성기 $G(x,c)$ 와 판별기 $D:x\to{D_{src}(x),D_{cls}(x)}$ 를 기준으로 정리합니다.
⚔️ 1. 적대 손실 (Eq. 1)
\[\mathcal{L}_{adv}=\mathbb{E}_x\big[\log D_{src}(x)\big]+\mathbb{E}_{x,c}\big[\log\big(1-D_{src}(G(x,c))\big)\big]\]$D$ 는 최대화, $G$ 는 최소화합니다. 역할은 생성 이미지가 실제 이미지와 구분되지 않게 하는 것입니다. 실제 구현에서는 아래의 WGAN-GP 형태로 대체됩니다.
🏷️ 2. 도메인 분류 손실 (Eq. 2, 3)
판별기 위의 보조 분류기 $D_{cls}$ 를 두 방향으로 씁니다.
진짜 이미지에 대한 분류 손실 — $D$ 를 학습합니다. 진짜 이미지 $x$ 와 원래 도메인 $c’$ 에 대해
\[\mathcal{L}^r_{cls}=\mathbb{E}_{x,c'}\big[-\log D_{cls}(c'\mid x)\big]\]가짜 이미지에 대한 분류 손실 — $G$ 를 학습합니다. 생성 이미지가 목표 도메인 $c$ 로 분류되도록
\[\mathcal{L}^f_{cls}=\mathbb{E}_{x,c}\big[-\log D_{cls}(c\mid G(x,c))\big]\]| 손실 | 누가 최소화 | 효과 |
|---|---|---|
| $\mathcal{L}^r_{cls}$ | $D$ | $D_{cls}$ 가 진짜 이미지의 도메인을 정확히 맞추는 분류기가 됨 |
| $\mathcal{L}^f_{cls}$ | $G$ | $G$ 가 목표 도메인으로 분류될 만큼 속성을 실제로 바꾸도록 강제 |
적대 손실만으로는 $G$ 가 입력을 그대로 내보내도 “진짜 같다”는 평가를 받으므로, 분류 손실이 없으면 도메인 변경이 일어나지 않습니다.
🔄 3. 재구성 손실 (Eq. 4)
적대 손실과 분류 손실만으로는 생성 이미지가 입력의 내용(정체성, 자세 등)을 보존한다는 보장이 없습니다. CycleGAN의 순환 일관성을 같은 생성기를 두 번 적용하는 형태로 가져옵니다.
\[\mathcal{L}_{rec}=\mathbb{E}_{x,c,c'}\big[\|x-G(G(x,c),c')\|_1\big]\]$x$ 를 목표 도메인 $c$ 로 보낸 뒤 원래 도메인 $c’$ 로 되돌리면 원본이 복원되어야 합니다. CycleGAN이 $G$ 와 $F$ 두 생성기를 쓰는 것과 달리 StarGAN은 생성기 하나가 도메인 라벨만 바꿔 양방향을 모두 담당합니다. L1 노름을 씁니다.
🧮 4. 전체 목적 (Eq. 5, 6)
\[\mathcal{L}_D=-\mathcal{L}_{adv}+\lambda_{cls}\mathcal{L}^r_{cls},\qquad \mathcal{L}_G=\mathcal{L}_{adv}+\lambda_{cls}\mathcal{L}^f_{cls}+\lambda_{rec}\mathcal{L}_{rec}\]모든 실험에서 $\lambda_{cls}=1$, $\lambda_{rec}=10$ 입니다. 재구성 가중치가 10배 큰 것은 CycleGAN의 관행과 같으며, 정체성 보존을 강하게 요구한다는 뜻입니다.
💡 Key Takeaway 세 손실은 각각 “진짜처럼”(적대), “목표 도메인으로”(분류), “나머지는 그대로”(재구성) 를 담당합니다. 어느 하나가 빠지면 변환이 안 되거나, 사실성이 깨지거나, 정체성이 사라집니다.
학습 흐름 한눈에 보기 (Figure 3)
세 손실이 실제 학습 스텝에서 어떻게 배치되는지는 Figure 3에 정리되어 있습니다. 판별기와 생성기가 각각 무엇을 입력받고 어떤 손실로 갱신되는지를 따라가면 StarGAN의 동작이 분명해집니다.
🔄 1. 판별기 스텝 (Figure 3a)
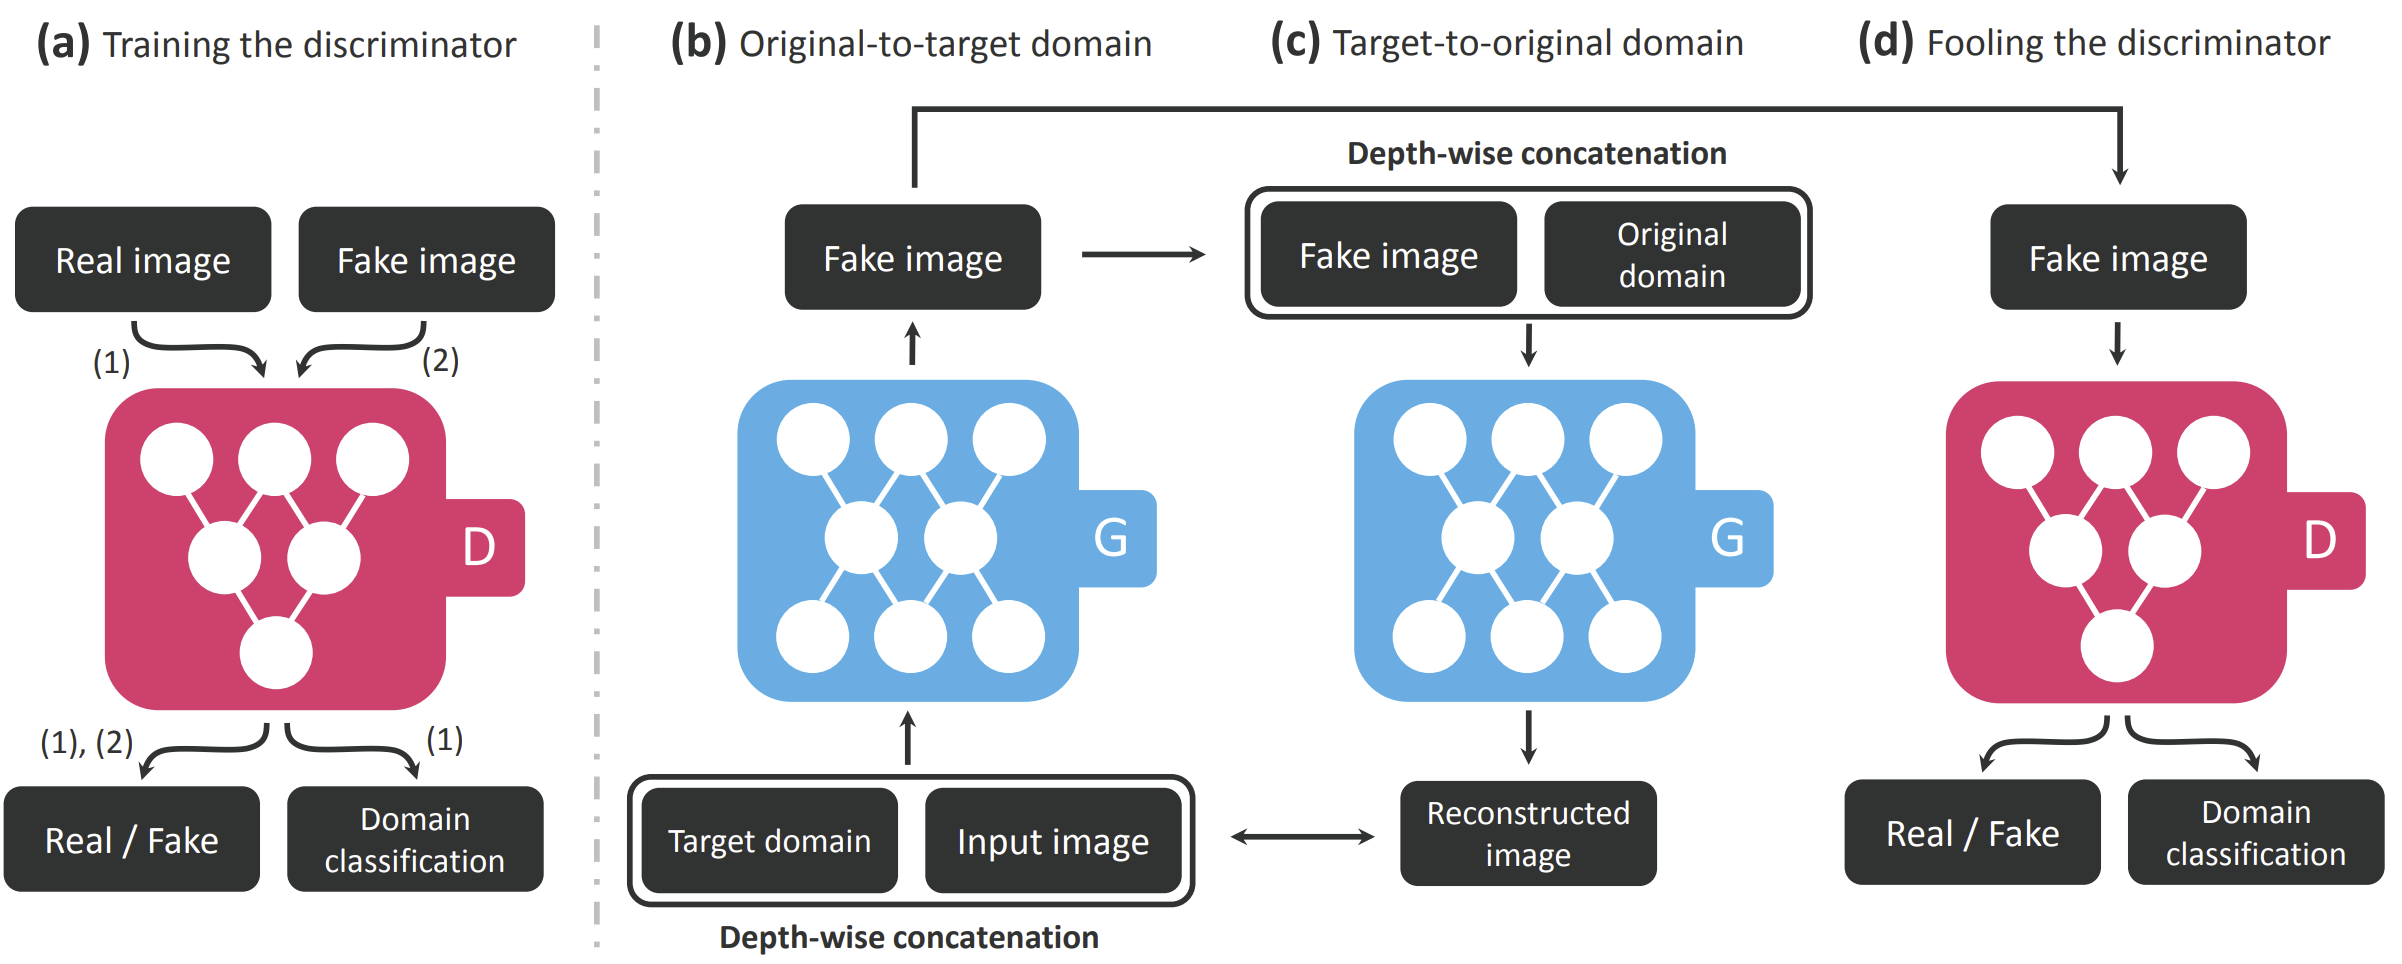
| 입력 | 출력 | 손실 |
|---|---|---|
| 진짜 이미지 $x$ | $D_{src}(x)$ → 진짜로 판정 | $\mathcal{L}_{adv}$ |
| 진짜 이미지 $x$ | $D_{cls}(c’\mid x)$ → 원래 도메인 $c’$ 로 분류 | $\mathcal{L}^r_{cls}$ |
| 생성 이미지 $G(x,c)$ | $D_{src}(G(x,c))$ → 가짜로 판정 | $\mathcal{L}_{adv}$ |
판별기는 생성 이미지에 대해서는 분류 손실을 계산하지 않습니다. 가짜 이미지의 도메인을 맞추는 것은 생성기의 몫입니다.
🎨 2. 생성기 스텝 (Figure 3b–d)
| 단계 | 연산 | 손실 |
|---|---|---|
| (b) 변환 | $x$ + 목표 라벨 $c$ (공간 복제) → $G(x,c)$ | – |
| (c) 재구성 | $G(x,c)$ + 원래 라벨 $c’$ → $G(G(x,c),c’)$ | $\mathcal{L}_{rec}$ (L1 vs. $x$) |
| (d) 속이기 | $G(x,c)$ → $D_{src}$ 진짜로, $D_{cls}$ 는 $c$ 로 | $\mathcal{L}{adv}$, $\mathcal{L}^f{cls}$ |
목표 라벨 $c$ 는 학습 중 무작위로 생성됩니다. 이로써 생성기는 모든 (원래 도메인, 목표 도메인) 조합을 고르게 경험하고, 테스트 시 임의의 목표 라벨을 유연하게 처리할 수 있습니다.
🧩 3. 라벨 입력의 구체적 형태
CelebA의 7개 도메인은 세 속성 그룹으로 나뉩니다.
| 그룹 | 인코딩 | 차원 |
|---|---|---|
| 머리색 | 원-핫 (검정/금발/갈색) | 3 |
| 성별 | 이진 | 1 |
| 나이 | 이진 | 1 |
따라서 CelebA 라벨 $c$ 는 5차원이고, 이를 128×128로 공간 복제해 RGB와 연결하면 생성기 입력은 $128\times128\times8$ 이 됩니다. 머리색은 원-핫이므로 한 번에 하나만 고를 수 있고, 성별·나이는 독립적으로 켜고 끌 수 있어 다중 속성 동시 변환(Figure 4의 H+G+A)이 가능합니다.
💡 Key Takeaway 한 스텝은 “판별기: 진짜를 분류하고 가짜를 가려내기 → 생성기: 목표 도메인으로 바꾸고 되돌려 보기” 로 요약됩니다. 목표 라벨을 무작위로 뽑는 것이 모든 도메인 쌍을 한 모델이 배우게 하는 장치입니다.
마스크 벡터와 다중 데이터셋 학습
마스크 벡터(mask vector) 는 라벨 집합이 다른 여러 데이터셋을 하나의 StarGAN으로 학습하기 위한 장치입니다(Section 3.2). 핵심 아이디어는 “모르는 라벨은 무시하라”는 신호를 생성기에 명시적으로 주는 것입니다.
🧮 1. 통합 라벨 벡터 (Eq. 7)
\[\tilde c=[c_1,\ldots,c_n,m]\]| 기호 | 의미 |
|---|---|
| $c_i$ | $i$ 번째 데이터셋의 라벨 벡터. 이진 속성은 이진 벡터, 범주형 속성은 원-핫 벡터 |
| $m$ | $n$ 차원 원-핫 마스크. 현재 이미지가 어느 데이터셋에서 왔는지 표시 |
| 알 수 없는 라벨 | 0으로 채움. 생성기는 마스크를 보고 이 부분을 무시하도록 학습 |
논문에서는 $n=2$ (CelebA, RaFD)이며, CelebA 이미지의 $\tilde c$ 는 $[c_{CelebA},\,\mathbf{0},\,(1,0)]$, RaFD 이미지는 $[\mathbf{0},\,c_{RaFD},\,(0,1)]$ 꼴입니다.
🏋️ 2. 학습 절차 (Figure 8, 부록)
- 미니배치마다 CelebA와 RaFD를 번갈아 사용합니다.
- 판별기의 $D_{cls}$ 는 두 데이터셋의 라벨을 모두 출력하지만, 분류 손실은 현재 데이터셋의 라벨에 대해서만 계산합니다(다중 과제 학습). CelebA 배치에서는 속성 분류 오류만, RaFD 배치에서는 표정 분류 오류만 최소화합니다.
- 생성기는 마스크 벡터를 통해 어느 라벨 블록이 유효한지 알고, 유효한 블록에만 반응하는 법을 배웁니다.
이렇게 학습하면 판별기는 두 데이터셋의 모든 라벨에 대한 판별 특징을 배우고, 생성기는 모든 라벨을 제어할 수 있게 됩니다.
🎭 3. 데이터셋 경계를 넘는 변환 (Figure 1, 6, 7)
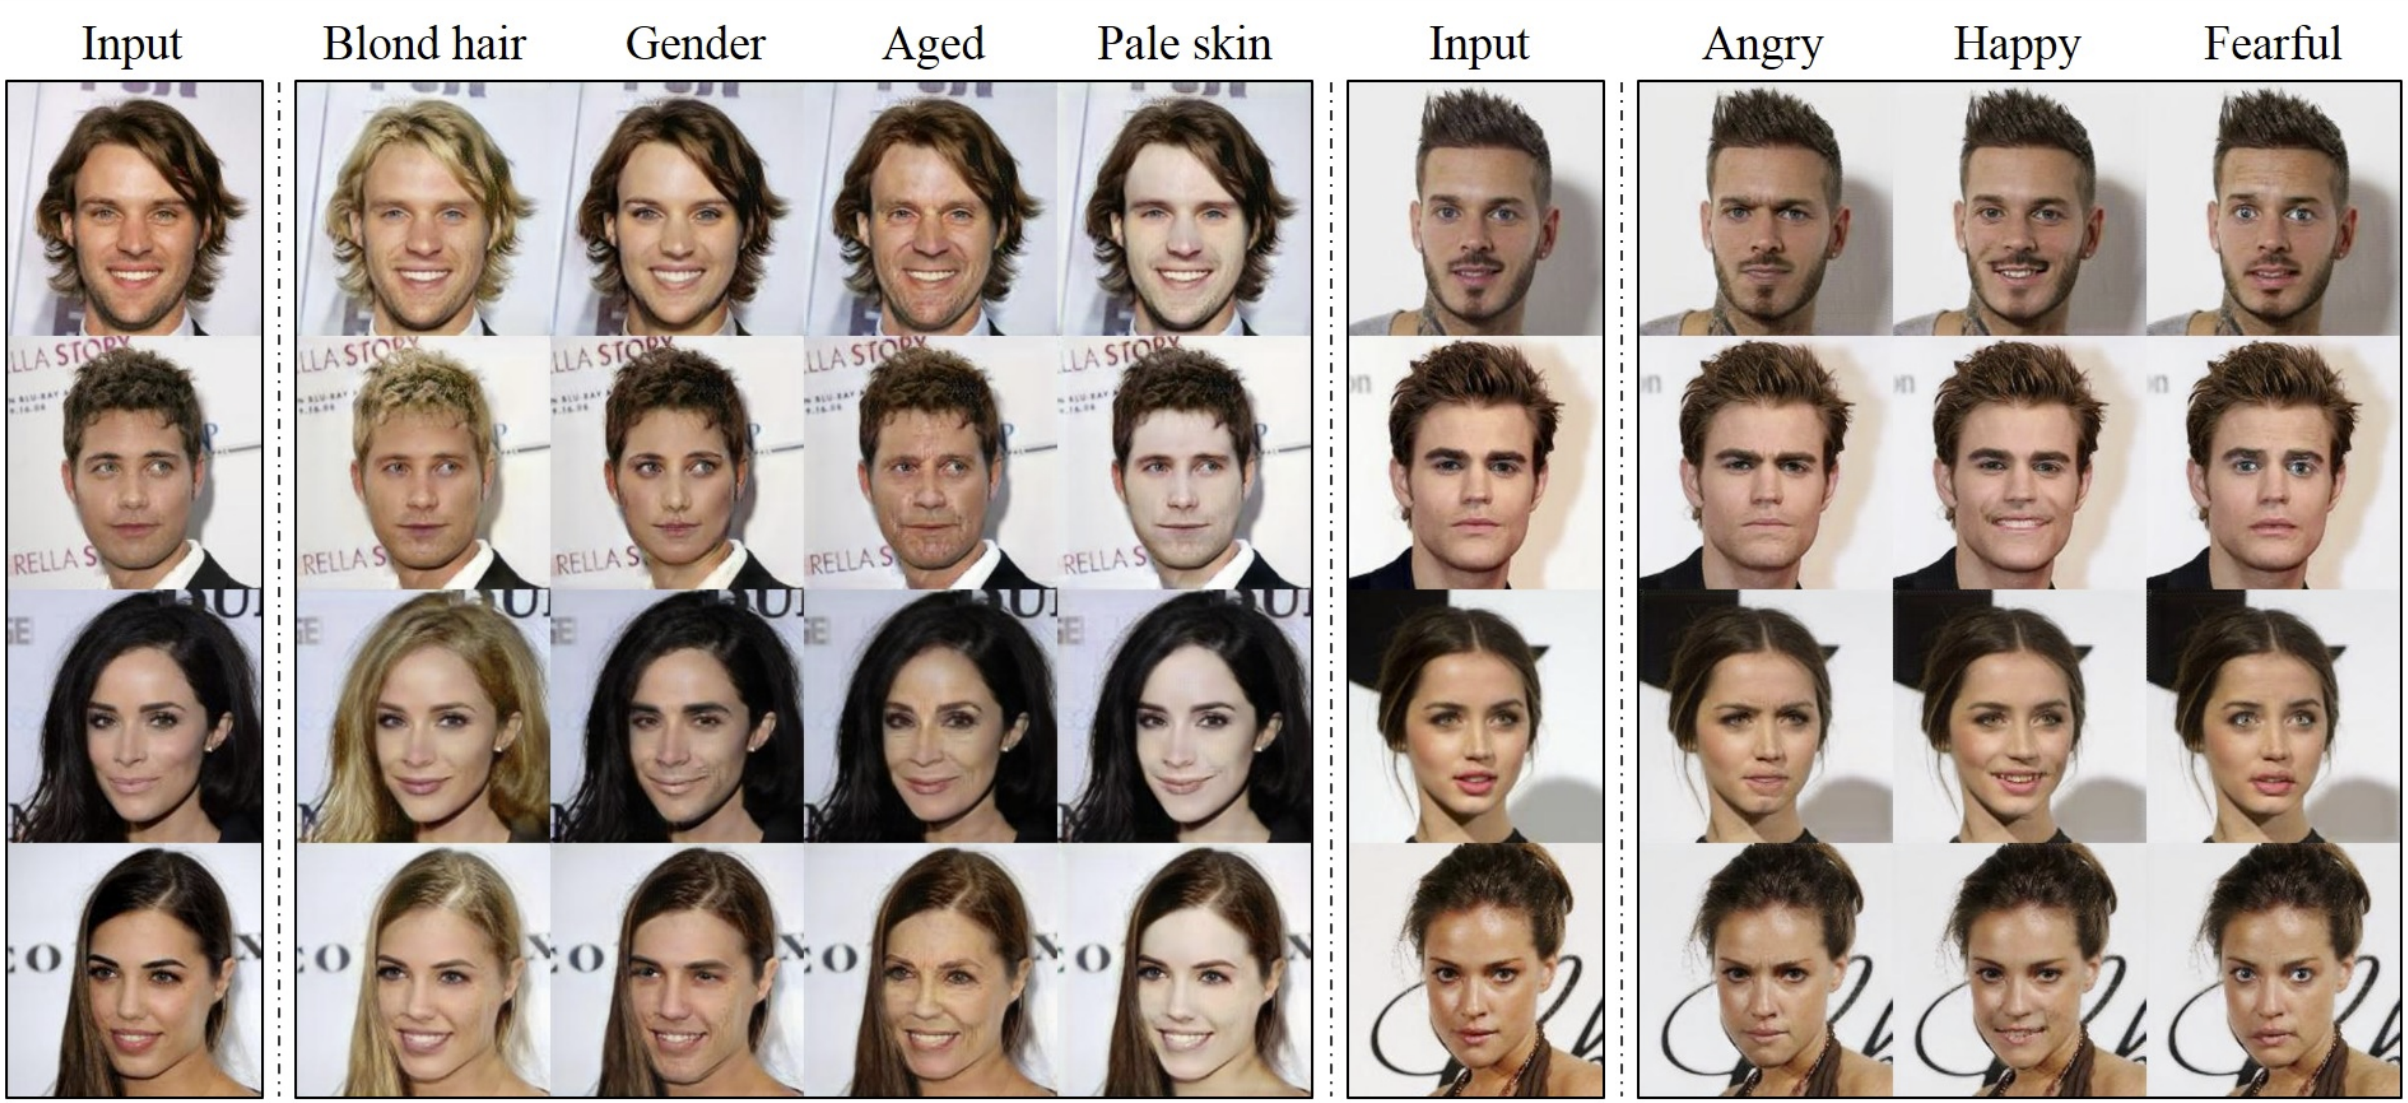
학습이 끝나면 CelebA 얼굴에 RaFD의 표정 라벨을 주어 CelebA에는 없는 표정 변환을 할 수 있습니다(Figure 1). 테스트 시 마스크를 $(0,1)$ 로 두고 RaFD 라벨 블록만 채우면 됩니다.
| 실험 | 관찰 |
|---|---|
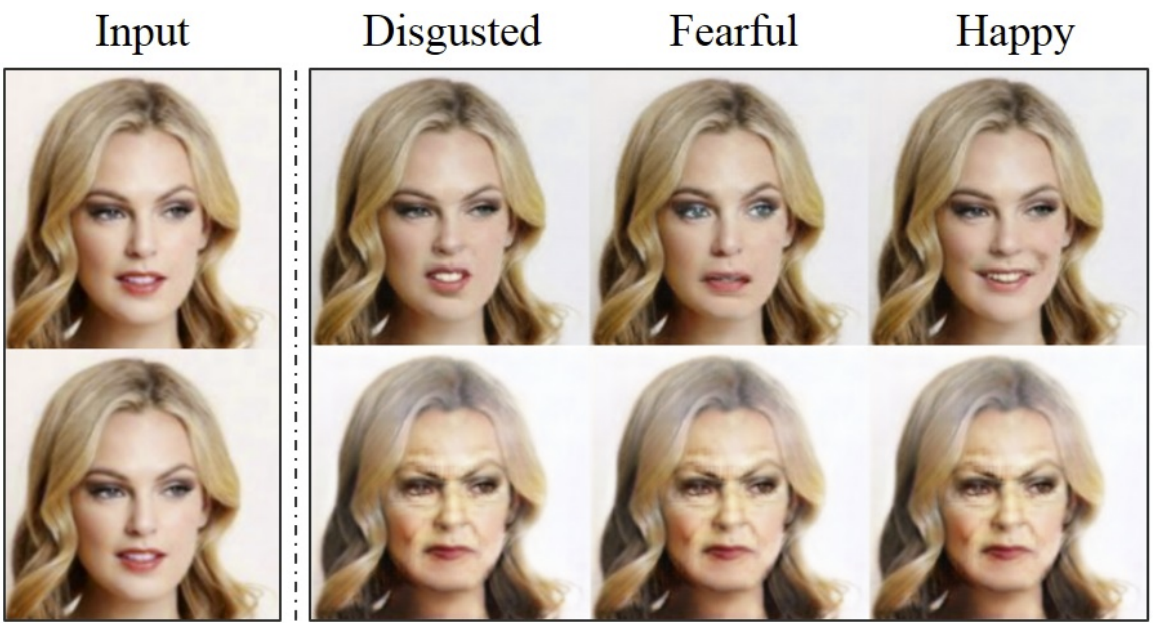
| StarGAN-SNG (RaFD만 학습) vs. StarGAN-JNT (공동 학습), CelebA 얼굴 표정 합성 (Figure 6) | JNT가 더 선명하고 자연스러운 결과. RaFD는 약 500장/도메인으로 작아 SNG는 CelebA의 자연 얼굴 분포를 모르기 때문 |
| 마스크 벡터 조작 (Figure 7) | 올바른 마스크 $(0,1)$ 이면 표정이 바뀌지만, 잘못된 마스크 $(1,0)$ 을 주면 표정 대신 나이가 바뀜. 생성기가 마스크를 실제로 사용한다는 증거 |
💡 Key Takeaway 마스크 벡터는 “이 라벨 블록은 유효하고 저 블록은 무시하라” 는 한 비트짜리 신호입니다. 이 신호 덕분에 라벨이 없는 데이터셋끼리도 한 모델에서 학습되고, 작은 데이터셋(RaFD)이 큰 데이터셋(CelebA)의 얼굴 분포를 빌려 쓸 수 있습니다.
네트워크 구조와 학습 설정
StarGAN의 네트워크는 CycleGAN의 생성기와 PatchGAN 판별기를 거의 그대로 가져오되, 조건 입력과 보조 분류기를 더한 것입니다(Section 4, 부록 Table 4–5). 새로움은 구조가 아니라 손실과 학습 방식에 있습니다.
🏗️ 1. 생성기 (Table 4)
| 단계 | 층 | 채널 |
|---|---|---|
| 입력 | 이미지 $(3)$ + 공간 복제된 라벨 $(n_c)$ 채널 연결 | $3+n_c$ |
| 다운샘플 | 7×7 conv → 4×4 stride-2 conv ×2 | 64 → 128 → 256 |
| 병목 | 잔차 블록 ×6 (3×3 conv) | 256 |
| 업샘플 | 4×4 stride-2 transposed conv ×2 | 128 → 64 |
| 출력 | 7×7 conv, Tanh | 3 |
출력층을 제외한 모든 층에 인스턴스 정규화를 씁니다. 라벨을 공간 복제해 입력에 붙이는 방식은 단순하지만, 이후 StarGAN v2에서 AdaIN 기반 스타일 주입으로 대체됩니다.
🕵️ 2. 판별기 (Table 5)
| 단계 | 층 | 채널 |
|---|---|---|
| 특징 추출 | 4×4 stride-2 conv ×6, LeakyReLU(0.01), 정규화 없음 | 64 → 128 → 256 → 512 → 1024 → 2048 |
| $D_{src}$ | 3×3 conv → 1채널 PatchGAN 출력 | 국소 패치별 진위 |
| $D_{cls}$ | $h/64\times w/64$ 크기 conv → $n_d$ 채널 | 도메인 분류 |
PatchGAN은 이미지 전체가 아니라 국소 패치의 진위를 판정하여 고주파 세부에 집중합니다. 두 출력이 특징 추출기를 공유하므로 분류에 쓰이는 특징이 진위 판별에도 쓰입니다.
🛡️ 3. WGAN-GP 적대 손실 (Eq. 8)
학습 안정화와 품질 향상을 위해 Eq. 1을 Wasserstein 거리 + 그래디언트 페널티로 바꿉니다.
\[\mathcal{L}_{adv}=\mathbb{E}_x\big[D_{src}(x)\big]-\mathbb{E}_{x,c}\big[D_{src}(G(x,c))\big]-\lambda_{gp}\,\mathbb{E}_{\hat x}\Big[\big(\|\nabla_{\hat x}D_{src}(\hat x)\|_2-1\big)^2\Big]\]$\hat x$ 는 진짜 이미지와 생성 이미지 쌍을 잇는 직선 위에서 균등 샘플링하며, $\lambda_{gp}=10$ 입니다. 판별기에 정규화 층이 없는 것도 WGAN-GP의 권고를 따른 것입니다.
⚙️ 4. 학습 설정 (Section 4.3)
| 항목 | 값 |
|---|---|
| 최적화 | Adam, $\beta_1=0.5$, $\beta_2=0.999$ |
| 배치 | 16 |
| 판별기/생성기 갱신 비 | 5 : 1 |
| 학습률 (CelebA) | 0.0001로 10 epoch, 이후 10 epoch 동안 선형 감소 |
| 학습률 (RaFD) | 0.0001로 100 epoch, 이후 100 epoch 동안 선형 감소 (데이터 부족 보상) |
| 증강 | 수평 뒤집기 확률 0.5 |
| 하드웨어 | NVIDIA Tesla M40 1장, 약 1일 (256×256 다중 데이터셋 모델은 약 7일) |
💡 Key Takeaway 구조는 CycleGAN 생성기 + PatchGAN 판별기 + 보조 분류기 로 거의 표준 부품입니다. StarGAN의 기여가 아키텍처가 아니라 조건화와 손실 설계에 있다는 점을 보여줍니다.
실험: CelebA 속성 변환과 RaFD 표정 합성
평가는 두 데이터셋, 세 가지 방식(AMT 지각 평가, 분류 오류율, 파라미터 수)으로 이루어집니다(Section 5). 비교 대상 DIAT, CycleGAN, IcGAN은 모두 2-도메인 모델이므로 도메인 쌍마다 따로 학습했습니다.
🗂️ 1. 데이터셋 (Section 4.1)
| 데이터셋 | 규모 | 사용 라벨 | 전처리 |
|---|---|---|---|
| CelebA | 202,599장, 40개 이진 속성 | 머리색(검정/금발/갈색), 성별, 나이 → 7개 도메인 | 178×218 → 178×178 크롭 → 128×128, 테스트 2,000장 |
| RaFD | 67명, 4,824장 | 8가지 표정 (분노, 경멸, 혐오, 공포, 행복, 슬픔, 놀람, 중립) | 얼굴 중심 256×256 크롭 → 128×128 |
👥 2. CelebA: AMT 지각 평가 (Table 1, 2, Figure 4)
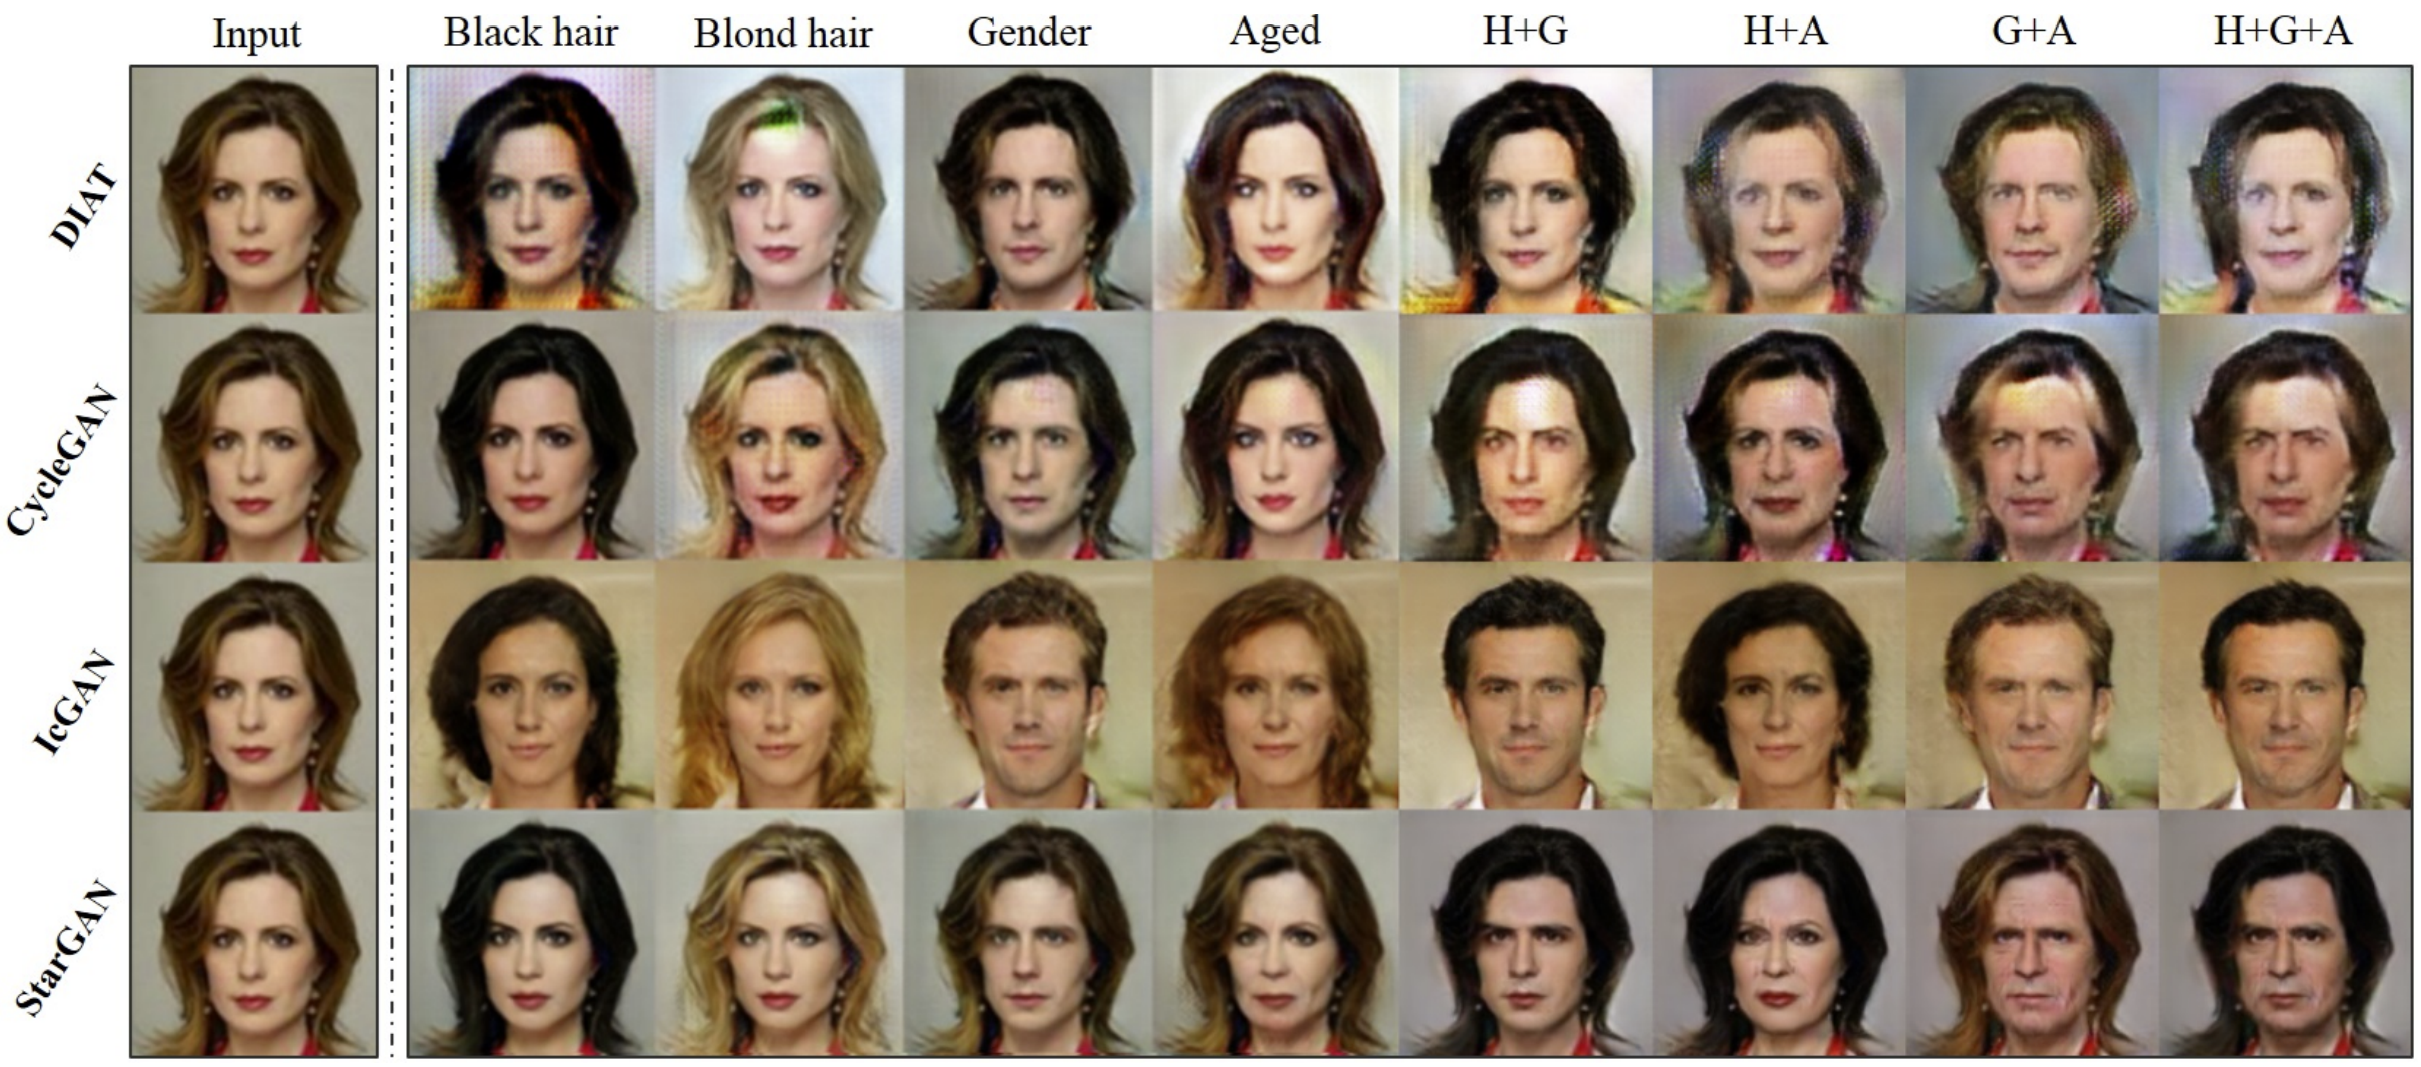
평가자는 사실성, 속성 변환 품질, 정체성 보존을 기준으로 네 방법 중 최선을 골랐습니다. 단일 속성 146명, 다중 속성 100명이 각각 30~40문항(검증 문항 포함)에 답했습니다.
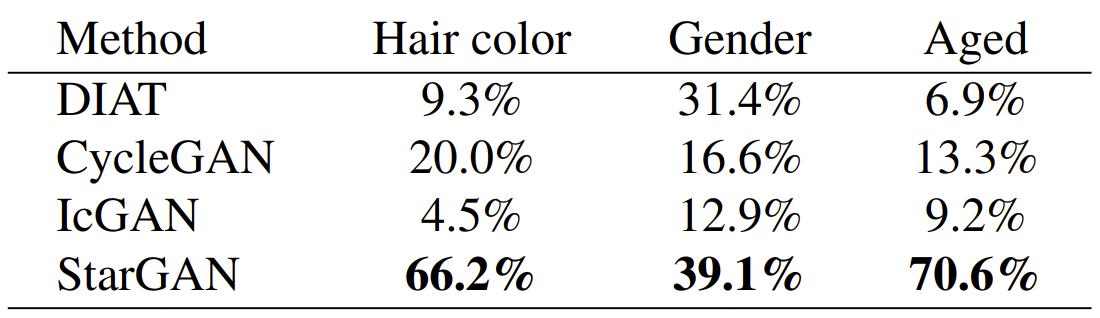
| 단일 속성 (득표 %) | 머리색 | 성별 | 나이 |
|---|---|---|---|
| DIAT | 9.3 | 31.4 | 6.9 |
| CycleGAN | 20.0 | 16.6 | 13.3 |
| IcGAN | 4.5 | 12.9 | 9.2 |
| StarGAN | 66.2 | 39.1 | 70.6 |
| 다중 속성 (득표 %) | 머리색+성별 | 머리색+나이 | 성별+나이 | 셋 모두 |
|---|---|---|---|---|
| DIAT | 20.4 | 15.6 | 18.7 | 15.6 |
| CycleGAN | 14.0 | 12.0 | 11.2 | 11.9 |
| IcGAN | 18.2 | 10.9 | 20.3 | 20.3 |
| StarGAN | 47.4 | 61.5 | 49.8 | 52.2 |
성별 변환에서 DIAT와의 차이는 작았습니다(39.1% vs. 31.4%). 다중 속성에서 StarGAN의 우위가 더 큰 것은, 2-도메인 모델이 여러 속성을 바꾸려면 변환을 여러 번 연쇄해야 해서 오류가 누적되는 반면 StarGAN은 한 번에 처리하기 때문입니다. 정성적으로(Figure 4) DIAT와 CycleGAN은 선명도가 떨어지고 흐릿하며, IcGAN은 정체성 보존에 실패하는 경우가 많았습니다.
🎭 3. RaFD: 분류 오류율과 파라미터 수 (Table 3, Figure 5)
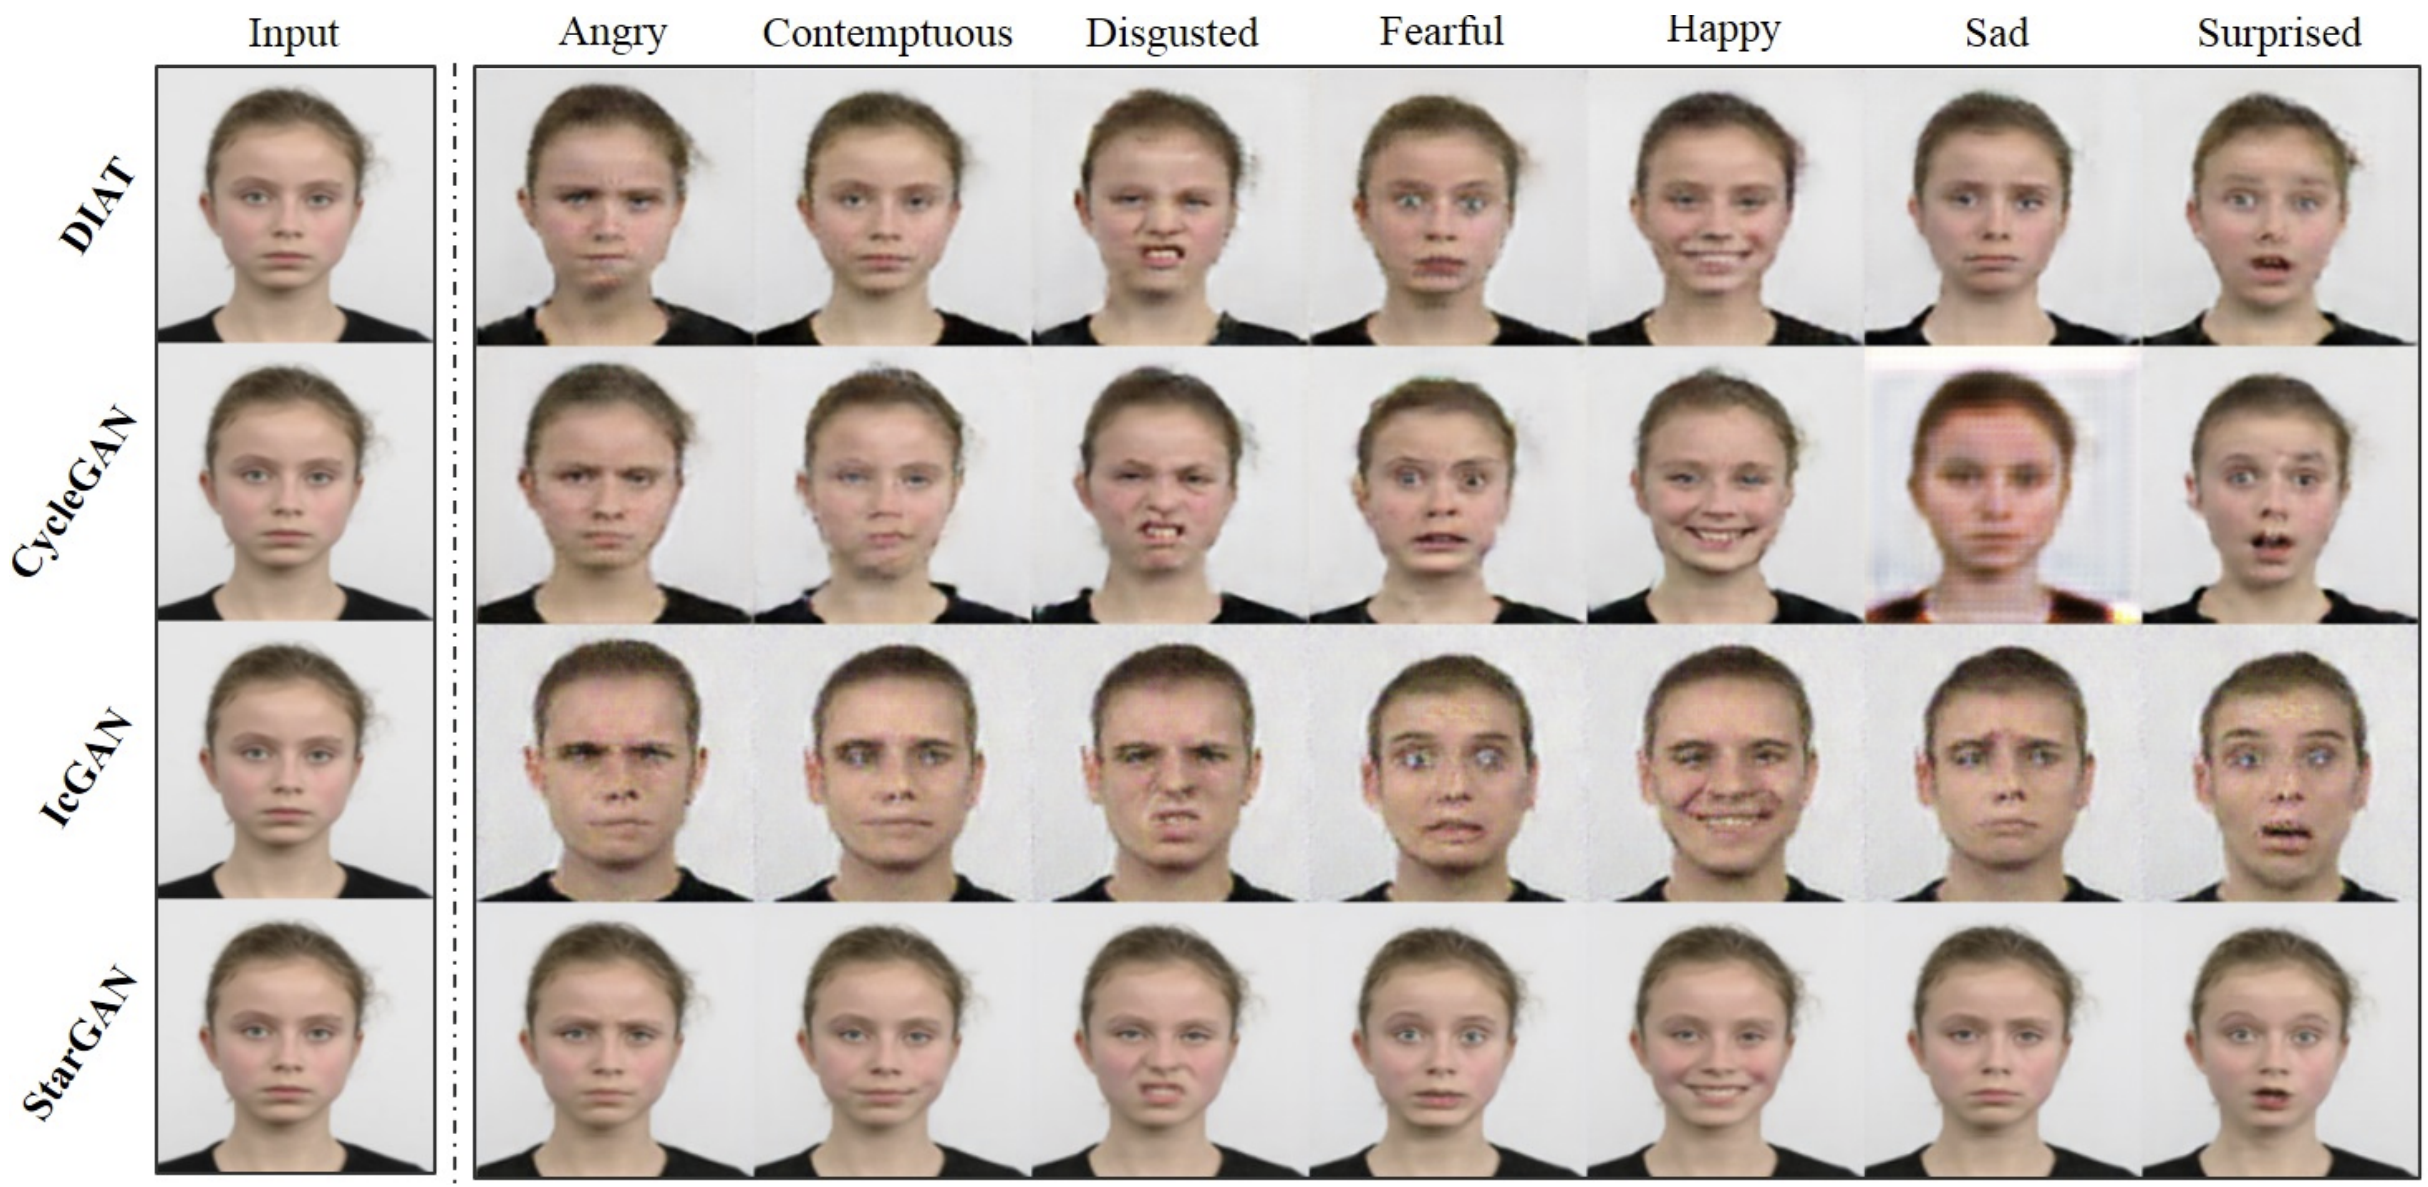
중립 표정을 입력으로 나머지 7개 표정으로 변환하고, 실제 RaFD로 학습한 ResNet-18 분류기(실제 이미지 정확도 99.55%)로 생성 이미지의 표정을 분류했습니다.
| 방법 | 분류 오류율 (%) | 파라미터 수 |
|---|---|---|
| DIAT | 4.10 | 52.6M × 7 |
| CycleGAN | 5.99 | 52.6M × 14 |
| IcGAN | 8.07 | 67.8M × 1 |
| StarGAN | 2.12 | 53.2M × 1 |
| 실제 이미지 | 0.45 | – |
StarGAN은 가장 낮은 오류율을 하나의 모델로 달성했습니다. DIAT는 중립→표정 7쌍, CycleGAN은 양방향 14개 생성기가 필요합니다. 저자들은 RaFD가 도메인당 약 500장에 불과한 상황에서 StarGAN이 모든 도메인 데이터를 한 생성기가 보는 다중 과제 학습의 정규화 효과 덕분에 더 좋은 품질을 냈다고 해석합니다.
💡 Key Takeaway 평가 결과는 “모델을 하나로 합치면 품질이 떨어진다”는 우려를 뒤집습니다. 데이터 전체를 보는 단일 생성기가 품질(오류율 2.12%)과 효율(파라미터 1/7~1/14)을 동시에 얻었습니다.
한계와 열린 방향
StarGAN은 다중 도메인 변환의 기준 모델이 되었지만, 설계상의 한계가 뚜렷했고 그 한계가 2년 뒤 StarGAN v2의 설계 동기가 되었습니다.
⚠️ 1. 한계
- 결정론적 일대일 변환: 입력과 목표 라벨이 같으면 항상 같은 출력이 나옵니다. “금발”이라는 도메인 안에도 다양한 금발 스타일이 있지만 StarGAN은 도메인당 하나의 결과만 냅니다. 다양성(diversity)이 없습니다.
- 라벨은 사람이 정의한 이산 속성: 변환할 수 있는 것은 데이터셋에 라벨로 주어진 속성뿐입니다. 라벨이 없는 스타일(헤어스타일 세부, 화장 등)은 제어할 수 없고, 참조 이미지로부터 스타일을 가져오는 것도 불가능합니다.
- 라벨 주입 방식의 한계: 라벨을 공간 복제해 입력에 붙이는 방식은 단순하지만, 생성기 깊은 층까지 조건 정보를 전달하기에 약합니다.
- 평가의 한계: AMT 평가는 참가자 수가 제한적이고, RaFD 평가는 분류기 하나에 의존합니다. FID 같은 분포 수준 지표가 없어 품질과 다양성을 객관적으로 비교하기 어렵습니다.
- 실험 범위: 데이터셋 2개, 속성 소수에 그칩니다. 논문에 별도의 한계 절은 없으며 위 항목 대부분은 후속 연구에서 지적된 것입니다.
- 논문 자체가 언급한 제약: RaFD는 도메인당 약 500장으로 작아 단독 학습 시 품질이 제한됩니다. 공동 학습이 이를 완화했지만 근본 해법은 아닙니다.
🔭 2. StarGAN v2로의 연결
| StarGAN의 한계 | StarGAN v2 (Choi et al., CVPR 2020)의 해법 |
|---|---|
| 도메인당 하나의 출력 | 스타일 코드 $s$ 를 도입해 같은 도메인 안에서 다양한 출력 생성 |
| 라벨만으로 조건화 | 매핑 네트워크 $F$ (잠재 → 스타일)와 스타일 인코더 $E$ (참조 이미지 → 스타일)로 잠재 기반·참조 기반 합성 모두 지원 |
| 라벨 공간 복제 입력 | AdaIN 으로 스타일 코드를 생성기에 주입 |
| 단일 분류 헤드 | 도메인별 출력 분기를 가진 다중 과제 판별기 |
| 다양성 측정 부재 | FID + LPIPS 로 품질과 다양성을 함께 평가 |
StarGAN v2의 Table 1은 StarGAN 기준선(FID 98.4)에서 시작해 각 요소를 추가하며 FID 13.7까지 내려가는 과정을 보여주는데, 이는 곧 StarGAN의 한계 목록을 하나씩 지워 나간 기록입니다.
🧭 3. 이 논문의 위치
StarGAN은 “조건 라벨 + 보조 분류기 + 순환 일관성” 이라는 조합으로 다중 도메인 변환을 정의한 논문입니다. 이후 다중 도메인 변환 연구(StarGAN v2, DRIT++, AttGAN, STGAN, RelGAN 등)는 대부분 이 틀을 기준선으로 삼았고, 마스크 벡터 방식의 부분 라벨 학습은 다중 데이터셋 공동 학습의 간단한 선례로 남았습니다.
💡 Key Takeaway StarGAN은 확장성 문제를 풀었지만 다양성 문제는 남겼습니다. “도메인 라벨”에서 “스타일 코드”로의 전환이 StarGAN v2의 핵심이며, 그 출발점이 바로 이 논문의 결정론적 일대일 변환이라는 한계입니다.