 You know maize mean?
InsetGAN for Full-Body Image Generation
0. Summary
기본 정보 : ArXiv,2022.03.14 (CVPR 2022), InsetGAN for Full-Body Image Generation
연구 배경
StyleGAN 계열은 얼굴·자동차·풍경처럼 정렬이 잘 된 단일 물체 클래스에서는 사진 수준의 이미지를 만들지만, 전신 인물 생성은 여전히 어려운 문제로 남아 있었다. 정체성·헤어스타일·의상·자세의 변동이 매우 크고, 손·발·얼굴 같은 부위가 학습 이미지마다 다른 위치에 나타나 정렬이 어렵기 때문이다. 기존 전신 생성·편집 연구는 대부분 256×256이나 512×512에 머물렀고, 이미지를 타일로 나눠 순차 생성하는 방식은 부위 간 비국소적 결합을 다루지 못했다. 단일 GAN을 1024×1024로 학습하면 전체 비율은 맞아도 얼굴과 사지에 눈에 띄는 아티팩트가 남았다(Figure 1a, Figure 3). 사람은 얼굴 아티팩트에 특히 민감하기 때문에 이 결함이 결과 전체의 설득력을 떨어뜨렸다.
제안 방법
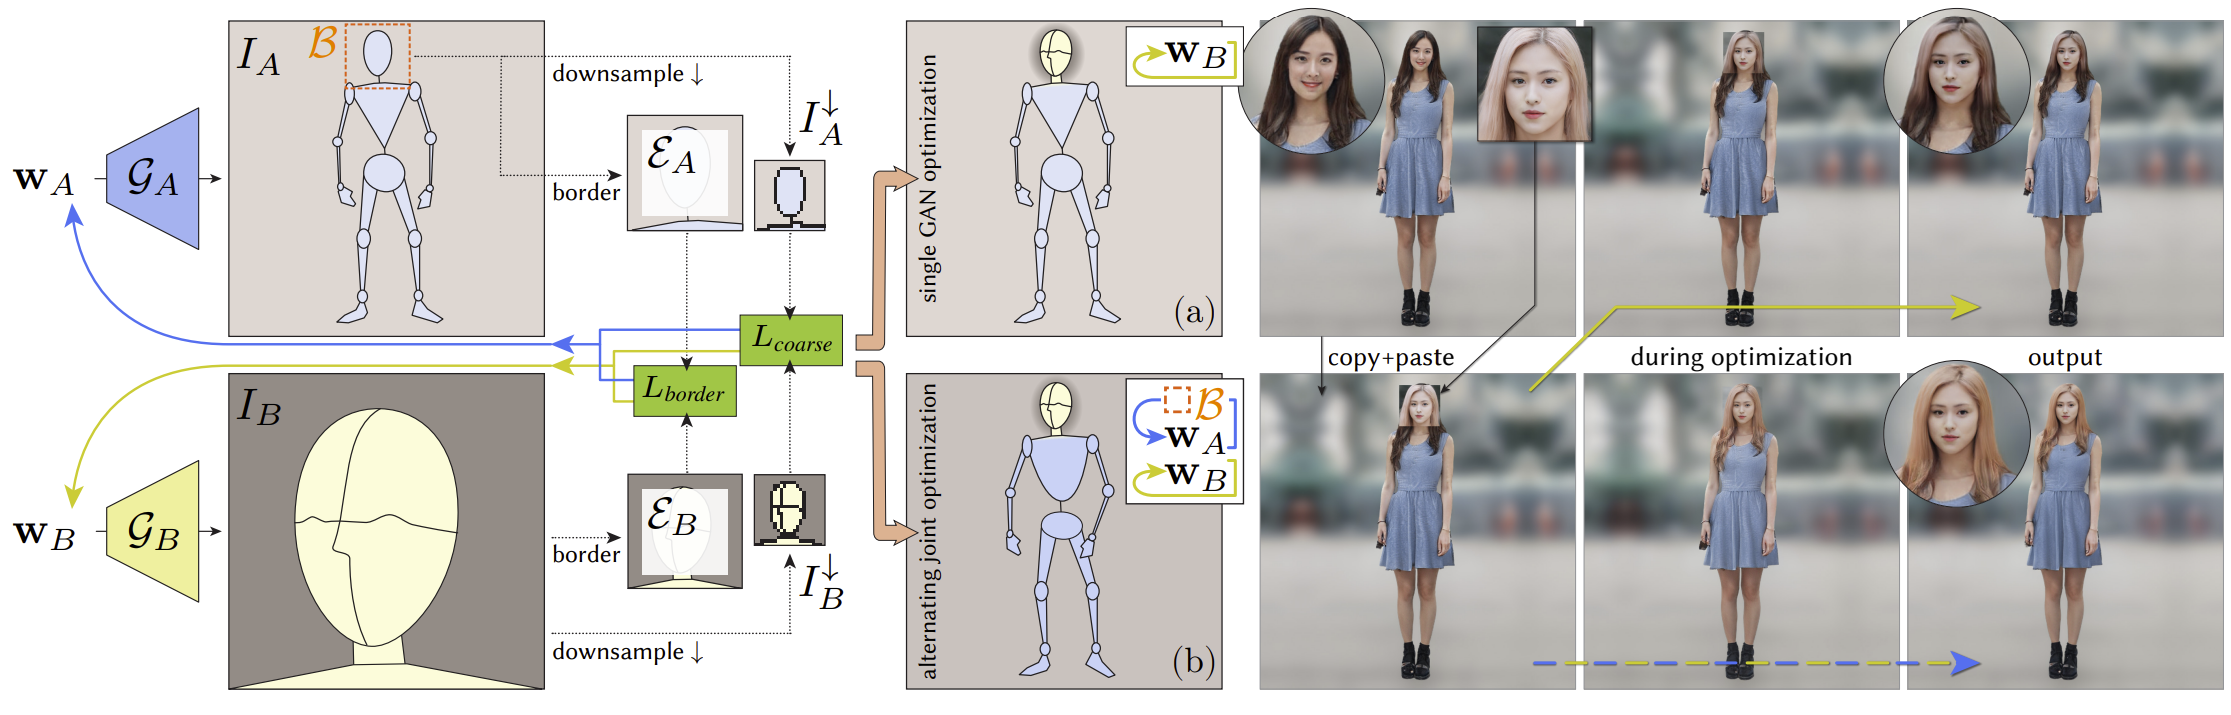
InsetGAN은 하나의 GAN으로 복잡한 도메인 전체를 모델링하는 대신 사전 학습된 여러 GAN을 조합한다. 캔버스 생성기 $G_A$ 가 전신 이미지 $I_A=G_A(w_A)$ 를 만들고, 전문화된 인셋(inset) 생성기 $G_B$ 가 얼굴(또는 신발 등) 이미지 $I_B=G_B(w_B)$ 를 만들며, 얼굴 검출기로 찾은 바운딩 박스 $B(I_A)$ 영역의 픽셀을 $I_B$ 로 직접 교체한다. 핵심은 교체 경계에 이음새(seam)가 생기지 않도록 두 생성기의 잠재 코드 $(w_A,w_B)$ 를 공동으로 최적화하는 것이다. 손실은 64×64로 다운샘플한 두 얼굴 영역의 L1+LPIPS로 거친 외형(피부색 등)을 맞추는 $L_{coarse}$, 폭 8픽셀 테두리의 L1+LPIPS로 경계를 맞추는 $L_{border}$, 평균 잠재에서 멀어지지 않게 하고 $w^+$ 오프셋을 억제하는 $L_{reg}$, 그리고 응용에 따라 몸 또는 얼굴을 참조 이미지에 고정하는 $L_{body}$, $L_{face}$ 로 구성된다. 바운딩 박스가 $w_A$ 에 의존하기 때문에 $w_A$ 와 $w_B$ 를 번갈아 최적화하고 $w_A$ 갱신 뒤마다 경계를 다시 평가한다.
발견 사실
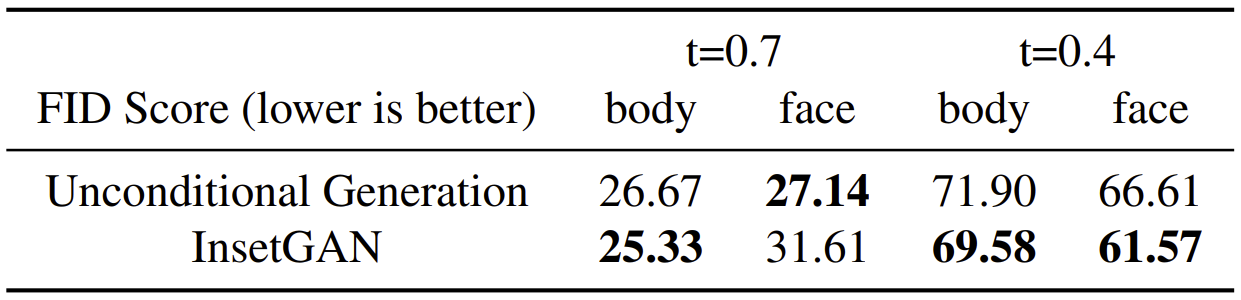
83,972장의 자체 전신 데이터셋으로 StyleGAN2-ADA를 1024×1024에서 학습한 캔버스 생성기에 얼굴 GAN을 결합하면, 얼굴 영역의 아티팩트가 제거되고 머리카락·피부색이 몸과 자연스럽게 이어졌다(Figure 5). Amazon Mechanical Turk 사용자 연구에서 98% 의 이미지 쌍에서 공동 최적화 결과가 정제 전 결과보다 선호되었고, 같은 과제에 CoModGAN을 쓰면 7%만 선호되었다. 1초만 보여줬을 때 정제 전 생성 결과가 실제 학습 이미지보다 선호된 비율은 12.4%였다. FID는 정제 전후에 거의 차이가 없어(Table 1) 공동 최적화가 생성기의 분포와 다양성을 해치지 않음을 보였으며, 저자들은 FID가 지각 품질보다 다양성에 민감하다고 지적했다(절단 없음 13.96, $t=0.7$ 에서 26.67, $t=0.4$ 에서 71.90). 같은 틀로 주어진 얼굴에 맞는 다양한 몸 생성(Figure 6), 얼굴-몸 몽타주(Figure 7), 얼굴과 신발 두 인셋 동시 최적화(Figure 4)가 가능했다.
핵심 기여
- 다중 GAN 공동 잠재 최적화 프레임워크 : 캔버스 GAN과 하나 이상의 부위 GAN의 잠재 코드를 함께 최적화해, 부위 결과를 캔버스에 인셋으로 붙여도 경계 아티팩트가 없는 일관된 합성 결과를 얻는 방법을 제안했다. 각 GAN은 서로 다른 데이터·해상도로 독립 학습될 수 있다.
- 1024×1024 무조건 전신 인물 생성의 첫 실용 파이프라인 : 83,972장의 정렬된 전신 데이터셋을 구축하고, 이 해상도에서 그럴듯한 전신 인물을 조건 없이 생성하는 첫 결과를 보였다.
- 하나의 손실 조합으로 여러 응용 : 얼굴 정제, 얼굴 조건 몸 생성, 얼굴-몸 몽타주, 다중 인셋을 $L_{coarse}, L_{border}, L_{reg}, L_{body}, L_{face}$ 의 조합만 바꿔 처리했으며, CoModGAN 대비 사용자 선호에서 압도적 차이를 확인했다.
관련 개념
전신 인물 생성이 어려운 이유와 “분할 정복” 전략
무조건 전신 인물 생성(unconditional full-body human generation) 은 포즈·세그멘테이션 같은 조건 없이 잠재 벡터만으로 사람 전체를 그리는 문제입니다. 얼굴 생성(FFHQ)과 비교하면 변동 요인의 수와 정렬의 어려움이 차원이 다릅니다. 이 논문은 “더 큰 GAN을 하나 학습한다”는 길 대신 여러 GAN을 조정(coordinate)한다는 길을 택합니다.
🧩 1. 기존 접근의 분류 (Section 2)
| 접근 | 예 | 한계 |
|---|---|---|
| 단일 고해상도 GAN | StyleGAN2를 전신에 학습 | 얼굴·사지 아티팩트, 고품질 대규모 데이터 필요 |
| 타일 분할 순차 생성 | 타일 기반 GAN | 부위 간 비국소 결합(피부색, 머리 흐름)을 통계적으로 모델링하기 어려움 |
| 조건부 생성 | 포즈·세그멘테이션 조건 | 제어는 좋지만 대부분 1024×1024 미지원, 조건 입력 필요 |
| 조건부 콜라주 | CollageGAN | 의미 맵이 힌트로 주어지는 조건부 설정 |
| 아웃페인팅 | CoModGAN | 얼굴 구멍 채우기로 전용 가능하나 품질 한계 (Section 5 비교) |
InsetGAN이 다루는 것은 의미 맵 없이 생성기들끼리 모양과 외형을 스스로 합의해야 하는 무조건 설정입니다. 저자들은 이것이 CollageGAN보다 어려운 문제라고 강조합니다.
🎯 2. 캔버스 + 인셋 설계의 세 가지 이점 (Section 1)
- 캔버스 GAN은 중간 품질 데이터로 충분합니다. 부위가 정렬되지 않아 개별 부위가 흐릿해도, 나중에 삽입될 부위들의 전역 조정만 제공하면 됩니다.
- 부위 GAN은 부위별 데이터로 학습하므로 정렬이 쉽고 품질이 높습니다. 같은 데이터셋에서 얼굴을 크롭해 쓸 수도 있고 FFHQ 같은 외부 생성기를 가져올 수도 있습니다.
- 서로 다른 해상도로 학습 가능해 데이터 품질 요구가 낮아집니다. 논문은 256×256 얼굴 GAN을 1024×1024 캔버스에 결합합니다.
🔗 3. 남는 문제: 조정(coordination)
부위를 캔버스에 붙였을 때 경계에 이음새가 보이지 않으려면 피부색, 옷 경계, 머리카락 흐름이 양쪽에서 일치해야 합니다. 경계 조건이 자명하지 않고 인셋 경계 자체(얼굴 위치)가 미리 정해져 있지 않다는 점이 어려움입니다. Figure 2 우측은 단순 복사·붙여넣기가 경계 아티팩트를 만드는 것과, 한쪽만 최적화할 때보다 양쪽을 함께 최적화할 때 머리카락과 피부색이 더 자연스럽게 이어지는 것을 보여줍니다.
💡 Key Takeaway InsetGAN의 전제는 “큰 문제 하나보다 전역 캔버스 + 국소 전문가 가 낫다”는 것입니다. 남는 과제는 전문가들이 서로 모순되지 않게 만드는 조정이며, 이것을 잠재 공간 최적화로 풉니다.
다중 GAN 잠재 공동 최적화 문제의 정식화
다중 GAN 최적화(Multi-GAN Optimization) 는 사전 학습된 생성기들의 가중치는 고정한 채, 각 생성기의 잠재 코드만 움직여 합성 결과를 일관되게 만드는 문제입니다(Section 3.2). GAN 역변환(inversion)과 같은 도구를 쓰지만, 목표가 “실제 이미지 복원”이 아니라 “두 생성기의 합의”라는 점이 다릅니다.
🧮 1. 문제 정의
캔버스 생성기 $G_A$ 와 인셋 생성기 $G_B$, 잠재 코드 $w_A, w_B$ 에 대해 $I_A:=G_A(w_A)$, $I_B:=G_B(w_B)$ 라 합니다. 바운딩 박스 검출기로 $I_A$ 에서 인셋에 해당하는 영역을 찾아 크롭한 것을 $B(I_A)$ 라 하면, 최종 이미지는 $B(I_A)$ 안의 픽셀을 $I_B$ 로 직접 교체해 만듭니다. 최적화 문제는
\[\min_{w_A,\,w_B}\int_{\Omega}L\big(G_A(w_A),G_B(w_B)\big),\qquad \Omega:=B\big(G_A(w_A)\big)\]입니다. $L$ 은 $\Omega$ 의 경계를 따라 이음새 품질을, $\Omega$ 내부에서 두 얼굴의 유사도를 함께 측정합니다. 어려운 점은 관심 영역 $\Omega$ 자체가 $w_A$ 에 의존한다는 것입니다. $w_A$ 가 바뀌면 얼굴 위치가 바뀌고, 그러면 경계 조건도 바뀝니다.
🎯 2. 세 가지 최적화 목표 (Section 3.2, Optimization Objectives)
| 목표 | 내용 | 담당 손실 |
|---|---|---|
| (I) 거친 외형 일치 | 얼굴 GAN과 몸 GAN의 얼굴 영역이 거친 스케일에서 비슷해야 함 (예: 얼굴 피부색 = 목 피부색) | $L_{coarse}$ |
| (II) 경계 픽셀 일치 | 얼굴 크롭 주변 테두리가 맞아 복사·붙여넣기로 이음새가 안 보여야 함 | $L_{border}$ |
| (III) 사실성 유지 | 최적화 중 잠재가 비현실적 영역으로 가지 않아야 함 | $L_{reg}$ |
🔁 3. $w^+$ 공간과 번갈아 최적화
StyleGAN2 추론에서는 512차원 $w$ 하나가 모든 층에 들어가지만, 역변환 연구들은 층마다 다른 코드를 허용하는 $n\times 512$ 차원 $w^+$ 공간에서 최적화합니다. 논문은 최근 연구를 따라 $w^+$ 를 단일 기저 $w^$ 와 층별 오프셋 $\delta_i$ 로 분해하고(층 $i$ 의 잠재는 $w^+\delta_i$), $\delta_i$ 가 작게 유지되도록 L2로 정규화합니다.
$\Omega$ 가 $w_A$ 에 의존하는 문제는 $w_A$ 와 $w_B$ 를 번갈아 최적화하고, $w_A$ 를 갱신할 때마다 경계를 다시 평가하는 것으로 해결합니다. 보충 자료에 따르면 두 잠재에 별도의 Adam 최적화기를 두고 50회 반복마다 대상을 바꾸며, 얼굴 바운딩 박스는 초반 일정 기간(몸 생성 약 150회, 얼굴 정제 약 75회) 동안 25회마다 재평가한 뒤 고정합니다. 너무 자주 또는 너무 오래 재평가하면 최적화가 불안정해진다고 합니다.
💡 Key Takeaway InsetGAN은 생성기를 재학습하지 않습니다. 두 잠재 코드를 번갈아 움직여 얼굴 GAN과 몸 GAN이 서로의 경계 조건을 만족하는 점을 찾는 것이 전부이며, 그래서 어떤 사전 학습 GAN 쌍에도 적용할 수 있습니다.
손실 함수의 구성
InsetGAN의 손실은 모두 L1 + LPIPS(지각 손실) 의 조합이며, 적용되는 영역(다운샘플 얼굴, 테두리, 얼굴 바깥, 얼굴 안쪽)만 다릅니다. 응용에 따라 이 항들을 골라 더합니다(Section 3.2).
🧮 1. 다섯 가지 손실 항
거친 외형 손실. 두 얼굴 영역을 64×64로 다운샘플($D_{64}$)해 비교합니다.
\[L_{coarse}:=\lambda_1 L_1\big(I_A^{\downarrow},I_B^{\downarrow}\big)+\lambda_2 L_{lpips}\big(I_A^{\downarrow},I_B^{\downarrow}\big),\qquad I_A^{\downarrow}=D_{64}\big(B(I_A)\big),\;I_B^{\downarrow}=D_{64}(I_B)\]경계 손실. 전체 해상도에서 폭 8픽셀 테두리 $E_8(\cdot)$ 만 비교합니다.
\[L_{border}:=\lambda_3 L_1\big(E_8(B(I_A)),E_8(I_B)\big)+\lambda_4 L_{lpips}\big(E_8(B(I_A)),E_8(I_B)\big)\]정규화 손실. 기저 잠재가 평균 잠재 $w_{avg}$ 에서 멀어지지 않게 하고, $w^+$ 오프셋을 억제합니다.
\[L_{reg}:=\lambda_{r1}\|w^*-w_{avg}\|+\lambda_{r2}\sum_i\|\delta_i\|\]몸 보존 손실. 얼굴 바운딩 박스 바깥 영역 $R^O$ 를 참조 몸 $I_{ref}$ 와 같게 유지합니다.
\[L_{body}:=\lambda_5 L_1\big(R^O(I_A),R^O(I_{ref})\big)+\lambda_6 L_{lpips}\big(R^O(I_A),R^O(I_{ref})\big)\]얼굴 보존 손실. 얼굴 크롭 안쪽 영역 $R^I$ 를 참조 얼굴과 같게 유지합니다.
\[L_{face}:=\lambda_7 L_1\big(R^I(I_B),R^I(I_{ref})\big)+\lambda_8 L_{lpips}\big(R^I(I_B),R^I(I_{ref})\big)\]⚖️ 2. 가중치 (보충 자료)
| 가중치 | 몸 생성($L_{body}$ 사용) | 얼굴 정제($L_{face}$ 사용) |
|---|---|---|
| $\lambda_1$ (coarse L1) | 500 | 500 |
| $\lambda_2$ (coarse LPIPS) | 0.05 | 0.05 |
| $\lambda_3$ (border LPIPS) | – | 0.1 |
| $\lambda_4$ (border L1) | 2500 | 10000 |
| $\lambda_{r1}$ (mean-latent reg) | 25000 | – |
| $\lambda_5$ / $\lambda_6$ (target body L1 / LPIPS) | 9000 / 0.1 | – |
| $\lambda_7$ / $\lambda_8$ (target face L1 / LPIPS) | – | 5000 / 1.75 |
L1 가중치가 LPIPS보다 수천 배 큰 것은 두 손실의 스케일 차이 때문입니다. 저자들은 L2보다 L1이 시각적으로 약간 더 나았다고 보고합니다. 평균 잠재 정규화는 얼굴 생성기보다 몸 생성기에 더 큰 가중치를 둡니다.
🔍 3. 왜 다운샘플해서 비교하는가
$L_{coarse}$ 를 64×64에서 계산하는 이유는 두 가지입니다. 첫째, 최적화에 유연성을 주어 얼굴 GAN이 세부를 자유롭게 생성하게 합니다. 둘째, 몸 GAN의 얼굴 영역은 사실적인 고주파 세부가 없는 아티팩트 덩어리이므로, 전체 해상도에서 맞추면 그 아티팩트에 과적합합니다. 이는 PULSE(Menon et al., 2020)가 저해상도 제약만으로 고해상도 얼굴을 탐색하는 전략과 같습니다.
💡 Key Takeaway 손실은 “거칠게는 비슷하게, 경계는 정확하게, 나머지는 건드리지 말고, 잠재는 평균 근처에“라는 네 문장으로 요약됩니다. 응용은 이 중 어떤 영역을 참조에 고정하느냐($L_{body}$ 또는 $L_{face}$)로 결정됩니다.
응용별 목적 함수와 결과
같은 손실 항을 조합만 바꿔 네 가지 응용을 만듭니다(Section 3.2 후반, Figure 1, 5–8). 어떤 잠재를 고정하고 어떤 잠재를 움직이는지가 각 응용을 정의합니다.
🪄 1. 얼굴 정제 (Face Refinement, Figure 1b, 5)
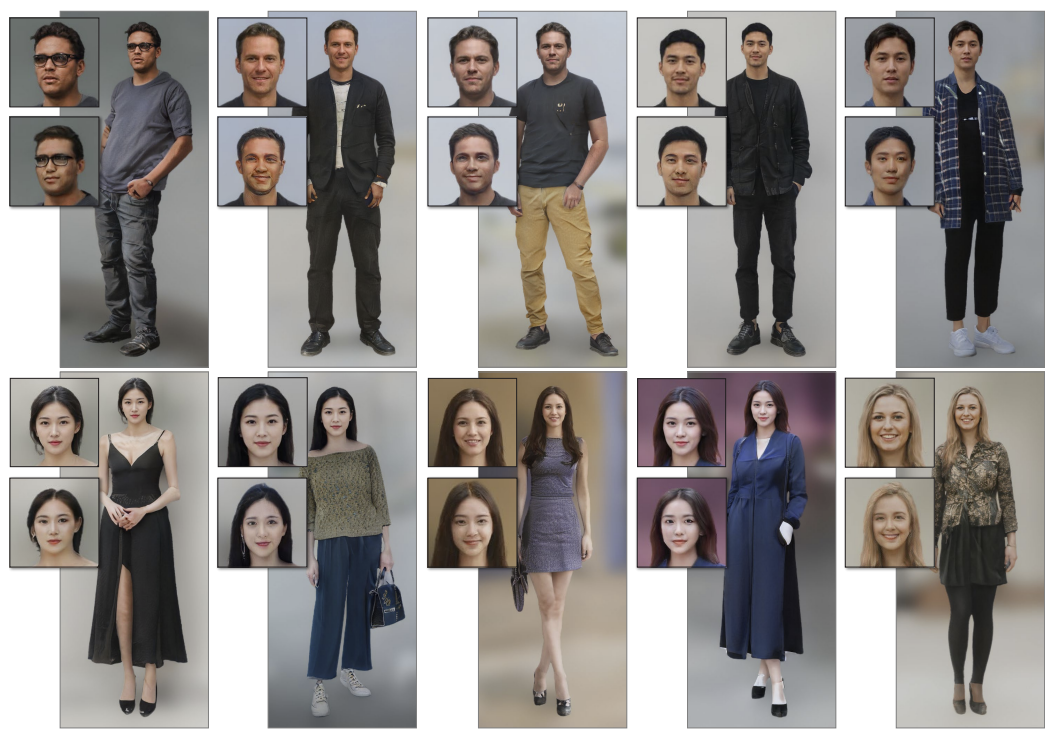
무작위 생성된 몸 $G_A(w_A)$ 의 얼굴을 얼굴 GAN으로 교체합니다.
| 방식 | 목적 함수 | 특징 |
|---|---|---|
| 단방향 ($w_A$ 고정) | $\min_{w_B}(L_{coarse}+L_{border})$ | 거의 만족스럽지만 때때로 경계 불연속 |
| 양방향 (공동 최적화) | $\min_{w_A,w_B}(L_{coarse}+L_{border}+L_{reg}+L_{body})$ | 몸 외형은 $L_{body}$ 로 유지하면서 경계가 자연스럽게 이어짐 |
얼굴 GAN은 같은 데이터에서 크롭한 얼굴로 학습한 자체 모델이든, 사전 학습 FFHQ 모델이든 비슷한 품질을 냈습니다. DeepFashion 몸 생성기에 FFHQ 얼굴을 다양한 초기화로 끼우면 같은 몸에 어울리는 여러 얼굴이 나옵니다(Figure 8).
🧍 2. 주어진 얼굴에 맞는 몸 생성 (Figure 1c, 6)
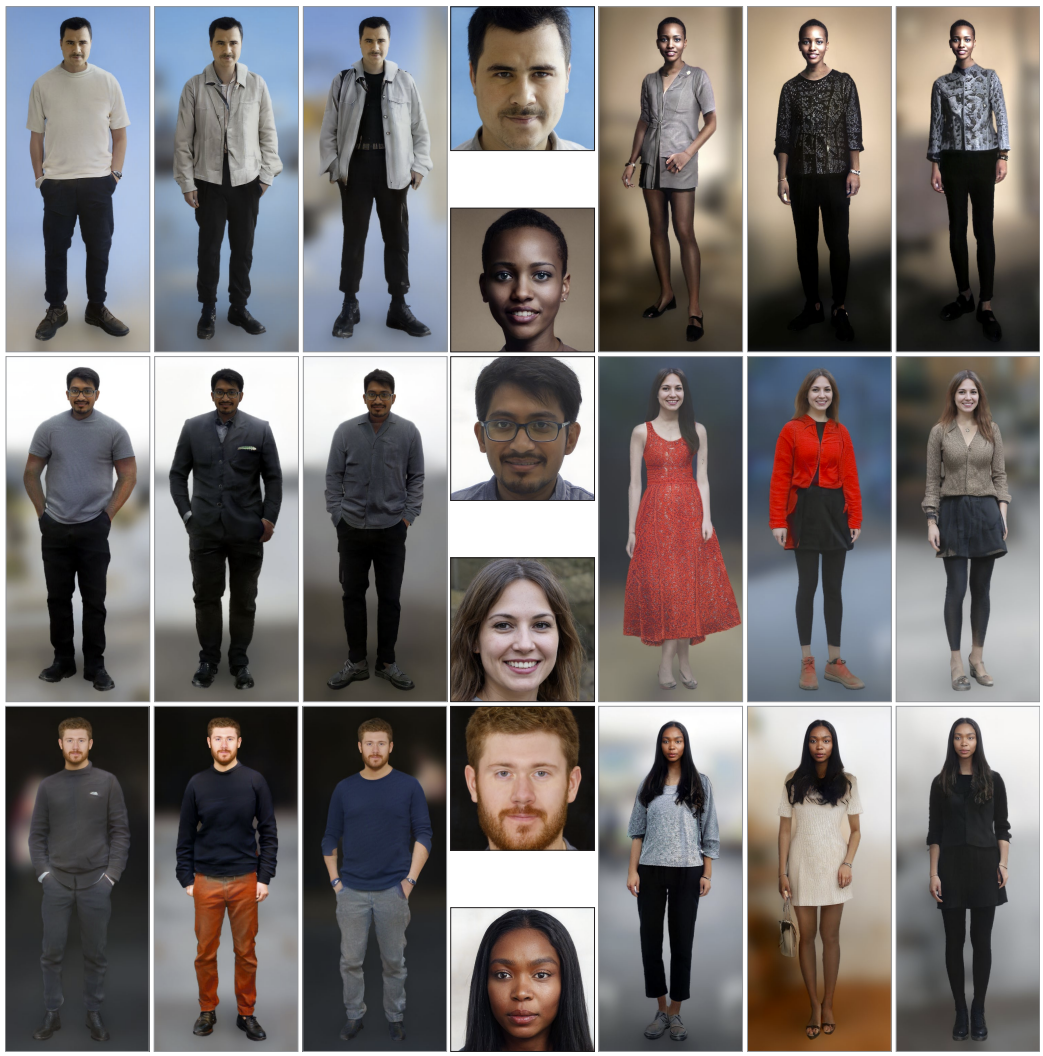
실제 얼굴 또는 생성 얼굴 $G_B(w_B)$ 에 대해 자세·피부색·성별·헤어스타일이 어울리는 몸을 찾습니다.
\[\min_{w_A,\,w_B}\big(L_{coarse}+L_{border}+L_{reg}+L_{face}\big)\]$w_B$ 를 완전히 고정하지 않고 $L_{face}$ 로 얼굴 내부만 보존하는 이유는, 복잡한 헤어스타일에서 경계와 배경 픽셀이 약간 조정될 수 있어야 $w_A$ 최적화가 쉬워지기 때문입니다. $w_A$ 를 절단된 무작위 잠재 $w_{trunc}=w_{rand}(1-\alpha)+w_{avg}\alpha$ 로 다르게 초기화하면 한 얼굴에 여러 몸이 나오며, 생성된 몸의 피부색은 대체로 입력 얼굴과 일치합니다.
🧑🤝🧑 3. 얼굴-몸 몽타주 (Figure 1d, 7)
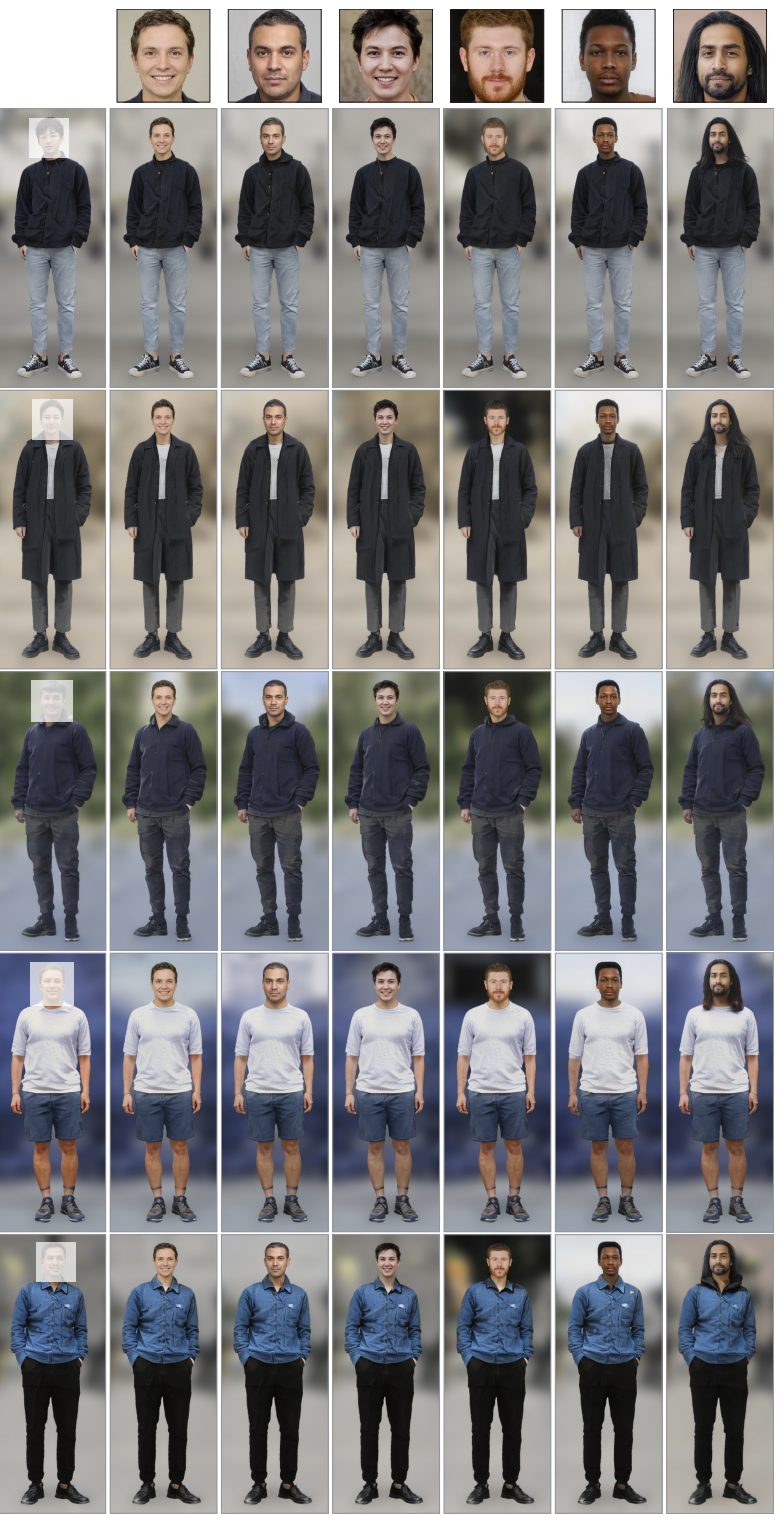
특정 얼굴과 특정 몸을 모두 지정해 결합합니다.
\[\min_{w_A,\,w_B}\big(L_{coarse}+L_{border}+L_{reg}+L_{face}+L_{body}\big)\]실제 얼굴은 기성 인코더로 $G_B$ 의 잠재 공간에 임베딩합니다. 실제 몸은 변동이 커서 낮은 복원 오차를 얻기 어려우므로 몽타주의 몸은 모두 합성 몸입니다. 피부색 일치를 강제하는 손실이 없는데도 공동 최적화가 목과 손의 피부색을 얼굴에 맞게 약간 조정하고, 머리카락이 어깨에 자연스럽게 놓이도록 어깨 영역을 바꾸는 현상이 관찰됩니다.
👟 4. 다중 인셋 (Figure 4)
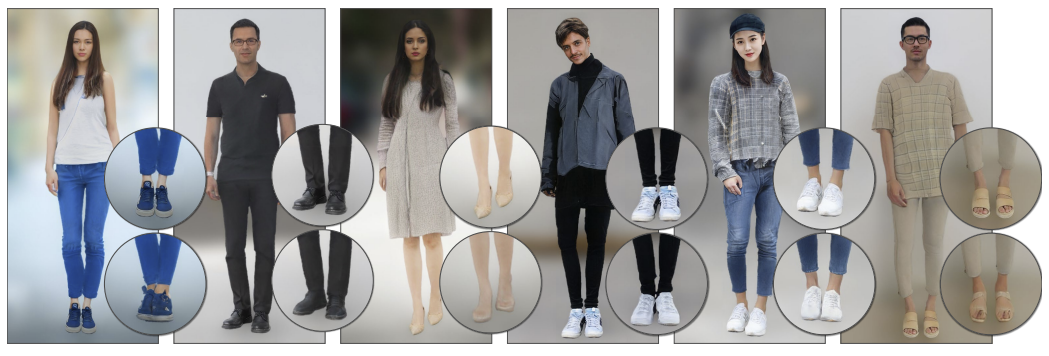
전신 데이터에서 신발을 크롭해 학습한 신발 GAN(256×256)을 추가하면, 캔버스·얼굴·신발 세 생성기를 공동 최적화해 두 부위를 동시에 개선할 수 있습니다. 프레임워크가 인셋 수에 대해 열려 있음을 보이는 예시입니다.
💡 Key Takeaway 네 응용의 차이는 무엇을 참조에 고정하느냐뿐입니다. 몸을 고정하면 얼굴 정제, 얼굴을 고정하면 몸 생성, 둘 다 고정하면 몽타주가 됩니다.
데이터셋과 학습·최적화 설정
InsetGAN의 결과 품질은 상당 부분 정렬된 전신 데이터셋에 의존합니다. Section 4는 데이터 구축 방식과 생성기 학습 설정을 자세히 적고 있으며, 이 부분이 “1024×1024 전신 생성의 첫 실용 파이프라인”이라는 주장의 근거입니다.
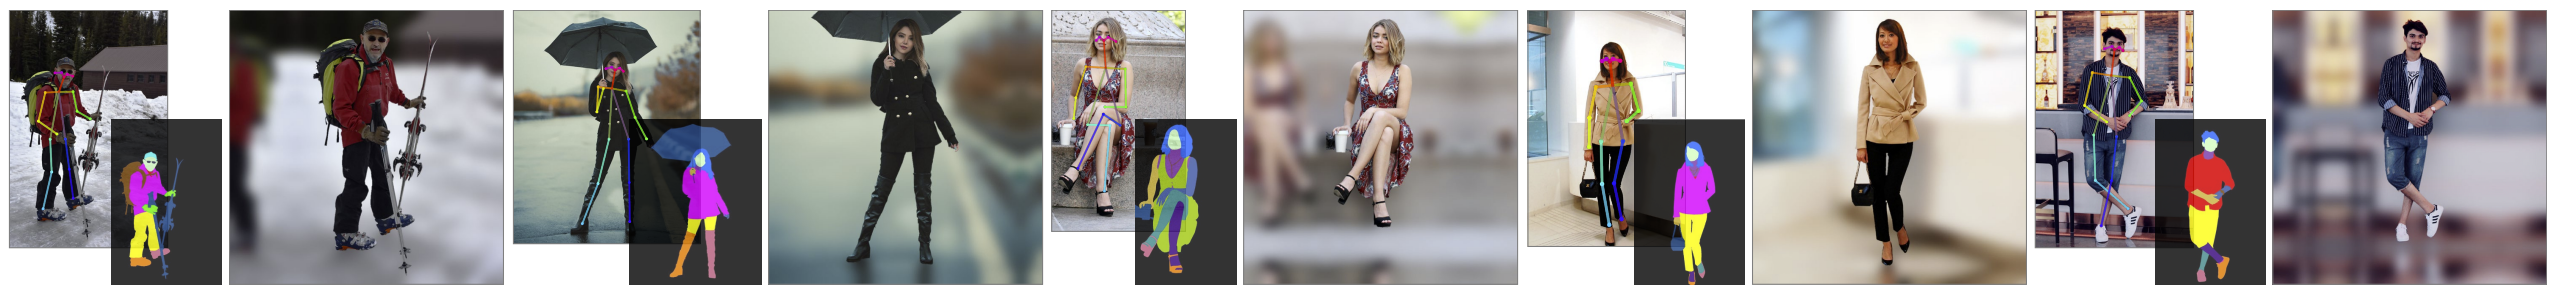
🗂️ 1. 자체 전신 데이터셋 (Figure 9)
| 항목 | 값 |
|---|---|
| 원본 | 제3자 벤더에서 구매한 자연 환경 사진 100,718장, 수작업 세그멘테이션 마스크 포함 |
| 필터링 | 포즈 검출 신뢰도가 낮은 극단적 포즈 제거 → 83,972장 |
| 해상도 | 1024×1024 |
| 정렬 | 목–엉덩이 관절로 상체 축을 정의해 이미지 중앙에 수직 정렬, 상체 길이로 스케일 조정, 얼굴 길이가 최소/최대 범위를 벗어나면 재조정 |
| 배경 | 반사 패딩으로 확장 후 크기 27 가우시안 커널로 강하게 블러 |
배경을 완전히 제거하지 않은 이유는 (1) 세그멘테이션 마스크가 경계에서 불완전하고 (2) 현재 GAN이 넓은 단색 영역을 잘 다루지 못하기 때문입니다. FFHQ의 품질이 정렬 덕분이라는 관찰에 따라 정렬에 특히 공을 들였습니다.
🏋️ 2. 생성기 학습 설정
| 생성기 | 아키텍처 | 해상도 | 학습 |
|---|---|---|---|
| 자체 전신 | StyleGAN2-ADA (모든 증강 사용), R1 $\gamma=13$ | 1024×1024 | Titan V 4장, 배치 4, 42M 이미지, 28일 18시간 |
| DeepFashion 전신 | StyleGAN2-ADA | 1024×768 | V100 4장, 배치 8, 18M 이미지, 9일 (66,607장 중 정렬 추출 10,145장) |
| 자체 얼굴 | StyleGAN2, 전신 데이터에서 크롭 | 256×256 | – |
| FFHQ 얼굴 | 사전 학습 모델 | 1024×1024 | – |
StyleGAN3 대신 StyleGAN2-ADA를 택한 것은 이 도메인에서 FID와 Precision/Recall이 더 좋았기 때문입니다. R1 $\gamma$ 는 0.1~20 범위를 실험해 13을 골랐습니다.
⚙️ 3. 최적화 설정
| 항목 | 값 |
|---|---|
| 얼굴 검출·정렬 | 사전 학습 FaceNet |
| 실행 시간 | 1024×1024 두 생성기 공동 최적화 약 75초 (Titan RTX), $G_B$ 가 256×256이면 약 60초 |
| 초기화 | 기본은 $w_{avg}$. 다양성이 필요하면 절단 잠재 $w_{trunc}$, 참조를 고정할 때는 참조 생성에 쓴 잠재 |
| 학습률 (보충) | 캔버스 0.05, 인셋 0.002 |
| 종료 (보충) | 테두리 L1 < 0.09 또는 약 1000 스텝 |
| 무조건 샘플링 (보충) | 18개 층에 대해 층별 적응 절단. 아티팩트가 많은 4~7층을 가장 강하게 절단 |
💡 Key Takeaway 전신 생성의 절반은 데이터 정렬입니다. 83,972장을 상체 축과 얼굴 크기로 정렬하고 배경을 블러한 것이 1024×1024 캔버스 생성기를 가능하게 했고, InsetGAN은 그 위에서 남은 얼굴 결함을 처리합니다.
무조건 생성과 적응 절단(Adaptive Truncation)
InsetGAN의 출발점은 캔버스 생성기의 무조건 샘플입니다(Section 3.1, Figure 3). 이 샘플의 품질이 결과의 상한을 정하므로, 논문은 StyleGAN의 절단 기법(truncation trick)을 층별로 조정한 적응 절단을 보충 자료에서 제안합니다.
🧍 1. 캔버스 생성기의 무조건 샘플 (Figure 3)
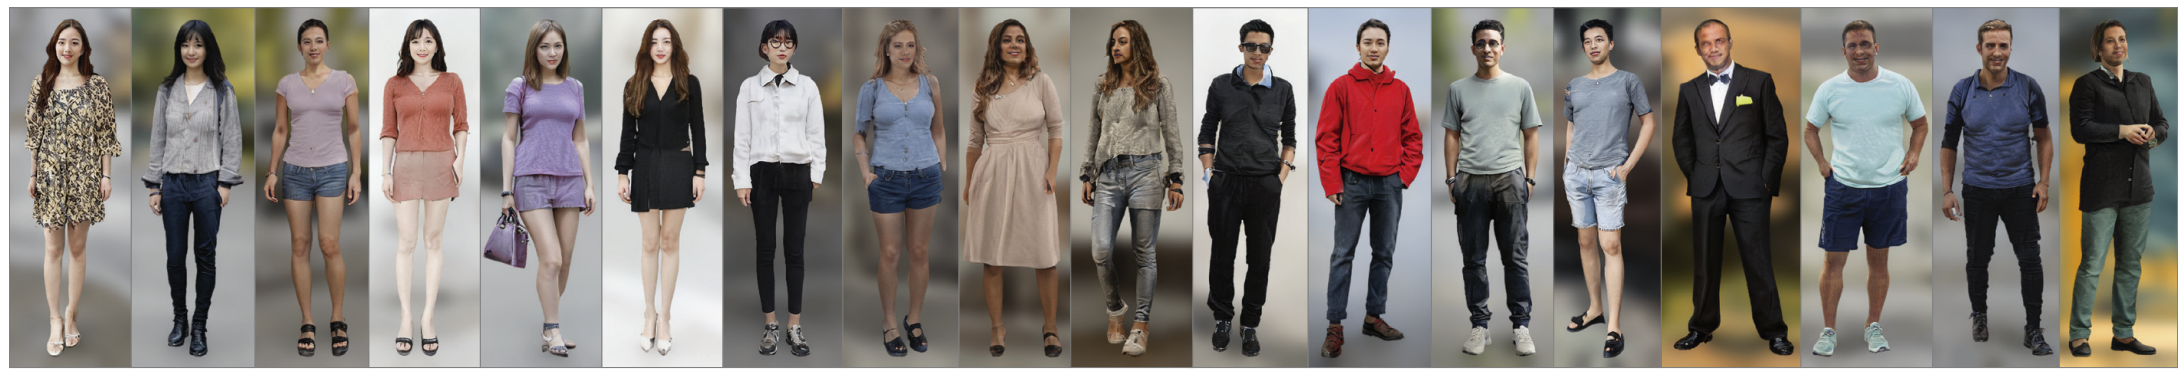
1024×1024 StyleGAN2-ADA 캔버스 생성기의 샘플은 신체 비율, 얼굴과 몸의 피부색 일관성, 다양한 의상, 핸드백·선글라스 같은 소품까지 그럴듯하게 만듭니다. 그러나 확대해 보면 얼굴과 손·발에 아티팩트가 뚜렷합니다. 이 결함이 InsetGAN의 존재 이유입니다.
🎚️ 2. 절단과 품질–다양성 교환
StyleGAN의 절단은 잠재를 평균 쪽으로 당기는 연산 $w’=w_{avg}+t\,(w-w_{avg})$ 입니다. $t$ 가 작을수록 아티팩트가 줄지만 다양성이 사라지고 색이 바랩니다.
| 절단 | FID (4K 샘플) | 관찰 |
|---|---|---|
| 없음 | 13.96 | 다양하지만 아티팩트 많음 |
| $t=0.7$ | 26.67 | – |
| $t=0.6$ (표준) | 71.89 | 품질은 오르지만 색이 바램 |
| $t=0.4$ | 71.90 | 다양성 크게 감소 |
| 적응 절단 | 53.26 | 색 유지하며 아티팩트 감소 |
🧩 3. 층별 적응 절단의 설계
StyleGAN2의 18개 층에 서로 다른 절단 계수를 적용합니다. 보충 자료에 제시된 값은 다음과 같습니다.
\[t=[0.35,\,0.25,\,0.25,\,0.70,\,0.75,\,0.65,\,0.65,\,0.40,\,0.40,\,0.35,\,0.25,\,0.15,\,0.15,\,0.05,\,0.05,\,0.05,\,0.05,\,0.05]\]| 층 범위 | 절단 강도 | 이유 |
|---|---|---|
| 0–2 (거친 구조) | 강함 (0.25–0.35) | 극단적 자세·체형 억제 |
| 4–7 (중간 구조) | 약함 (0.65–0.75) | 이 층들이 아티팩트를 가장 많이 만들지만, 강하게 절단하면 다양성이 크게 줄어 절충 |
| 8–13 (세부) | 점차 강해짐 | – |
| 14–17 (색·미세 질감) | 매우 강함 (0.05) | 색이 바래는 것을 막기 위해 평균 쪽으로 |
표준 절단($t=0.6$)과 비교하면 FID가 71.89에서 53.26으로 내려갔고, Figure 9(보충)에서 색이 유지되는 것이 확인됩니다. 다만 적응 절단은 경험적으로 조정된 값이며 데이터셋마다 다시 찾아야 합니다.
💡 Key Takeaway 캔버스 생성기의 샘플은 절단 강도를 층마다 다르게 주어 색을 지키면서 아티팩트를 줄입니다. 그래도 남는 얼굴 결함은 절단으로 해결되지 않으며, 거기서 InsetGAN의 인셋 최적화가 시작됩니다.
평가: FID의 한계와 사용자 연구
Section 5는 정량 지표(FID, Precision/Recall)와 사용자 연구를 함께 제시하면서, FID가 이 과제의 지각 품질을 반영하지 못한다는 점을 명시적으로 논증합니다.
📉 1. FID와 절단(truncation)의 관계
| 설정 | FID |
|---|---|
| 절단 없음 | 13.96 |
| $t=0.7$ | 26.67 |
| $t=0.4$ | 71.90 |
절단을 강하게 할수록 아티팩트가 줄어 자연스러운 이미지가 나오지만 FID는 크게 나빠집니다. FID가 품질보다 다양성에 민감하기 때문입니다. 얼굴 정제 전후의 FID(Table 1, $t=0.7$ 과 $0.4$, 전신과 얼굴 크롭 모두)는 차이가 작았는데, 저자들은 이를 “공동 최적화가 생성기의 분포를 바꾸지 않아 다양성을 해치지 않는다”는 긍정적 신호로 읽습니다.
보충 자료의 Precision/Recall에서는 InsetGAN 적용 후 precision이 일관되게 오르고 recall이 소폭 감소했으며, 특히 얼굴 크롭에서 precision 상승이 뚜렷했습니다.
👥 2. 사용자 연구 (AMT)
전신 생성기 결과 500장과 학습 이미지 500장을 모아, 쌍마다 5명이 “어느 사람이 더 그럴듯하고 실제 같은가”를 골랐습니다(다수결).
| 비교 | 결과 |
|---|---|
| 실제 이미지 vs. 정제 전 생성 (1초 노출) | 생성 결과 선호 12.4% |
| 정제 전 vs. InsetGAN 공동 최적화 | InsetGAN 선호 98% |
| 정제 전 vs. CoModGAN 얼굴 교체 | CoModGAN 선호 7% |
| InsetGAN vs. CoModGAN (보충) | InsetGAN 선호 99% |
12.4%라는 수치는 1초 노출에서 생성 결과가 기본 비율과 자세는 맞혔다는 뜻이지만, 뒤집어 보면 대부분은 여전히 가짜로 식별된다는 뜻이기도 합니다. 저자들은 이를 딥페이크 우려에 대한 답변으로도 인용합니다.
🆚 3. CoModGAN과의 비교 (Figure 10, 11)
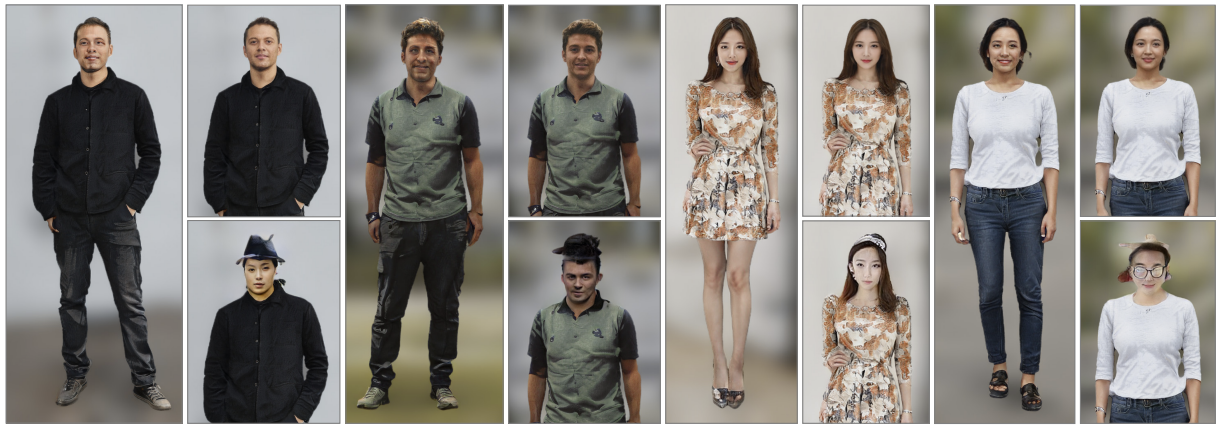
1024×1024에서 조건 없이 전신을 생성하거나 인페인팅하는 선행 연구가 없어, 가장 가까운 CoModGAN을 얼굴 주변 사각형 구멍(얼굴 정제)과 몸 주변 사각형 구멍(몸 생성)으로 각각 2주간 V100 4장에서 학습해 비교했습니다. CoModGAN은 이음새 없는 내용을 만들지만 사실성과 다양성이 떨어졌고, 얼굴당 여러 초기화 중 가장 좋은 둘을 골라도 Figure 6의 InsetGAN 결과보다 못했습니다.
💡 Key Takeaway 이 과제에서 FID는 거의 변하지 않는데 사용자 선호는 98% 로 갈립니다. 지각 품질이 중요한 응용에서는 FID 하나로 결론을 내릴 수 없다는 점을 논문이 데이터로 보여줍니다.
한계와 열린 방향
논문은 Section 5 말미에 한계와 데이터셋 편향·사회적 영향을 비교적 길게 적었습니다. 기술적 한계와 데이터 한계가 섞여 있으므로 나누어 정리합니다.
⚠️ 1. 기술적 한계
- 의도치 않은 세부 변화: 공동 최적화가 헤어스타일, 네크라인, 옷 세부를 바꿀 수 있습니다. 대개 사소하지만 Figure 6 가운데 행의 머리카락이나 Figure 7 윗줄의 옷깃처럼 변화가 클 때도 있습니다.
- InsetGAN이 고치지 못하는 결함: 손·발·옷의 대칭성 문제와 옷감의 일관성 문제는 캔버스 생성기의 한계이며 인셋으로 해결되지 않습니다(Figure 3).
- 제한된 체형·포즈 다양성: 포즈 다양성과 품질이 얽혀 있어 극단적 포즈를 걸러낸 결과, 생성 결과는 대부분 마른 체형과 제한된 포즈입니다.
- 저해상도 손실의 부작용: $L_{coarse}$ 가 64×64에서 작동하므로 입력 얼굴의 속성이 정확히 보존되지 않을 수 있습니다.
- 최적화 기반의 비용: 이미지 한 장당 약 60~75초가 걸리며, 피드포워드가 아니므로 실시간 응용에는 맞지 않습니다.
⚖️ 2. 데이터셋 편향과 사회적 영향
| 데이터 | 편향 |
|---|---|
| DeepFashion | 고유 인물 수가 적고 같은 모델이 반복, 여성 비율 약 9:1, 연령·인종·체형이 실제 인구를 대표하지 못함 → 주로 젊은 백인 여성만 생성(Figure 8) |
| 자체 데이터셋 | 동아시아 벤더에서 구매해 젊은 아시아 여성 과대표집, 마른 스트리트 패션 모델과 정장 위주 → 다른 인종에서 얼굴 아티팩트 증가(Figure 3 우측 4개) |
| 연령 | 거의 성인만 포함되어 아동 얼굴에 맞는 몸은 생성 불가 |
저자들은 편향된 데이터로 학습한 모델은 편향된 신체 표현을 배운다고 인정하고, 다양한 데이터 구축을 후속 연구에 촉구합니다. 딥페이크 악용 가능성에 대해서는 사용자 연구에서 1초 만에 대부분이 가짜로 식별되었다는 점을 들되, 품질이 오를수록 탐지 연구가 필요하다고 적습니다.
🔭 3. 열린 방향
- 3D 확장: 다중 생성기 아이디어를 3D GAN이나 트랜스포머 기반 자기회귀 모델 같은 3D 형상 표현으로 확장(Section 6).
- 다른 도메인: 전신 인물 외 도메인에서의 InsetGAN 시연과, 다중 GAN 설정에서의 조정된 잠재 편집.
- 더 많은 인셋: 손·발 전용 생성기 추가. 논문은 프레임워크가 지원한다고만 밝히고 얼굴·신발만 시연했습니다.
- 최적화에서 인코더로: 역변환 연구의 흐름처럼, 잠재 최적화를 학습된 인코더로 대체하면 실행 시간을 크게 줄일 수 있습니다.
💡 Key Takeaway InsetGAN은 “여러 사전 학습 GAN을 잠재 최적화로 조정한다”는 범용 틀을 제시했지만, 결과의 다양성은 결국 캔버스 생성기와 그 데이터셋에 묶여 있습니다. 대칭성·체형·인구 다양성 같은 한계는 인셋이 아니라 데이터와 캔버스 모델에서 풀어야 할 문제입니다.