 You know maize mean?
StackGAN: Text to Photo-realistic Image Synthesis with Stacked Generative Adversarial Networks
0. Summary
기본 정보 : ArXiv,2016.12.10 (ICCV 2017 Oral), StackGAN: Text to Photo-realistic Image Synthesis with Stacked Generative Adversarial Networks
연구 배경
텍스트 설명에서 이미지를 생성하는 문제는 Reed et al.(2016)의 GAN-INT-CLS가 조건부 GAN으로 처음 그럴듯하게 풀었지만 결과는 64×64 해상도에 머물렀고, 물체의 대략적인 형태와 색만 반영될 뿐 세부 묘사가 빠져 있었다. 위치 주석을 추가로 쓰는 GAWWN이 128×128까지 올렸으나 추가 주석 없이는 동작하지 않았다. 해상도를 그냥 키워 256×256 GAN을 한 번에 학습하면 자연 이미지 분포와 모델 분포의 지지집합(support)이 고차원 픽셀 공간에서 거의 겹치지 않아 학습이 불안정하고 의미 없는 이미지를 생성했다(Figure 1 하단). 또한 텍스트 임베딩은 100차원을 넘는 고차원인데 학습 데이터는 적어, 조건부 잠재 다양체(manifold)가 불연속적이 되는 문제도 있었다.
제안 방법
StackGAN은 “스케치 후 세부 묘사”라는 화가의 작업 방식을 따라 생성을 두 단계로 쌓는다. Stage-I GAN은 텍스트 조건으로 물체의 기본 형태와 색을 가진 64×64 저해상도 이미지를 그리고, Stage-II GAN은 Stage-I 결과와 텍스트를 다시 입력받아 Stage-I의 결함을 고치고 세부를 추가한 256×256 이미지를 만든다. 두 단계 모두에 조건부 증강(Conditioning Augmentation, CA) 을 도입하는데, 텍스트 임베딩 $\varphi_t$ 를 고정 벡터로 쓰는 대신 가우시안 $\mathcal{N}(\mu(\varphi_t),\Sigma(\varphi_t))$ 에서 조건 변수 $\hat c$ 를 샘플링하고, 이 분포를 표준 정규분포 쪽으로 당기는 KL 항(Eq. 2)을 생성기 손실에 더해 조건 다양체를 매끄럽게 만든다. Stage-II 생성기는 노이즈 $z$ 없이 인코더-잔차 블록-디코더 구조로 Stage-I 이미지를 정제하며, 판별기는 Reed et al.의 matching-aware 방식으로 “진짜 이미지 + 불일치 텍스트” 쌍도 음성으로 학습한다.
발견 사실
CUB, Oxford-102, MS COCO 세 데이터셋에서 StackGAN은 Inception score와 사람 순위 평가 모두 기존 방법을 앞섰다. CUB에서 Inception score는 GAN-INT-CLS 2.88에서 3.70으로 28.47%, Oxford-102에서는 2.66에서 3.20으로 20.30% 개선되었고, COCO에서도 7.88에서 8.45로 올랐다(Table 1). 사람 평가에서는 세 데이터셋 모두 StackGAN이 1위에 가까운 평균 순위(1.37, 1.13, 1.11)를 받았다. 구성요소 분석(Table 2)에서 CA를 빼면 256×256 StackGAN의 점수가 3.70에서 3.31로, Stage-II에 텍스트를 다시 넣지 않으면 3.45로 떨어졌고, 128×128 StackGAN(3.35)보다 256×256(3.70)이 높아 해상도 증가가 단순 픽셀 수 증가가 아니라 실제 세부 정보 추가임을 보였다. CA 없이 256×256 Stage-I GAN을 학습하면 같은 문장에 대해 무의미한 이미지로 붕괴하지만, CA를 넣으면 다양한 자세·시점의 새가 생성되었다(Figure 7).
핵심 기여
- 2단계 적층 생성 구조 : 저해상도 스케치(Stage-I)와 고해상도 정제(Stage-II)로 생성을 분해해, 텍스트 조건 이미지 생성에서 처음으로 256×256 사진 수준의 결과를 얻었다. Stage-II는 세부 추가뿐 아니라 Stage-I의 오류(예: 잘못된 머리 색)를 교정한다(Figure 5).
- 조건부 증강(CA) : 텍스트 임베딩을 가우시안 분포로 바꾸고 KL 정규화를 더해, 적은 텍스트-이미지 쌍으로도 조건 다양체를 매끄럽게 만들어 학습 안정성과 생성 다양성을 동시에 높였다.
- 체계적인 구성요소 분석 : Inception score와 사람 평가로 CA, 텍스트 재입력, 해상도, 단계 수의 기여를 분리했고(Table 2), 최근접 이웃 검색(Figure 6)으로 학습 이미지의 단순 복제가 아님을 확인했다.
관련 개념
텍스트 조건 이미지 생성과 “한 번에 고해상도”의 어려움
텍스트-이미지 합성(text-to-image synthesis) 은 자연어 문장 $t$ 를 조건으로 그 설명에 맞는 이미지를 생성하는 문제입니다. 조건부 GAN의 자연스러운 응용이지만, 텍스트라는 조건의 특성과 고해상도 생성의 어려움이 겹쳐 2016년까지는 64×64 수준에 머물러 있었습니다.
📚 1. 선행 연구와 그 한계 (Section 2)
| 방법 | 해상도 | 조건 | 한계 |
|---|---|---|---|
| GAN-INT-CLS (Reed et al., 2016) | 64×64 | 텍스트 임베딩 | 대략적 형태·색만 반영, 세부 부족 |
| GAWWN (Reed et al., 2016) | 128×128 | 텍스트 + 물체 위치 주석 | 추가 주석 없이는 그럴듯한 이미지를 내지 못함 |
| 조건부 PixelCNN, VAE 계열 | 저해상도 | 텍스트 | 샘플이 흐릿하거나 생성이 느림 |
텍스트 임베딩은 사전 학습된 문자 수준 CNN-RNN 인코더(Reed et al.)로 얻으며, 보통 1,024차원 정도의 고차원 벡터입니다. 이미지당 설명이 10개 안팎에 불과해 임베딩 공간에 비해 데이터가 매우 희박합니다.
🧱 2. 왜 256×256을 한 번에 학습하면 실패하는가
Figure 1은 같은 텍스트 조건에 대해 바닐라 256×256 GAN이 의미 없는 패턴을 내놓는 것을 보여줍니다. 논문은 이유를 두 가지로 설명합니다.
- 지지집합 불일치: 고차원 픽셀 공간에서 자연 이미지 분포와 모델 분포의 지지집합이 거의 겹치지 않으면 판별기가 쉽게 완벽해지고 생성기에 유용한 경사가 사라집니다(Arjovsky & Bottou, 2017).
- 불연속한 조건 다양체: 고차원 텍스트 임베딩에 비해 학습 쌍이 적어 조건 공간이 듬성듬성하고, 임베딩 근처의 작은 변동에 생성기가 과적합합니다.
🎨 3. “스케치 후 묘사”라는 분해
저자들의 해법은 문제를 저해상도 분포 학습 → 조건부 고해상도 정제로 쪼개는 것입니다. 저해상도에서는 두 분포의 지지집합이 겹칠 가능성이 높아 학습이 안정적이고, 고해상도 단계는 “저해상도 이미지가 주어졌을 때”의 조건부 분포만 모델링하면 되므로 훨씬 쉬운 문제가 됩니다. Laplacian Pyramid GAN(Denton et al., 2015)의 다단계 정신을 잇되, 각 단계가 텍스트 조건을 함께 받는다는 점이 다릅니다.
💡 Key Takeaway 고해상도 텍스트-이미지 생성의 벽은 고차원 픽셀 공간의 지지집합 문제와 희박한 조건 공간입니다. StackGAN은 전자를 2단계 분해로, 후자를 조건부 증강으로 각각 공략합니다.
전체 파이프라인 한눈에 보기 (Figure 2)
StackGAN의 구조는 Figure 2 한 장에 요약됩니다. 텍스트 임베딩이 어떻게 두 번 쓰이고, 텐서 크기가 어떻게 변하는지를 따라가면 각 구성요소의 역할이 분명해집니다.
🗺️ 1. 데이터 흐름
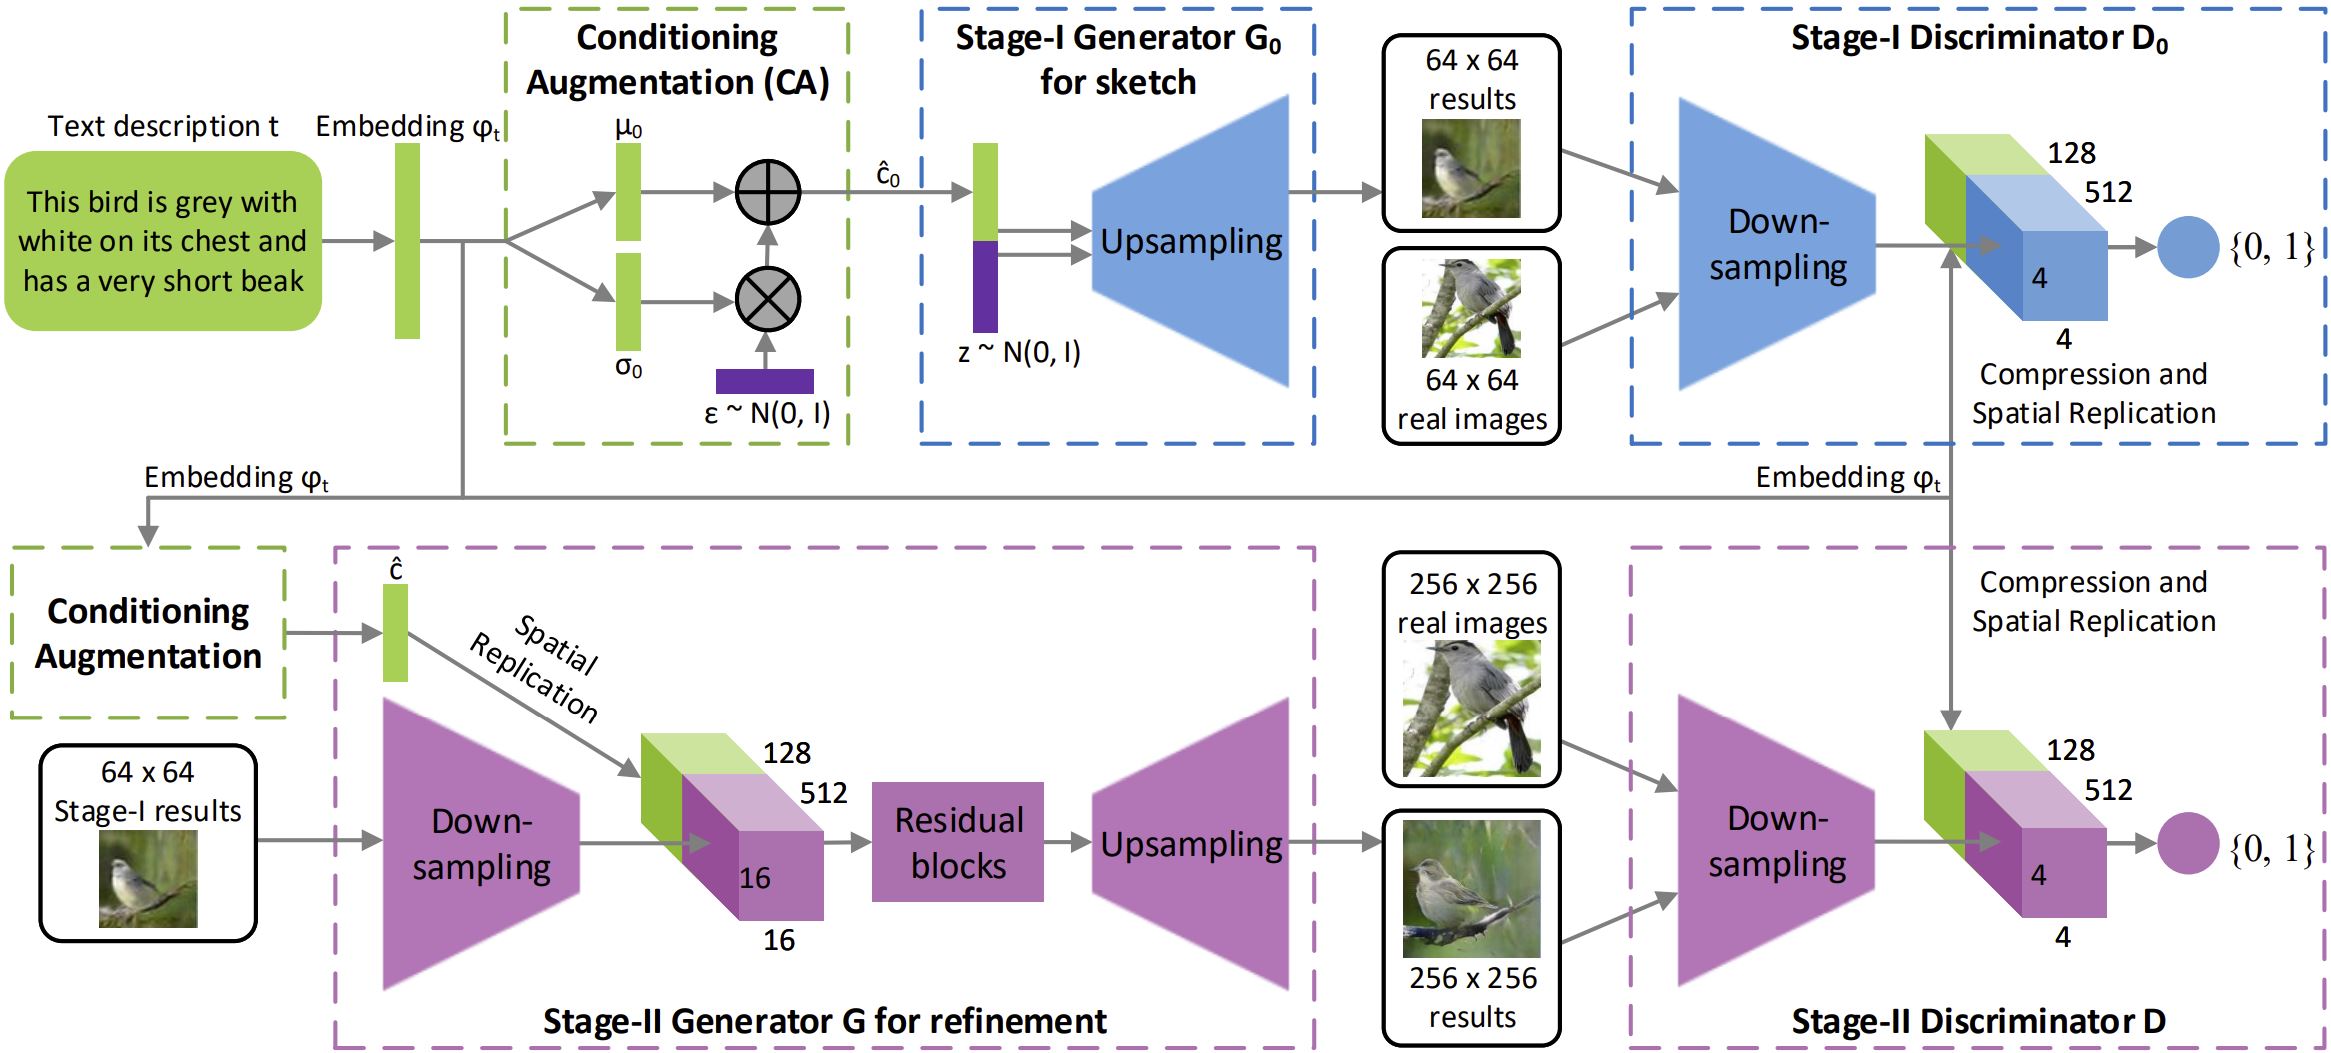
| 단계 | 입력 | 처리 | 출력 |
|---|---|---|---|
| 텍스트 인코딩 | 문장 $t$ | 사전 학습 문자 수준 CNN-RNN 인코더 (Reed et al.) | $\varphi_t$ (고차원 임베딩) |
| Stage-I CA | $\varphi_t$ | FC → $\mu_0,\sigma_0$ → 재파라미터화 | $\hat c_0\in\mathbb{R}^{128}$ |
| Stage-I $G_0$ | $[\hat c_0;\,z]$, $z\in\mathbb{R}^{100}$ | FC → 업샘플 블록 ×4 | 64×64×3 |
| Stage-I $D_0$ | 64×64 이미지 + $\varphi_t$ (128로 압축, 4×4 복제) | 다운샘플 → 연결 → 1×1 conv → FC | 진위 점수 |
| Stage-II CA | $\varphi_t$ (같은 인코더, 별도 FC) | FC → $\mu,\sigma$ → 재파라미터화 | $\hat c\in\mathbb{R}^{128}$ |
| Stage-II $G$ | $s_0$ (64×64) + $\hat c$ (16×16 복제) | 다운샘플 → 연결 → 잔차 블록 ×4 → 업샘플 | 256×256×3 |
| Stage-II $D$ | 256×256 이미지 + $\varphi_t$ | 더 깊은 다운샘플, matching-aware | 진위 점수 |
🔑 2. 설계상 눈여겨볼 점
- 텍스트는 두 번, 노이즈는 한 번. 텍스트 조건은 Stage-I과 Stage-II 모두에 들어가지만 노이즈 $z$ 는 Stage-I에만 들어갑니다. Stage-II의 무작위성은 $s_0$ 가 운반합니다.
- CA는 단계마다 독립. 두 단계의 CA는 텍스트 인코더는 공유하되 $\mu,\sigma$ 를 만드는 완전연결층은 따로 둡니다. 각 단계가 자기 해상도에 맞는 조건 분포를 학습할 수 있습니다.
- 판별기는 항상 텍스트를 본다. 두 판별기 모두 이미지와 텍스트 임베딩을 함께 받으므로 “텍스트와 맞는 이미지인가”를 판정합니다.
🧭 3. 두 단계의 역할 분담 요약
| Stage-I | Stage-II | |
|---|---|---|
| 목표 | 형태·색·배경 배치 | 세부 추가 + Stage-I 오류 교정 |
| 해상도 | 64×64 | 256×256 |
| 입력 | 텍스트 + 노이즈 | 텍스트 + Stage-I 이미지 |
| 구조 | 업샘플 전용 | 인코더–잔차–디코더 |
| 어려움 | 낮음 (저해상도 분포) | 중간 (조건부 정제) |
💡 Key Takeaway StackGAN은 “텍스트 → 스케치 → 정제” 의 선형 파이프라인이며, 텍스트가 두 단계 모두에 조건으로 들어간다는 점이 단순 초해상도와 구분되는 지점입니다.
조건부 증강(Conditioning Augmentation)
조건부 증강(CA) 은 텍스트 임베딩이라는 결정론적 조건을 확률 분포로 바꾸는 기법입니다. 구현은 간단하지만, 적은 데이터에서 조건부 GAN을 안정적으로 학습시키는 데 결정적이었다는 점이 Table 2와 Figure 7에서 확인됩니다.
🧮 1. 정의 (Section 3.2, Eq. 2)
텍스트 인코더 출력 $\varphi_t$ 로부터 완전연결층으로 평균 $\mu(\varphi_t)$ 와 대각 공분산 $\Sigma(\varphi_t)$ 를 계산하고, 조건 변수를
\[\hat c\sim\mathcal{N}\big(\mu(\varphi_t),\Sigma(\varphi_t)\big),\qquad \hat c_0=\mu_0+\sigma_0\odot\epsilon,\;\epsilon\sim\mathcal{N}(0,I)\]로 샘플링합니다(재파라미터화 트릭). 분포가 지나치게 뾰족해지지 않도록 생성기 손실에 KL 정규화 항을 더합니다.
\[D_{KL}\big(\mathcal{N}(\mu(\varphi_t),\Sigma(\varphi_t))\,\|\,\mathcal{N}(0,I)\big)\]이 항의 가중치 $\lambda$ 는 모든 실험에서 1 입니다.
🎯 2. 효과
| 효과 | 메커니즘 |
|---|---|
| 조건 다양체의 매끄러움 | 같은 문장이 매번 조금씩 다른 $\hat c$ 를 만들어 임베딩 주변을 채움 |
| 학습 안정화 (붕괴 방지) | 생성기가 특정 임베딩 값에 과적합하지 못함 |
| 생성 다양성 | 같은 문장에서 자세·시점이 다른 이미지가 나옴 (Figure 7) |
| 데이터 증강 효과 | 소수의 텍스트-이미지 쌍을 사실상 무한한 조건 쌍으로 확장 |
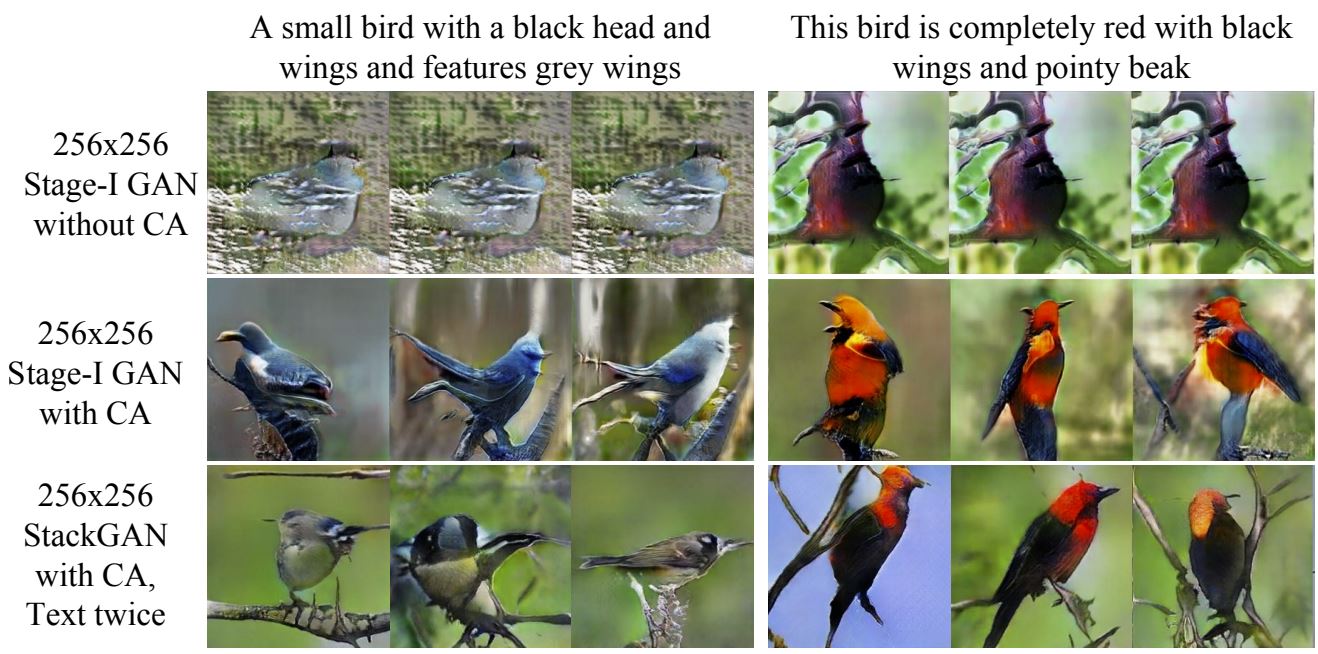
Figure 7에서 CA 없이 학습한 256×256 Stage-I GAN은 같은 텍스트에 대해 무의미한 이미지로 붕괴하지만, CA를 넣으면 같은 텍스트에서 서로 다른 자세와 시점의 새가 나옵니다.
🔗 3. VAE와의 관계
구조만 보면 CA는 텍스트 임베딩에 대한 변분 인코더와 같습니다. $\mu,\Sigma$ 를 예측하고 KL로 사전분포 쪽으로 당기는 방식은 VAE의 인코더와 동일합니다. 차이는 복원 손실 대신 GAN 손실이 “디코더”를 학습시킨다는 점입니다. 이 관점에서 CA는 조건 공간에 대한 정보 병목으로 읽을 수도 있습니다. 조건이 담는 정보를 제한하면 생성기가 텍스트의 세부 수치가 아니라 의미에 반응하게 됩니다.
💡 Key Takeaway CA는 “조건을 점이 아니라 분포로 준다”는 한 줄짜리 아이디어지만, 희박한 조건 공간을 채워 붕괴를 막고 다양성을 만드는 핵심 장치입니다. 256×256 StackGAN에서 CA를 빼면 Inception score가 3.70에서 3.31로 떨어집니다.
Stage-I GAN: 저해상도 스케치
Stage-I GAN 은 텍스트 조건과 노이즈로 64×64 이미지를 생성합니다. 목표는 사진 수준의 품질이 아니라 물체의 기본 형태와 색, 배경의 대략적 배치를 맞추는 것입니다. 이후 Stage-II가 이 결과를 입력으로 받기 때문에, 여기서 전역 구조만 맞으면 됩니다.
🧮 1. 목적 함수 (Eq. 3, 4)
\[\mathcal{L}_{D_0}=\mathbb{E}_{(I_0,t)\sim p_{data}}\big[\log D_0(I_0,\varphi_t)\big]+\mathbb{E}_{z\sim p_z,\,t\sim p_{data}}\big[\log\big(1-D_0(G_0(z,\hat c_0),\varphi_t)\big)\big]\] \[\mathcal{L}_{G_0}=\mathbb{E}_{z\sim p_z,\,t\sim p_{data}}\big[\log\big(1-D_0(G_0(z,\hat c_0),\varphi_t)\big)\big]+\lambda\,D_{KL}\big(\mathcal{N}(\mu_0(\varphi_t),\Sigma_0(\varphi_t))\,\|\,\mathcal{N}(0,I)\big)\]판별기 $D_0$ 는 조건 GAN의 표준 목적을 최대화하고, 생성기 $G_0$ 는 적대 항에 CA의 KL 항을 더해 최소화합니다.
🏗️ 2. 구조 (Section 3.5)
| 구성 | 세부 |
|---|---|
| 조건 벡터 | $\hat c_0\in\mathbb{R}^{N_g}$, $N_g=128$ |
| 노이즈 | $z\in\mathbb{R}^{N_z}$, $N_z=100$ |
| 생성기 입력 | $[\hat c_0; z]$ 를 완전연결로 확장 후 업샘플 블록 연속 |
| 업샘플 블록 | nearest-neighbor ×2 → 3×3 stride-1 conv → BN → ReLU (마지막 층 제외) |
| 출력 | $W_0\times H_0=64\times 64$ |
| 판별기 | 4×4 stride-2 conv + BN + LeakyReLU 다운샘플 블록 (첫 블록은 BN 없음) |
| 텍스트 결합 | $\varphi_t$ 를 $N_d=128$ 로 압축해 $M_d\times M_d\times N_d$ ($M_d=4$)로 공간 복제 후 이미지 특징과 연결 → 1×1 conv → 1노드 FC |
🖼️ 3. 결과의 성격 (Figure 5 상단)
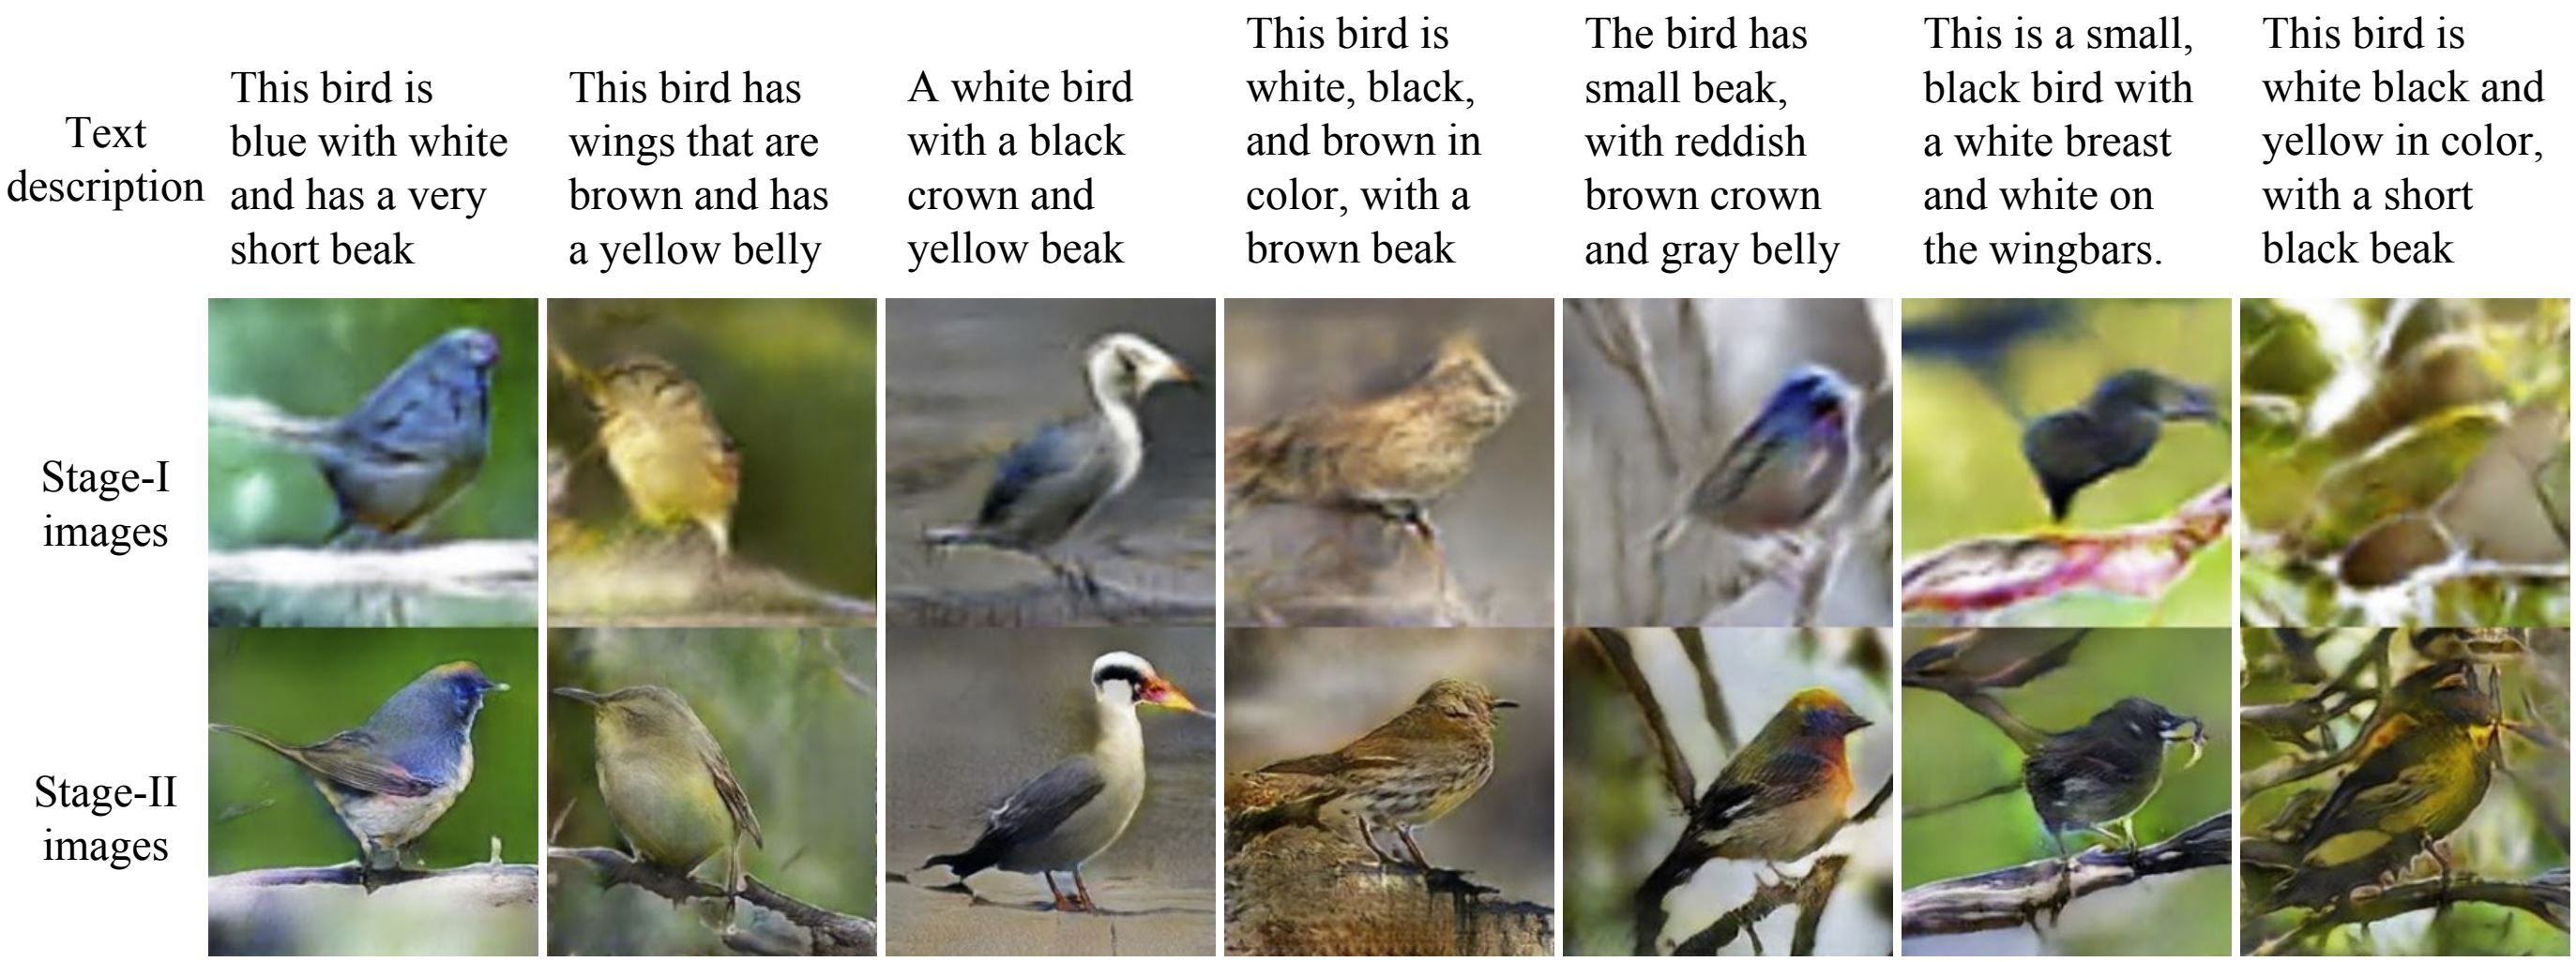
Stage-I 결과는 새의 윤곽과 주된 색, 배경 색조는 맞지만 깃털 질감이나 부리·눈 같은 세부가 없고, 때때로 색이 잘못 칠해집니다. 이 결함들이 다음 단계에서 교정 대상이 됩니다.
💡 Key Takeaway Stage-I는 “틀리지 않게 대충 그리는” 단계입니다. 저해상도이기 때문에 학습이 안정적이고, 그 안정성이 Stage-II의 조건부 정제를 가능하게 합니다.
Stage-II GAN: 조건부 고해상도 정제
Stage-II GAN 은 Stage-I 이미지 $s_0=G_0(z,\hat c_0)$ 와 텍스트를 함께 받아 256×256 이미지를 생성합니다. Stage-I가 놓친 텍스트 정보를 다시 읽고, 결함을 고치며, 세부를 더하는 것이 역할입니다.
🧮 1. 목적 함수 (Eq. 5, 6)
\[\mathcal{L}_{D}=\mathbb{E}_{(I,t)\sim p_{data}}\big[\log D(I,\varphi_t)\big]+\mathbb{E}_{s_0\sim p_{G_0},\,t\sim p_{data}}\big[\log\big(1-D(G(s_0,\hat c),\varphi_t)\big)\big]\] \[\mathcal{L}_{G}=\mathbb{E}_{s_0\sim p_{G_0},\,t\sim p_{data}}\big[\log\big(1-D(G(s_0,\hat c),\varphi_t)\big)\big]+\lambda\,D_{KL}\big(\mathcal{N}(\mu(\varphi_t),\Sigma(\varphi_t))\,\|\,\mathcal{N}(0,I)\big)\]Stage-I 식과 비교하면 노이즈 $z$ 가 $s_0$ 로 바뀌었습니다. Stage-II는 별도 노이즈를 쓰지 않습니다. 무작위성은 $s_0$ 에 이미 담겨 있다고 보기 때문입니다. 두 단계의 CA는 서로 다른 완전연결층을 쓰지만 텍스트 인코더는 공유합니다.
🏗️ 2. 생성기: 인코더-잔차-디코더
| 단계 | 세부 |
|---|---|
| 인코더 | $s_0$ (64×64)를 다운샘플 블록으로 $M_g\times M_g$ ($M_g=16$) 특징 맵으로 압축 |
| 텍스트 주입 | $\hat c\in\mathbb{R}^{128}$ 을 16×16으로 공간 복제해 이미지 특징과 채널 방향 연결 |
| 잔차 블록 | 3×3 stride-1 conv + BN + ReLU. 256×256 모델은 4개, 128×128 모델은 2개 |
| 디코더 | 업샘플 블록 연속으로 $W\times H=256\times 256$ 까지 확대 |
인코더-디코더 구조이므로 Stage-II는 사실상 텍스트 조건 이미지-이미지 변환기입니다. 텍스트를 다시 넣는 것이 중요한데, Table 2에서 텍스트를 Stage-I에만 주면 점수가 3.70에서 3.45로 떨어집니다.
🕵️ 3. 판별기: matching-aware 학습
판별기는 Stage-I와 비슷한 다운샘플 구조에 블록을 더 쌓은 형태이며, Reed et al.의 matching-aware 방식으로 학습합니다.
| 입력 쌍 | 라벨 |
|---|---|
| 진짜 이미지 + 일치하는 텍스트 | 양성 |
| 진짜 이미지 + 불일치 텍스트 | 음성 |
| 생성 이미지 + 해당 텍스트 | 음성 |
두 번째 행 덕분에 판별기는 “사진처럼 보이는가”뿐 아니라 “텍스트와 맞는가” 도 판단하게 되고, 생성기는 텍스트 조건을 무시할 수 없게 됩니다.
🔧 4. 교정 효과 (Figure 5 하단)
Figure 5의 Stage-II 결과는 Stage-I에서 잘못 칠한 머리 색을 텍스트에 맞게 고치고, 깃털 질감·부리·눈 같은 세부를 추가합니다. 저자들은 이것이 Stage-II가 단순 초해상도(super-resolution)가 아니라 텍스트를 다시 읽는 조건부 생성기이기 때문이라고 설명합니다.
💡 Key Takeaway Stage-II는 초해상도 모듈이 아닙니다. 텍스트를 다시 입력받아 Stage-I의 오류를 고치고, matching-aware 판별기 덕분에 텍스트와의 일치까지 책임집니다.
학습 설정과 평가 프로토콜
StackGAN의 실험은 이후 텍스트-이미지 연구(AttnGAN, DM-GAN 등)가 그대로 따르는 데이터셋 분할과 평가 방식의 기준이 되었습니다. 설정은 Section 3.5와 4.1에 있습니다.
⚙️ 1. 학습 설정
| 항목 | 값 |
|---|---|
| 학습 순서 | Stage-I 600 epoch (Stage-II 고정) → Stage-II 600 epoch (Stage-I 고정) |
| 최적화 | Adam, 배치 64, 초기 학습률 0.0002, 100 epoch마다 절반 |
| 기본 차원 | $N_g=128$, $N_z=100$, $M_g=16$, $M_d=4$, $N_d=128$ |
| 해상도 | $W_0=H_0=64$, $W=H=256$ |
| CA 가중치 | $\lambda=1$ |
🗂️ 2. 데이터셋 (Section 4.1)
| 데이터셋 | 규모 | 분할 | 설명 수 | 전처리 |
|---|---|---|---|---|
| CUB | 200종, 11,788장 | 클래스 분리(class-disjoint) | 이미지당 10 | 바운딩 박스가 이미지의 0.75 이상 차지하도록 크롭 |
| Oxford-102 | 102종, 8,189장 | 클래스 분리 | 이미지당 10 | — |
| MS COCO | 학습 약 80k, 검증 약 40k | 공식 분할 | 이미지당 5 | 다중 물체·복잡 배경 |
CUB와 Oxford-102는 학습에 없던 클래스로 평가하므로, 모델이 텍스트에서 새로운 종을 일반화해 그려야 합니다.
📏 3. 평가 지표
- Inception score: 생성 샘플 30k 장에 대해 $\exp\big(\mathbb{E}x D{KL}(p(y\mid x)\,|\,p(y))\big)$. CUB·Oxford-102는 해당 데이터로 미세조정한 Inception 모델, COCO는 사전 학습 모델을 씁니다. 품질과 다양성을 함께 반영하지만 텍스트와의 일치는 측정하지 못합니다.
- 사람 순위(human rank): CUB·Oxford-102는 클래스당 50개 설명, COCO는 검증 설명 4k개를 뽑아 문장당 5장을 생성하고, 10명이 방법별 결과의 순위를 매겼습니다. 낮을수록 좋습니다.
💡 Key Takeaway Inception score는 텍스트 일치를 보지 못하므로 논문은 사람 평가를 함께 제시합니다. 클래스 분리 분할과 30k 샘플 Inception score는 이후 텍스트-이미지 연구의 표준이 되었습니다.
실험 결과와 구성요소 분석
Section 4.2–4.3은 세 데이터셋에서의 비교와, 각 설계 선택이 성능에 얼마나 기여했는지를 분리한 분석입니다.
🏆 1. 기존 방법과의 비교 (Table 1)
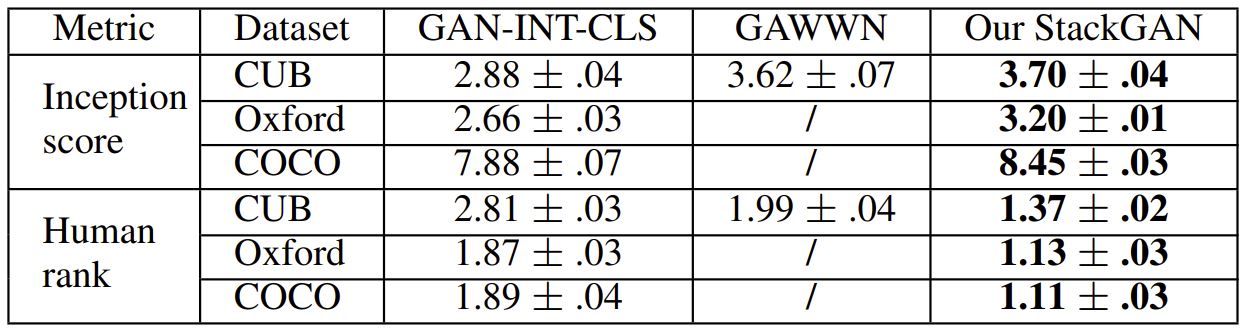
| 지표 | 데이터셋 | GAN-INT-CLS | GAWWN | StackGAN |
|---|---|---|---|---|
| Inception score ↑ | CUB | 2.88 ± .04 | 3.62 ± .07 | 3.70 ± .04 |
| Oxford-102 | 2.66 ± .03 | – | 3.20 ± .01 | |
| COCO | 7.88 ± .07 | – | 8.45 ± .03 | |
| 사람 순위 ↓ | CUB | 2.81 ± .03 | 1.99 ± .04 | 1.37 ± .02 |
| Oxford-102 | 1.87 ± .03 | – | 1.13 ± .03 | |
| COCO | 1.89 ± .04 | – | 1.11 ± .03 |
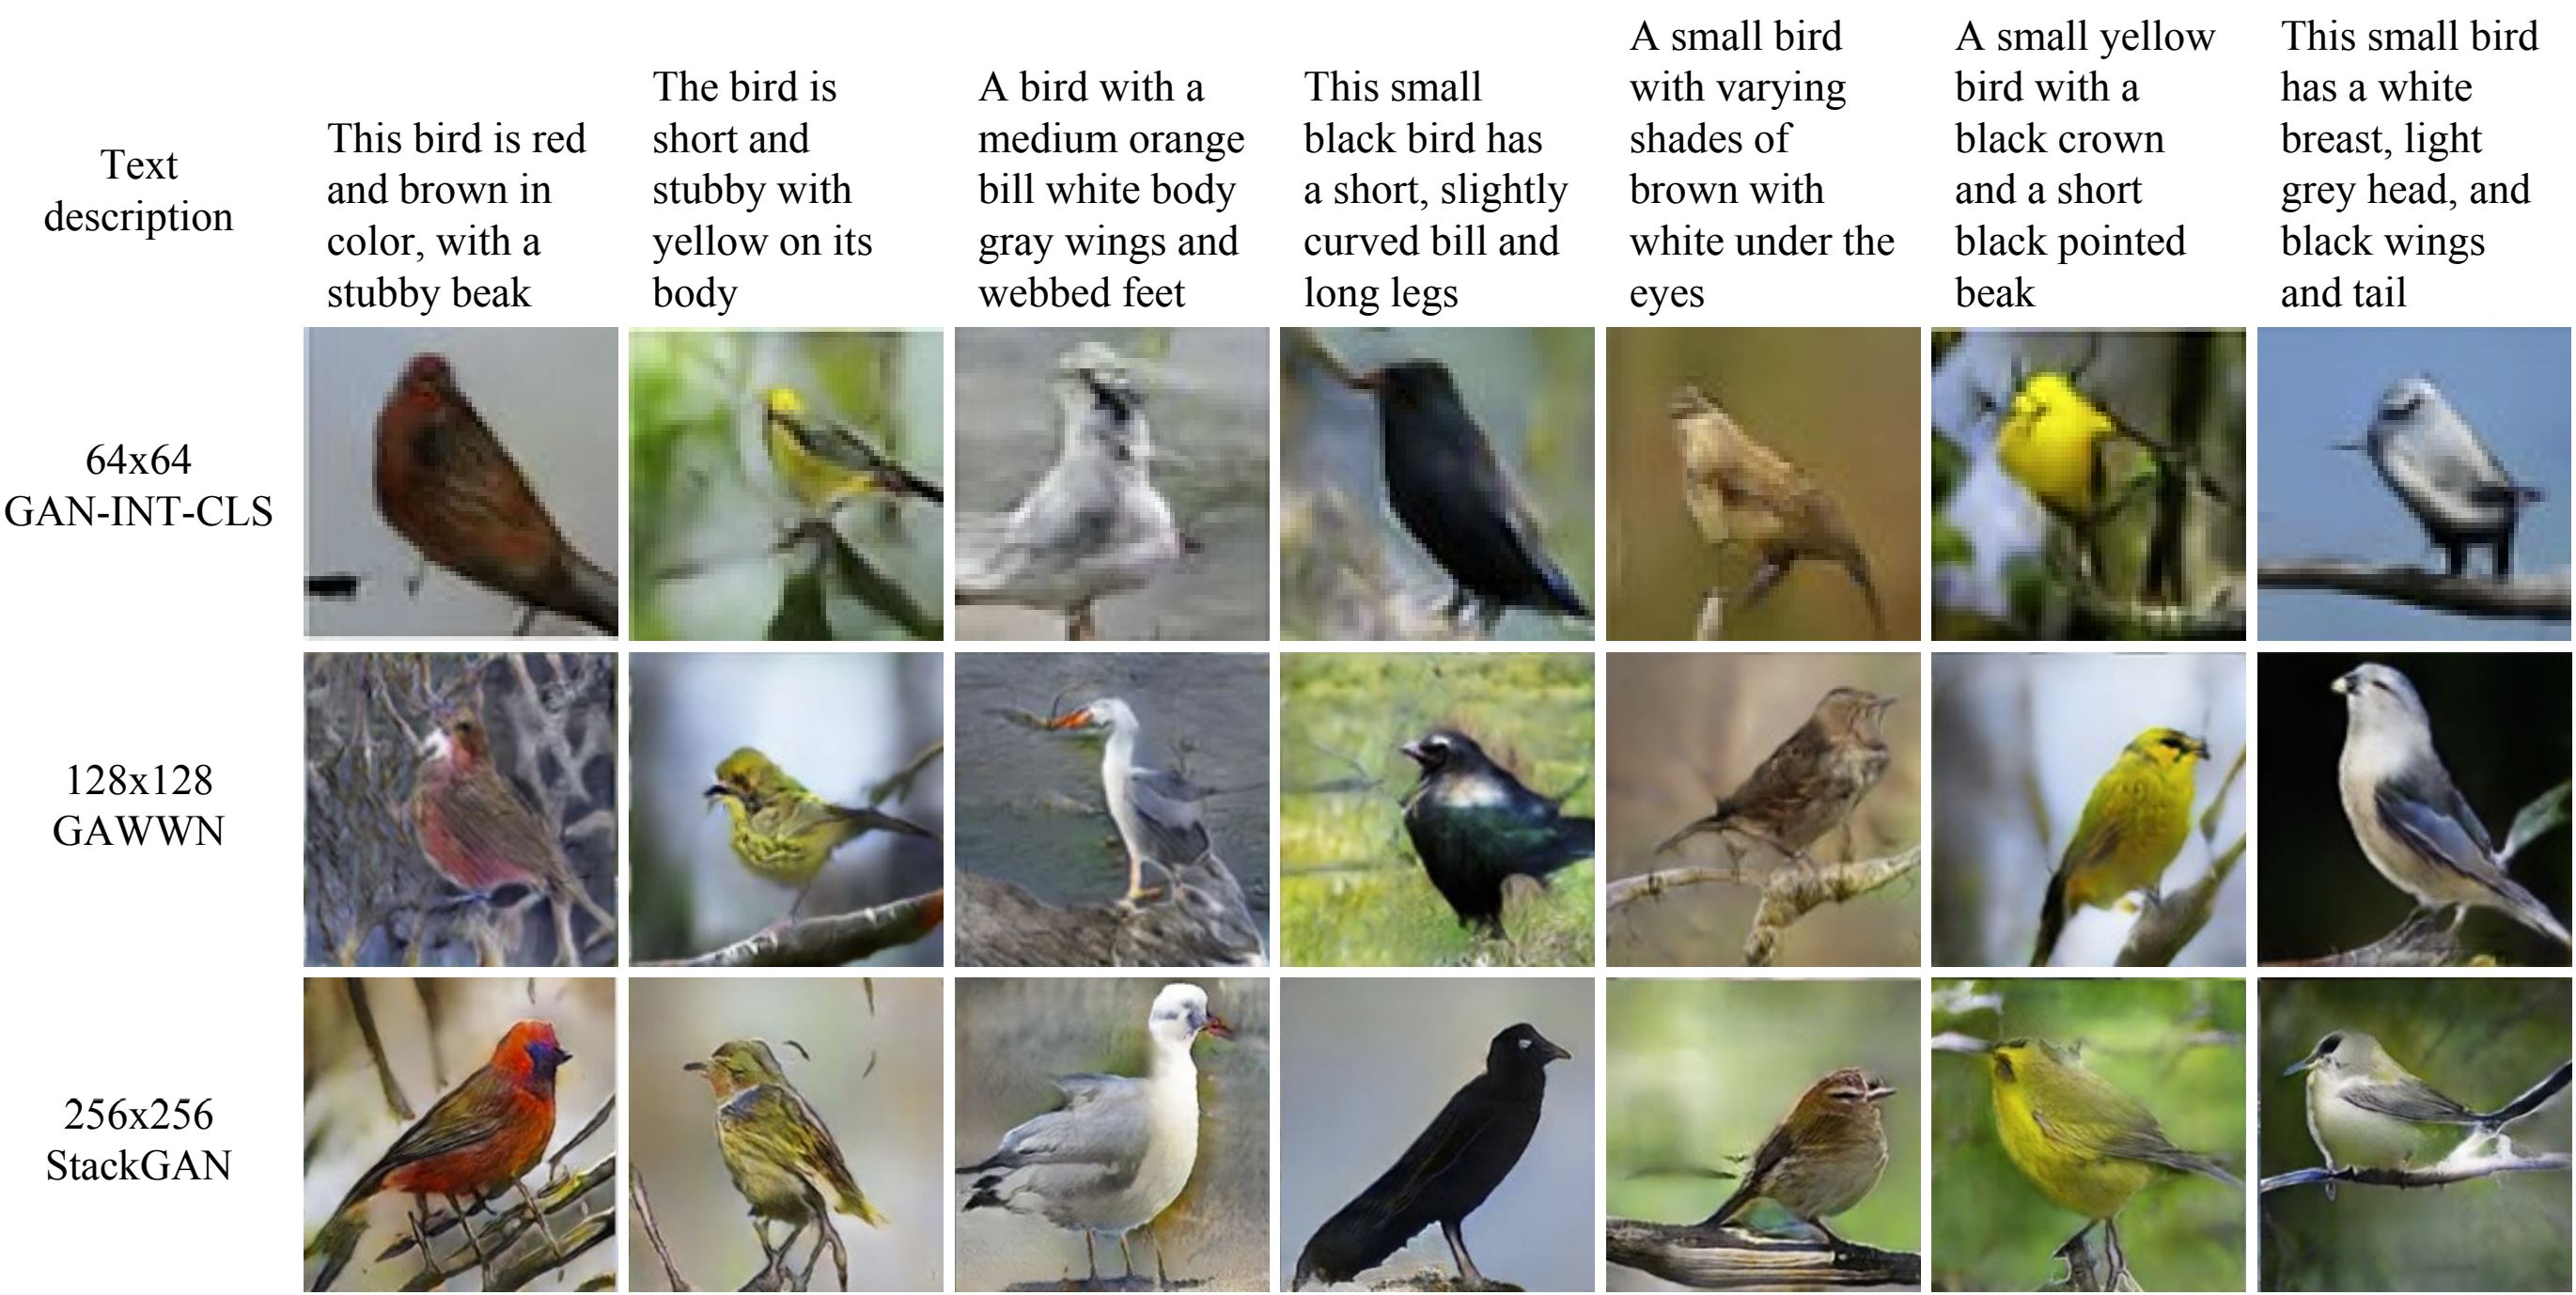
GAWWN은 물체 위치 주석을 추가로 쓰고도 CUB에서 StackGAN보다 약간 낮았고, 주석 없이는 그럴듯한 이미지를 내지 못한다고 저자들이 보고했습니다. Figure 3과 4의 정성 비교에서 GAN-INT-CLS는 형태와 색만, GAWWN은 더 많은 세부를, StackGAN은 사진에 가까운 질감을 보여줍니다.
🔬 2. 구성요소 분석 (Table 2, CUB Inception score)
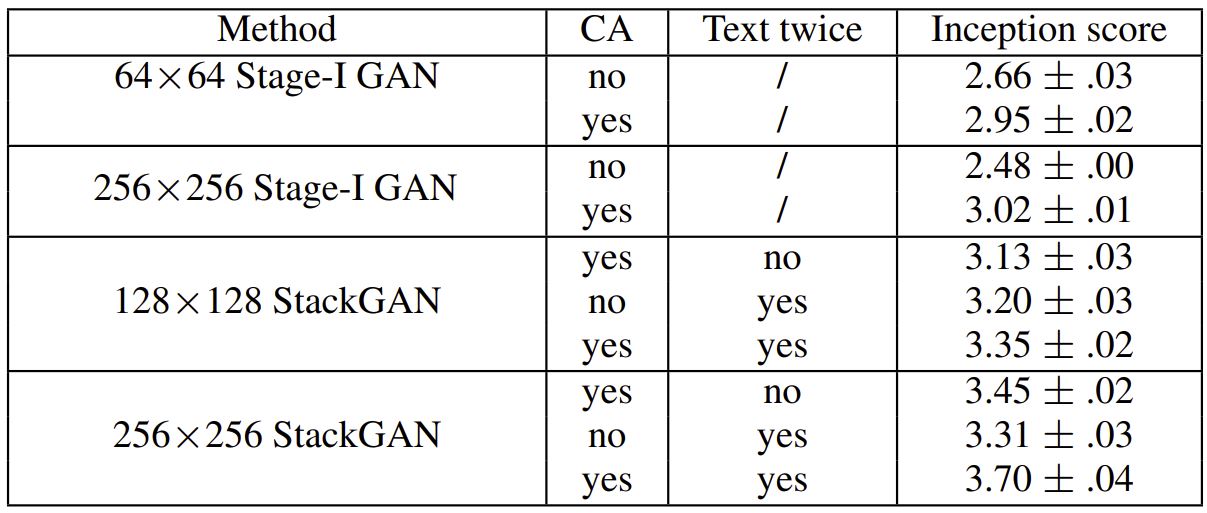
| 모델 | CA | 텍스트 재입력 | Inception score |
|---|---|---|---|
| 64×64 Stage-I GAN | ✗ | – | 2.66 ± .03 |
| 64×64 Stage-I GAN | ✓ | – | 2.95 ± .02 |
| 256×256 Stage-I GAN | ✗ | – | 2.48 ± .00 |
| 256×256 Stage-I GAN | ✓ | – | 3.02 ± .01 |
| 128×128 StackGAN | ✓ | ✗ | 3.13 ± .03 |
| 128×128 StackGAN | ✗ | ✓ | 3.20 ± .03 |
| 128×128 StackGAN | ✓ | ✓ | 3.35 ± .02 |
| 256×256 StackGAN | ✓ | ✗ | 3.45 ± .02 |
| 256×256 StackGAN | ✗ | ✓ | 3.31 ± .03 |
| 256×256 StackGAN | ✓ | ✓ | 3.70 ± .04 |
읽어낼 수 있는 사실은 네 가지입니다.
- CA는 모든 설정에서 도움이 되며, 특히 단일 단계 256×256 GAN에서는 CA가 없으면(2.48) 64×64보다도 나쁩니다. 고해상도일수록 붕괴가 심하다는 뜻입니다.
- 2단계 구조 자체의 효과: 같은 CA 조건에서 단일 단계 256×256(3.02)보다 StackGAN 256×256(3.70)이 크게 높습니다.
- 텍스트 재입력: Stage-II에 텍스트를 주지 않으면 3.70→3.45로 떨어집니다.
- 해상도: 128×128 StackGAN(3.35)보다 256×256(3.70)이 높아, 해상도 증가가 실제 세부 정보를 더한다는 근거가 됩니다.
🔍 3. 복제가 아닌 생성인가 (Figure 6, 8)
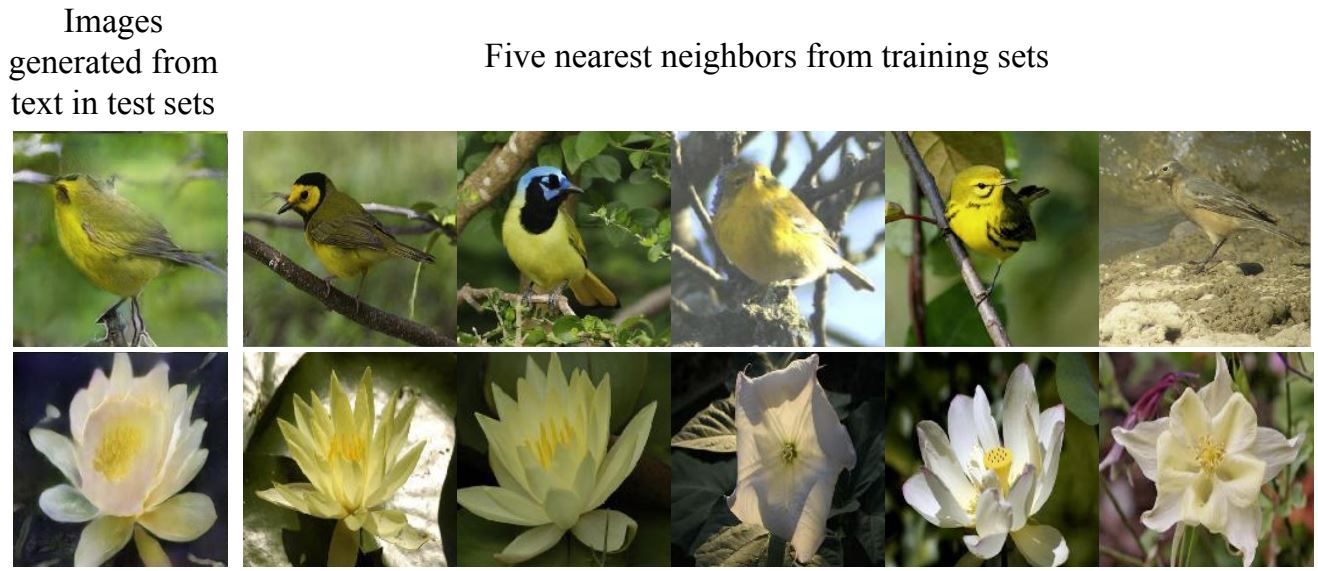
Stage-II 판별기 특징의 L2 거리로 학습 이미지 중 최근접 이웃을 찾으면, 생성 이미지는 학습 이미지와 비슷한 스타일을 가지되 동일한 이미지는 아닙니다. 또한 두 문장의 임베딩을 선형 보간하고 $z$ 를 0으로 고정하면 색과 속성이 매끄럽게 변하는 이미지 열이 나와(Figure 8), 조건 다양체가 연속적으로 학습되었음을 보여줍니다.
💡 Key Takeaway 구성요소 분석의 결론은 2단계 구조, CA, 텍스트 재입력 세 가지가 모두 필요하다는 것입니다. 어느 하나를 빼도 Inception score가 0.25 이상 떨어지며, 셋이 합쳐져야 3.70에 도달합니다.
한계와 열린 방향
StackGAN은 텍스트-이미지 생성을 256×256으로 끌어올린 첫 논문이지만, 방법과 평가 모두에 뚜렷한 한계가 있었고 그 한계가 곧 후속 연구의 출발점이 되었습니다.
⚠️ 1. 한계
- 복잡한 장면에서의 품질: CUB·Oxford-102처럼 단일 물체 데이터에서는 사진 수준이지만, COCO 같은 다중 물체 장면에서는 전역 배치는 그럴듯해도 개별 물체가 흐릿합니다(Figure 4 우측). Inception score 8.45는 실제 이미지와 거리가 큽니다.
- Stage-I 오류의 전파: Stage-II가 일부 결함을 고치지만, Stage-I가 형태를 크게 틀리면 Stage-II도 복구하지 못합니다. 두 단계를 따로 순차 학습하므로 Stage-II가 Stage-I의 분포 변화에 적응할 수 없습니다.
- 텍스트 일치도의 측정 부재: Inception score는 텍스트와의 일치를 재지 못하고, 사람 평가는 규모가 작습니다(10명). 이후 R-precision(AttnGAN) 같은 지표가 이 공백을 메웠습니다.
- 문장 수준 조건만 사용: 문장 전체를 하나의 벡터로 압축하므로 “빨간 부리와 흰 배”처럼 단어 단위의 세부가 이미지의 특정 영역에 대응되지 않습니다.
- Stage-II에 노이즈 없음: 무작위성을 $s_0$ 에만 의존하므로 Stage-II 단계에서의 다양성은 제한됩니다.
🔭 2. 후속 연구와의 연결
| 한계 | 후속 연구 |
|---|---|
| 순차 학습, 2단계 고정 | StackGAN++ (Zhang et al., 2018): 여러 해상도의 생성기·판별기를 트리 구조로 동시(end-to-end) 학습, 색 일관성 정규화 추가 |
| 문장 수준 조건 | AttnGAN (Xu et al., 2018): 단어 수준 어텐션으로 하위 영역을 생성하고 DAMSM으로 텍스트-이미지 일치를 손실에 반영 |
| 텍스트 일치 지표 | AttnGAN의 R-precision, 이후 CLIP score |
| 다중 물체 장면 | 레이아웃·장면 그래프 조건 생성(Hong et al., 2018; Johnson et al., 2018) |
| GAN 자체의 한계 | 확산 모델 기반 텍스트-이미지 생성(GLIDE, Imagen, Stable Diffusion)으로 패러다임 전환 |
🧭 3. 이 논문의 위치
“저해상도에서 전역 구조를 잡고 고해상도에서 조건부로 정제한다”는 StackGAN의 분해는 이후 ProGAN의 점진적 성장, 캐스케이드 확산 모델(Imagen의 64→256→1024 초해상도 단계)로 형태를 바꿔 이어졌습니다. CA 역시 조건 임베딩에 잡음을 주어 조건 공간을 매끄럽게 만드는 기법으로 다양한 조건부 생성 모델에서 변형되어 쓰입니다.
💡 Key Takeaway StackGAN의 한계는 대부분 “문장 하나를 벡터 하나로, 두 단계를 따로” 라는 단순화에서 옵니다. StackGAN++와 AttnGAN은 바로 그 두 지점을 고쳤고, 다단계 정제라는 뼈대는 확산 모델 시대까지 살아남았습니다.