 You know maize mean?
Emergence of Invariance and Disentanglement in Deep Representations
0. Summary
기본 정보 : ArXiv,2017.06.05 (JMLR 2018), Emergence of Invariance and Disentanglement in Deep Representations
연구 배경
딥러닝에서 좋은 표현(representation)이 갖추어야 할 성질로 충분성(sufficiency), 최소성(minimality), 불변성(invariance), 풀림(disentanglement) 이 오래전부터 거론되어 왔지만, 이 성질들이 서로 어떤 관계인지, 그리고 왜 평범한 교차 엔트로피로 학습한 심층 신경망에서 이런 성질이 “저절로” 나타나는지는 설명되지 않았다. 특히 Zhang et al.(2017)이 보인 것처럼 심층 신경망은 완전히 무작위인 라벨도 통째로 암기할 수 있을 만큼 용량이 크다. 그런데 같은 네트워크가 실제 라벨로 학습하면 일반화를 잘 한다. 파라미터 개수로 복잡도를 재는 고전적 관점으로는 이 현상을 설명할 수 없었고, 정보 병목(Information Bottleneck, IB) 이론도 “활성값이 입력에 대해 갖는 정보”에만 초점을 맞춰 학습 데이터셋과 가중치의 관계는 다루지 않았다.
제안 방법
논문은 두 가지 정보량을 구분한다. 하나는 활성값 $z$ 가 입력 $x$ 에 대해 갖는 정보 $I(z;x)$ 이고, 다른 하나는 가중치 $w$ 가 학습 데이터셋 $\mathcal{D}$ 에 대해 갖는 정보 $I(w;\mathcal{D})$ 다. 먼저 nuisance(과제와 무관한 변동 요인)에 대한 불변성이 사실 충분 표현의 최소성과 동치임을 증명한다(Proposition 3.1). 다음으로 교차 엔트로피 손실을 네 항으로 분해하여, 그중 가중치가 데이터셋을 암기하도록 부추기는 음(−)의 과적합 항 $-I(y;w\mid x,\theta)$ 을 드러내고, 이 항을 가중치에 대한 정보 병목 $\beta\,I(w;\mathcal{D})$ 로 상한을 잡는 정규화를 제안한다(Eq. 2–3). 가중치에 로그 정규 곱셈 잡음을 넣는 변형(Information Dropout, Variational Dropout 류)으로 이 정보량을 추정·최소화할 수 있다. 마지막으로 가중치의 정보가 활성값의 정보 $I(z;x)$ 와 전체 상관(Total Correlation) $TC(z)$ 의 합을 위아래로 묶는다는 쌍대성(duality) 을 증명하여(Proposition 5.1–5.2), 가중치에 저장된 정보를 줄이면 테스트 시 표현이 더 불변하고 더 풀린(disentangled) 표현이 됨을 보인다.
발견 사실
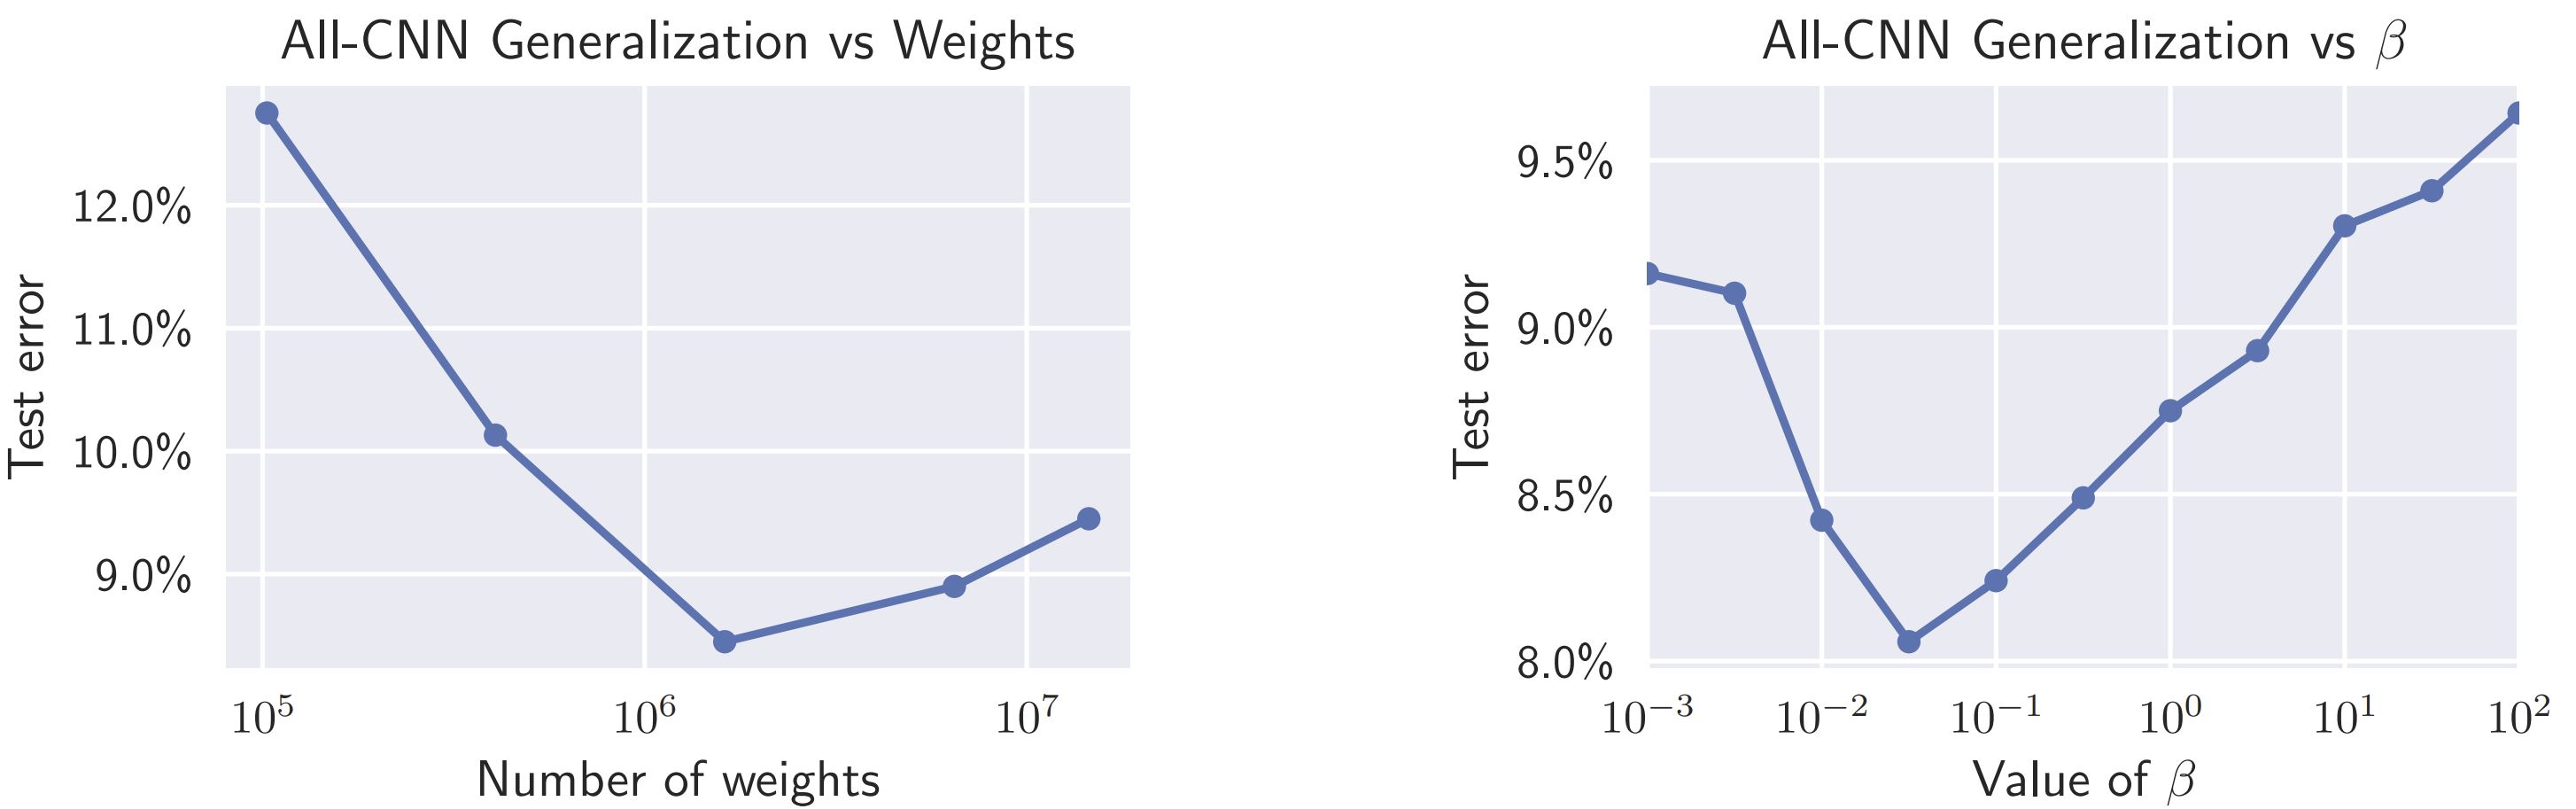
CIFAR-10 무작위 라벨 실험에서 정규화가 없는 AlexNet류 모델은 높은 정확도로 암기에 성공하지만, 가중치 정보 병목을 걸면 $\beta=1$ 부근에서 암기(과적합)와 언더피팅 사이의 날카로운 상전이가 나타났고, 이는 이론이 예측한 임계값과 일치했다(Figure 1, 2). 라벨 손상 비율을 높일수록 가중치에 필요한 정보량이 선형으로 늘었으며, 완전 무작위 라벨은 샘플당 약 3 nats로 10클래스 라벨의 부호화 비용(2.30 nats)과 같은 차수였다(Figure 2 우). All-CNN에서 파라미터 수를 늘려도 테스트 오차는 평평했지만 $\beta$ 를 조절하면 고전적인 U자형 편향-분산 곡선이 복원되어(Figure 3), 일반화를 결정하는 것은 파라미터 개수가 아니라 가중치에 담긴 정보량임을 보였다. Cluttered MNIST에서는 $\beta$ 를 키울수록 $I(z;n)$ 이 감소하면서 $I(z;y)$ 는 유지되었고(Figure 4), CelebA 재구성에서는 배경·머리 모양 같은 nuisance가 무작위화되며 머리색·성별·표정 같은 과제 속성만 남았다(Figure 5).
핵심 기여
- 불변성 = 최소성 정리 : nuisance $n$ 에 대해 $I(z;n)\le I(z;x)-I(x;y)$ 가 성립하므로, 충분 표현이 불변하기 위한 필요충분조건은 최소성이다(Prop. 3.1). 층을 쌓고 잡음을 더하는 것 자체가 표현을 불변성 쪽으로 편향시킨다(Prop. 3.5).
- 가중치 정보 병목과 과적합 항의 분리 : 교차 엔트로피를 내재 오차·충분성·효율성·과적합의 네 항으로 분해하고(Eq. 2), 과적합 항을 $\beta I(w;\mathcal{D})$ 로 제어하는 IB Lagrangian(Eq. 3)을 제안했다. $\beta=1$ 이 변분 학습(ELBO)과 일치하는 임계값이다.
- 가중치 정보와 활성값 정보의 쌍대성 : $I(z;x)+TC(z)$ 가 $\tilde I(W;\mathcal{D})$ 로 양쪽에서 촘촘히 묶이며(Prop. 5.2), 평탄한 최소점(flat minima)이 낮은 정보량을 뜻한다는 Hessian 기반 상한(Prop. 4.3)과 PAC-Bayes 경계(Eq. 7)를 같은 틀 안에 연결했다.
관련 개념
표현의 네 가지 바람직한 성질: 충분성·최소성·불변성·풀림
표현(representation) $z$ 는 입력 $x$ 의 확률적 함수 $p(z\mid x)$ 로 정의됩니다. 논문은 표현이 “좋다”는 말을 네 개의 정보이론적 성질로 정식화하고, 이들 사이의 관계를 정리(theorem)로 증명하는 데서 출발합니다. 이 절의 정의는 모두 논문 Section 2에 해당합니다.
📐 1. 네 성질의 정의
| 성질 | 정의 | 직관 |
|---|---|---|
| 충분성(sufficient) | $I(z;y)=I(x;y)$, 즉 $y\perp x\mid z$ | 과제 $y$ 를 푸는 데 필요한 정보를 하나도 잃지 않음 |
| 최소성(minimal) | 충분 표현 중 $I(x;z)$ 가 가장 작은 것 | 과제에 불필요한 입력 정보는 버림 |
| 불변성(invariant) | nuisance $n$ 에 대해 $I(z;n)=0$ | 과제와 무관한 변동(조명, 배경 등)에 반응하지 않음 |
| 풀림(disentangled) | $TC(z)=\mathrm{KL}\big(p(z)\,|\,\prod_i p(z_i)\big)=0$ | 표현의 각 성분이 서로 독립 |
여기서 nuisance 는 $I(y;n)=0$ 인 변수, 즉 과제와 무관한 변동 요인으로 정의됩니다. 엄밀한 불변성이 불가능하더라도 충분 표현 중 $I(z;n)$ 을 최소화하는 표현을 “최대한 둔감(maximally insensitive)”하다고 부릅니다. 상호정보량은 $I(z;x)=\mathbb{E}_x\,\mathrm{KL}\big(p(z\mid x)\,|\,p(z)\big)$ 로 계산합니다.
🔗 2. 불변성과 최소성의 동치 (Proposition 3.1)
이 논문의 첫 번째 핵심 정리입니다. $n$ 이 nuisance이고 $z$ 가 $x$ 를 통해서만 $n$ 에 의존하는 충분 표현이면,
\[I(z;n)\;\le\; I(z;x)-I(x;y)\]가 성립합니다. 우변은 “표현이 입력에 대해 갖는 정보 중 과제 정보를 뺀 나머지”, 즉 불필요한 정보의 양입니다. 등호는 잔차 $\varepsilon=I(z;y\mid n)-I(x;y)$, $0\le\varepsilon\le H(y\mid x)$ 를 제외하고 성립합니다. 따라서 충분 표현은 최소일 때 그리고 오직 그때만 불변합니다. 불변성을 위해 nuisance를 명시적으로 모델링할 필요 없이, 입력 정보를 가능한 한 적게 담도록 하면 충분하다는 뜻입니다.
| 따름정리 | 내용 |
|---|---|
| Cor. 3.3 | IB Lagrangian $\mathcal{L}=H(y\mid z)+\beta I(z;x)$ 를 $\beta\to 0^+$ 로 최소화하면 충분하고 불변인 표현을 얻음 |
| Cor. 3.4 | $z_1\to z_2$ 사이에 병목($I(z_1;z_2)<I(z_1;x)$)이 있으면, $z_2$ 가 충분한 한 $z_2$ 는 $z_1$ 보다 더 불변 |
| Prop. 3.5 | 마르코프 사슬 $x\to z_1\to\cdots\to z_L$ 에서 마지막 층 $z_L$ 이 충분하면 앞 층들보다 nuisance에 더 둔감 |
🧱 3. 왜 “층을 쌓는 것”이 불변성을 만드는가
Prop. 3.5는 심층 구조의 역할을 정보이론적으로 설명합니다. 각 층이 입력 정보의 일부를 잃는 병목으로 작동하면, 과제 정보를 보존하는 한 뒤로 갈수록 nuisance 정보는 줄어들 수밖에 없습니다. 논문은 이를 “층을 쌓고 학습 중 잡음을 넣는 것 자체가 네트워크를 불변 표현 쪽으로 편향시킨다”고 요약합니다. 다만 ResNet처럼 스킵 연결이 있으면 층 단위의 마르코프 사슬은 깨지고, 블록 단위에서만 성립한다는 점을 덧붙입니다.
💡 Key Takeaway 불변성은 별도로 설계할 성질이 아니라 최소성의 다른 이름입니다. 과제에 충분하면서 입력 정보를 최소로 담는 표현은 자동으로 모든 nuisance에 불변합니다.
교차 엔트로피 손실의 분해와 과적합 항
가중치 $w$ 를 학습 데이터셋 $\mathcal{D}$ 로부터 얻은 확률적 양 $q(w\mid\mathcal{D})$ 로 보면, 우리가 실제로 최소화하는 경험적 교차 엔트로피 $H_{p,q}(y\mid x,w)$ 를 해석 가능한 항들로 쪼갤 수 있습니다. 이것이 논문 Section 4의 출발점입니다.
🧮 1. 네 항 분해 (Eq. 2)
\[H_{p,q}(y\mid x,w)=\underbrace{H(y\mid x,\theta)}_{\text{내재 오차}}+\underbrace{I(\theta;y\mid x,w)}_{\text{충분성}}+\underbrace{\mathbb{E}_{x,w}\,\mathrm{KL}\big(p(y\mid x,w)\,\|\,q(y\mid x,w)\big)}_{\text{효율성}}-\underbrace{I(y;w\mid x,\theta)}_{\text{과적합}}\]| 항 | 의미 |
|---|---|
| 내재 오차 $H(y\mid x,\theta)$ | 데이터 생성 파라미터 $\theta$ 를 알아도 남는 불확실성. 줄일 수 없음 |
| 충분성 $I(\theta;y\mid x,w)$ | 가중치가 참 파라미터 $\theta$ 의 정보를 얼마나 담지 못했는가 |
| 효율성 | 모델 $q$ 가 참 분포 $p$ 를 얼마나 근사하지 못하는가 |
| 과적합 $-I(y;w\mid x,\theta)$ | 유일한 음수 항. 가중치가 $\theta$ 와 무관하게 라벨 $y$ 를 직접 암기하면 손실이 내려감 |
마지막 항이 핵심입니다. 정규화가 없는 네트워크는 이 항을 키워서, 즉 데이터셋 자체를 가중치에 저장해서 손실을 낮출 수 있습니다. 무작위 라벨도 암기되는 이유가 여기에 있습니다.
⚖️ 2. 가중치에 대한 정보 병목 (Eq. 3–5)
과적합 항은 직접 계산하기 어렵지만, 가중치가 데이터셋에 대해 갖는 전체 정보 $I(w;\mathcal{D})$ 로 상한을 잡을 수 있습니다. 그래서 논문은 다음 가중치 IB Lagrangian 을 제안합니다.
\[\mathcal{L}\big(q(w\mid\mathcal{D})\big)=H_{p,q}(y\mid x,w)+\beta\,I(w;\mathcal{D})\]$I(w;\mathcal{D})$ 자체도 계산이 어려우므로 사전분포 $p(w)$ 를 도입한 상한
\[\mathcal{L}=H_{p,q}(y\mid x,w)+\beta\,\mathrm{KL}\big(q(w\mid\mathcal{D})\,\|\,p(w)\big)\]을 쓰고(Eq. 4), 사전분포가 주변 분포의 인수분해 $\tilde q(w)=\prod_i q(w_i)$ 라는 가정 아래 $\tilde I(w;\mathcal{D}):=\mathrm{KL}\big(q(w\mid\mathcal{D})\,|\,\prod_i q(w_i)\big)$ 를 정의합니다(Eq. 5). $\beta=1$ 이면 이 식은 정확히 변분 하한(ELBO) 이 되므로, 가중치 IB는 변분 베이지안 학습의 일반화로 볼 수 있습니다.
🎲 3. 곱셈 잡음으로 정보량을 재는 방법 (Section 4.2, Prop. 4.1)
| 가중치를 $w_i\mid\mathcal{D}\sim\epsilon_i\hat w_i$, 즉 결정론적 값 $\hat w_i$ 에 평균 1인 로그 정규 곱셈 잡음 $\epsilon_i$ 를 곱한 꼴로 모델링하고, 사전분포로 스케일 불변인 로그 균등 분포 $\tilde q(w_i)=c/ | w_i | $ 를 두면 닫힌 형식의 상한이 나옵니다. |
여기서 $\alpha_i$ 는 잡음의 분산 파라미터입니다. 잡음이 클수록(= $\alpha_i$ 가 클수록) 가중치가 담는 정보는 줄어듭니다. 이 구조는 Variational Dropout(Kingma et al., 2015)과 Information Dropout의 로컬 재파라미터화 기법과 정확히 같아서, 기존 구현으로 바로 학습할 수 있습니다. 가우시안 잡음은 닫힌 형식이 없어 수치적으로 근사하며, 저자들은 이쪽이 학습이 약간 더 안정적이었다고 보고합니다.
🏔️ 4. 평탄한 최소점은 정보가 적다 (Proposition 4.3)
“평탄한 최소점(flat minima)이 더 잘 일반화한다”는 오래된 직관도 같은 틀에서 설명됩니다. 국소 최소점 $\hat w$ 의 Hessian을 $\mathcal{H}$, 파라미터 차원을 $K$ 라 하면
\[I(w;\mathcal{D})\le\tilde I(w;\mathcal{D})\le\tfrac12 K\Big[\log\|\hat w\|_2^2+\log\|\mathcal{H}\|_*-K\log\tfrac{K^2\beta}{2}\Big]\]입니다($|\cdot|_*$ 는 핵 노름). Hessian이 작을수록, 즉 최소점이 평탄할수록 가중치에 담긴 정보의 상한이 낮아집니다. 단 역은 성립하지 않습니다. 정보가 적다고 해서 반드시 평탄한 것은 아닙니다. 논문은 “정보량”이 평탄도보다 더 근본적인 양이라고 주장합니다.
💡 Key Takeaway 교차 엔트로피 안에는 암기를 보상하는 음의 항이 숨어 있습니다. 가중치가 데이터셋에 대해 갖는 정보 $I(w;\mathcal{D})$ 를 $\beta$ 로 벌점하면 이 항이 제어되고, $\beta=1$ 에서 변분 학습과 만납니다.
쌍대성: 가중치의 정보가 활성값의 정보를 결정한다
지금까지 두 종류의 정보가 등장했습니다. 학습 시 가중치가 과거(데이터셋) 에 대해 갖는 정보 $I(w;\mathcal{D})$ 와, 테스트 시 활성값이 미래(새 입력) 에 대해 갖는 정보 $I(z;x)$ 입니다. Section 5는 이 둘이 서로를 묶는다는 쌍대성(duality) 을 증명합니다. 이것이 논문 제목의 “emergence”를 설명하는 부분입니다.
🔁 1. 단일 층에서의 정확한 식 (Proposition 5.1, Eq. 6)
선형 층 $z=Wx$ 에서 $W=\epsilon\odot\hat W$ 로 곱셈 잡음을 넣으면
\[I(z;x)+TC(z)=-\tfrac12\sum_{i=1}^{\dim z}\mathbb{E}_x\log\frac{\tilde\alpha_i\hat W_i^2\cdot x^2}{\hat W_i\cdot\mathrm{Cov}(x)\hat W_i+\tilde\alpha_i\hat W_i^2\cdot\mathbb{E}(x^2)},\qquad\tilde\alpha_i=e^{\alpha_i}-1\]이 성립합니다. 좌변은 “활성값이 입력에 대해 갖는 정보”와 “활성값 성분 간 전체 상관”의 합이고, 우변은 가중치 잡음 $\alpha_i$ 에 대해 단조 감소합니다. 가중치에 잡음을 더 넣을수록 활성값은 입력 정보를 덜 담고 성분들은 더 독립적이 됩니다.
📏 2. 양쪽에서 촘촘한 경계 (Proposition 5.2, Corollary 5.3)
$\alpha=\exp{-I(W;\mathcal{D})/\dim W}$ 로 두면
\[g(\alpha)\;\le\;\frac{I(x;z)+TC(z)}{\dim z}\;\le\;g(\alpha)+c,\qquad g(\alpha)=-\tfrac12\log(1-e^{-\alpha}),\;c=O(1/\dim x)\]입니다. 즉 $I(x;z)+TC(z)$ 는 가중치 정보 $\tilde I(W;\mathcal{D})$ 의 단조 증가 함수로 위아래에서 거의 같은 값으로 묶입니다. 다층 네트워크로 확장하면
\[I(z_L;x)\le\min_{k<L}\dim(z_k)\big[g(\alpha^k)+1\big]\]이 되어(Cor. 5.3), 어느 한 층이라도 가중치 정보가 적으면 최종 표현의 입력 정보가 제한됩니다. 다만 이 다층 경계는 촘촘하지 않을 수 있다고 논문 스스로 적습니다(Remark 5.4).
🌉 3. 과거와 미래를 잇는 해석
| 학습 시 (가중치) | ⟺ | 테스트 시 (활성값) |
|---|---|---|
| $I(w;\mathcal{D})$ 감소 | → | $I(z;x)$ 감소 → 최소성 → Prop. 3.1에 의해 불변성 |
| $I(w;\mathcal{D})$ 감소 | → | $TC(z)$ 감소 → 풀림(disentanglement) |
따라서 가중치 IB 정규화 하나로 과적합 억제, nuisance 불변성, 풀린 표현이 동시에 따라 나옵니다. 저자들은 이를 “과거의 데이터셋에 대해 가중치가 덜 기억할수록, 미래의 입력에 대해 표현이 더 불변하고 더 풀린다”는 문장으로 요약합니다. 이 쌍대성은 데이터 처리 부등식(Data Processing Inequality)과도 부합합니다. 표현은 데이터보다 더 많은 정보를 담을 수 없기 때문입니다.
📜 4. PAC-Bayes와의 연결 (Section 6, Eq. 7)
McAllester(2013)의 PAC-Bayes 경계는 $\lambda>1/2$ 에 대해
\[\mathbb{E}_{\mathcal{D}}\big[L^{\text{test}}(q)\big]\le\frac{1}{N\big(1-\tfrac{1}{2\lambda}\big)}\Big(H_{p,q}(y\mid x,w)+\lambda L_{\max}\,\mathbb{E}_{\mathcal{D}}\,\mathrm{KL}\big(q(w\mid\mathcal{D})\,\|\,p(w)\big)\Big)\]입니다. 사전분포를 $p(w)=q(w)$ 로 택하면 KL 항의 기대값이 정확히 $I(w;\mathcal{D})$ 가 되어 가장 날카로운 경계가 되고, 이는 상수를 제외하고 가중치 IB Lagrangian 과 일치합니다. 즉 가중치 정보 병목은 PAC-Bayes 일반화 경계를 직접 최소화하는 것과 같습니다. 단, 논문의 로그 균등 사전분포는 비정상(improper)이어서 그 모델 아래서는 경계 값 자체는 무의미(vacuous)하다는 한계도 명시합니다.
💡 Key Takeaway 가중치의 정보와 활성값의 정보는 같은 양의 두 얼굴입니다. 학습 데이터를 덜 암기하도록 만들면, 새 입력에 대한 표현은 자동으로 최소·불변·풀림 성질을 갖습니다.
합리성 파라미터 $\beta$ 와 과적합 상전이
가중치 IB Lagrangian의 $\beta$ 는 “데이터 적합”과 “가중치 정보 절약” 사이의 교환비입니다. 논문은 $\beta$ 를 바꿔 가며 무작위 라벨 암기가 갑자기 불가능해지는 임계점이 존재함을 이론과 실험으로 보입니다(Section 7.1).
🌡️ 1. 이론적 예측
| 조건 | 예측 |
|---|---|
| 무작위 라벨, $\beta>1$ | 암기 불가. 라벨을 저장하는 데 드는 정보 비용이 손실 감소보다 큼 |
| 무작위 라벨, $\beta<1$ | 암기 가능(과적합) |
| 실제 라벨 | $\beta<1$ 에서 과적합 가능하지만, $\beta N\propto I(w;\mathcal{D})$ 가 $H(\theta)$ 를 넘으면 넓은 범위의 $\beta>1$ 에서 과적합 없이 적합 |
핵심 직관은 이렇습니다. 무작위 라벨 $N$ 개를 맞추려면 가중치에 라벨 수만큼의 정보를 저장해야 하므로 필요한 $I(w;\mathcal{D})$ 가 $N$ 에 비례해 선형으로 증가합니다. 반면 실제 라벨은 생성 규칙 $\theta$ 만 저장하면 되므로 필요한 정보가 데이터셋 의존 상수로 포화합니다(Figure 1 우).
🧪 2. 실험 설정 (Appendix A.1)
| 항목 | 값 |
|---|---|
| 데이터 | CIFAR-10 중앙 28×28 크롭, 채널별 정규화, 증강 없음 |
| 모델 | Small AlexNet(5×5 conv + BN), All-CNN, ResNet(pre-activation) |
| 최적화 | SGD momentum 0.9, batch 500, 360 epoch, lr 0.02 또는 0.005를 140 epoch마다 1/10, weight decay 없음 |
| 상전이 스윕 | $N=10{,}000$ 무작위 라벨, $\beta\in[10^{-2},10^{2}]$ 로그 균등 |
| 라벨 손상 실험 | $\beta=0.1$, $N=30{,}000$, $\eta=0.005$ |
📊 3. 관찰된 상전이 (Figure 1, 2)
- Figure 1 좌: 정규화 없는 AlexNet은 무작위 라벨에서도 높은 정확도를 냅니다. 가중치 IB를 걸면 $\beta=1$ 근처에서 과적합→언더피팅으로 급격히 전환되며, 점선으로 표시된 이론 예측과 가깝습니다.
- Figure 2 좌: Small AlexNet, All-CNN, ResNet 모두 $\beta=1$ 직전에서 날카로운 전이를 보입니다. ResNet의 전이가 가장 날카롭고, 저자들은 이 전이가 아키텍처에 거의 독립적이라고 해석합니다.
- Figure 2 우: 라벨 손상 비율을 높일수록 가중치에 들어가는 정보가 증가하며, 완전 무작위 라벨에서는 샘플당 약 3 nats 가 추가로 필요합니다. 10클래스 라벨 하나를 부호화하는 $\ln 10\approx 2.30$ nats 와 같은 차수입니다.
💡 Key Takeaway $\beta=1$ 은 임의의 하이퍼파라미터가 아니라 암기가 비용을 못 이기는 임계점입니다. 이 값 근처에서 세 가지 아키텍처가 모두 같은 상전이를 보인 것은 현상이 모델이 아니라 정보량에 의해 결정됨을 시사합니다.
실험: 정보량으로 본 편향-분산, 불변성, 시각화
Section 7.2–7.3과 Appendix A는 가중치 정보량이 실제로 일반화·불변성·풀림을 추적하는지 세 가지 실험으로 검증합니다. 수치보다는 곡선의 형태가 핵심이며, 논문도 대부분을 그래프로만 제시합니다.
📉 1. 파라미터 수 vs. 정보량: 편향-분산 교환 (Figure 3)
| 조작 변수 | 결과 |
|---|---|
| 가중치 개수 증가 (All-CNN, weight decay 0.001만 사용) | 테스트 오차가 올라가지 않고 평평하게 포화 |
| $\beta$ 로 가중치 정보량 조절 | 정보가 적으면 언더피팅, 많으면 과적합인 고전적 U자 곡선 복원 |
파라미터 개수로는 “모델이 클수록 과적합한다”는 고전 이론이 재현되지 않지만, 정보량을 복잡도 척도로 쓰면 편향-분산 교환이 그대로 나타납니다. 저자들은 유효 복잡도의 올바른 척도는 파라미터 수가 아니라 $I(w;\mathcal{D})$ 라고 결론짓습니다.
🎭 2. Cluttered MNIST에서의 nuisance 불변성 (Figure 4)
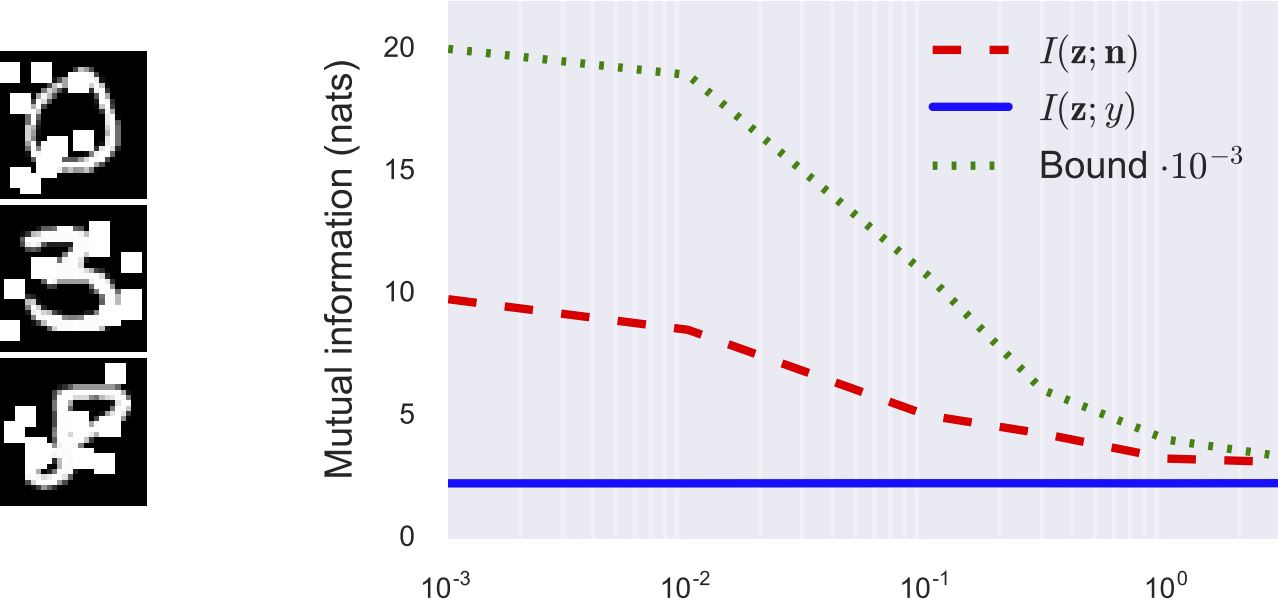
각 숫자 이미지에 4×4 가림 사각형 10개를 무작위로 얹습니다. 사각형의 위치가 nuisance $n$, 숫자가 과제 $y$ 입니다. $I(z;n)$ 은 직접 계산이 불가능하므로 판별기(discriminator)로 로그 가능도비 $\log\frac{p(z\mid n)}{p(z)}$ 를 학습해 몬테카를로 추정합니다. 결과는 $\beta$ 가 커질수록 $I(z;n)$ 이 감소하면서 $I(z;y)=I(x;y)$ 는 유지되는 것으로, Corollary 5.3의 이론 경계와 유사한 거동을 보였습니다. 다만 이 추정에는 근사 품질 보장이 없다고 논문은 명시합니다.
🖼️ 3. CelebA 재구성으로 본 “무엇이 버려지는가” (Figure 5, Appendix A.4)
32×32 CelebA에서 40개 이진 속성을 과제로 두고, GAN 방식 디코더로 $z$ 에서 이미지를 복원합니다. $\beta$ 를 키울수록 복원 이미지에서 배경과 머리 모양은 매번 다르게 생성되는 반면 머리색·성별·표정 같은 과제 관련 속성은 보존됩니다. 표현이 어떤 정보를 nuisance로 판단해 버렸는지를 눈으로 확인하는 실험입니다.
💡 Key Takeaway 세 실험 모두 같은 그림을 그립니다. 가중치 정보량 $\beta$ 를 조이면 일반화 곡선은 U자로, nuisance 정보는 0으로, 재구성은 과제 속성만 남는 쪽으로 움직입니다.
정보 병목(Information Bottleneck) 이론과의 관계
이 논문은 Tishby et al.의 정보 병목(IB) 원리를 계승하면서도 그 적용 대상을 바꾸었습니다. 어디까지가 기존 IB이고 어디서부터가 이 논문의 확장인지를 구분하면 “활성값의 IB”와 “가중치의 IB”라는 두 층위가 분명해집니다.
📚 1. 고전적 IB: 활성값에 대한 병목
Tishby & Zaslavsky(2015)의 IB는 표현 $z$ 에 대해 다음 Lagrangian을 최소화합니다.
\[\mathcal{L}_{IB}=H(y\mid z)+\beta\,I(z;x)\]첫 항은 과제 정보를 보존하라는 충분성 요구이고, 둘째 항은 입력 정보를 버리라는 최소성 요구입니다. Corollary 3.3은 바로 이 식을 $\beta\to 0^+$ 로 풀면 충분하고 불변인 표현이 나온다고 말합니다. 즉 고전 IB는 이 논문의 Section 3(불변성 = 최소성)과 직접 연결됩니다. 하지만 고전 IB는 “어떻게 학습하면 $I(z;x)$ 가 줄어드는가” 에 답하지 않습니다. $I(z;x)$ 는 테스트 시 활성값의 성질이고, 우리가 조작하는 것은 학습 시 가중치이기 때문입니다.
🔁 2. 이 논문의 확장: 가중치에 대한 병목
| 층위 | Lagrangian | 변수 | 조작 시점 |
|---|---|---|---|
| 활성값 IB (Tishby) | $H(y\mid z)+\beta I(z;x)$ | 표현 $z$ | 테스트 시 성질 |
| 가중치 IB (본 논문) | $H_{p,q}(y\mid x,w)+\beta I(w;\mathcal{D})$ | 가중치 $w$ | 학습 시 직접 최소화 가능 |
가중치 IB는 Section 4의 손실 분해에서 자연스럽게 나오며, 곱셈 잡음 파라미터화로 실제 학습 가능한 목적 함수가 됩니다. 그리고 Section 5의 쌍대성이 두 층위를 잇습니다. 가중치 IB를 최소화하면 활성값 IB의 $I(z;x)$ 도 함께 줄어듭니다. 결과적으로 고전 IB가 “표현이 가져야 할 성질”을 말했다면, 이 논문은 “그 성질을 얻는 학습 절차” 를 제공한 셈입니다.
🧰 3. Information Dropout과의 관계
같은 저자들의 Information Dropout(2018)은 활성값에 곱셈 잡음을 넣어 $I(z;x)$ 를 직접 벌점하는 활성값 IB의 구현입니다. 이 논문은 잡음을 가중치에 넣어 $I(w;\mathcal{D})$ 를 벌점하는 것이 더 근본적이라고 봅니다. 두 방법의 관계를 정리하면 다음과 같습니다.
| Information Dropout | 본 논문의 가중치 IB | |
|---|---|---|
| 잡음 위치 | 활성값 | 가중치 |
| 벌점 대상 | $I(z;x)$ | $I(w;\mathcal{D})$ |
| 과적합(암기)과의 연결 | 간접적 | 직접적 (Eq. 2의 과적합 항) |
| 불변성·풀림 | 직접 유도 | 쌍대성(Prop. 5.1–5.2)을 통해 유도 |
| 실무 구현 | Information Dropout 층 | Variational Dropout 류 가중치 잡음 |
Dropout, Variational Dropout, 가중치 잡음 같은 널리 쓰이는 정규화 기법들이 모두 가중치의 정보를 줄이는 장치로 재해석된다는 것이 이 틀의 실용적 함의입니다.
💡 Key Takeaway 고전 IB는 “표현은 최소·충분해야 한다”고 말하고, 이 논문은 “가중치를 최소·충분하게 만들면 표현이 따라온다” 고 말합니다. 활성값 IB와 가중치 IB를 잇는 다리가 Section 5의 쌍대성입니다.
한계와 열린 방향
이 논문은 이론 논문의 성격이 강하며, 저자들은 증명의 전제와 실험 추정의 한계를 비교적 솔직하게 적어 두었습니다. 이후 연구가 어디서 이어졌는지와 함께 정리합니다.
⚠️ 1. 논문이 명시한 한계
- 다층 경계의 느슨함(Remark 5.4): Corollary 5.3은 병목을 통과하는 정보를 모르기 때문에 촘촘하지 않을 수 있습니다. 쌍대성이 정확히 성립하는 것은 단일 선형 층(Prop. 5.1)뿐입니다.
- 비정상 사전분포: 로그 균등 사전분포는 정규화되지 않으므로 PAC-Bayes 경계의 수치 자체는 의미가 없습니다. 최적화 방향만 유효합니다.
- 가우시안 잡음의 근사: 로그 정규 잡음과 달리 가우시안 곱셈 잡음은 정보량의 닫힌 형식이 없어 수치 근사에 의존합니다.
- nuisance 정보 추정: 판별기 기반 $I(z;n)$ 추정에는 품질 보장이 없습니다.
- 충분성 가정(Remark 5.5): 테스트 데이터에서도 충분성이 유지된다고 가정하며, 전이 학습(transfer learning) 상황은 다루지 않습니다.
🔭 2. 이론적 전제에 대한 비판적 시각
| 쟁점 | 내용 |
|---|---|
| 표현의 확률성 | 논문은 표현이 본질적으로 확률적이라고 가정합니다. 결정론적 네트워크에서는 $I(z;x)$ 가 무한대가 되어 IB 논의가 성립하지 않는다는 비판(Saxe et al., 2018 등)이 이후 제기되었습니다. |
| 평탄도 ↔ 정보량 | Prop. 4.3은 한 방향 함의만 제공합니다. 재파라미터화에 따라 평탄도가 바뀐다는 Dinh et al.(2017)의 지적과 맞물려, 정보량이 더 근본적이라는 저자들의 주장은 여전히 논쟁적입니다. |
| 스킵 연결 | ResNet에서는 층 단위 마르코프 사슬이 깨지므로 Prop. 3.5의 “깊이가 불변성을 만든다”는 논리는 블록 단위로 약화됩니다. |
🚀 3. 후속 연구와의 연결
- 같은 저자들의 Information Dropout(Achille & Soatto, 2018, PAMI)은 이 논문의 활성값 쪽 정규화를 구체화한 것이고, Critical Learning Periods(2019)와 Task2Vec(2019)는 여기서 정의한 가중치 정보량(Fisher 정보 기반)을 학습 동역학과 과제 간 거리 측정에 응용했습니다.
- 논문이 미래 과제로 꼽은 능동 학습(active learning) 과 과제 거리(task distance) 는 Task2Vec으로 이어졌습니다.
- 가중치 IB의 $\beta$ 상전이는 이후 grokking 이나 double descent 처럼 “파라미터 수가 아닌 다른 복잡도 척도”가 필요하다는 논의의 선행 사례로 자주 인용됩니다.
💡 Key Takeaway 이 논문의 가치는 개별 수치가 아니라 충분성·최소성·불변성·풀림·평탄도·PAC-Bayes를 하나의 정보량 $I(w;\mathcal{D})$ 로 꿰어낸 틀에 있습니다. 전제(확률적 표현, 로그 균등 사전분포)는 논쟁의 여지가 있지만, “일반화를 재는 것은 파라미터 수가 아니라 가중치에 담긴 정보”라는 명제는 이후 연구의 기준점이 되었습니다.