 You know maize mean?
A Style-Based Generator Architecture for Generative Adversarial Networks
0. Summary
기본 정보 : ArXiv,2018.12.12 (CVPR 2019), A Style-Based Generator Architecture for Generative Adversarial Networks
연구 배경
Progressive GAN 이후 GAN이 만들어내는 이미지의 해상도와 품질은 빠르게 좋아졌지만, 생성기(generator)는 여전히 블랙박스로 남아 있었다. 생성 이미지의 확률적 디테일(머리카락 결, 주근깨 등)이 어디서 오는지, 잠재 공간(latent space)이 어떤 성질을 갖는지에 대한 이해가 부족했고, 흔히 보여주는 잠재 공간 보간(interpolation) 데모는 서로 다른 생성기를 정량적으로 비교할 방법을 제공하지 못했다. 또한 전통적인 생성기는 잠재 코드 $z$ 를 입력층 한 곳에만 넣기 때문에, 입력 잠재 공간이 훈련 데이터의 확률 밀도를 그대로 따라야 하고, 이 제약이 변동 요인(factors of variation)의 얽힘(entanglement) 을 피할 수 없게 만든다는 점도 문제로 지적되었다. GAN 아키텍처 연구의 대부분은 판별기(discriminator) 개선에 집중되어 있었고, 생성기 쪽은 입력 잠재 분포를 다듬는 수준에 머물러 있었다.
제안 방법
스타일 전이(style transfer) 문헌에서 아이디어를 빌려 생성기 아키텍처를 다시 설계한다. 잠재 코드 $z\in\mathcal{Z}$ 를 8층 MLP 매핑 네트워크 $f$ 로 중간 잠재 공간 $\mathcal{W}$ 에 보내고, 학습된 아핀 변환으로 $w$ 를 스타일 $y=(y_s,y_b)$ 로 특수화한 뒤, 합성 네트워크 $g$ 의 모든 합성곱 층 뒤에서 AdaIN(adaptive instance normalization) 으로 특징 맵의 채널별 통계를 조정한다. 입력층은 아예 없애고 학습된 $4\times4\times512$ 상수 텐서에서 합성을 시작하며, 각 합성곱 뒤에 픽셀별 가우시안 노이즈를 더해 확률적 디테일을 직접 공급한다. 훈련 중에는 두 개의 잠재 코드를 무작위 지점에서 바꿔 끼우는 스타일 혼합 정규화(mixing regularization) 를 적용한다. 판별기와 손실 함수는 전혀 바꾸지 않는다. 더불어 잠재 공간의 얽힘 정도를 재는 두 가지 자동 지표인 지각 경로 길이(perceptual path length) 와 선형 분리성(linear separability) 을 제안하고, 고품질 얼굴 데이터셋 FFHQ(Flickr-Faces-HQ)를 공개한다.
발견 사실
FFHQ 기준으로 Progressive GAN 베이스라인(config A)의 FID 8.04 는 튜닝(B)으로 5.25, 매핑 네트워크와 스타일 추가(C)로 4.85, 노이즈 입력(E)으로 4.42, 혼합 정규화(F)로 4.40 까지 내려간다. 스타일 기반 생성기(E)는 전통 생성기(B)보다 FID를 거의 20% 개선한다(Table 1). 스타일은 해상도별로 국소화되어 거친 해상도($4^2$–$8^2$)는 포즈·얼굴형·안경을, 중간 해상도($16^2$–$32^2$)는 세부 얼굴 특징과 눈 개폐를, 미세 해상도($64^2$–$1024^2$)는 색 구성과 미세 구조를 제어한다(Figure 3). 노이즈는 정체성이나 포즈 같은 전역 속성은 건드리지 않고 머리카락·배경·실루엣 같은 확률적 디테일만 바꾼다(Figure 4, 5). 지각 경로 길이와 선형 분리성 모두에서 $\mathcal{W}$ 가 $\mathcal{Z}$ 보다 일관되게 덜 얽혀 있었으며(분리성 10.78 → 3.79), 매핑 네트워크가 깊을수록 FID·경로 길이·분리성이 함께 좋아졌다(Table 3, 4). 흥미롭게도 전통 생성기 앞에 매핑 네트워크를 붙이면 $\mathcal{Z}$ 의 분리성은 170.29로 크게 나빠지지만 $\mathcal{W}$ 는 좋아지고 FID도 개선된다.
핵심 기여
- 스타일 기반 생성기 아키텍처 : 입력층 대신 학습된 상수에서 출발하고, 매핑 네트워크 $f:\mathcal{Z}\to\mathcal{W}$ 와 AdaIN을 통해 매 층의 “스타일”을 조정하며, 픽셀별 노이즈로 확률적 변동을 공급한다. 손실·판별기를 건드리지 않고도 FID를 크게 낮추고, 고수준 속성과 확률적 변동의 비지도 분리와 해상도별 제어를 가능하게 했다.
- 중간 잠재 공간 $\mathcal{W}$ 와 얽힘 분석 : 입력 잠재 공간이 훈련 분포를 따라야 해서 생기는 불가피한 얽힘을 지적하고, 그 제약에서 자유로운 $\mathcal{W}$ 가 더 선형적이고 덜 얽힌 표현을 학습함을 보였다. 절단 기법(truncation trick)도 $\mathcal{W}$ 에서 수행할 수 있음을 제시했다.
- 두 가지 자동 분리성 지표와 FFHQ : 인코더가 필요 없는 지각 경로 길이와 선형 분리성을 제안해 임의의 생성기 아키텍처에 적용 가능하게 했고, $1024^2$ 해상도 70,000장의 FFHQ 데이터셋을 코드·사전훈련 모델과 함께 공개했다.
관련 개념
스타일 기반 생성기의 전체 구조
스타일 기반 생성기(style-based generator) 는 잠재 코드를 “입력”이 아니라 “스타일”로 네트워크에 공급한다는 발상에서 출발합니다. 전통적인 생성기가 $z$ 를 첫 층에 한 번 넣고 그 뒤로는 손을 떼는 것과 달리, 이 생성기는 매 합성곱 층마다 잠재 코드에서 유도된 스타일로 특징 맵의 통계를 다시 씁니다.
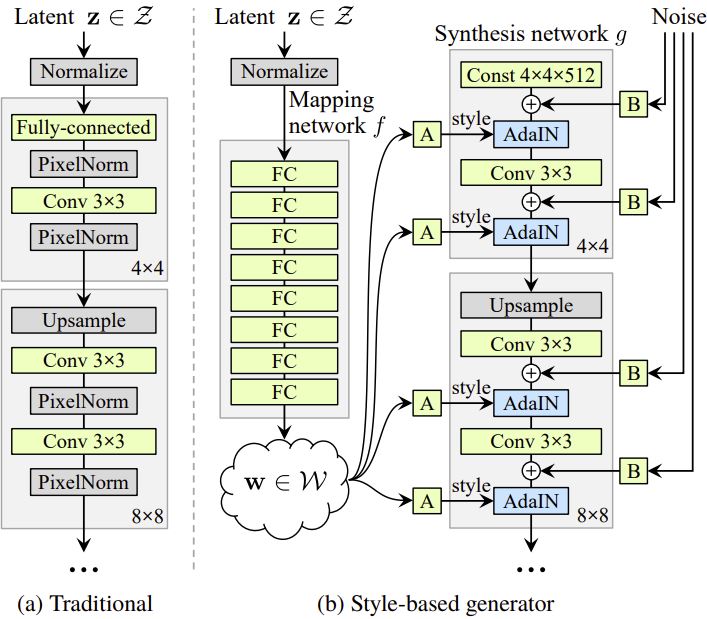
🏗️ 1. 전통 생성기와의 비교 (Figure 1)
| 구분 | 전통 생성기 (Progressive GAN) | 스타일 기반 생성기 |
|---|---|---|
| 잠재 코드 투입 위치 | 입력층(첫 번째 층) 한 곳 | 모든 합성곱 층 뒤의 AdaIN |
| 합성 시작점 | $z$ 를 투영한 텐서 | 학습된 $4\times4\times512$ 상수 |
| 잠재 공간 | $\mathcal{Z}$ (512차원, 정규분포) | $\mathcal{Z}\to\mathcal{W}$ (둘 다 512차원) |
| 확률적 디테일의 원천 | 네트워크가 이전 활성값에서 스스로 만들어야 함 | 층마다 주입되는 노이즈 이미지 |
| 훈련 가능 파라미터 | 23.1M | 26.2M |
매핑 네트워크 $f$ 는 8개의 완전연결층으로 구성되고, 합성 네트워크 $g$ 는 $4^2$ 부터 $1024^2$ 까지 해상도마다 2개씩 총 18개 층으로 구성됩니다. 마지막 층의 출력은 별도의 $1\times1$ 합성곱으로 RGB로 변환됩니다.
🔀 2. 세 가지 구성 요소
(1) 매핑 네트워크 $f:\mathcal{Z}\to\mathcal{W}$ — 정규분포에서 뽑은 $z$ 를 비선형 변환해 $w$ 를 만듭니다. 이 네트워크의 존재 이유는 4절(분리성 연구)에서 분석되는데, 핵심은 $\mathcal{W}$ 가 고정된 분포를 따를 필요가 없다는 점입니다.
(2) 학습된 아핀 변환 A와 AdaIN — 각 층마다 $w$ 를 아핀 변환해 스타일 $y=(y_s,y_b)$ 를 만들고, 이것이 AdaIN 연산을 제어합니다. $y$ 의 차원은 해당 층 특징 맵 수의 두 배입니다.
(3) 노이즈 입력 B — 상관관계 없는 가우시안 노이즈로 이루어진 단일 채널 이미지를 층마다 하나씩 공급합니다. 학습된 채널별 스케일 계수로 모든 특징 맵에 브로드캐스트한 뒤, 해당 합성곱 출력에 더하고 비선형성을 적용합니다.
📊 3. 단계별 FID 개선 (Table 1)
논문은 Progressive GAN 설정을 베이스라인으로 삼아 구성 요소를 하나씩 추가하며 FID를 측정했습니다. FID는 훈련 세트에서 무작위로 뽑은 50,000장으로 계산하고, 훈련 과정에서 관측된 최솟값을 보고합니다.
| 구성 | 방법 | CelebA-HQ | FFHQ |
|---|---|---|---|
| A | Progressive GAN 베이스라인 | 7.79 | 8.04 |
| B | + 튜닝(bilinear up/down, 더 긴 훈련, 하이퍼파라미터) | 6.11 | 5.25 |
| C | + 매핑 네트워크와 스타일(AdaIN) | 5.34 | 4.85 |
| D | + 전통적 입력층 제거(학습된 상수) | 5.07 | 4.88 |
| E | + 노이즈 입력 | 5.06 | 4.42 |
| F | + 혼합 정규화 | 5.17 | 4.40 |
구성 C에서 저자들은 잠재 코드를 첫 합성곱 층에 넣어도 더 이상 이득이 없다는 사실을 발견했고, 이에 따라 입력층을 제거하고 학습된 상수에서 시작하도록 단순화했습니다(D). 합성 네트워크가 AdaIN을 제어하는 스타일만으로 입력을 받으면서도 의미 있는 결과를 낸다는 점을 저자들은 주목할 만하다고 평합니다. 손실 함수는 CelebA-HQ에서 WGAN-GP, FFHQ에서는 구성 A만 WGAN-GP이고 B–F는 비포화 손실(non-saturating loss)과 $R_1$ 정규화를 사용했습니다. 논문의 기여는 손실 함수를 수정하지 않습니다.
💡 Key Takeaway 잠재 코드를 “입력”이 아니라 매 층의 “스타일”로 공급하는 것만으로, 판별기와 손실을 그대로 둔 채 FID가 베이스라인 대비 크게 개선됩니다. 입력층은 없어도 되고, 노이즈와 혼합 정규화가 그 위에 추가 이득을 줍니다.
AdaIN과 스타일의 국소화
AdaIN(Adaptive Instance Normalization) 은 피드포워드 스타일 전이에서 쓰이던 연산으로, 특징 맵을 채널별로 정규화한 뒤 외부에서 주어진 스케일과 편향으로 다시 통계를 입히는 연산입니다. StyleGAN은 예시 이미지 대신 벡터 $w$ 에서 공간 불변 스타일 $y$ 를 계산한다는 점이 스타일 전이와 다릅니다.
🧮 1. AdaIN 정의 (Eq. 1)
\[\mathrm{AdaIN}(x_i, y) = y_{s,i}\,\frac{x_i - \mu(x_i)}{\sigma(x_i)} + y_{b,i}\]각 특징 맵 $x_i$ 는 따로 정규화되고(평균 0, 분산 1), 스타일 $y$ 에서 대응하는 스칼라 성분 $y_{s,i}$, $y_{b,i}$ 로 스케일·편향됩니다. 저자들이 보다 일반적인 특징 변환 대신 AdaIN을 고른 이유는 효율성과 간결한 표현 때문입니다. “스타일”이라는 단어를 재사용한 것은 유사한 구조가 이미 피드포워드 스타일 전이, 비지도 이미지 변환, 도메인 혼합에 쓰이고 있기 때문입니다.
📍 2. 왜 스타일이 국소화되는가 (Section 3)
AdaIN은 먼저 채널을 정규화하고 그 다음 스타일에 따라 스케일·편향을 적용합니다. 스타일이 지정한 새로운 채널별 통계는 다음 합성곱 연산에서 특징들의 상대적 중요도를 바꾸지만, 정규화 때문에 원래 통계에는 의존하지 않습니다. 따라서 각 스타일은 다음 AdaIN에 의해 덮어쓰이기 전까지 하나의 합성곱만 제어합니다.
| 관점 | 해석 |
|---|---|
| 매핑 네트워크 + 아핀 변환 | 학습된 분포에서 각 스타일의 샘플을 뽑는 장치 |
| 합성 네트워크 | 스타일의 모음을 바탕으로 새 이미지를 만드는 장치 |
| 스타일 일부의 수정 | 이미지의 특정 측면에만 영향 |
🌐 3. 전역 효과와 확률적 효과의 분리 (Section 3.3)
스타일은 전체 특징 맵을 같은 값으로 스케일·편향하므로 이미지 전체에 영향을 줍니다. 포즈, 조명, 배경 스타일 같은 전역 효과를 일관되게 제어할 수 있는 이유입니다. 반면 노이즈는 픽셀마다 독립적으로 더해지므로 확률적 변동을 제어하기에 알맞습니다. 만약 네트워크가 노이즈로 포즈를 제어하려 들면 공간적으로 일관되지 않은 결정이 생겨 판별기에게 벌점을 받게 됩니다. 그래서 명시적 지침 없이도 네트워크는 전역 채널(스타일)과 국소 채널(노이즈)을 적절히 나눠 쓰는 법을 배웁니다. 이 관찰은 공간 불변 통계(Gram 행렬, 채널별 평균·분산)가 이미지의 스타일을 안정적으로 부호화한다는 스타일 전이 문헌의 결론과도 일치합니다.
💡 Key Takeaway AdaIN의 “정규화 후 재통계화” 구조 덕분에 각 스타일은 딱 한 합성곱만 지배합니다. 이 국소성이 해상도별 제어의 수학적 근거이고, 전역(스타일) 대 국소(노이즈)의 역할 분담은 판별기의 압력에 의해 저절로 생겨납니다.
스타일 혼합과 혼합 정규화
스타일 혼합(style mixing) 은 두 개의 잠재 코드로 만든 스타일을 합성 네트워크의 서로 다른 층에 나눠 적용하는 연산이고, 혼합 정규화(mixing regularization) 는 이를 훈련 중에 일정 비율의 이미지에 적용하는 정규화 기법입니다.
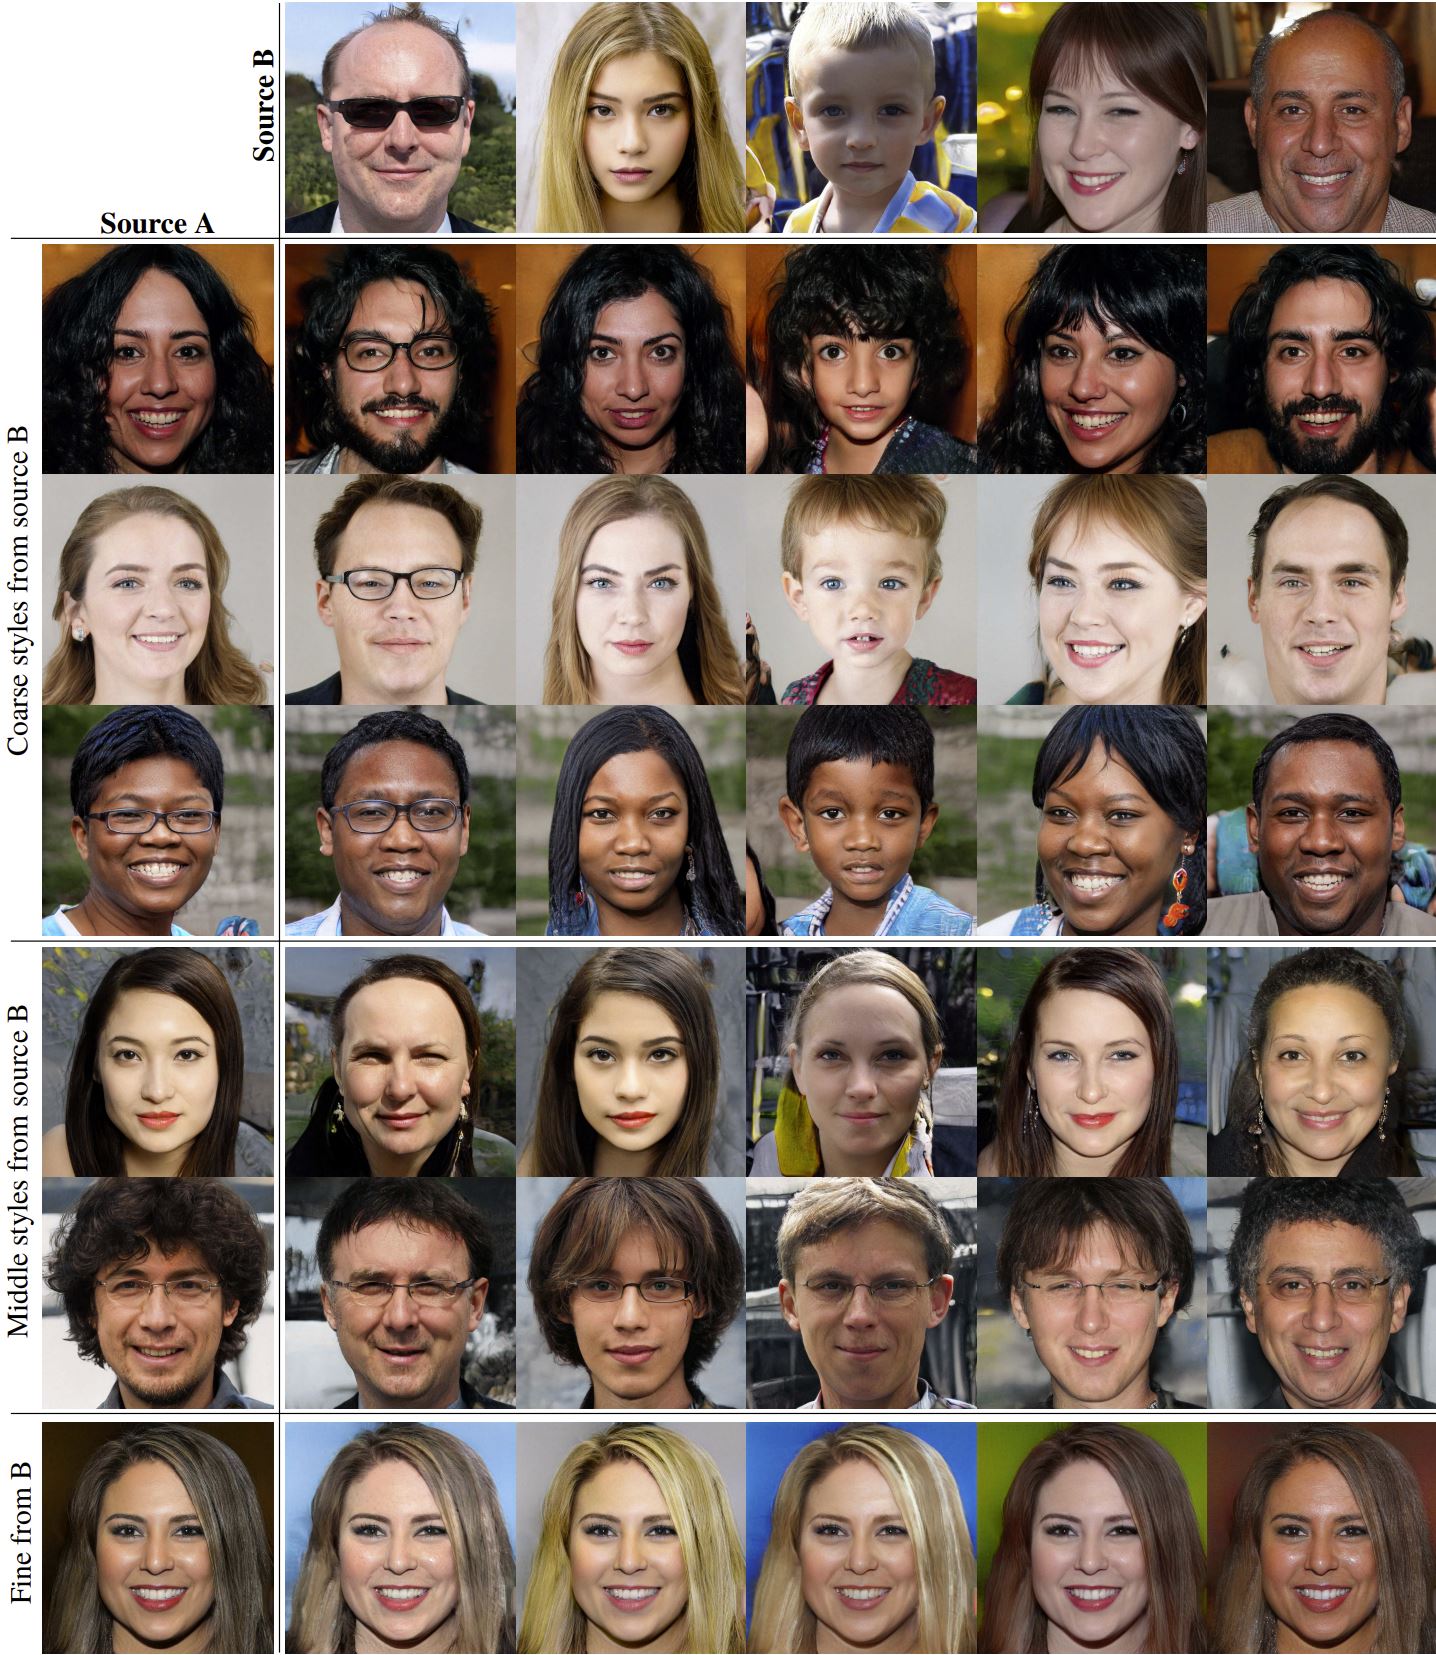
🎨 1. 혼합 정규화의 절차 (Section 3.1)
- 두 잠재 코드 $z_1$, $z_2$ 를 매핑 네트워크에 통과시켜 $w_1$, $w_2$ 를 얻습니다.
- 합성 네트워크에서 무작위로 교차점(crossover point) 을 고릅니다.
- 교차점 이전 층에는 $w_1$, 이후 층에는 $w_2$ 를 스타일로 적용합니다.
이 기법은 네트워크가 인접한 스타일들이 서로 상관되어 있다고 가정하는 것을 막습니다. 결과적으로 스타일의 국소화가 더 강해지고, 생성 이미지를 더 세밀하게 제어할 수 있게 됩니다.
🔬 2. 해상도 구간별로 무엇이 옮겨지는가 (Figure 3)
소스 A의 스타일 일부를 소스 B의 것으로 바꿨을 때 나타나는 변화입니다.
| 해상도 구간 | B에서 가져오는 것 | A에서 유지되는 것 |
|---|---|---|
| 거친(coarse) $4^2$–$8^2$ | 포즈, 전반적 헤어스타일, 얼굴형, 안경 | 모든 색(눈, 머리, 조명), 세부 얼굴 특징 |
| 중간(middle) $16^2$–$32^2$ | 더 작은 규모의 얼굴 특징, 머리 모양, 눈 개폐 | 포즈, 전반적 얼굴형, 안경 |
| 미세(fine) $64^2$–$1024^2$ | 색 구성(color scheme), 미세 구조 | 그 외 구조적 요소 |
📈 3. 테스트 시 여러 잠재 코드 혼합에 대한 내성 (Table 2)
FFHQ에서 훈련 중 혼합 정규화를 적용한 비율을 달리한 네트워크를, 테스트 시 1~4개의 잠재 코드를 무작위 교차점으로 섞어 평가한 FID입니다.
| 구성 | 혼합 비율 | 1개 | 2개 | 3개 | 4개 |
|---|---|---|---|---|---|
| E | 0% | 4.42 | 8.22 | 12.88 | 17.41 |
| E | 50% | 4.41 | 6.10 | 8.71 | 11.61 |
| F | 90% | 4.40 | 5.11 | 6.88 | 9.03 |
| F | 100% | 4.83 | 5.17 | 6.63 | 8.40 |
혼합 정규화 없이 훈련한 네트워크는 잠재 코드를 4개 섞으면 FID가 17.41까지 치솟지만, 90% 혼합으로 훈련하면 9.03에 머뭅니다. 100% 혼합은 다중 혼합 내성은 가장 좋지만 단일 잠재 코드 FID가 4.83으로 나빠져, 논문은 90%를 기본 구성(F)으로 채택했습니다.
💡 Key Takeaway 훈련 중 스타일을 무작위로 바꿔 끼우면 네트워크는 “인접 층의 스타일이 같다”는 가정을 버리게 됩니다. 그 결과 해상도 구간별 스타일이 독립적인 제어 손잡이가 되고, 테스트 시 여러 사람의 스타일을 섞어도 품질이 급락하지 않습니다.
노이즈 입력과 확률적 변동
확률적 변동(stochastic variation) 은 머리카락, 수염, 주근깨, 피부 모공의 정확한 배치처럼 올바른 분포만 따른다면 어떻게 무작위화해도 이미지에 대한 인식이 바뀌지 않는 측면을 말합니다. StyleGAN은 이 변동을 네트워크가 스스로 “발명”하게 두는 대신 노이즈로 직접 공급합니다.
🎲 1. 전통 생성기의 문제 (Section 3.2)
전통 생성기의 유일한 입력은 입력층뿐이므로, 확률적 디테일이 필요할 때마다 네트워크는 이전 활성값으로부터 공간적으로 변하는 의사난수를 생성하는 방법을 스스로 고안해야 합니다. 이는 네트워크 용량을 소모하고, 생성된 신호의 주기성을 숨기기도 어렵습니다. 생성 이미지에서 흔히 보이는 반복 패턴이 그 실패의 증거입니다. StyleGAN은 각 합성곱 뒤에 픽셀별 노이즈를 더함으로써 이 문제를 통째로 우회합니다.
🔍 2. 노이즈가 바꾸는 것과 바꾸지 않는 것 (Figure 4, 5)
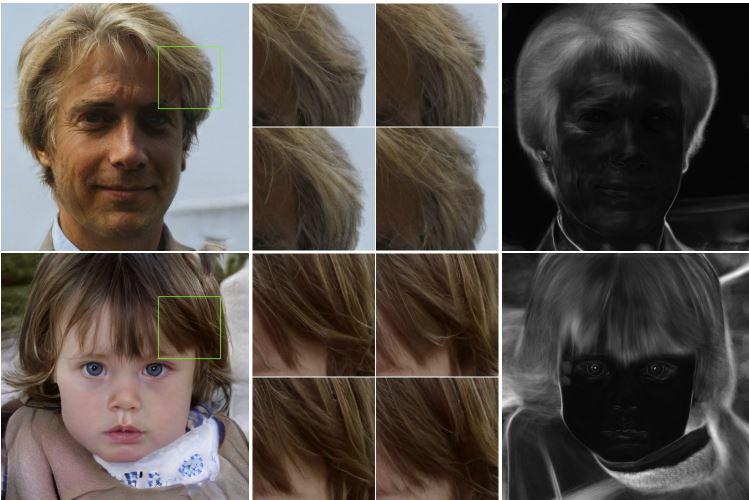
Figure 4는 같은 기본 이미지에 대해 노이즈 실현만 바꾼 결과를 보여줍니다. 머리카락 한 올 한 올의 배치는 크게 달라지지만 전체 인상은 거의 같습니다. 100가지 실현에 대한 픽셀별 표준편차를 보면 노이즈의 영향은 머리카락, 실루엣, 배경에 집중되고 눈의 반사광에서도 흥미로운 변동이 나타나지만, 정체성과 포즈 같은 전역 속성은 영향을 받지 않습니다.
| 노이즈 적용 층 (Figure 5) | 결과 |
|---|---|
| 모든 층 | 자연스러운 디테일 |
| 없음 | 특징 없는 “회화풍(painterly)” 외관 |
| 미세 층만 ($64^2$–$1024^2$) | 머리카락의 더 미세한 컬, 더 세밀한 배경, 피부 모공 |
| 거친 층만 ($4^2$–$32^2$) | 머리카락의 대규모 컬링, 더 큰 배경 특징 |
🧠 3. 노이즈 효과는 왜 국소적인가
저자들은 노이즈의 효과가 네트워크 안에서 긴밀하게 국소화되어 나타난다는 점을 흥미롭게 봅니다. 가설은 이렇습니다. 생성기의 어느 지점에서든 가능한 한 빨리 새로운 콘텐츠를 도입하라는 압력이 있고, 확률적 변동을 만드는 가장 쉬운 방법은 주어진 노이즈에 의존하는 것입니다. 모든 층에 새 노이즈 세트가 제공되므로, 초기 활성값에서 확률적 효과를 만들어 둘 동기가 없고, 결과적으로 각 층의 노이즈는 그 층의 규모(scale)에 맞는 변동만 담당하게 됩니다.
💡 Key Takeaway 노이즈를 명시적으로 주입하면 네트워크는 의사난수를 발명하는 데 용량을 쓰지 않아도 됩니다. 노이즈는 해상도에 맞는 확률적 디테일만 바꾸고, 정체성·포즈 같은 전역 속성은 스타일이 맡습니다.
중간 잠재 공간 $\mathcal{W}$ 와 얽힘 해소
얽힘 해소(disentanglement) 의 정의는 다양하지만 공통 목표는 선형 부분공간들로 이루어진 잠재 공간이며, 각 부분공간이 하나의 변동 요인을 제어하는 것입니다. StyleGAN의 핵심 주장은 입력 잠재 공간 $\mathcal{Z}$ 는 구조적으로 이 목표를 달성할 수 없고, 중간 잠재 공간 $\mathcal{W}$ 는 그 제약에서 자유롭다는 것입니다.

🌀 1. $\mathcal{Z}$ 가 얽힐 수밖에 없는 이유 (Figure 6)
$\mathcal{Z}$ 에서 각 요인 조합의 샘플링 확률은 훈련 데이터의 해당 밀도와 일치해야 합니다. 예컨대 남성성과 머리 길이라는 두 요인이 있고 훈련 데이터에 “긴 머리 남성” 조합이 없다면(Figure 6a), $\mathcal{Z}$ 에서 이미지 특징으로 가는 매핑은 금지된 조합이 사라지도록 휘어져야(curved) 합니다(6b). 이 휘어짐이 곧 얽힘입니다. 반면 $\mathcal{Z}\to\mathcal{W}$ 로 학습된 매핑 $f$ 는 이 휘어짐의 상당 부분을 “되돌릴(unwarp)” 수 있습니다(6c).
🧩 2. 왜 생성기가 $\mathcal{W}$ 를 풀어내도록 학습하는가 (Section 4)
$\mathcal{W}$ 의 샘플링 밀도는 고정된 분포가 아니라 학습된 조각별 연속 매핑 $f(z)$ 에 의해 유도됩니다. 저자들의 가설은 얽힌 표현보다 풀린 표현을 바탕으로 사실적인 이미지를 만드는 것이 더 쉬우므로, 생성기에는 $\mathcal{W}$ 를 풀어내도록 하는 압력이 있다는 것입니다. 따라서 변동 요인을 미리 알 수 없는 비지도 설정에서도 훈련이 덜 얽힌 $\mathcal{W}$ 를 산출할 것으로 기대합니다.
✂️ 3. $\mathcal{W}$ 에서의 절단 기법 (Appendix B, Figure 8)
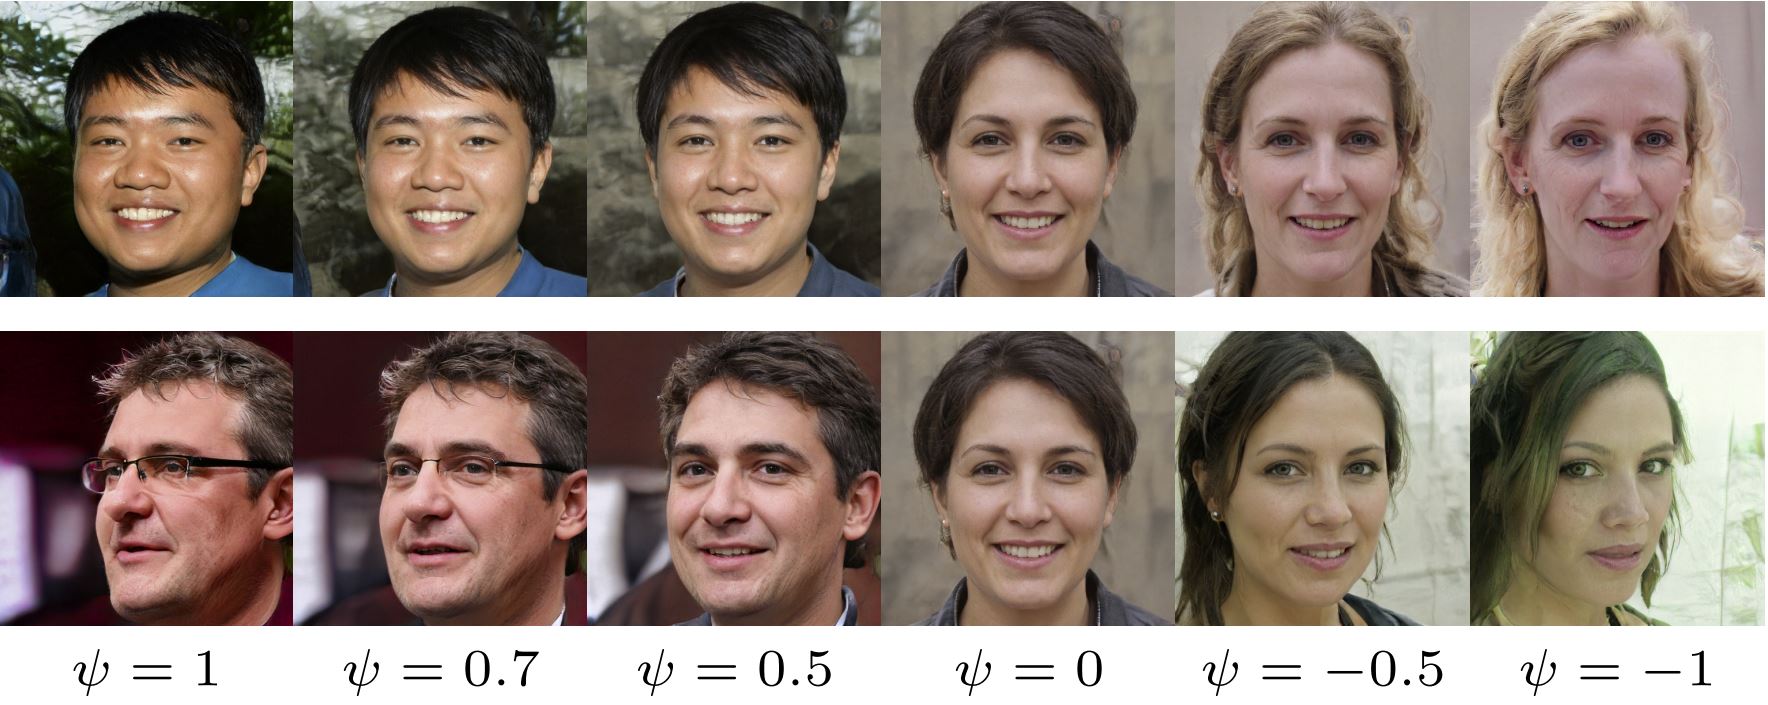
훈련 데이터 분포의 저밀도 영역은 표현이 부족해 생성기가 배우기 어렵습니다. 잘라낸(truncated) 혹은 축소된 샘플링 공간에서 잠재 벡터를 뽑으면 다양성은 일부 잃지만 평균 품질이 올라간다는 것이 알려져 있었고, StyleGAN은 이를 $\mathcal{W}$ 에서 수행합니다. 먼저 질량 중심을 구하고
\[\bar{w} = \mathbb{E}_{z\sim P(z)}[f(z)]\]주어진 $w$ 의 편차를 스케일링합니다.
\[w' = \bar{w} + \psi\,(w - \bar{w}),\qquad \psi<1\]FFHQ에서 $\bar{w}$ 는 일종의 “평균 얼굴”에 해당하며($\psi=0$), $\psi\to0$ 으로 가면 모든 얼굴이 이 평균 얼굴로 수렴합니다. 음수 $\psi$ 를 쓰면 반대 속성의 “안티 페이스”가 나오는데, 시점·안경·나이·색·머리 길이·종종 성별까지 함께 뒤집힙니다. 스타일 기반 생성기는 절단을 저해상도 층에만 선택적으로 적용할 수 있어 고해상도 디테일은 보존됩니다. Figure 2는 $4^2$–$32^2$ 에만 $\psi=0.7$ 을 적용한 예입니다. 논문의 모든 FID는 절단 없이 계산되었습니다. 직교 정규화를 써야 일부 네트워크만 절단을 견딘다는 BigGAN의 관찰과 달리, $\mathcal{W}$ 에서의 절단은 손실 함수를 바꾸지 않아도 안정적으로 작동했습니다.
💡 Key Takeaway $\mathcal{Z}$ 는 훈련 데이터의 밀도를 따라야 하므로 반드시 휘어지지만, $\mathcal{W}$ 는 그럴 의무가 없습니다. 생성기는 더 쉬운 길을 택해 $\mathcal{W}$ 를 펴내고, 그 덕분에 절단 기법 같은 조작도 $\mathcal{W}$ 에서 자연스럽게 작동합니다.
지각 경로 길이(Perceptual Path Length)
지각 경로 길이는 잠재 공간에서 보간할 때 이미지가 얼마나 급격하게 변하는지를 재는 지표입니다. 잠재 벡터 보간이 놀랄 만큼 비선형적인 이미지 변화를 낳을 수 있고, 두 끝점 어디에도 없는 특징이 보간 경로 중간에 나타나는 현상은 잠재 공간이 얽혀 있다는 신호입니다. 덜 휘어진 잠재 공간일수록 지각적으로 더 매끄러운 전이를 만들어야 한다는 직관에서 출발합니다.
📏 1. 정의 (Eq. 2, 3)
지각 거리 $d(\cdot,\cdot)$ 로는 두 VGG16 임베딩의 가중 차이로 계산되는 LPIPS 계열 지표를 쓰며, 가중치는 사람의 지각 유사성 판단과 일치하도록 맞춰져 있습니다. 보간 경로를 선형 구간으로 잘게 나누고 각 구간의 지각 차이를 합한 것이 경로 길이이며, 실제로는 작은 간격 $\epsilon=10^{-4}$ 로 근사합니다. $\mathcal{Z}$ 에서는
\[l_{\mathcal{Z}} = \mathbb{E}\left[\frac{1}{\epsilon^{2}}\, d\Big(G(\mathrm{slerp}(z_1,z_2;t)),\ G(\mathrm{slerp}(z_1,z_2;t+\epsilon))\Big)\right]\]여기서 $z_1,z_2\sim P(z)$, $t\sim U(0,1)$, $G$ 는 생성기(스타일 기반이면 $g\circ f$)입니다. 정규화된 입력 잠재 공간에서는 구면 보간(slerp)이 가장 적절하므로 slerp를 씁니다. $\mathcal{W}$ 에서는
\[l_{\mathcal{W}} = \mathbb{E}\left[\frac{1}{\epsilon^{2}}\, d\Big(g(\mathrm{lerp}(f(z_1),f(z_2);t)),\ g(\mathrm{lerp}(f(z_1),f(z_2);t+\epsilon))\Big)\right]\]$\mathcal{W}$ 의 벡터는 어떤 방식으로도 정규화되지 않으므로 선형 보간(lerp)을 씁니다. $d$ 가 2차 지표이므로 $\epsilon^{2}$ 로 나누고, 배경 대신 얼굴에 집중하기 위해 이미지를 얼굴만 포함하도록 자른 뒤 측정하며, 기댓값은 100,000개 샘플로 계산합니다.
📐 2. “full”과 “end” 측정의 차이 (Table 3)
| 방법 | 공간 | 경로 길이 (full) | 경로 길이 (end) | 분리성 |
|---|---|---|---|---|
| B 전통 생성기 | $\mathcal{Z}$ | 412.0 | 415.3 | 10.78 |
| D 스타일 기반 생성기 | $\mathcal{W}$ | 446.2 | 376.6 | 3.61 |
| E + 노이즈 입력 | $\mathcal{W}$ | 200.5 | 160.6 | 3.54 |
| + 혼합 50% | $\mathcal{W}$ | 231.5 | 182.1 | 3.51 |
| F + 혼합 90% | $\mathcal{W}$ | 234.0 | 195.9 | 3.79 |
노이즈 입력이 있는 스타일 기반 생성기에서 전체 경로 길이가 상당히 짧아, $\mathcal{W}$ 가 $\mathcal{Z}$ 보다 지각적으로 더 선형적임을 시사합니다. 다만 이 측정은 $\mathcal{Z}$ 에 다소 유리하게 편향되어 있습니다. $\mathcal{W}$ 가 정말로 $\mathcal{Z}$ 를 풀어 “펴놓은” 매핑이라면, 입력 다양체에서 매핑된 점들 사이에 입력 다양체 위에 없는 영역이 포함될 수 있고 생성기가 그 영역을 잘못 재구성할 수 있습니다. 반면 $\mathcal{Z}$ 는 정의상 그런 영역이 없습니다. 그래서 측정을 경로의 끝점($t\in{0,1}$)으로 제한하면 $l_{\mathcal{Z}}$ 는 변하지 않지만 $l_{\mathcal{W}}$ 는 더 작아져야 하며, Table 3이 실제로 그 결과를 보여줍니다.
🔗 3. 매핑 네트워크 깊이의 효과 (Table 4)
| 방법 | 깊이 | 공간 | FID | 경로 길이 (full) | 경로 길이 (end) | 분리성 |
|---|---|---|---|---|---|---|
| 전통 | 0 | $\mathcal{Z}$ | 5.25 | 412.0 | 415.3 | 10.78 |
| 전통 | 8 | $\mathcal{Z}$ | 4.87 | 896.2 | 902.0 | 170.29 |
| 전통 | 8 | $\mathcal{W}$ | 4.87 | 324.5 | 212.2 | 6.52 |
| 스타일 기반 | 0 | $\mathcal{Z}$ | 5.06 | 283.5 | 285.5 | 9.88 |
| 스타일 기반 | 1 | $\mathcal{W}$ | 4.60 | 219.9 | 209.4 | 6.81 |
| 스타일 기반 | 2 | $\mathcal{W}$ | 4.43 | 217.8 | 199.9 | 6.25 |
| 스타일 기반 | 8 | $\mathcal{W}$ | 4.40 | 234.0 | 195.9 | 3.79 |
전통 생성기와 스타일 기반 생성기 모두 매핑 네트워크를 두면 이득을 보고, 깊이가 깊을수록 FID와 경로 길이가 대체로 좋아집니다. 특히 전통 생성기에 8층 매핑 네트워크를 붙이면 $l_{\mathcal{W}}$ 는 개선되지만 $l_{\mathcal{Z}}$ 는 896.2로 크게 악화됩니다. 이는 입력 잠재 공간이 GAN 안에서 임의로 얽힐 수 있다는 주장의 직접적 증거입니다.
💡 Key Takeaway 지각 경로 길이는 인코더 없이 “보간이 얼마나 매끄러운가”만으로 얽힘을 잽니다. $\mathcal{W}$ 는 $\mathcal{Z}$ 보다 짧은 경로를 가지며, 매핑 네트워크가 깊을수록 더 짧아집니다.
선형 분리성(Linear Separability)
선형 분리성은 잠재 공간이 충분히 풀려 있다면 개별 변동 요인에 일관되게 대응하는 방향 벡터가 존재해야 한다는 생각을 정량화한 지표입니다. 잠재 공간의 점들이 선형 초평면으로 두 집합으로 얼마나 잘 나뉘는지를 잽니다.
🏷️ 1. 측정 절차 (Section 4.2)
- 보조 분류기 훈련 — 판별기와 같은 아키텍처의 분류 네트워크를 CelebA-HQ의 40개 이진 속성(원래 CelebA의 속성을 유지)에 대해 훈련합니다.
- 이미지 생성과 라벨링 — $z\sim P(z)$ 로 200,000장을 생성해 보조 분류기로 분류합니다.
- 신뢰도 필터링 — 분류기 신뢰도로 정렬해 신뢰도가 낮은 절반을 버리고 100,000개의 라벨된 잠재 벡터를 남깁니다.
- 선형 SVM 적합 — 속성마다 잠재 공간의 점(전통은 $z$, 스타일 기반은 $w$)으로 라벨을 예측하는 선형 SVM을 학습합니다.
- 조건부 엔트로피 계산 — $X$ 를 SVM이 예측한 클래스, $Y$ 를 사전훈련된 분류기가 정한 클래스로 두고 $H(Y\vert X)$ 를 계산합니다. 초평면의 어느 쪽에 있는지 알 때 진짜 클래스를 결정하는 데 얼마나 더 많은 정보가 필요한지를 뜻하며, 낮을수록 해당 요인에 대한 잠재 방향이 일관됩니다.
🧮 2. 최종 점수
\[\text{Separability} = \exp\Big(\sum_{i} H(Y_i \vert X_i)\Big)\]$i$ 는 40개 속성을 열거합니다. Inception score와 마찬가지로 지수화는 값을 로그 영역에서 선형 영역으로 가져와 비교를 쉽게 합니다. 낮을수록 좋습니다.
📊 3. 결과 해석 (Table 3, 4)
- $\mathcal{W}$ 는 $\mathcal{Z}$ 보다 일관되게 분리성이 좋아 덜 얽힌 표현임을 시사합니다(전통 10.78 대 스타일 기반 F 3.79).
- 매핑 네트워크 깊이를 늘리면 $\mathcal{W}$ 의 이미지 품질과 분리성이 함께 좋아집니다. 이는 합성 네트워크가 본질적으로 풀린 입력 표현을 선호한다는 가설과 일치합니다.
- 전통 생성기 앞에 매핑 네트워크를 붙이면 $\mathcal{Z}$ 의 분리성은 170.29로 심각하게 나빠지지만, 중간 공간 $\mathcal{W}$ 의 분리성(6.52)과 FID(4.87)는 좋아집니다. 전통 아키텍처조차 훈련 분포를 따를 의무가 없는 중간 잠재 공간을 도입하면 더 잘 동작한다는 뜻입니다.
💡 Key Takeaway 선형 SVM 하나로 속성을 나눌 수 있는가가 얽힘의 척도입니다. 매핑 네트워크는 어떤 생성기에 붙여도 $\mathcal{W}$ 를 더 선형적으로 만들고, 그 대가로 $\mathcal{Z}$ 는 더 얽혀도 상관없습니다.
FFHQ 데이터셋과 훈련 설정
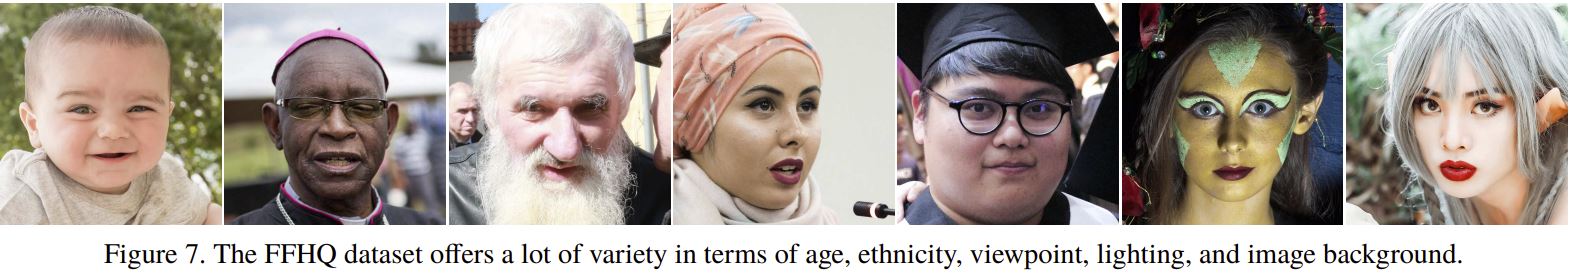
FFHQ(Flickr-Faces-HQ) 는 이 논문과 함께 공개된 고해상도 얼굴 데이터셋으로, 이후 얼굴 생성 연구의 표준 벤치마크가 되었습니다.
🗂️ 1. 데이터셋 구성 (Appendix A)
| 항목 | 내용 |
|---|---|
| 규모·해상도 | $1024^2$ 해상도 70,000장 |
| 출처 | Flickr에서 크롤링(따라서 해당 사이트의 편향을 그대로 상속), 허용 라이선스 이미지만 수집 |
| 전처리 | 자동 정렬·크롭 |
| 필터링 | 다양한 자동 필터로 가지치기 후 Mechanical Turk로 조각상·그림·사진의 사진 제거 |
| CelebA-HQ 대비 | 나이, 민족, 배경의 변동이 훨씬 크고 안경·선글라스·모자 등 액세서리 커버리지가 좋음 |
| 공개 | github.com/NVlabs/ffhq-dataset |
⚙️ 2. 훈련 설정
- 베이스라인(A)은 Progressive GAN의 네트워크와 하이퍼파라미터를 그대로 상속합니다. 구성 B부터 bilinear up/down 샘플링, 더 긴 훈련, 튜닝된 하이퍼파라미터를 적용합니다.
- FFHQ에서 $R_1$ 정규화를 쓰면서 판별기에 보여주는 이미지 수를 12M에서 25M으로 늘렸습니다.
- 훈련 시간은 8개의 Tesla V100 GPU를 장착한 NVIDIA DGX-1에서 약 1주일입니다.
- 모든 이미지는 $1024^2$ 해상도로 생성됩니다.
🔭 3. 병행 연구와의 관계 (Section 2.2)
판별기 쪽 연구(다중 판별기, 다중 해상도 판별, self-attention)와 달리 생성기 쪽 연구는 입력 잠재 분포를 다듬는 데 집중되어 있었습니다. 조건부 생성기들은 클래스 식별자를 별도 임베딩으로 여러 층에 공급하지만 잠재 코드는 여전히 입력층으로 들어갑니다. 같은 시기 Chen 등의 병행 연구도 AdaIN으로 생성기를 “자기 변조(self-modulate)”하지만, 중간 잠재 공간이나 노이즈 입력은 고려하지 않았습니다. 저자들은 자신들의 결과와 이 병행 연구를 근거로 전통적인 GAN 생성기 아키텍처가 스타일 기반 설계보다 모든 면에서 열등하다는 점이 분명해지고 있다고 결론짓습니다.
💡 Key Takeaway FFHQ는 CelebA-HQ보다 훨씬 다양한 고해상도 얼굴 데이터셋이며, 이 논문의 모든 핵심 수치는 FFHQ에서 손실·판별기를 고정한 채 아키텍처만 바꿔 얻은 것입니다.
한계와 열린 방향
StyleGAN 은 생성기 설계의 패러다임을 바꿨지만, 논문 자체와 이후 연구에서 드러난 한계도 분명합니다.
⚠️ 1. 논문이 스스로 밝힌 제약
- 지표의 편향 — 지각 경로 길이의 full 측정은 $\mathcal{Z}$ 에 유리하게 편향되어 있어 end 측정을 함께 보아야 합니다. 선형 분리성은 CelebA의 40개 속성과 보조 분류기의 품질에 의존하므로 얼굴 도메인 밖으로 바로 옮기기 어렵습니다.
- 분포 저밀도 영역 — 절단 기법은 다양성을 희생해 품질을 얻는 임시방편이며, 저밀도 영역을 잘 배우는 것은 모든 생성 모델의 미해결 문제라고 저자들도 인정합니다.
- 데이터 편향 — FFHQ는 Flickr의 편향을 그대로 상속합니다.
🔮 2. 저자들이 제안한 후속 방향 (Section 5)
평균 경로 길이 지표는 훈련 중 정규화 항으로 쉽게 쓸 수 있고, 선형 분리성의 변형도 마찬가지입니다. 일반적으로 훈련 중에 중간 잠재 공간을 직접 성형(shaping)하는 방법이 흥미로운 후속 연구가 될 것이라고 전망합니다. 이 전망은 그대로 실현되어, 후속 논문 StyleGAN2(Analyzing and Improving the Image Quality of StyleGAN)는 경로 길이 정규화(path length regularization) 를 도입했습니다.
🧪 3. 후속 연구에서 드러난 문제
- 물방울 아티팩트(droplet artifacts) — StyleGAN2는 AdaIN의 인스턴스 정규화가 특징 맵의 상대적 크기 정보를 파괴해 생성기가 신호 강도를 몰래 전달하려고 국소적 스파이크를 만든다는 점을 밝히고, AdaIN을 가중치 변조·복조(weight demodulation)로 대체했습니다.
- 위상 아티팩트(phase artifacts) — Progressive growing에서 상속한 점진적 성장 방식이 치아·눈 같은 디테일을 특정 위치에 고착시키는 문제가 있어, StyleGAN2는 점진적 성장 없이 skip/residual 구조로 이를 해결했습니다.
- GAN 역변환(inversion) — $\mathcal{W}$ 가 풀려 있다는 성질은 실제 이미지를 잠재 공간에 투영해 편집하는 연구(각 층마다 다른 $w$ 를 허용하는 $\mathcal{W}^{+}$ 공간 등)의 출발점이 되었습니다.
💡 Key Takeaway StyleGAN은 “생성기 아키텍처만으로 품질·제어성·얽힘 해소를 동시에 얻을 수 있다”는 것을 보였지만, AdaIN의 정보 파괴와 점진적 성장의 부작용은 남겨두었습니다. 이 빈틈이 StyleGAN2의 출발점이 됩니다.