 You know maize mean?
A Large-Scale Study on Regularization and Normalization in GANs
0. Summary
기본 정보 : ArXiv,2018.07.12 (ICML 2019), A Large-Scale Study on Regularization and Normalization in GANs
연구 배경
GAN(Generative Adversarial Networks)은 비지도 방식으로 목표 분포를 학습하는 강력한 생성 모델이지만, 학습이 악명 높게 불안정하다. 손실 함수, 신경망 구조, 정규화(regularization)와 정규화(normalization) 기법, 그리고 수많은 하이퍼파라미터에 민감하기 때문에 새로운 데이터셋에 적용하려면 상당한 양의 “꼼수(tricks)”와 튜닝이 필요하다. 문제는 이 어려움을 해결하겠다며 제안된 손실·정규화·구조가 너무 많아졌다는 점이다. 각 논문은 자신의 설정에서만 비교를 수행하고, FID 계산 방식·데이터 전처리·구조 세부사항이 논문마다 달라 공정하게 무엇이 실제로 효과가 있는지 판단하기 어려운 상태였다. 선행 연구인 Lucic et al. (2018)의 “Are GANs Created Equal?”은 단일 구조와 저해상도 데이터셋(MNIST, CIFAR10, CelebA)에서 손실 함수 간에 통계적으로 유의한 차이가 없음을 보였지만, 고용량 구조·고해상도 데이터·정규화 기법까지 포괄하는 체계적 연구는 비어 있었다.
제안 방법
저자들은 먼저 GAN 지형(GAN landscape) 을 정의한다. 손실 함수(non-saturating, least-squares, Wasserstein), 정규화 기법(gradient penalty, DRAGAN penalty, $L^2$ 정규화), 정규화 기법(batch norm, layer norm, spectral norm), 그리고 두 가지 대표 구조(SNDCGAN, ResNet19)가 그 축이다. 전체 조합을 다 탐색하는 것은 불가능하므로 한 번에 한 축만 바꾸는 슬라이스(slice) 실험을 설계했다. Section 3.1은 정규화만, 3.2는 손실만, 3.3은 구조만 바꾼다. 하이퍼파라미터는 문헌의 “좋은” 설정 24개(Table 1의 데카르트 곱)와 순차 베이지안 최적화(sequential Bayesian optimization) 로 찾은 설정 240개(Table 2 범위, 12라운드 × 10개 × $n_{dis}\in{1,5}$)를 함께 사용했고, 초기 가중치 민감성을 고려해 각 설정을 5개 시드로 학습한 뒤 중앙값 FID 를 보고한다. 데이터셋은 CIFAR10, CelebA-HQ-128, LSUN-BEDROOM이며, 평가는 FID를 주 지표로 하고 KID와의 상관을 별도로 확인한다. 평가 방식 자체도 두 가지로 설계했는데, 하나는 상위 5% 모델의 FID 분포(중앙값과 분산), 다른 하나는 “하이퍼파라미터 설정을 $k$ 개만 시도할 수 있을 때 도달 가능한 최소 FID”라는 계산 예산 관점의 지표다.
발견 사실
가장 일관된 발견은 spectral normalization(SN)이 데이터셋·손실·구조를 가리지 않고 샘플 품질을 개선하며, 계산 효율도 가장 좋다는 것이다(Figure 1–3). Gradient penalty(GP)도 도움이 되지만 학습을 안정화시키지는 못하고, 정규화 강도 $\lambda$ 와 손실 사이의 균형을 맞추는 데 추가 예산이 필요하다. 예컨대 LSUN-BEDROOM에서 FID 100 이하를 얻으려면 GP는 최소 6개 설정을 시도해야 하지만 SN은 2개 설정으로 더 낮은 FID에 도달한다(Figure 1). 판별자(discriminator)에 batch norm을 넣으면 오히려 성능이 나빠진다. GP를 쓰는 모델은 판별자:생성자 갱신 비율 5:1에서 이득을 보고, 10만 스텝을 추가로 학습하면 더 좋아질 가능성이 있다. 손실 함수를 바꿔도(NS, LS, WGAN) 이 결론은 유지되며, SNDCGAN과 ResNet19 두 구조 모두 비슷한 수준의 결과를 내고 둘 다 정규화에서 이득을 본다. SN과 GP, 혹은 LN과 GP를 동시에 적용하면 추가 개선이 있지만, 꽤 큰 계산 비용 대비 FID 이득은 제한적이다(Figure 4). 부록의 중앙값 FID 표에서는 SNDCGAN이 LSUN-BEDROOM에서 SN 유무에 따라 FID 63.46 대 180.36으로 극적인 차이를 보였다. 아울러 FID 계산 방식 차이만으로 보고 수치가 10% 이상 어긋날 수 있다는 재현성 문제를 지적했다.
핵심 기여
- GAN 지형의 체계적 분해 실험 : 손실·정규화·구조라는 세 축을 분리한 슬라이스 실험과 베이지안 최적화 기반 탐색으로, 수백 개의 하이퍼파라미터 설정과 5개 시드에 걸쳐 공정한 비교를 수행했다. 상위 5% FID 분포와 계산 예산 대비 최소 FID라는 두 관점을 제시해 “성능”과 “튜닝 난이도”를 함께 측정했다.
- 실무 권고안 도출 : 예산이 제한적이면 non-saturating 손실 + spectral normalization을 기본값으로 쓰고, 예산이 더 있으면 gradient penalty를 추가하고 수렴할 때까지 학습하라는 구체적이고 재현 가능한 지침을 제시했다.
- 재현성 함정의 명시와 공개 기준 구현 : FID 계산 방식(학습/테스트 데이터, 샘플 수)의 불일치, ResNet 블록 설계 세부사항 누락, 데이터셋 전처리 차이, GPU 비결정성 같은 함정을 정리하고, 학습·평가 코드(
compare_gan)와 TensorFlow Hub 사전학습 모델을 공개해 후속 연구의 기준선을 제공했다.
관련 개념
GAN 지형(GAN Landscape): 비교 대상 손실 함수
GAN 지형은 이 논문이 비교 대상으로 삼는 설계 선택지 전체를 가리킵니다. 그 첫 번째 축이 손실 함수입니다. 목표 분포를 $P$, 모델 분포를 $Q$ 라 할 때, 각 손실은 판별자 $D$ 가 어떤 통계량을 추정하고 생성자 $G$ 가 어떤 발산(divergence)을 줄이는지를 결정합니다. 논문은 세 가지를 비교합니다(Section 2.1).
🎯 1. Non-Saturating(NS) 손실
Goodfellow et al. (2014)은 minimax GAN과 non-saturating GAN 두 가지를 제안했습니다. 전자는 생성자가 $\log(1-D(\hat{x}))$ 를 최소화하고, 후자는 생성자가 생성 샘플이 진짜로 분류될 확률을 직접 최대화합니다. 경험적으로 NS가 우수하다는 것이 알려져 있어 논문은 NS만 다룹니다.
\[L_D=-\mathbb{E}_{x\sim P}[\log D(x)]-\mathbb{E}_{\hat{x}\sim Q}[\log(1-D(\hat{x}))]\] \[L_G=-\mathbb{E}_{\hat{x}\sim Q}[\log D(\hat{x})]\]여기서 $D(x)$ 는 $x$ 가 $P$ 에서 나왔을 확률입니다. 판별자는 이진 분류의 음의 로그우도를 최소화하고, 최적 판별자 아래에서 생성자는 Jensen–Shannon 발산 계열의 양을 줄이게 됩니다.
📏 2. Wasserstein(WGAN) 손실
Arjovsky et al. (2017)은 JS 발산 대신 Wasserstein 거리를 쓰자고 제안했습니다. 판별자(critic)의 출력은 확률이 아니라 실수 $D(x)\in\mathbb{R}$ 입니다.
\[L_D=-\mathbb{E}_{x\sim P}[D(x)]+\mathbb{E}_{\hat{x}\sim Q}[D(\hat{x})]\] \[L_G=-\mathbb{E}_{\hat{x}\sim Q}[D(\hat{x})]\]최적 판별자 아래에서 이 손실을 생성자에 대해 최소화하면 $P$ 와 $Q$ 사이의 Wasserstein 거리를 최소화하는 것이 됩니다. 단, $D$ 가 1-Lipschitz 여야 한다는 제약이 붙으며, 이 제약을 어떻게 강제할 것인가가 다음 절의 정규화 기법과 직결됩니다.
📐 3. Least-Squares(LS) 손실
Mao et al. (2017)의 LSGAN은 교차 엔트로피 대신 제곱 오차를 사용하며, 이는 $P$ 와 $Q$ 사이의 Pearson $\chi^2$ 발산을 최소화하는 것에 대응합니다.
\[L_D=\mathbb{E}_{x\sim P}[(D(x)-1)^2]+\mathbb{E}_{\hat{x}\sim Q}[D(\hat{x})^2]\] \[L_G=\mathbb{E}_{\hat{x}\sim Q}[(D(\hat{x})-1)^2]\]직관적으로 이 매끄러운 손실은 교차 엔트로피보다 포화(saturate)가 느려서 결정 경계에서 멀리 떨어진 샘플에도 기울기를 공급합니다. 논문은 이 외에 최근 널리 쓰이는 hinge 손실도 부록에서 다루며, CIFAR10에서는 NS와 비슷한 성능을 보였다고 적었습니다.
| 손실 | 판별자 출력 | 대응 발산 | 추가 제약 |
|---|---|---|---|
| NS | 확률 $[0,1]$ | JS 계열 | 없음 |
| WGAN | 실수 $\mathbb{R}$ | Wasserstein-1 | $D$ 가 1-Lipschitz |
| LS | 실수 $\mathbb{R}$ | Pearson $\chi^2$ | 없음 |
💡 Key Takeaway 세 손실은 “판별자가 무엇을 추정하는가”에서 갈립니다. 하지만 이 논문의 결론은, 정규화를 적절히 걸면 손실 선택은 생각보다 덜 중요하고 NS가 충분히 안정적이라는 것입니다.
판별자 정규화(Regularization)와 정규화(Normalization)
이 논문에서 regularization은 손실에 벌점 항을 더해 판별자의 복잡도나 기울기를 제한하는 것, normalization은 활성값이나 가중치 자체를 정규화하는 것을 뜻합니다. 둘 다 궁극적으로는 판별자의 Lipschitz 상수를 통제하거나 최적화를 안정시키려는 목적을 공유합니다(Section 2.2).
🧲 1. 기울기 노름 벌점(Gradient Norm Penalty)
GP (Gulrajani et al., 2017) 는 판별자 기울기의 $L^2$ 노름을 제약합니다. Wasserstein GAN과 최적 수송(optimal transport)의 맥락에서는 $P$ 와 $Q$ 사이 최적 결합(optimal coupling)에 놓인 점들에서 기울기 노름이 1이어야 한다는 조건이 자연스럽게 나오지만, 학습 중 이 결합을 계산하는 것은 비싸므로 실제 샘플과 생성 샘플 사이의 선형 보간점에서 벌점을 평가합니다.
DRAGAN (Kodali et al., 2017) 은 데이터 다양체(manifold) 근처에서 기울기 노름을 벌점으로 걸어 판별자가 그 영역에서 조각별 선형(piece-wise linear)이 되도록 유도합니다.
| 기법 | 벌점 위치 | 한계 |
|---|---|---|
| GP | 실제–생성 샘플의 선형 보간점 | 학습 중 변하는 모델 분포 $Q$ 에 의존 |
| DRAGAN | 실제 데이터 주변(가우시안 섭동) | 다양체에 대한 가우시안 가정의 타당성 불명확 |
| $L^2$ | 가중치 자체 | 고전적 복잡도 제어, GAN 특화 아님 |
두 경우 모두 벌점 강도 $\lambda$ 가 추가 하이퍼파라미터로 들어옵니다. 저자들은 Fedus et al. (2018)의 관점을 따라, 기울기 벌점을 특정 손실에 대한 이론적 귀결이 아니라 판별자 복잡도에 대한 고전적 정규화자로도 볼 수 있다고 보고, 지도학습에서 흔한 $L^2$ 정규화도 비교군에 넣었습니다.
📊 2. 활성값 정규화: Batch Norm과 Layer Norm
최적화 관점에서 batch normalization(BN) 은 배치 축으로, layer normalization(LN) 은 특징 축으로 활성값을 정규화합니다. BN은 Denton et al. (2015)에서 탐색되고 DCGAN(Radford et al., 2016)으로 대중화되었으며, LN은 WGAN-GP(Gulrajani et al., 2017)에서 판별자에 적용되었습니다. 두 기법 모두 더 효율적인 기울기 흐름과 안정적인 최적화를 노리지만, 뒤에서 보듯 판별자에 BN을 넣는 것은 이 연구에서 해로운 것으로 나타났습니다.
🌀 3. 가중치 정규화: Spectral Normalization
표현 관점에서는 신경망을 (비선형) 사상들의 합성으로 보고 각 사상의 스펙트럼 성질을 분석할 수 있습니다. 판별자가 유계 연산자(bounded operator)가 되려면 각 층의 연산자 노름(operator norm)을 통제하면 충분합니다. Miyato et al. (2018)의 spectral normalization(SN) 은 각 가중치 행렬 $W$ 를 자신의 스펙트럼 노름(최대 특이값)으로 나눕니다.
\[\bar{W}=\frac{W}{\sigma(W)},\qquad \sigma(W)=\max_{\|h\|_2\le 1}\|Wh\|_2\]합성곱 커널도 2차원 행렬로 재배열해 같은 방식으로 정규화합니다. 추가 하이퍼파라미터가 없고 거듭제곱법(power iteration) 한 번으로 근사할 수 있어 계산이 저렴합니다. 다만 Figure 4의 설명에서 저자들이 지적하듯, 합성곱 층을 이렇게 정규화하는 방식은 판별자가 정확히 1-Lipschitz임을 보장하지는 않습니다. 이 사실이 SN과 GP를 동시에 쓸 때 추가 이득이 나오는 이유를 부분적으로 설명합니다.
💡 Key Takeaway GP는 “어디서” 기울기를 제약할지와 $\lambda$ 를 골라야 하는 반면, SN은 하이퍼파라미터 없이 가중치 수준에서 Lipschitz 상수를 눌러 줍니다. 이 차이가 곧 실험에서 계산 효율의 차이로 나타납니다.
비교 구조와 평가 지표
구조(architecture) 와 지표(metric) 는 실험의 “고정 축”이지만, 결과 해석에 결정적입니다. 논문은 GAN 연구에서 가장 흔한 두 계열의 구조를 쓰고, FID를 주 지표로 삼습니다(Section 2.3–2.4).
🏗️ 1. SNDCGAN과 ResNet19
| 구조 | 출처 | 특징 |
|---|---|---|
| SNDCGAN | Miyato et al. (2018)의 DCGAN 변형 | 판별자가 8층 합성곱, 그 외 DCGAN과 유사 (Table 4) |
| ResNet19 | Miyato et al. (2018)의 ResNet 설정을 단순화 | 생성자 5개 ResNet 블록, 판별자 6개 ResNet 블록, $128\times128$ 입력 (Table 5a, 5b) |
| ResNet CIFAR | CIFAR10용 $32\times32$ 변형 | 재현성 확인용 |
저자들은 이 설정으로 Miyato et al. (2018)의 결과를 재현할 수 있었다고 밝히며, ResNet 블록의 세부 변형(층 순서, ReLU 위치, 업/다운샘플링 시점, 필터 수)에 대한 절제 연구를 부록에 실었습니다. 결론은 대부분의 변형이 미미한 차이만 만든다는 것입니다.
📈 2. Inception Score와 FID
Inception Score(IS) 는 Salimans et al. (2016)이 제안한 지표로, 의미 있는 객체를 담은 샘플은 조건부 레이블 분포 $p(y\vert x)$ 의 엔트로피가 낮아야 하고 샘플 전체의 다양성은 높아야 한다는 직관을 수식화합니다.
\[IS=\exp\Big(\mathbb{E}_{x\sim Q}\big[d_{KL}(p(y\vert x)\,\|\,p(y))\big]\Big)\]하지만 레이블 사전분포에 둔감하고 적절한 거리(proper distance)가 아니라는 단점이 있습니다. Fréchet Inception Distance(FID) (Heusel et al., 2017)는 $P$ 와 $Q$ 의 샘플을 Inception 네트워크의 특정 층에 임베딩하고, 임베딩이 다변량 가우시안을 따른다고 가정해 두 가우시안 사이의 Fréchet 거리를 계산합니다.
\[FID=\|\mu_x-\mu_y\|_2^2+\mathrm{Tr}\Big(\Sigma_x+\Sigma_y-2(\Sigma_x\Sigma_y)^{\frac12}\Big)\]여기서 $(\mu_x,\Sigma_x)$, $(\mu_y,\Sigma_y)$ 는 각각 $P$, $Q$ 임베딩의 평균과 공분산입니다. FID는 인간 판단과 일관되고 잡음에 더 강건하며, 생성 샘플에 노이즈나 아티팩트가 끼면 즉시 나빠집니다. 무엇보다 IS와 달리 클래스 내 모드 붕괴(intra-class mode dropping) 를 탐지할 수 있습니다. 클래스당 한 장씩만 만드는 모델은 IS가 좋아도 FID는 나쁩니다.
🔁 3. KID와 FID의 상관
Binkowski et al. (2018)은 FID에 불편 추정량(unbiased estimator)이 없다고 지적하며 Kernel Inception Distance(KID) 를 대안으로 제안했습니다. 저자들은 부록 B에서 두 지표를 비교했는데, Spearman 순위 상관계수가 LSUN-BEDROOM에서 0.994, CelebA-HQ-128에서 0.995로 거의 같은 순위를 만들었습니다. 그래서 본문에서는 FID에만 집중합니다.
💡 Key Takeaway FID는 품질과 다양성을 함께 보는 실용적 지표이고 KID와 순위가 거의 일치합니다. 다만 뒤에서 보듯 FID를 “어떻게” 계산하느냐가 비교 가능성을 좌우합니다.
실험 설계: 데이터셋, 하이퍼파라미터 탐색, 두 가지 평가 관점
이 논문의 설득력은 결론 자체보다 설계의 공정성에서 나옵니다. 데이터셋 분할, 하이퍼파라미터 탐색, 시드 처리, 평가 관점이 모두 생존 편향(survivorship bias)을 줄이도록 짜여 있습니다(Section 2.5–2.6, Section 3 도입부).
🗂️ 1. 세 데이터셋과 기준 FID
| 데이터셋 | 규모 | 해상도 | 테스트 분할 | 기준 FID |
|---|---|---|---|---|
| CIFAR10 | 70K | $32\times32\times3$ | 60K 학습 / 10K 테스트 | 5.19 |
| CelebA-HQ-128 | 30K | $128\times128\times3$ | 3K 테스트 | 12.6 |
| LSUN-BEDROOM | 300만 장 이상 | $128\times128\times3$ (crop or pad) | 30,588장 테스트 | 3.8 |
CelebA-HQ는 ProGAN 저자(Karras et al., 2018)의 코드로 만든 128 해상도 버전을 사용했습니다. 기준 FID 는 실제 데이터끼리(학습 대 테스트) 계산한 값으로, 모델이 도달할 수 있는 하한선의 감각을 줍니다.
🔍 2. 하이퍼파라미터: 문헌의 “좋은 값” + 순차 베이지안 최적화
Lucic et al. (2018)이 지적했듯, 커뮤니티는 일부 데이터셋에서만 통하는 소수의 하이퍼파라미터 값에 수렴해 있고 이것이 진전을 막는 큰 요인입니다. 저자들은 두 단계로 탐색했습니다.
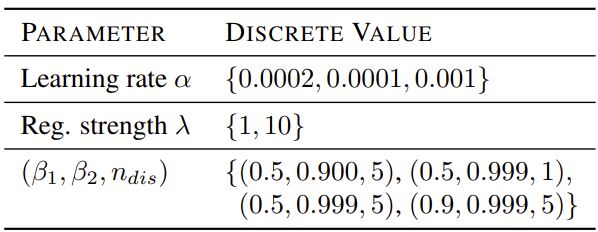
(1) 사전 정의 설정 (Table 1) : Fedus et al. (2018), Miyato et al. (2018), Gulrajani et al. (2017)이 보고한 “좋은” 값들의 데카르트 곱으로 24개 설정을 만듭니다.
| 파라미터 | 값 |
|---|---|
| 학습률 $\alpha$ | ${0.0002,\ 0.0001,\ 0.001}$ |
| 벌점 강도 $\lambda$ | ${1,\ 10}$ |
| $(\beta_1,\beta_2,n_{dis})$ | $(0.5,0.900,5),\ (0.5,0.999,1),\ (0.5,0.999,5),\ (0.9,0.999,5)$ |
| 배치 크기 | 64 (모든 실험) |
| 판별자 갱신 스텝 | LSUN-BEDROOM·CelebA-HQ-128 100K, CIFAR10 200K |
| 최적화기 | Adam |
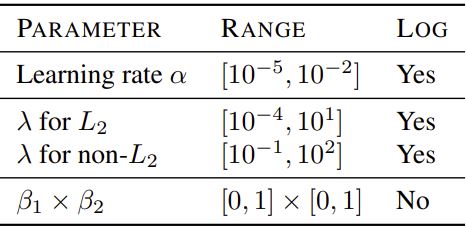
(2) 순차 베이지안 최적화 (Table 2) : Srinivas et al. (2010)의 방식으로, 이전 라운드의 FID를 바탕으로 탐색(exploration)과 활용(exploitation)을 균형 잡으며 다음 설정 묶음을 고릅니다. 12라운드 × 10개 = 120개 설정을 탐색하고, $n_{dis}\in{1,5}$ 를 함께 탐색해 총 240개의 추가 설정을 얻었습니다. 탐색 범위는 학습률 $[10^{-5},10^{-2}]$(로그 스케일), $L^2$ 의 $\lambda\in[10^{-4},10^{1}]$, 그 외 벌점의 $\lambda\in[10^{-1},10^{2}]$, $\beta_1\times\beta_2\in[0,1]\times[0,1]$ 입니다. 이렇게 찾은 설정 중 일부는 알려진 값보다 더 좋았습니다.
🎲 3. 시드와 중앙값
GAN 학습은 초기 가중치에 민감하므로, 사전 정의 설정의 모델은 서로 다른 난수 초기화로 5번 학습해 중앙값 FID 를 보고합니다. 베이지안 최적화로 얻은 모델의 분산은 탐색–활용 전략 안에서 암묵적으로 처리됩니다.
⚖️ 4. 두 가지 평가 관점
| 관점 | 측정 방법 | 읽는 법 |
|---|---|---|
| 상위 5% FID 분포 | 사전 정의 + 베이지안 설정으로 학습한 모델 중 상위 5%의 FID 분포 | 중앙값이 낮을수록 좋은 모델, 분산이 작을수록 최적화 관점에서 안정적 |
| 예산 대비 최소 FID | 설정을 $k$ 개만 시도할 수 있는 실무자를 시뮬레이션. 예산 일부를 문헌의 좋은 설정에 쓰고 나머지로 베이지안 탐색. 무작위 과정이므로 1,000회 반복 후 최소 FID의 평균 | 같은 예산에서 더 낮은 FID에 도달하는 기법이 실용적으로 우월 |
두 번째 관점이 이 논문의 독창적인 부분입니다. “최고 성능”뿐 아니라 “그 성능에 도달하기까지 얼마나 많은 시도가 필요한가” 를 수치화하기 때문에, 하이퍼파라미터가 하나 더 붙는 GP와 그렇지 않은 SN의 차이가 드러납니다.
💡 Key Takeaway 한 축씩만 바꾸는 슬라이스 설계, 문헌값 + 베이지안 탐색, 5시드 중앙값, 그리고 예산 대비 최소 FID 라는 네 장치가 이 연구의 공정성을 떠받칩니다.
핵심 결과: 정규화·손실·구조 슬라이스
각 슬라이스는 나머지 축을 고정한 채 하나만 바꿉니다. 결과는 CelebA-HQ-128과 LSUN-BEDROOM 모두에서 보고됩니다(Section 3.1–3.3).
🧪 1. 정규화 슬라이스 (Figure 1): 손실 NS, 구조 ResNet19 고정
비교군은 BN, LN, SN, GP, DRAGAN(DR), $L^2$, 그리고 아무것도 안 쓴 기준선(W/O)입니다.
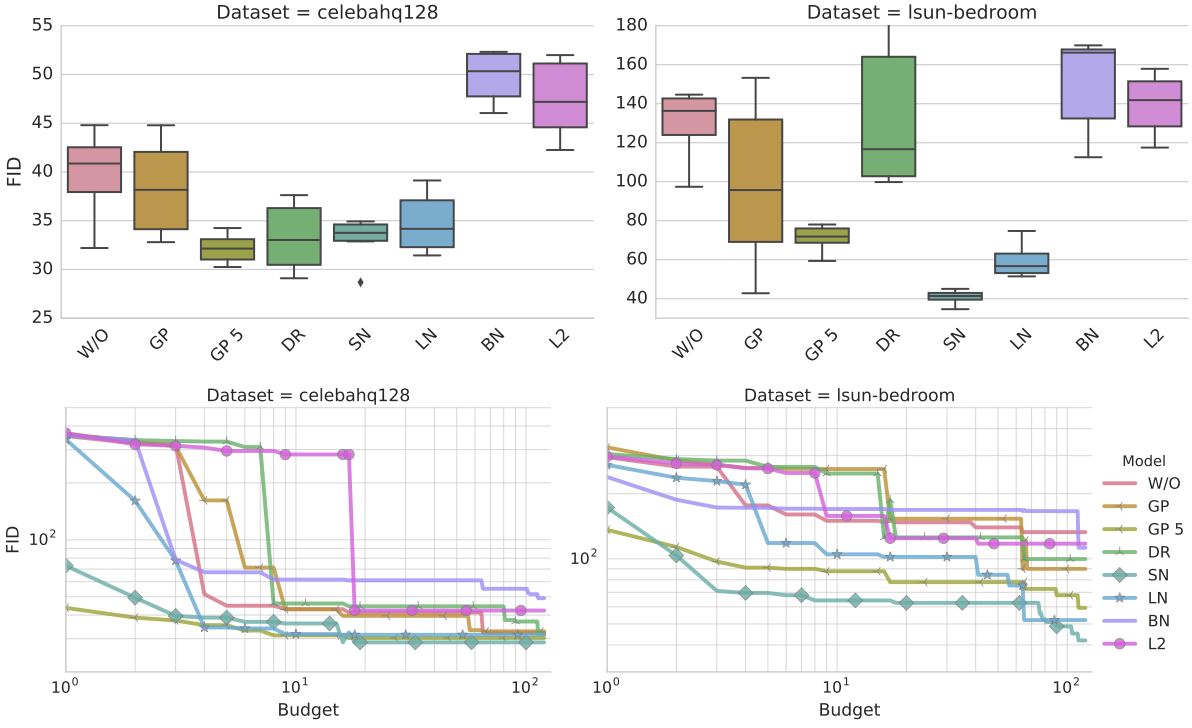
- 판별자에 BN을 넣으면 성능이 나빠집니다.
- GP는 도움이 되지만 학습을 안정화하지는 못합니다. 손실과 정규화 강도의 균형을 맞추는 것이 쉽지 않습니다.
- SN은 품질을 개선하면서 GP보다 계산 효율이 높습니다. 이는 Zhang et al. (2019, SAGAN)의 결과와도 일치합니다.
- 예산 관점(Figure 1 두 번째 행)에서, NS + GP로 FID 100 아래를 얻으려면 최소 6개 설정이 필요하지만, SN은 2개 설정으로 더 낮은 FID에 도달합니다.
- GP 모델은 판별자:생성자 갱신 비율 5:1 에서 이득을 보며, 별도 절제 실험에서 10만 스텝을 더 학습하면 GP 모델이 더 좋아질 가능성이 관찰되었습니다.
🔀 2. 손실 슬라이스 (Figure 2): 구조 ResNet19 고정, SN 또는 GP 적용
NS, LS, WGAN 세 손실을 SN·GP와 조합했습니다.
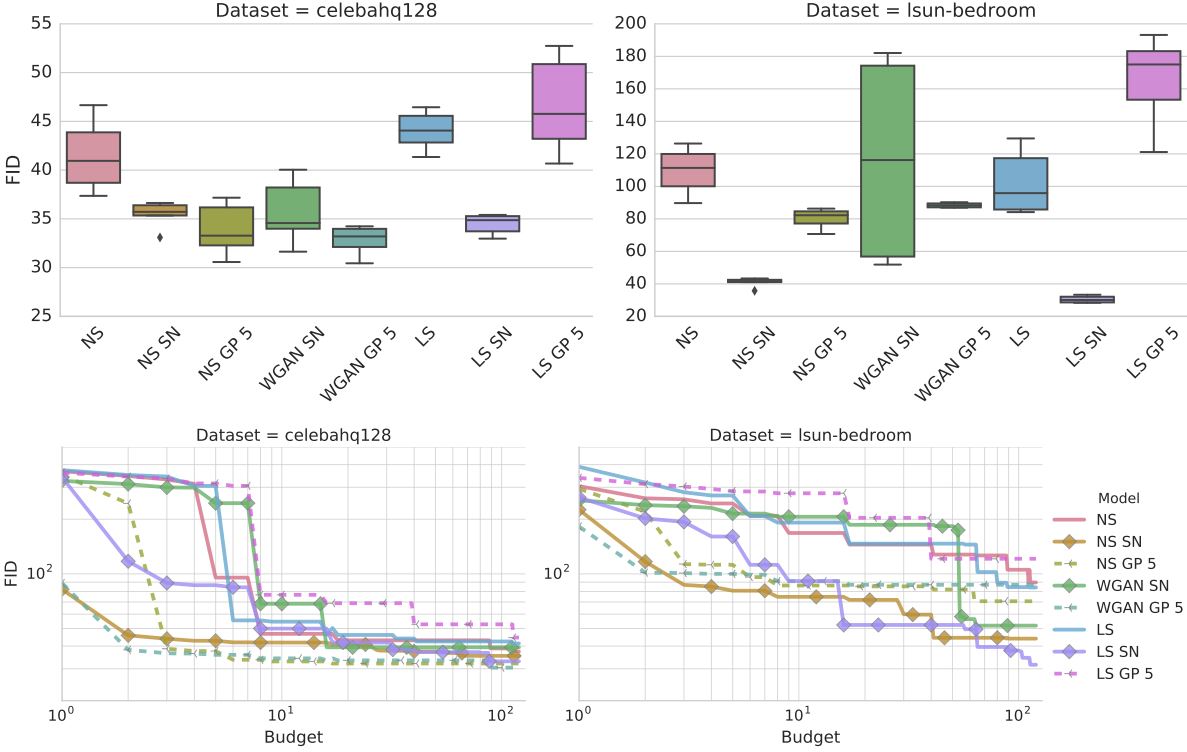
- SN은 두 데이터셋 모두에서, 어떤 손실과 결합해도 품질을 개선합니다.
- GP는 때로 도움이 되지만 뚜렷한 경향이 없고, 좋은 정규화 트레이드오프를 찾는 데 큰 계산 예산이 듭니다.
- GP 모델은 역시 5:1 갱신 비율에서 이득을 봅니다(Gulrajani et al., 2017과 일치).
- 손실 사이에서는 명확한 승자가 없으며, 이것이 “NS가 충분히 안정적이다”라는 결론의 근거입니다.
🏛️ 3. 구조 슬라이스 (Figure 3): 손실 NS 고정, SNDCGAN 대 ResNet19
더 작은 구조에서는 정규화가 필수가 아니라는 Lucic et al. (2018)의 관찰이 있었기에, 깊은 구조에서 정규화 효과가 더 커지는지 확인했습니다.

- 두 구조는 비슷한 수준의 결과를 내고, 둘 다 정규화에서 이득을 봅니다.
- SN은 두 구조 모두에서 기준선을 크게 앞섭니다.
- GP는 하이퍼파라미터를 하나 더 튜닝해야 하므로 계산 효율이 떨어집니다.
부록의 중앙값 FID 표가 이 그림을 수치로 뒷받침합니다.
| 구조 / 데이터셋 | SN 없음 | SN 적용 |
|---|---|---|
| SNDCGAN / CIFAR10 | 29.75 | 26.66 |
| SNDCGAN / LSUN-BEDROOM | 180.36 | 63.46 |
| ResNet CIFAR / CIFAR10 | 31.40 | 23.57 |
LSUN-BEDROOM처럼 복잡한 데이터셋에서 SN 유무의 차이가 극적으로 벌어진다는 점이 눈에 띕니다. ResNet19에서는 CelebA-HQ-128에서 LN을 쓴 설정이 32.46으로 정규화 없는 최선 설정 43.73보다 좋았고, LSUN-BEDROOM에서는 SN이 70.30을 기록했습니다.
➕ 4. 동시 적용 (Figure 4): SN + GP, LN + GP
판별자의 Lipschitz 상수가 핵심이라면 정규화와 벌점을 동시에 쓰면 더 좋아질 것이라 기대할 수 있습니다. 손실 NS, 구조 ResNet19를 고정하고 Table 1 설정에 무작위 24개 설정을 더해 조합을 비교했습니다.
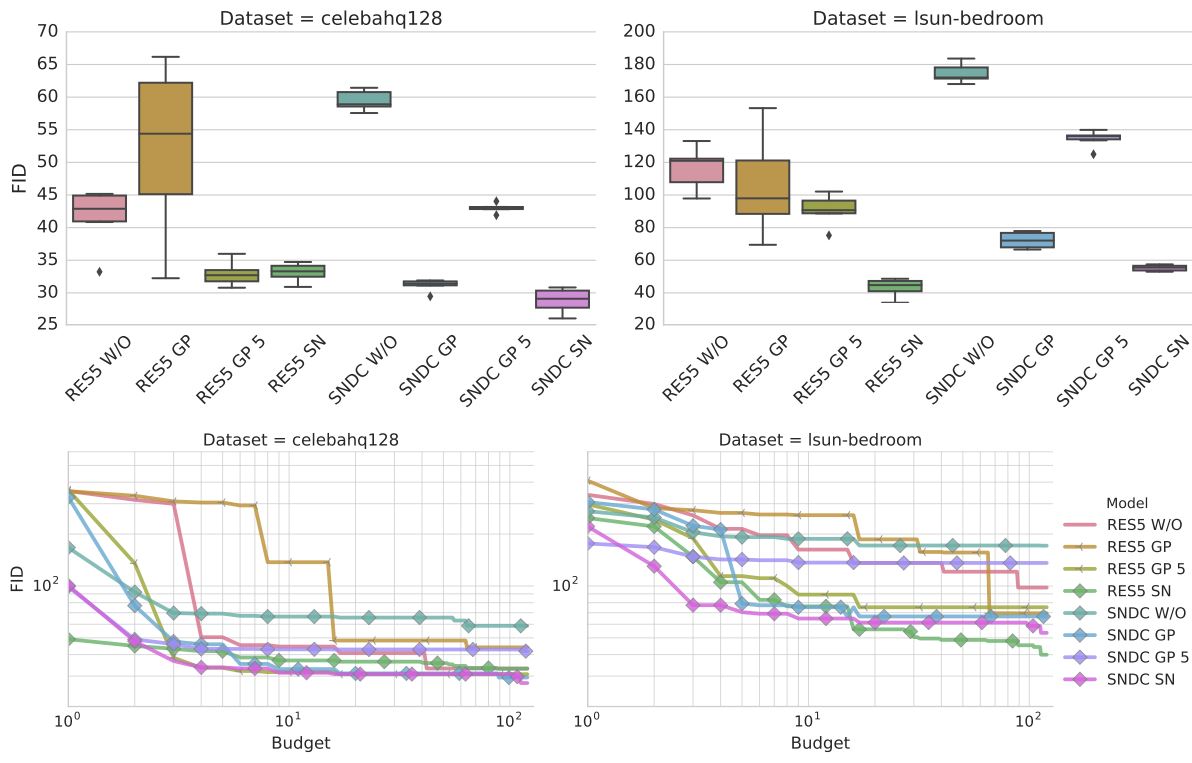
- GP + SN, GP + LN은 기준선을 크게 개선합니다.
- 그러나 상당한 계산 노력 대비 FID 이득은 다소 제한적입니다.
- 저자들은 예산이 충분하다면 동시 적용을 권하며, 이것이 가능한 이유를 SN이 합성곱 층의 정규화 방식 때문에 1-Lipschitz를 보장하지 않는다는 사실로 부분 설명합니다. GP가 그 틈을 메워 준다는 해석입니다.
💡 Key Takeaway 네 슬라이스 모두에서 SN이 가장 일관되고 저렴한 선택이고, GP는 “예산이 있을 때 추가하는 옵션”입니다. 손실과 구조는 결과를 뒤집을 만큼 중요하지 않았습니다.
대규모 연구의 함정: 재현성 문제
Section 4는 저자들이 기존 결과를 재현하면서 겪은 함정을 정리합니다. 각각은 사소해 보이지만 합쳐지면 공정한 비교를 가로막는 안개가 됩니다(Sculley et al., 2018의 표현).
🧮 1. 지표 계산 방식의 불일치
FID 계산 방식이 논문마다 다릅니다.
| 관행 | 예 |
|---|---|
| 학습 데이터 50K 대 생성 50K | Unterthiner et al. (2018) |
| 테스트 10K 대 생성 5K, 자체 구현 | Miyato et al. (2018) |
| 테스트 10K 대 생성 10K | Lucic et al. (2018) |
이 미묘한 차이가 보고 FID를 10% 이상 어긋나게 만들 수 있습니다. 저자들은 FID를 테스트 데이터 기준으로 계산하고, 가능하면 선행 결과와 같은 샘플 수를 써야 한다고 주장합니다. 이 연구에서는 CIFAR10과 LSUN-BEDROOM은 테스트 10K 대 생성 10K, CelebA-HQ-128은 3K 대 3K를 사용했습니다.
🧱 2. 구조 세부사항과 데이터 전처리
ResNet 같은 대중적 구조도 블록 내 층 순서, ReLU 적용 시점, 업/다운샘플링 위치, 필터 수 같은 결정이 보고에서 흔히 빠져 있어 잠재적으로 불공정한 비교를 만듭니다. 저자들은 자신들의 구조를 기준선으로 쓰기를 제안합니다. 데이터셋도 마찬가지입니다. “LSUN-BEDROOM”이 늘 같은 데이터셋인가? 업스케일이나 크롭의 정확한 알고리즘이 명시되지 않아 같은 이름의 데이터셋 사이에 불일치가 생깁니다.
🎛️ 3. 구현 세부사항과 비결정성
논문에 적힌 알고리즘과 공개 코드가 다른 경우가 많고, 좋은 구현과 나쁜 구현 사이의 간극은 “당혹스러울 만큼” 큽니다. 코드가 없으면 어떤 수정이 있었는지 추측할 수밖에 없습니다. 무작위성 제거도 까다롭습니다. 데이터 순서와 초기 가중치를 고정해도 GPU 연산의 비결정성 때문에 같은 모델을 두 번 학습해 같은 점수를 얻기가 어렵고, 비결정성을 일으키는 최적화를 끄면 실행 시간이 한 자릿수 배 늘어납니다.
💡 Key Takeaway “FID 몇 점 차이”를 논하기 전에 지표 계산법·전처리·구조 세부·구현이 같은지부터 물어야 합니다. 이 논문이 코드와 사전학습 모델을 공개한 이유입니다.
실무 권고와 선행 연구와의 관계
이 연구는 Lucic et al. (2018)의 “Are GANs Created Equal?”을 모든 축에서 한 단계 확장한 것으로 자리매김합니다(Section 5–6).
🧭 1. 권고안
| 상황 | 권고 |
|---|---|
| 계산 예산이 제한적일 때 | non-saturating 손실 + spectral normalization 을 기본값으로 |
| 예산이 더 있을 때 | gradient penalty 추가, 그리고 수렴할 때까지 학습 |
| 구조 선택 | SNDCGAN과 ResNet 계열 모두 잘 작동. ResNet 변형 대부분은 미미한 개선 |
| 평가 | 테스트 데이터 기준 FID, 선행 결과와 같은 샘플 수 |
🔗 2. 선행 연구와의 차이
| 연구 | 범위 | 결론 |
|---|---|---|
| Lucic et al. (2018) | MNIST, CIFAR10, CelebA / 단일 구조 / 손실·정규화 일부 | 최근 모델과 원래 NS GAN 사이에 통계적으로 유의한 차이 없음 |
| Fedus et al. (2018) | 기울기 노름 정규화 | GP를 NS GAN에도 적용 가능, 하이퍼파라미터 민감도를 제한적으로 감소 |
| Miyato et al. (2018) | SN 제안, 소규모 비교 | SN이 경쟁 기법보다 우수 |
| 본 논문 | 더 복잡한 구조, 더 복잡한 데이터셋, 더 많은 정규화 기법 | SN이 강건한 기본값, GP는 예산이 있을 때 |
Lucic et al. (2018)의 공개 코드를 기반으로 구조·데이터·정규화 세 차원을 모두 확장했다는 점이 기여의 핵심입니다.
📦 3. 공개 자원
학습·평가 코드는 GitHub의 compare_gan 저장소로, 사전학습 모델은 TensorFlow Hub 로 공개되었습니다. 이후 Google의 여러 GAN 연구(self-modulation, self-supervised GAN 등)가 이 코드베이스 위에서 수행되었다는 점에서, 이 논문은 결과뿐 아니라 인프라로서도 후속 연구의 기준선이 되었습니다.
💡 Key Takeaway 결론은 단순합니다. NS + SN으로 시작하고, 여유가 있으면 GP를 더하라. 그리고 비교할 때는 지표와 전처리를 맞춰라.
한계와 열린 방향
이 연구는 대규모이지만 전체 지형이 아니라 슬라이스를 탐색했고, 저자들 스스로 여러 한계를 명시합니다(Section 6).
🚧 1. 탐색 범위의 한계
- 손실·구조·정규화의 모든 조합을 탐색한 것이 아니라 한 축씩 고정한 슬라이스만 보았으므로, 축 사이의 상호작용은 Figure 4의 일부 조합을 제외하면 다루지 않았습니다.
- 해상도는 최대 $128\times128$ 이고, BigGAN(Brock et al., 2019)처럼 대규모 학습이 필요한 모델이나 StyleGAN(Karras et al., 2019), SAGAN(Zhang et al., 2019) 같은 맞춤형 구조는 포함되지 않았습니다.
- 정규화 기법도 GP, DRAGAN, $L^2$, BN, LN, SN으로 한정되어, Roth et al. (2017), Mescheder et al. (2018)의 R1/R2 류 벌점이나 Chen et al. (2018)의 안정화 기법은 미래 과제로 남았습니다.
🏷️ 2. 비조건부 설정과 지표의 한계
- 모든 실험이 비조건부(unconditional) GAN입니다. 조건부 GAN이 더 널리 쓰이는 만큼, 이 통찰이 조건부 설정으로 이전되는지는 확인이 필요합니다.
- FID와 IS 모두 알려진 단점이 있습니다. 가우시안 가정, 편향된 추정량, Inception 특징에 대한 의존 등입니다. 저자들은 Sajjadi et al. (2018)과 Kynkäänniemi et al. (2019)의 정밀도–재현율(precision–recall) 계열 지표로 추가 평가하면 새로운 통찰이 나올 수 있다고 적었습니다.
🔭 3. 이후 연구와의 연결
이 논문의 권고는 이후 GAN 설계에서 사실상 표준이 되었습니다. SN은 BigGAN을 비롯한 대규모 모델의 기본 구성 요소가 되었고, “예산이 있으면 벌점을 추가하라”는 권고는 StyleGAN2의 lazy regularization처럼 벌점의 계산 비용을 줄이는 방향으로 이어졌습니다. 한편 이 연구가 제기한 재현성 문제, 특히 FID 계산 방식의 표준화는 이후 clean-fid 같은 작업으로 별도의 연구 주제가 되었습니다. 남은 질문은 분명합니다. 여기서 얻은 결론이 더 큰 모델, 더 높은 해상도, 조건부 설정, 그리고 GAN 이후의 생성 모델에서도 유지되는가입니다.
💡 Key Takeaway 이 연구의 가치는 “SN이 좋다”는 결론 못지않게, 공정한 비교란 무엇인가를 실험 설계로 보여 준 데 있습니다. 그 설계는 모델이 바뀌어도 그대로 쓸 수 있습니다.