 You know maize mean?
Precomputed Real-Time Texture Synthesis with Markovian Generative Adversarial Networks
0. Summary
기본 정보 : ArXiv,2016.04.15 (ECCV 2016), Precomputed Real-Time Texture Synthesis with Markovian Generative Adversarial Networks
연구 배경
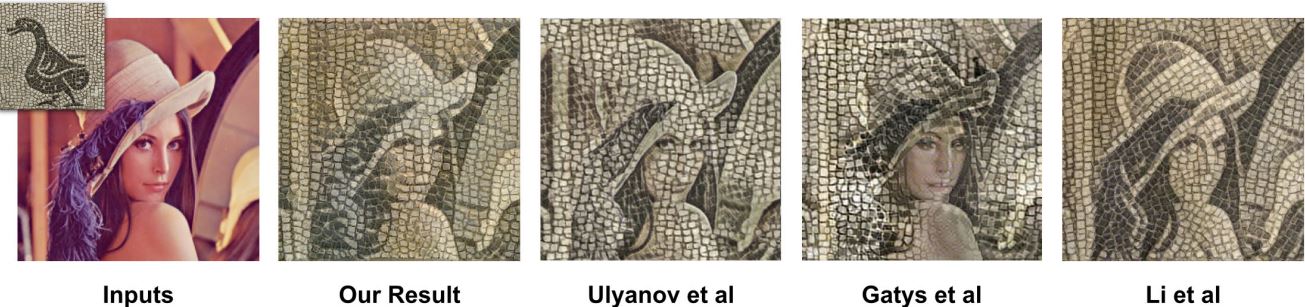
Gatys et al.의 신경망 기반 텍스처 합성과 스타일 전이는 품질 면에서 큰 반향을 일으켰지만, 매 출력 이미지마다 VGG 특징 공간에서 수치적 디콘볼루션(numerical deconvolution), 즉 픽셀을 반복 최적화하는 과정이 필요해 저해상도 이미지 한 장에도 수 분이 걸렸다. Li & Wand(CVPR 2016)의 패치 기반 MRF 방법은 복잡한 내용에서 더 일관된 텍스처 전이를 보여주지만, 패치 사전에 대한 최근접 이웃 탐색을 반복해야 하므로 더욱 느리다(384×384 이미지 한 장에 110초). 또 다른 축인 Gatys 류의 전역 통계 모델은 특징 벡터 분포를 가우시안(Gram 행렬) 으로 가정하는데, 실제 데이터는 복잡한 비선형 다양체 위에 놓여 있어 얼굴 같은 구조화된 내용은 Gram 행렬로 잘 구속되지 않는다(Fig. 1). 즉 “패치 수준의 충실한 텍스처 재현”과 “피드포워드 수준의 속도”를 동시에 가지는 생성 모델이 비어 있었다.
제안 방법
이 논문은 두 단계 모델을 제안한다. 첫째, MDAN(Markovian Deconvolutional Adversarial Network) 은 Li & Wand의 패치 사전과 최근접 탐색을 판별 네트워크 $D$ 로 대체한다. $D$ 는 VGG-19의 relu3_1 특징 맵에서 규칙적으로 샘플링한 “신경 패치(neural patch)”가 예제 텍스처에서 온 것인지 합성 이미지에서 온 것인지 분류하고, 힌지 손실(Eq. 2)로 정의된 텍스처 손실 $E_t$ 를 픽셀로 역전파해 이미지를 반복 갱신한다(Eq. 1). 둘째, MGAN(Markovian Generative Adversarial Network) 은 MDAN이 만든 결과를 목표로 삼아, VGG-19 relu4_1 인코딩을 입력받아 픽셀을 곧바로 디코딩하는 스트라이드 컨볼루션 생성 네트워크 $G$ 를 적대적으로 학습시킨다. VGG-19는 고정하고 $D$ 와 $G$ 만 동시에 학습하며, 고정 크기 패치로 학습해도 완전 컨볼루션 구조 덕분에 임의 크기 이미지를 한 번의 순전파로 생성한다.
발견 사실
학습된 $G$ 는 nVidia TitanX에서 256×256 이미지를 10 ms, 512×512 를 40 ms, 1024×1024 를 160 ms 에 생성해 픽셀 수에 선형으로 비례하는 시간 비용을 보였고, 0.25M 픽셀 이미지를 25 Hz로 디코딩한다. 이는 Gatys et al. 대비 약 500배, Li & Wand 대비 약 5000배 빠른 속도이며, 동시기 피드포워드 연구인 Ulyanov et al.의 Texture Networks와는 같은 수준이다(Fig. 15). 품질 면에서는 전역 가우시안 통계 방법이 놓치는 눈·얼굴 같은 복잡한 내용에도 일관된 텍스처를 입혔고(Fig. 11, 12), 임의의 ImageNet 이미지 100장과 예제 텍스처 한 장만으로 학습한 모델이 브라운/Perlin 노이즈를 그럴듯한 텍스처로 디코딩하거나(Fig. 13) 1080×810 비디오를 8 Hz로 스타일화했다(Fig. 14). 분석 실험에서는 relu3_1 + 패치 크기 8이 품질과 유연성의 균형점이고, 사전학습된 VGG 없이 픽셀부터 판별기를 학습하면 품질이 크게 떨어지며, 픽셀 공간 L2 손실의 VAE보다 신경 인코딩 비교가, 그보다 적대적 학습이 스타일 재현에 우수함을 보였다(Fig. 5). 한 텍스처당 학습은 약 1시간이며, 생성기 파라미터는 VGG relu4_1까지 포함해 70 MB다.
핵심 기여
- 마르코프 신경 패치 위의 적대적 학습 : 전체 이미지가 아니라 같은 이미지에서 뽑은 문맥적으로 대응되는 신경 패치를 판별 단위로 삼아, 객체 클래스 분포 전체를 배우는 GAN보다 학습을 쉽고 효과적으로 만들었다. 패치 사전과 최근접 탐색은 연속적인 판별 네트워크 $D$ 로 대체된다.
- 사전 계산된 피드포워드 합성기(MGAN) : MDAN의 디콘볼루션 결과를 교사로 삼아 relu4_1 → 픽셀 디코더 $G$ 를 적대적으로 학습시켜, 최적화 없이 임의 크기 이미지를 실시간(512×512 @ 25 Hz)으로 생성한다. 이전 신경 텍스처 합성기 대비 최소 500배 빠르다.
- 학습 안정화 설계와 체계적 분석 : 시그모이드+BCE 대신 힌지 손실로 판별기 포화를 피하고, 배치 정규화·Leaky ReLU, 사전학습 $D$ 초기화, 오토인코더 기반 $G$ 초기화를 도입했으며, 입력 층·패치 크기·네트워크 깊이·채널 수·VGG 역할에 대한 소거 실험으로 설계 선택의 근거를 제시했다.
관련 개념
가우시안 통계에서 마르코프 패치로: 문제 설정
텍스처 합성(texture synthesis) 은 작은 예제 텍스처에서 통계적으로 동일하게 보이는 임의 크기의 이미지를 만드는 문제이고, 유도(guided) 합성 혹은 스타일 전이는 내용 이미지의 구조를 유지한 채 그 위에 예제 텍스처를 입히는 문제입니다. 이 논문은 둘 다 “어떤 통계를 맞출 것인가”와 “그 통계를 어떻게 빠르게 맞출 것인가”라는 두 질문으로 봅니다.
🧭 1. 두 계열의 선행 연구
| 계열 | 대표 연구 | 맞추는 통계 | 장점 | 단점 |
|---|---|---|---|---|
| 전역 통계 | Gatys et al. | 상위 층 특징 벡터의 공분산(Gram 행렬) | 전역적 “look and feel” 보존, 색 분포 충실 | 특징 벡터별 통계만 강제해 비정상(non-stationary) 패턴 재현에 한계 |
| 국소 패치 MRF | Li & Wand (CVPR 2016) | 신경 패치의 최근접 이웃 매칭 | 복잡한 내용에서도 가장 일관된 합성 | 패치 매칭 반복으로 매우 느림(384×384 에 110초) |
| 피드포워드 근사 | Ulyanov et al., Johnson et al. (동시기) | Gatys 류 지각 손실로 디코더 사전 학습 | 큰 속도 이득 | 여전히 가우시안 가정 |
본 논문의 개념적 차이는 Li et al.의 특징 패치 통계를 쓰되 Ulyanov/Johnson처럼 디코더를 사전 계산한다는 점입니다. 개별 특징 벡터의 가우시안 분포 대신 패치 통계를 쓰면 텍스처를 더 충실하게 재현할 수 있다는 것이 저자들의 주장입니다.
🌀 2. 왜 가우시안으로 부족한가 (Fig. 1)
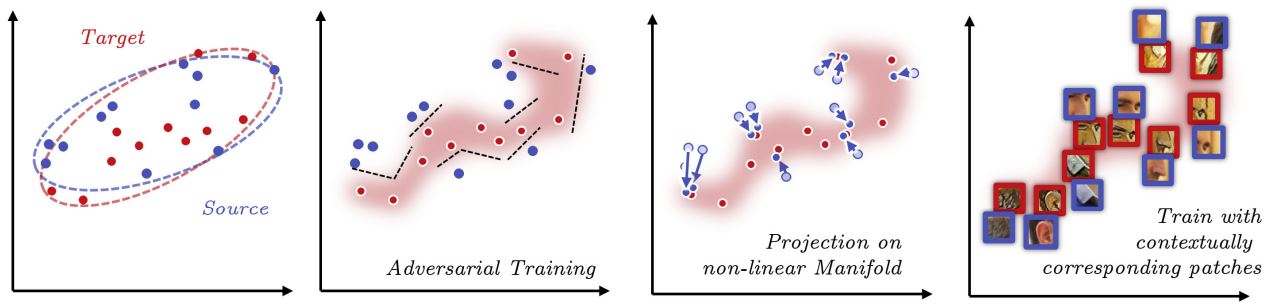
통계 기반 방법은 소스(입력 사진 또는 노이즈)와 타깃(텍스처)의 분포를 가우시안 모델로 맞추고, 두 분포가 일치하면 더 이상 결과를 개선하지 않습니다. 그러나 실제 데이터는 복잡한 비선형 다양체를 따를 수 있습니다. 적대적 학습은 판별 네트워크로 그 다양체를 인식하고, 생성 결과를 다양체 위로 투영함으로써 생성력을 강화합니다. 여기에 더해 이 논문은 문맥적으로 대응되는 마르코프 패치로 적대적 학습을 제한합니다. 그러면 학습은 “문맥과 묘사의 혼합”이 아니라 같은 문맥의 서로 다른 묘사(depiction) 사이의 사상에 집중하게 됩니다.
🧩 3. “마르코프(Markovian)”의 의미
여기서 마르코프 가정은 MRF 텍스처 모델의 전통적 가정입니다. 한 위치의 외관은 국소 이웃(패치) 에 의해서만 결정되고, 전체 이미지의 전역 배치와는 독립이라는 뜻입니다. 이 가정 덕분에 모델은 고정 크기 패치로만 학습해도 완전 컨볼루션 구조로 임의 크기 이미지를 생성할 수 있고, 패치 단위 판별이 전체 이미지 단위 판별보다 훨씬 데이터 효율적입니다. 대신 전역 구조(얼굴 전체의 의미 등)는 모델링하지 않으므로, 이는 뒤에서 다룰 한계와 직결됩니다.
💡 Key Takeaway 이 논문은 “전역 가우시안 통계 vs 국소 패치 통계”와 “반복 최적화 vs 피드포워드”라는 두 축에서, 패치 통계 + 피드포워드라는 비어 있던 칸을 채웁니다.
MDAN: 판별 네트워크가 구동하는 디콘볼루션 합성
MDAN(Markovian Deconvolutional Adversarial Networks) 은 Li & Wand의 패치 기반 합성 알고리즘을 확장한 것으로, 패치 사전(그리고 반복적인 최근접 이웃 탐색)을 연속적인 판별 네트워크 $D$ 로 대체합니다(Fig. 2의 녹색 블록). $D$ 는 VGG-19 relu3_1 층(보라색 블록)의 실제 특징 패치와 부적절하게 합성된 패치를 구분하도록 학습됩니다.
🏗️ 1. 파이프라인 (Fig. 2)
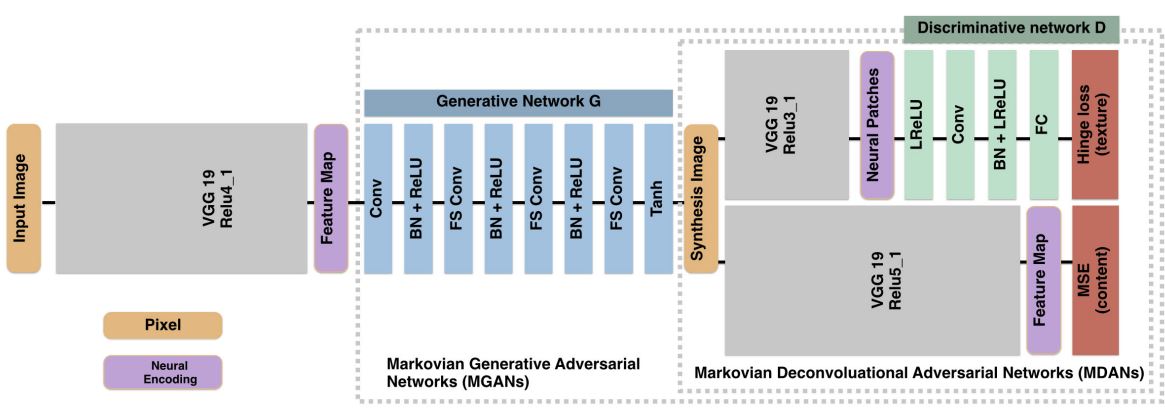
| 블록 | 역할 | 학습 여부 |
|---|---|---|
| VGG-19 (회색) | 이미지를 특징 맵으로 인코딩. relu3_1 은 $D$ 입력, relu4_1 은 $G$ 입력, relu5_1 은 선택적 내용 유도 | 고정 |
| $D$ (녹색) | relu3_1 신경 패치의 진짜/가짜 분류 점수 $s=\pm1$ 출력 | 학습 |
| $G$ (파란색, MGAN에서 추가) | relu4_1 인코딩을 픽셀로 직접 디코딩하는 스트라이드 컨볼루션 네트워크 | 학습 |
VGG 네트워크(판별기 경로, 선택적으로 유도 경로) 위에서 디콘볼루션을 실행하면 MDAN이 되고, 여기에 $G$ 를 더해 $D$ 와 $G$ 를 동시에 학습하면 MGAN이 됩니다.
🧮 2. 에너지 함수 (Eq. 1)
예제 텍스처를 $x_t\in\mathbb{R}^{w_t\times h_t}$, 합성 이미지를 $x\in\mathbb{R}^{w\times h}$ 라 합니다. 비유도 합성에서는 $x$ 를 랜덤 노이즈로, 유도 합성에서는 내용 이미지 $x_c$ 로 초기화하고, 디콘볼루션은 다음 에너지를 최소화하도록 $x$ 를 반복 갱신합니다.
\[x=\underset{x}{\arg\min}\; E_t\big(\Phi(x),\Phi(x_t)\big)+\alpha_1 E_c\big(\Phi(x),\Phi(x_c)\big)+\alpha_2\,\Upsilon(x)\]| 항 | 의미 | 설정 |
|---|---|---|
| $E_t$ | 텍스처 손실. $\Phi(x)$ 는 VGG-19 relu3_1 특징 맵 | 아래 Eq. 2 |
| $E_c$ | 내용 손실. $\Phi(x)$ 와 $\Phi(x_c)$ 의 평균제곱오차(MSE). 유도 합성에서만 사용 | $\alpha_1=1$ |
| $\Upsilon(x)$ | 픽셀 평활도 사전(smoothness prior), Mahendran & Vedaldi 를 따름 | $\alpha_2=0.0001$ |
$E_t$ 와 $\Upsilon(x)$ 만으로 무작위 텍스처를 합성할 수 있고(Fig. 3), $E_c$ 를 더하면 유도 이미지 $x_c$ 와 문맥적으로 관련된 이미지를 생성합니다(Fig. 4). 최적화는 ADAM(학습률 0.02, 모멘텀 0.5)으로 역전파합니다.
📐 3. 힌지 텍스처 손실 (Eq. 2)
$\Phi(x)$ 에서 패치를 샘플링하고, 레이블을 1로 고정한 힌지 손실로 $E_t$ 를 계산합니다.
\[E_t\big(\Phi(x),\Phi(x_t)\big)=\frac{1}{N}\sum_{i=1}^{N}\max\big(0,\;1-1\times s_i\big)\]$s_i$ 는 $i$ 번째 신경 패치의 분류 점수, $N$ 은 $\Phi(x)$ 에서 샘플링한 패치 총수입니다. 합성 이미지에서 뽑은 각 패치에 대해 $1-s$ 가 최소화할 텍스처 손실이 되고, 이 손실이 픽셀까지 역전파됩니다. 각 신경 패치는 $D$ 의 역전파를 통해 자기만의 출력 기울기를 받으므로, 인접 패치 사이의 일관된 전환을 위해 texture optimization처럼 기울기를 블렌딩합니다.
$D$ 는 즉석에서(on the fly) 학습됩니다. 파라미터를 무작위 초기화한 뒤 매 디콘볼루션 스텝 후 갱신하므로, 합성 결과가 좋아질수록 판별기도 점점 똑똑해집니다. Radford et al.(DCGAN)을 따라 배치 정규화와 Leaky ReLU 를 사용합니다.
🖼️ 4. MDAN 결과 (Fig. 3, 4)
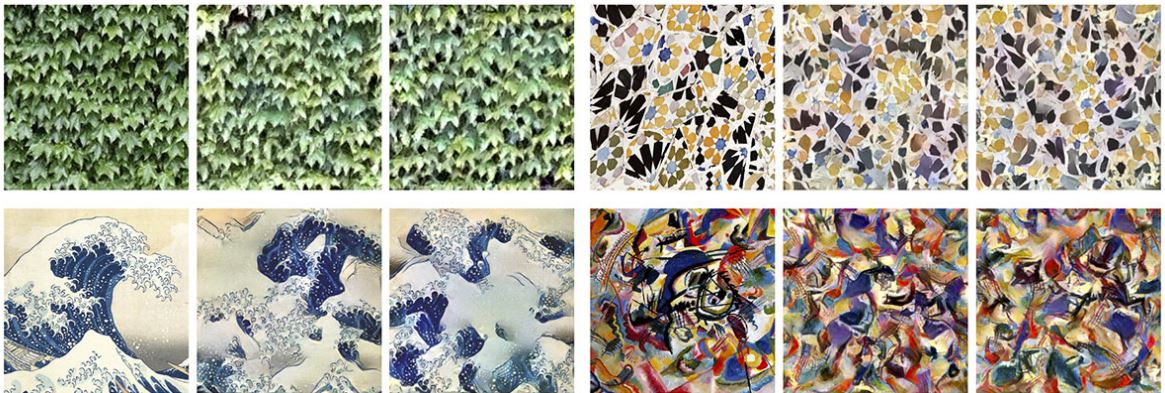
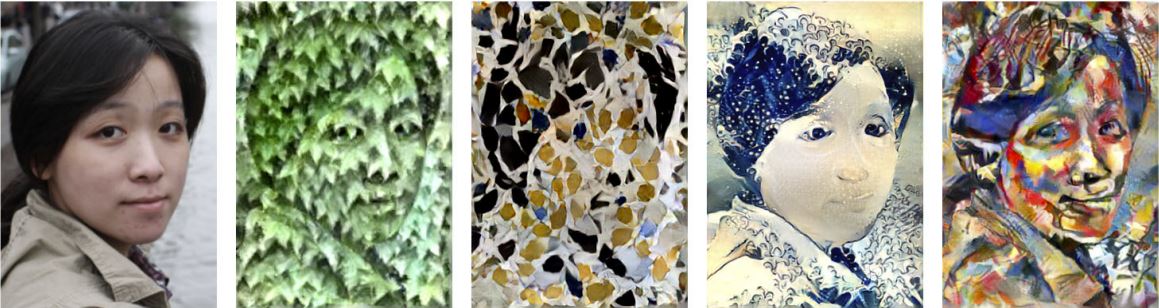
Fig. 3은 “Ivy”, 호쿠사이의 “가나가와 앞바다의 큰 파도”, 칸딘스키의 “Composition VII” 등 예제 텍스처로부터의 비유도 합성, Fig. 4는 같은 텍스처를 사진에 입힌 유도 합성입니다. MDAN은 반복 정제 덕분에 평탄한 배경을 자연스럽게 만들고 입력 사진의 내용을 잘 보존하지만, 매 출력마다 수많은 반복과 별도 실행이 필요해 여전히 매우 느립니다. 이것이 MGAN의 동기입니다.
💡 Key Takeaway MDAN은 “패치 사전 + 최근접 탐색”을 “학습되는 판별기 + 힌지 손실”로 바꾼 것입니다. 품질은 유지하되, 속도 문제는 아직 해결되지 않습니다.
MGAN: 디콘볼루션을 피드포워드 디코더로 사전 계산
MGAN(Markovian Generative Adversarial Networks) 은 MDAN의 출력(텍스처가 입혀진 사진)을 목표 예제로 삼아, 특징 맵을 픽셀로 직접 디코딩하는 생성 네트워크 $G$ 를 학습합니다. 논문은 이를 오토인코더 학습으로 설명하며, 핵심은 “어떤 척도로 재구성을 비교할 것인가”입니다.
🔁 1. 생성기 $G$ 의 구조
$G$ (Fig. 2의 파란색 블록)는 VGG-19의 relu4_1 층을 입력으로 받아, 일반 컨볼루션 하나와 분수 스트라이드 컨볼루션(fractional-strided convolution, FS Conv) 캐스케이드로 이미지를 디코딩합니다. 고정 크기 입력으로 학습하지만 완전 컨볼루션이므로 임의 크기 이미지로 자연스럽게 확장됩니다. 학습 중 VGG-19는 고정하고 $D$ 와 $G$ 만 최적화하며, $D$ 는 $G$ 의 적대자로서 $G$ 의 품질을 최대화하기 위해 동시에 학습됩니다. 논문은 $G$ 와 $D$ 의 개별 층 수·채널 수를 본문에 명시하지 않고, 소거 실험(Sec. 4)에서 상대적인 변화만 보고합니다.
📏 2. 어떤 척도로 학습할 것인가 (Fig. 5)
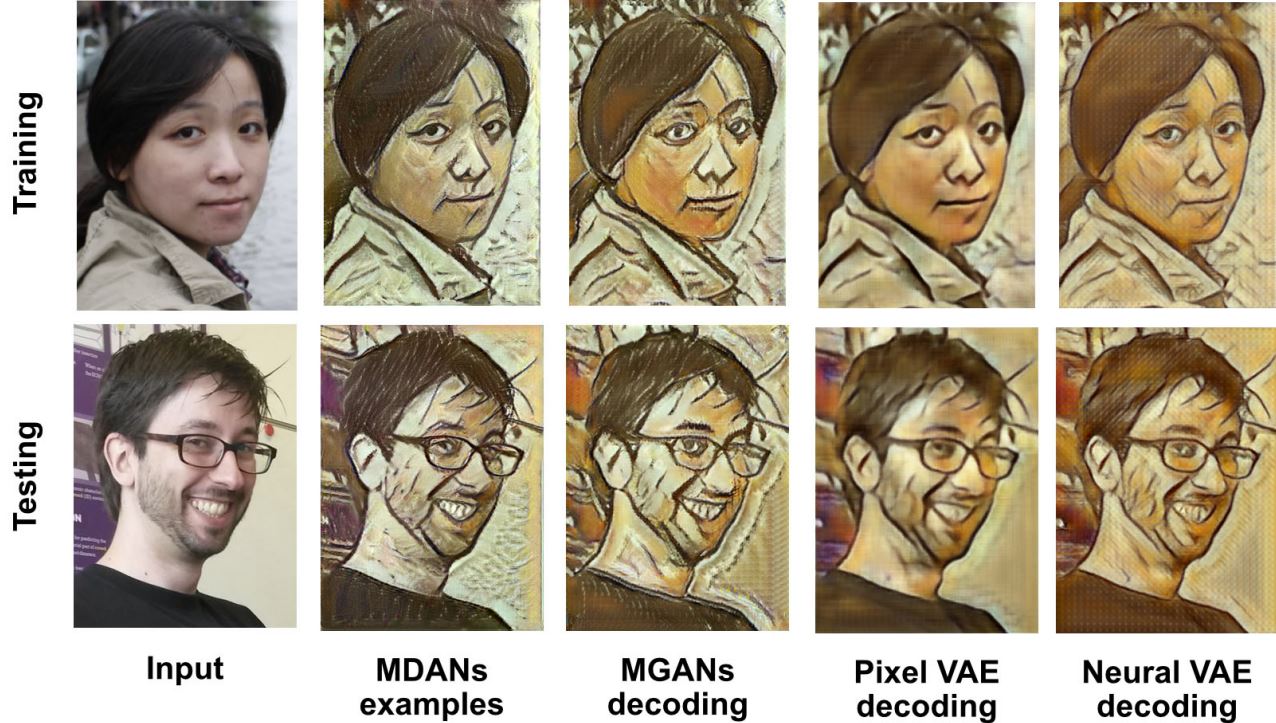
Dosovitskiy et al.이 지적했듯 오토인코더 학습에는 좋은 척도가 결정적입니다.
| 변형 | 비교 공간 | 결과 |
|---|---|---|
| Pixel VAE | 합성 이미지와 목표 이미지의 픽셀 유클리드 거리 | 지나치게 매끄러운(over-smoothed) 이미지 |
| Neural VAE | 신경 인코딩 수준 비교 | 개선됨 |
| MGANs | 신경 패치 위의 적대적 학습 | 의도한 스타일 재현이 가장 우수 |
⚔️ 3. 고전적 GAN과의 차이
| 항목 | 고전적 GAN / DCGAN | MGAN |
|---|---|---|
| 판별 단위 | 전체 이미지 | 같은 이미지에서 뽑은 신경 패치 |
| 학습 대상 | 객체 클래스의 분포, 혹은 문맥적으로 무관한 데이터 간 사상 | 패치 간 문맥 대응을 활용한 “같은 내용의 다른 묘사” 사상 |
| 판별기 출력/손실 | 시그모이드 + 이진 교차 엔트로피 | 최대 마진 기준(힌지 손실) |
힌지 손실을 쓰는 이유는 $D$ 학습 시 기울기 소실을 피하기 위해서입니다. MGAN의 학습 데이터는 DCGAN보다 다양성이 훨씬 낮아 시그모이드가 쉽게 포화되므로, 이 문제가 Radford et al.의 설정보다 더 심각합니다.
🎨 4. Picasso 자화상 실험과 학습 과정 (Fig. 5, 6)
Picasso의 “Self-portrait 1907” 스타일을 배우는 네트워크의 학습 데이터는 다음과 같이 구성됩니다.
| 항목 | 값 |
|---|---|
| 사진 | CelebA 얼굴 75장 + 공개 도메인 비연예인 사진 25장 |
| 크기 | 최대 변 384 픽셀로 리사이즈 |
| 증강 | 사진당 회전·스케일을 달리한 9개 복사본 |
| 샘플 | 128×128 크롭을 규칙적으로 샘플링 |
| 총 학습 예제 | 24,506개 (각각 relu3_1 인코딩에서 신경 패치를 샘플링해 $D$ 입력으로 사용) |
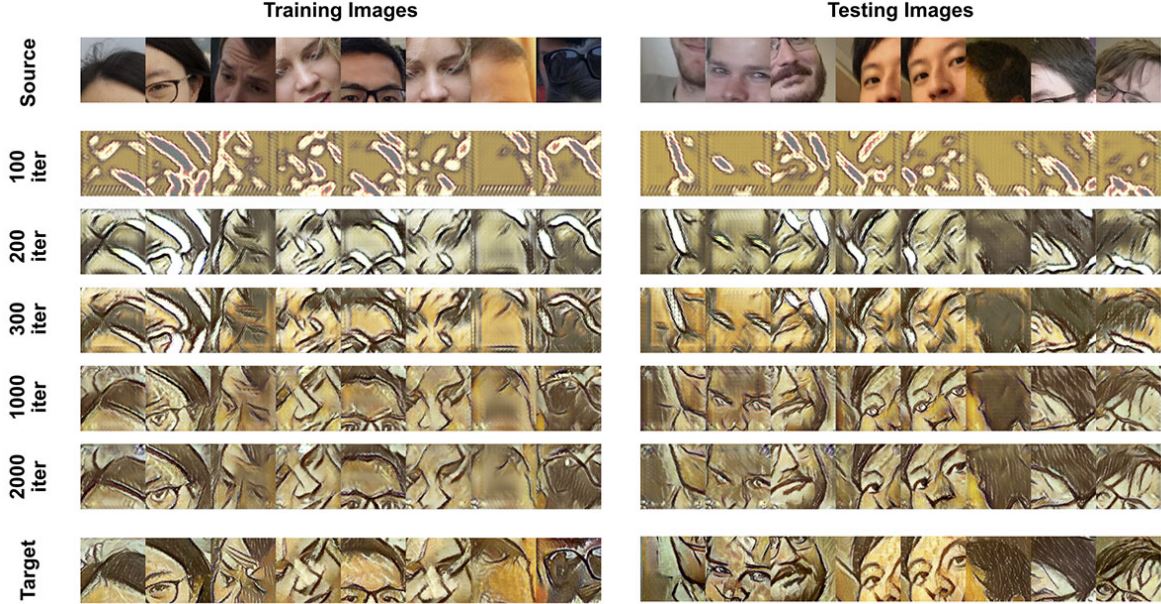
Fig. 6의 중간 결과를 보면 100 배치 후 전체 색과 강한 대비 영역을 익히고, 300 배치 후 붓질 텍스처를 만들기 시작하며, 1000 배치 후 눈을 그리는 법을 배웁니다. 추가 학습은 고스팅 아티팩트 일부를 제거합니다. 테스트 사진에 대한 MDAN 결과는 학습에 전혀 쓰이지 않았음에도 $G$ 의 직접 디코딩이 이를 잘 근사합니다. MDAN은 입력 사진의 내용을 더 잘 보존하고 MGAN은 많은 이미지로 학습해 가장 빈번한 특징을 익혔기에 더 양식화된(stylized) 결과를 냅니다.
💡 Key Takeaway MGAN은 느린 MDAN을 교사로 삼아 “relu4_1 → 픽셀” 디코더를 적대적으로 증류한 것입니다. 픽셀 L2보다 신경 인코딩 비교가, 그보다 패치 적대 손실이 스타일을 더 충실하게 살립니다.
설계 선택에 대한 실험적 분석 (Sec. 4)
논문은 파라미터(분류에 쓰는 층, 패치 크기)와 모델 복잡도(층 수, 채널 수), 초기화, VGG의 역할을 분석합니다. 모든 텍스처에 보편적인 최적 설계는 없을 수 있지만, 모델이 경우에 따라 어떻게 행동하는지 밝히는 것이 목적입니다. 공정한 비교를 위해 예제 텍스처는 128×128 로 고정하고 출력은 256×256 으로 요구합니다.
🔬 1. 입력 층과 패치 크기 (Fig. 8)
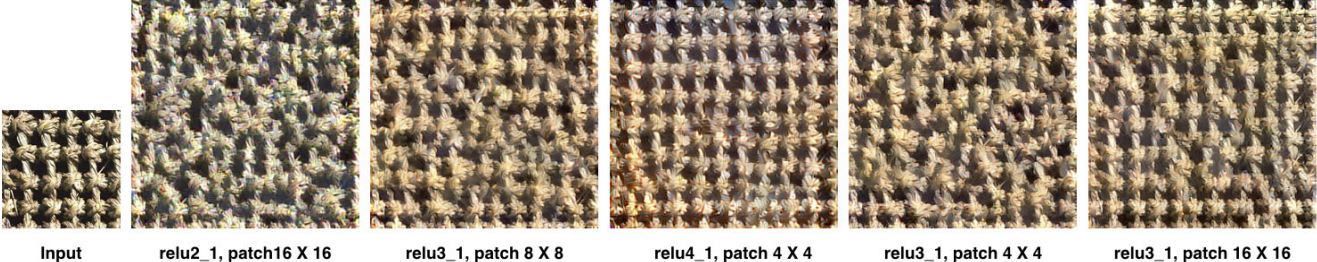
$D$ 의 입력 층을 바꾸되 이미지 상 수용 영역이 약 32 픽셀로 같도록 패치 크기를 조정합니다.
| $D$ 입력 층 | 패치 크기 | 결과 |
|---|---|---|
| relu2_1 | 16 | 더 선명하지만 텍스처의 형태·구조를 잃음 |
| relu3_1 | 8 (기본) | 품질과 유연성의 좋은 균형 |
| relu4_1 | 4 | 규칙성 같은 거친 구조는 잘 보존하나 유도 시나리오에서 너무 경직될 위험 |
입력 층을 relu3_1 로 고정하고 패치 크기를 4, 16 으로 바꾸면 작은 패치는 유연성을 높이고 큰 패치는 구조를 더 잘 보존합니다. 즉 패치 크기는 모델의 경직도(rigidity)를 조절하는 손잡이입니다.
🧱 2. 네트워크 복잡도 (Fig. 9)
- $D$ 의 깊이 : 컨볼루션 층을 제거하면 깊이가 줄어 합성 품질이 떨어지고, 되돌리면 더 매끄러운 합성이 되지만, 층을 더 추가해도 품질이 뚜렷이 좋아지지는 않습니다.
- $D$ 의 채널 수 : 4, 64, 128 채널을 비교하면 채널이 줄수록 대체로 나빠지지만, 64와 128 사이에는 유의미한 차이가 없습니다. 복잡도 요구는 텍스처에 따라 다릅니다. Ivy 처럼 단순한 MRF는 4채널과 64채널의 차이가 미미합니다.
- $G$ 의 복잡도 : 첫 컨볼루션 층을 빼거나 전체 채널을 줄이면 약간의 품질 손실이 있고, 더 복잡한 설계의 개선은 매우 제한적입니다. 모두 같은 $D$ 가 구동하기 때문이며, 개선이 멈춘다는 것은 디콘볼루션 과정의 어떤 비자명한 정보는 피드포워드로 복원되지 않음을 시사합니다. 특히 분수 스트라이드 컨볼루션은 max-pooling 의 비선형 거동을 모델링하지 못해 균질한 무텍스처 영역에서 앨리어스 패턴을 만들곤 합니다. 이를 피하고 텍스처 변이를 유도하기 위해 입력 이미지에 선택적으로 Perlin 노이즈를 더할 수 있습니다.
🌱 3. 초기화와 VGG의 역할 (Fig. 10)
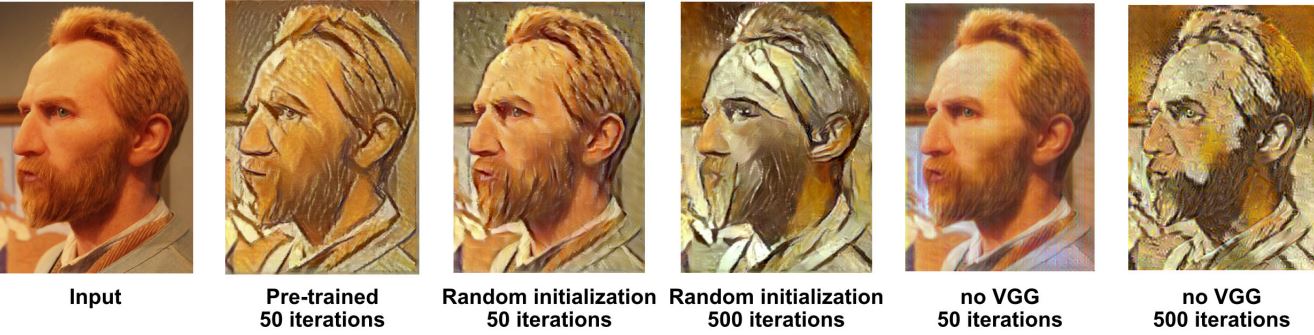
| 설정 | 관찰 |
|---|---|
| 사전학습된 $D$ (이미 얼굴 50장을 전이한 네트워크)로 초기화 | 50 반복만으로 좋은 결과 |
| 무작위 초기화 | 첫 500 반복 후에도 비교할 만한 품질이 나오지 않음 |
| $G$ 를 “입력 특징 → 원본 사진” 오토인코더로 초기화 | VGG-19 역변환 과정을 근사해 전체 적대 네트워크가 더 안정적으로 학습 |
| 사전학습 VGG 없이 픽셀부터 클래스 레이블까지 $D$ 를 처음부터 학습 | 결과가 현저히 나쁨 (Ulyanov et al. 도 같은 관찰) |
저자들의 설명은 VGG-19 의 통계적 힘이 다양한 이미지 집합에 대해 공유 특징 캐스케이드를 구축한 데서 나오며, 제한된 예제로 학습한 네트워크보다 인간 시지각에 더 가깝다는 것입니다. Fig. 7 의 디코더 필터 시각화(one-hot 입력을 직접 디코딩)도 개별 패치가 예제 텍스처와 비슷하되 아주 충실하진 않은 반분산적·비선형 인코딩임을 보여줍니다.
💡 Key Takeaway relu3_1 + 패치 8 이 기본값인 이유, 힌지 손실·사전학습 초기화가 필요한 이유, 그리고 고정된 VGG-19가 방법 전체의 지각적 기반이라는 점이 소거 실험으로 뒷받침됩니다.
결과: 품질 비교와 실시간 성능 (Sec. 5)
최종 모델은 임의로 고른 ImageNet 이미지 100장과 예제 텍스처 한 장으로 학습합니다. 먼저 MDAN으로 전이 이미지 100장을 만들고, 128×128 크롭을 규칙 샘플링해 모델당 약 16k 샘플을 얻습니다. 에포크당 약 12분이 걸리고 텍스처당 최대 5 에포크를 학습하며, 결론에서는 예제당 약 1시간이라고 요약합니다.
🆚 1. 선행 방법과의 질적 비교 (Fig. 11, 12)
| 방법 | 특성 |
|---|---|
| Gatys et al., Ulyanov et al. (전역 통계) | Lena 의 머리카락처럼 복잡한 내용에서 일관성을 잃고, 눈이나 얼굴 전체에 텍스처가 입혀지지 않음. 가우시안에 맞지 않는 특징은 Gram 행렬로 구속하기 어려움 |
| Li & Wand (패치 MRF) | 비모수 샘플링 덕에 가장 일관된 합성이지만 패치 매칭 때문에 384×384 에 110초 |
| MGAN | 머리카락이 일관되게 어두운 텍스처로 매핑되는 등 더 일관된 텍스처 전이, Ulyanov et al. 과 같은 속도 수준 |
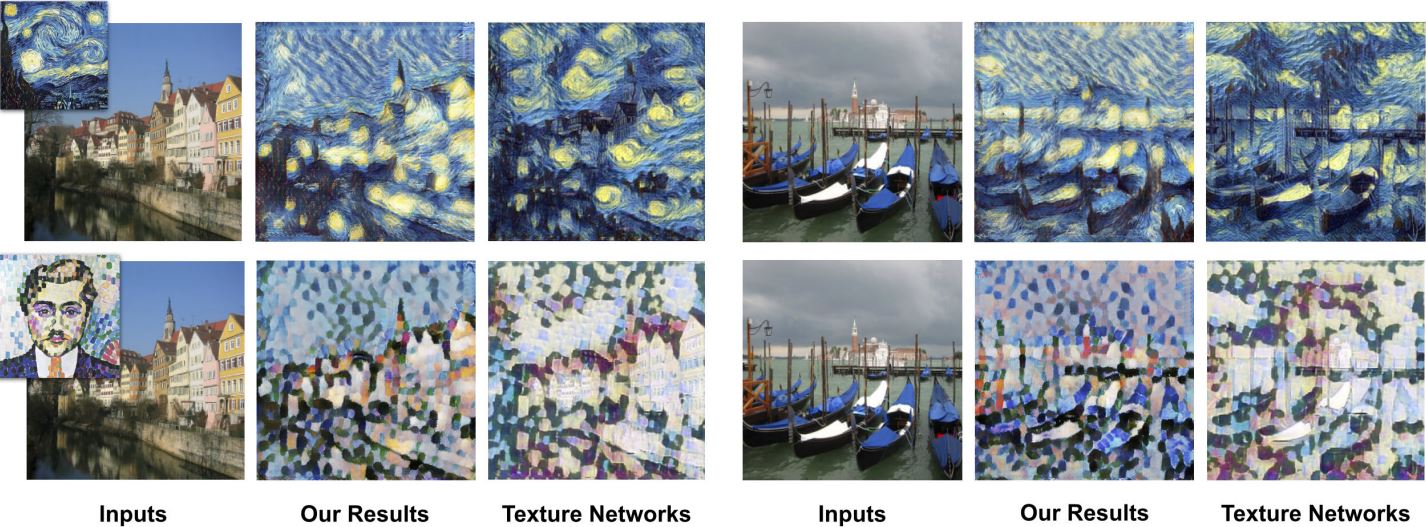
Fig. 12 의 Texture Networks 와의 추가 비교에서는 각자의 강점이 뚜렷합니다. Ulyanov et al. 은 스타일 이미지에 대해 더 충실한 색 분포를 내고 노이즈→가우시안 사상 학습 덕에 배경(별이 빛나는 밤 예시)을 더 잘 텍스처화합니다. 반면 MGAN은 건물 외벽(facade) 같은 복잡한 장면에서 가우시안 모델의 무능력을 겪지 않고 더 일관된 전이를 하며, 비교 대상은 이런 영역에 텍스처를 너무 많거나 적게 넣습니다.
⚡ 2. 속도 (Fig. 15)
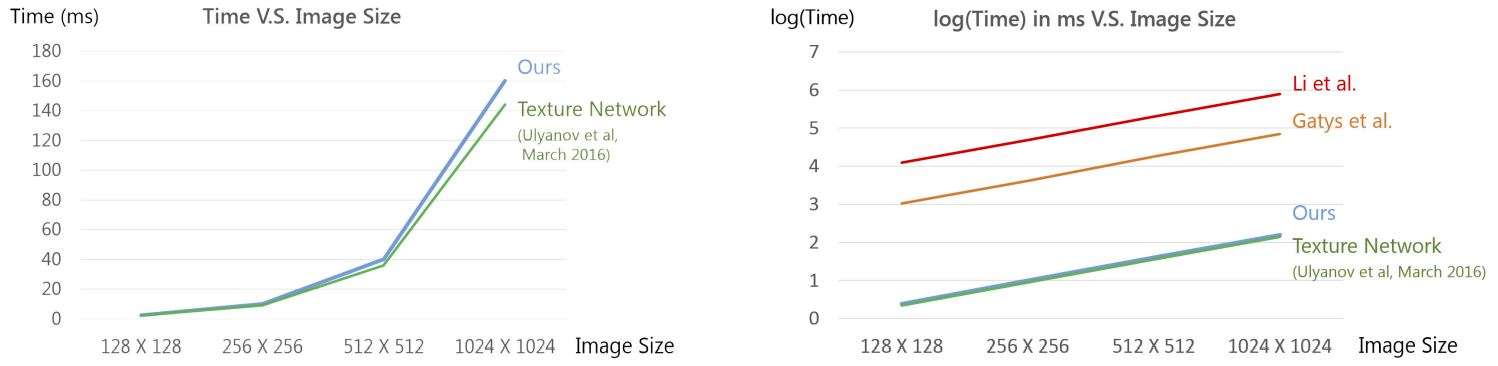
표준 벤치마크 프레임워크로 측정한 결과, 시간 비용은 픽셀 수에 선형으로 비례합니다.
| 출력 크기 | 시간 |
|---|---|
| 256×256 | 10 ms |
| 512×512 | 40 ms (25 Hz) |
| 1024×1024 | 160 ms |
| 비교 대상 | 상대 속도 |
|---|---|
| Ulyanov et al. (피드포워드) | 같은 수준, 상대가 아주 근소하게 앞섬 |
| Gatys et al. (디콘볼루션) | 약 500배 빠름 |
| Li & Wand (패치 매칭) | 약 5000배 빠름 |
전통적인 픽셀 기반 텍스처 합성기(비싼 최근접 탐색에 의존) 대부분보다도 빠르며, 예외는 GPU 구현 PatchMatch 정도인데 그 경우에도 MGAN은 심층 신경망 방법의 품질 이점(더 나은 블렌딩, 불변성)을 제공합니다. 참고로 Sec. 3.2 에서는 MDAN 대비 MGAN의 속도 이득을 25,000배라고 적고 있어, 비교 기준(MDAN 대 Li & Wand)에 따라 배율이 다르게 서술됩니다.
💾 3. 메모리와 응용 (Fig. 13, 14)
생성 모델의 파라미터는 VGG relu4_1 까지 포함해 70 MB 입니다. 런타임 메모리는 이미지 크기에 선형으로 의존해 256×256 에 약 600 MB, 512×512 에 약 2.5 GB 가 필요합니다. 입력을 블록으로 나눠 스캔라인 방식으로 디코딩하면 줄일 수 있지만 논문은 이를 더 탐색하지 않습니다.
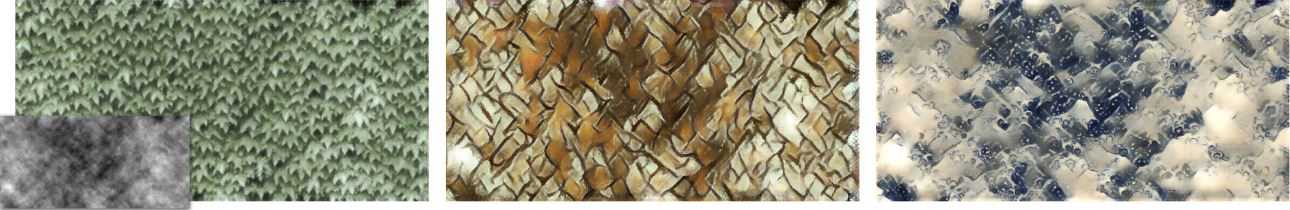
- 비유도 합성 : Perlin 노이즈 이미지를 VGG-19 에 통과시켜 특징 맵을 만들고 디코더에 넣으면, 무작위 ImageNet 이미지로 학습한 모델이 놀랍게도 그럴듯한 텍스처를 디코딩합니다(Fig. 13). 모델의 일반화 능력을 다시 보여주는 결과입니다.
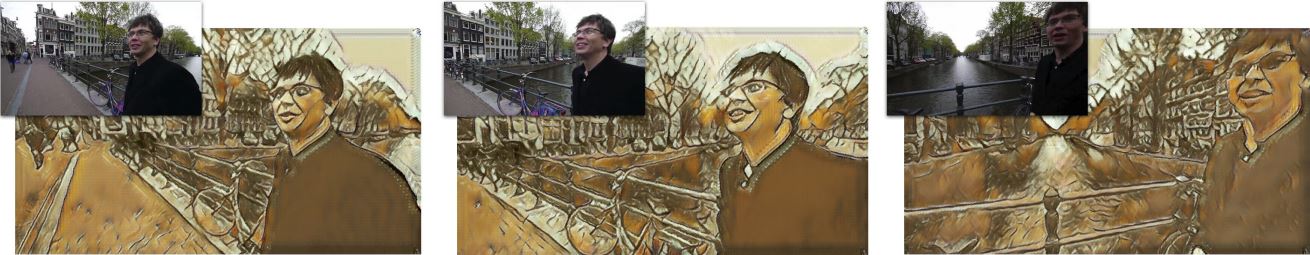
- 비디오 스타일화 : 1080×810 비디오를 8 Hz 로 디코딩했습니다(Fig. 14). 피드포워드 과정이므로 빠를 뿐 아니라 디콘볼루션 방법보다 상대적으로 시간적 일관성도 좋습니다.
💡 Key Takeaway MGAN은 Ulyanov et al. 과 같은 실시간 속도에 도달하면서, 복잡한 내용에 대해서는 더 일관된 패치 수준 전이를 보여줍니다. 대가는 텍스처당 약 1시간의 사전 학습입니다.
한계와 열린 방향
논문은 Sec. 6 에서 방법의 한계를 비교적 솔직하게 정리하고, 결론에서 후속 방향을 제시합니다. 이 한계들은 이후 패치 기반 적대 학습 연구의 출발점이 됩니다.
⚠️ 1. 저자가 밝힌 한계
| 한계 | 원인 | 제안된 방향 |
|---|---|---|
| 비텍스처 데이터에 약함. 두 얼굴 사진 사이의 얼굴 특징 전이에 실패 | 얼굴 특징은 텍스처가 아니라 표정·자세·성별 같은 의미 이해가 필요 | 객체 클래스 학습(DCGAN류)과 결합해 국소 통계를 더 잘 조건화 |
| 사실적 텍스처는 Li & Wand 가 종종 더 나음 | 비모수 샘플링이 데이터 왜곡을 막음 | MGAN은 변형 가능한 텍스처에 더 강하고 훨씬 빠르다는 트레이드오프 |
| 예제의 전역 색 분포에서 벗어날 수 있음 | 전역 특징 분포 대신 국소 패치 사상을 학습 | 내용 이미지가 더 중요한 경우에는 오히려 장점일 수 있음 |
| 하늘·초점 밖 영역 같은 고정적(stationary) 배경에 약함 | VGG-19 의 활성이 약한 영역 | 통계 기반 방법(배경에 강함)과 결합 |
| MGAN은 평탄 영역에 약함 | 반복 최적화가 없음 | RNN 처럼 상태 정보를 가진 구조 |
🔭 2. 결론이 제시한 큰 그림
핵심 통찰은 적대적 생성 네트워크를 마르코프 설정에 적용해 같은 내용의 서로 다른 묘사 사이의 사상을 배울 수 있다는 것입니다. 저자들은 이것이 이미지 생성 모델 학습의 한 걸음일 뿐이라고 보고, 빅데이터 시나리오에서 마르코프 모델뿐 아니라 거친 규모의 구조 모델까지 포함하는 더 넓은 틀을 후속 과제로 꼽습니다. 이미지 배치에 대한 추가 불변성은 더 많은 학습 데이터를 쓸 수 있게 해 더 큰 클래스에 일반화하는 복잡한 디코더를 허용할 것이며, 궁극 목표는 실세계 이미지의 큰 클래스를 직접 디코딩하는 생성 모델입니다.
🔗 3. 후속 연구와의 연결
- 패치 판별기 : “전체 이미지가 아니라 패치를 판별한다”는 발상은 이후 pix2pix 의 PatchGAN 판별기로 이어지며, 논문의 표현을 빌리면 마르코프 가정을 판별기 구조에 심은 것입니다.
- 힌지 손실 : 시그모이드 포화를 피하기 위한 힌지 손실 선택은 이후 Geometric GAN, SAGAN, BigGAN 등 대규모 GAN의 표준 손실 중 하나가 됩니다.
- 텍스처당 1 네트워크의 한계 : 스타일마다 네트워크를 사전 계산해야 하는 제약은 조건부 인스턴스 정규화나 AdaIN 기반의 임의 스타일 전이 연구가 풀고자 한 문제입니다.
💡 Key Takeaway MGAN은 “패치 수준 적대 학습 + 피드포워드 디코더”로 실시간 텍스처 전이를 열었지만, 의미 수준 구조와 전역 통계는 다루지 않습니다. 그 빈자리가 이후 PatchGAN, 임의 스타일 전이, 대규모 GAN 손실 설계로 이어지는 출발점입니다.