 You know maize mean?
Semi-Supervised Learning with Generative Adversarial Networks
0. Summary
기본 정보 : ArXiv,2016.06.05 (ICML 2016 Workshop), Semi-Supervised Learning with Generative Adversarial Networks
연구 배경
GAN(Goodfellow et al., 2014)은 생성기 $G$ 와 판별기 $D$ 를 상충하는 목적으로 동시에 학습시켜, 이후 LAPGAN(Denton et al., 2015)과 DCGAN(Radford et al., 2015)을 거치며 단일 생성기만으로도 좋은 이미지를 만드는 수준에 이르렀다. 그런데 라벨이 조금밖에 없는 데이터셋에서 분류기를 학습하는 준지도(semi-supervised) 문제에 GAN을 쓰는 방법은 아직 정리되지 않은 상태였다. 생성 모델을 준지도 학습에 쓰는 아이디어 자체는 VAE 계열(Kingma et al., 2014)에서 이미 제시되어 있었고, GAN 쪽에서도 CatGAN(Springenberg, 2015)이 관측 데이터와 예측 클래스 분포 사이의 상호정보를 목적함수에 넣는 방식을, DCGAN이 학습이 끝난 $D$ 의 특징(feature)을 뽑아 별도 분류기에 재사용하는 방식을 보여 준 바 있다.
저자는 DCGAN 방식의 두 가지 약점을 지적한다. 첫째, $D$ 의 표현이 분류기 $C$ 를 돕는다는 것은 당연한 일이지만, 거꾸로 좋은 $C$ 가 $D$ 를 도울 수도 있다는 방향은 활용되지 않는다. 예컨대 $C$ 의 출력 엔트로피가 높은 이미지는 $G$ 가 만든 것일 가능성이 크다는 신호가 될 수 있다. 둘째, 사후적으로 $D$ 의 표현을 꺼내 쓰는 방식으로는 $C$ 와 $G$ 를 동시에 학습할 수 없다. $D$ 가 좋아지면 $C$ 가 좋아지고, $C$ 가 좋아지면 $D$ 가 좋아지고, $D$ 가 좋아지면 $G$ 가 좋아지는 세 구성요소 사이의 피드백 루프를 이용하려면 하나의 학습 과정 안에서 셋을 함께 돌려야 한다.
제안 방법
핵심 아이디어는 매우 단순하다. 보통의 GAN 판별기는 “진짜일 확률” 하나를 내는 시그모이드 유닛으로 끝나지만, 이는 [REAL, FAKE] 두 클래스에 대한 소프트맥스와 동치이다. 여기서 REAL을 데이터셋의 실제 클래스 $N$ 개로 쪼개면 $D$ 는 $N+1$ 개의 출력 [CLASS-1, …, CLASS-N, FAKE] 를 갖는 네트워크가 되고, 판별기이자 분류기 역할을 동시에 한다. 논문은 이 네트워크를 D/C 라고 부르고, 전체 모델을 Semi-Supervised GAN(SGAN) 이라 이름 붙였다.
학습은 일반 GAN과 거의 같다. 미니배치의 절반은 실제 데이터에서 뽑아 더 세분화된 라벨(실제 클래스) 을 붙이고, 나머지 절반은 $G$ 의 출력으로 채워 FAKE 라벨을 붙인다. D/C는 주어진 라벨에 대한 음의 로그가능도(NLL)를 최소화하고, $G$ 는 자신의 샘플에 대한 D/C의 NLL을 최대화한다(Algorithm 1). Goodfellow et al. (2014) 3절의 수정된 생성기 목적(non-saturating trick)은 쓰지 않았다.
발견 사실
MNIST에서 DCGAN 유사 구조로 두 가지 실험을 했다. 생성 품질 실험에서는 실제 MNIST 라벨을 쓴 SGAN과 REAL/FAKE 두 라벨만 쓴 SGAN(의미상 일반 GAN과 동일)을 비교했는데, 2 에폭 뒤 SGAN의 샘플이 GAN보다 뚜렷하게 선명했다(Figure 1). 이 경향은 초기화와 네트워크 구조를 바꿔도 유지되는 것처럼 보였으나, 저자 스스로 하이퍼파라미터에 따른 체계적 품질 평가는 어렵다고 인정한다.
분류 성능 실험에서는 $G$ 를 전혀 갱신하지 않는 SGAN을 기준 CNN으로 삼아, 라벨 수를 1000, 100, 50, 25개로 줄여 가며 비교했다(Table 1). 라벨 1000개에서는 두 모델이 사실상 같았고(CNN 0.965, SGAN 0.964), 라벨이 줄어들수록 SGAN의 우위가 커져 100개에서 0.895 대 0.928, 50개에서 0.859 대 0.883, 25개에서 0.750 대 0.802를 기록했다. 즉 훈련 집합을 축소하는 정도에 비례해 SGAN의 이득이 커졌고, 이는 $D$ 와 $C$ 가 가중치를 공유하도록 강제하는 것이 데이터 효율을 높인다는 가설을 뒷받침한다.
핵심 기여
- 생성 모델과 분류기의 동시 학습 : 판별기 출력을 $N+1$ 클래스 소프트맥스로 바꾸는 최소한의 수정만으로, 하나의 네트워크(D/C)가 판별과 분류를 함께 수행하고 $G$, $D$, $C$ 가 한 학습 루프 안에서 서로를 개선하는 구조를 제시했다.
- 제한된 라벨에서의 분류 성능 향상 : 생성 구성요소가 없는 동일 구조 CNN 대비, 라벨이 적을수록 더 큰 정확도 향상을 MNIST에서 보였다(Table 1).
- 생성 샘플 품질 개선과 학습 시간 단축 : 클래스 라벨 정보를 판별기에 넣는 것만으로 같은 에폭 수에서 더 선명한 샘플을 얻었다(Figure 1). 동일 아이디어를 독립적으로 제안하고 훨씬 철저히 검증한 동시대 연구(Salimans et al., 2016)의 존재도 명시했다.
관련 개념
준지도 학습과 생성 모델
준지도 학습(semi-supervised learning) 은 라벨이 있는 데이터가 소수이고 라벨 없는 데이터가 다수인 상황에서, 라벨 없는 데이터까지 활용해 분류기의 성능을 끌어올리는 문제입니다. 생성 모델은 라벨 없이도 데이터 분포 $p(x)$ 의 구조를 배우기 때문에, 그 구조를 분류기와 공유하면 적은 라벨로도 좋은 결정 경계를 찾을 수 있으리라는 기대가 오래전부터 있었습니다.
🧭 1. 2016년 당시의 세 갈래 접근
| 접근 | 대표 연구 | 생성 모델과 분류기의 관계 |
|---|---|---|
| 변분 생성 모델 | Kingma et al. (2014), M1/M2 모델 | 잠재변수 모델 안에 클래스 변수를 포함시켜 함께 추론 |
| 목적함수 수정 GAN | CatGAN (Springenberg, 2015) | 관측 데이터와 예측 클래스 분포 사이의 상호정보를 목적에 추가 |
| 특징 재사용 GAN | DCGAN (Radford et al., 2015) | 학습이 끝난 $D$ 의 중간 특징을 뽑아 별도의 선형 분류기(L2-SVM 등)를 학습 |
SGAN은 세 번째 계열의 연장선에 있지만, “학습 후 특징을 꺼내 쓴다”는 단계를 없애고 분류를 판별기 학습 과정 자체에 집어넣는다는 점이 다릅니다.
🔄 2. 저자가 기대한 피드백 루프
논문 서론은 DCGAN식 특징 재사용의 한계를 두 가지로 정리합니다.
- 한 방향만 활용 : $D \rightarrow C$ 로 표현이 흘러가는 것은 자연스럽지만, $C \rightarrow D$ 방향은 쓰이지 않습니다. 분류기가 확신하지 못하는(출력 엔트로피가 높은) 입력은 가짜일 가능성이 높다는 식의 정보가 버려집니다.
- 동시 학습 불가 : 사후 재사용 방식은 $C$ 와 $G$ 를 동시에 훈련할 수 없습니다. 효율 문제도 있지만, 더 중요한 것은 $D$, $C$, $G$ 세 요소가 서로를 반복적으로 개선하는 루프를 쓸 수 없다는 점입니다.
이 두 문제를 한 번에 푸는 가장 단순한 방법이 “판별기와 분류기를 같은 네트워크로 만드는 것”입니다.
💡 Key Takeaway SGAN의 출발점은 새로운 손실함수가 아니라 “$D$ 의 특징을 나중에 쓰지 말고, $D$ 가 처음부터 분류까지 하게 하자” 는 구조적 선택입니다.
N+1 클래스 판별기 D/C
D/C 는 SGAN의 핵심 구성요소로, 판별기(Discriminator)와 분류기(Classifier)를 하나의 네트워크로 합친 것입니다. 일반 GAN 판별기와의 차이는 출력층뿐입니다.
🎯 1. 시그모이드에서 N+1 소프트맥스로
| 네트워크 | 출력층 | 출력의 의미 |
|---|---|---|
| 일반 GAN의 $D$ | 시그모이드 유닛 1개 | 입력이 데이터 분포에서 왔을 확률 |
| 동치 표현 | 소프트맥스 유닛 2개 [REAL, FAKE] | 위와 같은 정보를 2-클래스로 표현 |
| SGAN의 D/C | 소프트맥스 유닛 $N+1$ 개 [CLASS-1, …, CLASS-N, FAKE] | REAL을 실제 클래스 $N$ 개로 세분화 |
2-클래스 소프트맥스가 시그모이드와 동치라는 관찰이 다리 역할을 합니다. 일단 소프트맥스로 바꾸고 나면 REAL 유닛을 $N$ 개로 쪼개는 것은 자연스러운 확장이고, 그 순간 $D$ 는 $C$ 의 역할까지 맡게 됩니다(논문 2절).
🧮 2. 입력 종류별 라벨과 손실
D/C의 손실은 주어진 라벨에 대한 음의 로그가능도(negative log-likelihood, NLL) 하나뿐입니다. 입력이 어디서 왔는지에 따라 라벨만 달라집니다.
| 입력 출처 | 부여되는 라벨 | D/C가 하는 일 |
|---|---|---|
| 라벨 있는 실제 데이터 $(x, y)$ | 실제 클래스 $y \in {1,\dots,N}$ | 분류 |
| $G(z)$ 의 샘플 | FAKE ($N+1$ 번째 클래스) | 판별 |
D/C의 출력을 $p(y \mid x)$ 라 쓰면, 실제 데이터에 대해서는 $-\log p(y=y_{\text{true}} \mid x)$ 를, 생성 샘플에 대해서는 $-\log p(y=N+1 \mid G(z))$ 를 최소화합니다. 라벨 없는 실제 데이터를 따로 다루는 항은 논문에 명시되어 있지 않으며, Algorithm 1도 “데이터 분포에서 $(x, y)$ 쌍을 뽑는다”고만 적습니다.
🔍 3. 분류 시 FAKE 유닛의 처리
테스트 시 분류 정확도를 계산할 때는 FAKE에 해당하지 않는 $N$ 개 출력 중 최댓값을 예측 클래스로 삼습니다(논문 3.2절). FAKE 출력은 학습 때 판별 신호를 공급하는 역할을 하고, 추론 때는 무시되는 셈입니다.
💡 Key Takeaway D/C는 “진짜냐 가짜냐”를 “몇 번 클래스냐, 아니면 가짜냐”로 바꾼 네트워크입니다. 손실은 여전히 NLL 하나이고, 입력 출처에 따라 라벨만 달라집니다.
SGAN 학습 알고리즘
Algorithm 1 은 SGAN의 학습 절차를 기술합니다. 구조는 원래 GAN의 교대 학습과 같고, 실제 데이터 쪽 라벨의 세분화 정도(granularity) 만 높아졌습니다.
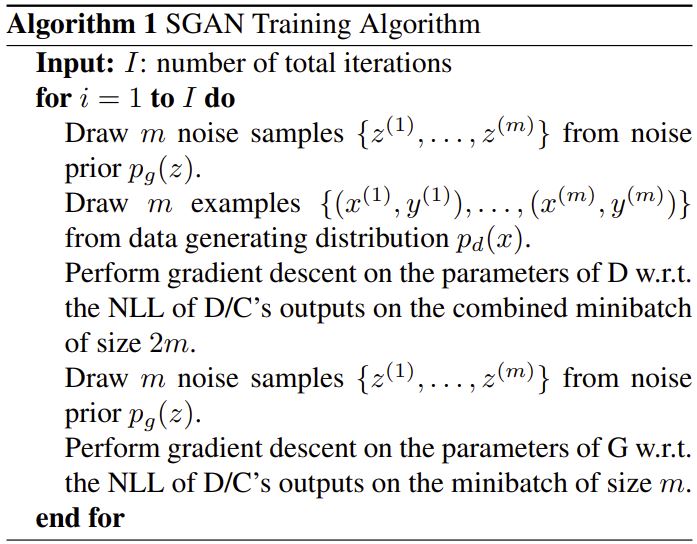
🔁 1. 반복 단위의 다섯 단계 (Algorithm 1)
각 반복 $i = 1, \dots, I$ 에서 다음을 수행합니다.
- 노이즈 사전분포 $p_g(z)$ 에서 노이즈 샘플 $m$ 개를 뽑는다.
- 데이터 분포 $p_d(x)$ 에서 예제 $(x, y)$ 를 $m$ 개 뽑는다.
- 크기 $2m$ 의 결합 미니배치에 대한 D/C 출력의 NLL에 대해, $D$ 의 파라미터를 경사하강으로 갱신한다.
- $p_g(z)$ 에서 새 노이즈 샘플 $m$ 개를 뽑는다.
- 크기 $m$ 의 미니배치에 대한 D/C 출력의 NLL에 대해, $G$ 의 파라미터를 경사하강으로 갱신한다. ($G$ 는 NLL을 최대화하는 방향이므로 부호가 반대입니다.)
⚖️ 2. 원래 GAN과의 대응
| 항목 | GAN (Goodfellow et al., 2014) | SGAN |
|---|---|---|
| 미니배치 구성 | 실제 $m$ 개 + 생성 $m$ 개 | 동일 |
| 실제 데이터의 라벨 | REAL | 실제 클래스 $y$ |
| 생성 데이터의 라벨 | FAKE | FAKE |
| $D$ 의 목적 | 이진 교차엔트로피 최소화 | $N+1$ 클래스 NLL 최소화 |
| $G$ 의 목적 | $D$ 의 손실 최대화 (또는 non-saturating 변형) | D/C의 NLL 최대화 (non-saturating 변형 미사용) |
$G$ 의 목적에 대해 논문은 Goodfellow et al. (2014) 3절의 “수정된 목적 트릭”을 쓰지 않았다고 명시합니다. 즉 $\log(1 - D(G(z)))$ 를 최소화하는 대신 $\log D(G(z))$ 를 최대화하는 non-saturating 손실이 아니라, 원래의 minimax 형태(여기서는 NLL 최대화)를 그대로 썼다는 뜻입니다. 학습 초기 기울기 소실 문제를 피하기 위한 표준 처방을 쓰지 않았다는 점은 결과 해석 시 염두에 둘 만합니다.
🧩 3. 기준 모델의 정의
분류 실험의 기준 CNN은 별도 네트워크가 아니라 $G$ 를 한 번도 갱신하지 않는 SGAN입니다. 따라서 구조, 출력층, 라벨링 방식이 모두 같고, 차이는 “FAKE 샘플이 학습 과정에서 의미 있는 적대적 신호를 주는가”뿐입니다. 이 설계 덕분에 Table 1의 차이를 생성 구성요소의 효과로 비교적 깨끗하게 귀속시킬 수 있습니다. 각 모델은 학습률에 대해 무작위 탐색을 하고 최선의 결과를 보고했습니다.
💡 Key Takeaway SGAN 학습은 GAN 학습에서 실제 데이터의 라벨만 세분화한 것입니다. 추가 손실항도, 추가 네트워크도 없습니다.
실험 설정과 결과
실험은 모두 MNIST에서 수행되었으며, 코드는 DCGAN-tensorflow 구현을 크게 차용한 공개 저장소(DoctorTeeth/supergan)에 있습니다. 네트워크 구조는 Radford et al. (2015)의 DCGAN과 유사하다고만 적혀 있고, 층 구성이나 배치 크기 같은 세부는 논문에 없습니다.
🖼️ 1. 생성 결과 (3.1절, Figure 1)
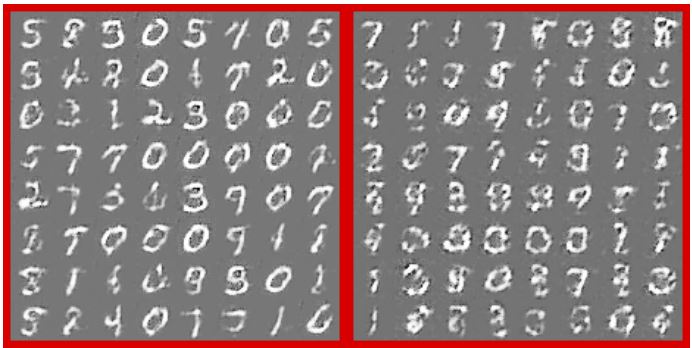
- 비교 대상은 실제 MNIST 라벨을 쓴 SGAN과 REAL/FAKE만 쓴 SGAN입니다. 후자는 의미상 일반 GAN과 동일합니다.
- 2 에폭 학습 후 샘플(왼쪽 SGAN, 오른쪽 GAN)을 보면 SGAN 쪽이 뚜렷하게 선명합니다.
- 이 경향은 서로 다른 초기화와 네트워크 구조에서도 유지되는 것처럼 보였지만, 저자는 다양한 하이퍼파라미터에 걸친 체계적인 샘플 품질 평가는 어렵다고 덧붙입니다. Inception Score나 FID 같은 정량 지표는 사용되지 않았습니다.
같은 에폭에서 더 선명한 샘플이 나온다는 것은 서론에서 주장한 “생성기 학습 시간 단축” 기여의 근거이기도 합니다.
📊 2. 분류 결과 (3.2절, Table 1)
| 라벨 있는 예제 수 | CNN (기준) | SGAN | 차이 |
|---|---|---|---|
| 1000 | 0.965 | 0.964 | $-0.001$ |
| 100 | 0.895 | 0.928 | $+0.033$ |
| 50 | 0.859 | 0.883 | $+0.024$ |
| 25 | 0.750 | 0.802 | $+0.052$ |
- 라벨이 1000개일 때는 두 모델이 사실상 같습니다.
- 라벨이 100개 이하로 줄면 SGAN이 일관되게 앞서고, 25개에서 차이가 가장 큽니다.
- 저자는 이를 “훈련 집합을 줄이는 정도에 비례해 SGAN이 기준선을 능가한다”고 요약하며, $D$ 와 $C$ 가 가중치를 공유하도록 강제하는 것이 데이터 효율을 높인다는 해석을 제시합니다.
🧪 3. 실험 설계에서 읽을 점
- 단일 데이터셋, 단일 구조 : MNIST 외 데이터셋이나 다른 구조에 대한 결과는 없습니다.
- 분산 미보고 : 여러 시드에 대한 평균이나 표준편차가 없어, 특히 라벨 25개 설정처럼 분산이 클 수 있는 조건에서의 통계적 신뢰도는 판단하기 어렵습니다.
- 라벨 없는 실제 데이터의 역할 : 표의 “예제 수”는 라벨 있는 예제 수이며, 생성 샘플이 사실상 라벨 없는 데이터의 역할을 합니다. 라벨 없는 실제 MNIST 이미지를 별도로 투입했는지는 명시되지 않았습니다.
💡 Key Takeaway SGAN의 실증적 메시지는 “라벨이 적을수록 적대적 학습의 이득이 크다” 는 한 줄입니다. 다만 MNIST 한 곳에서, 분산 없이 보고된 결과라는 점에서 예비 연구의 성격이 강합니다.
동시대 연구와의 관계: Improved GAN의 K+1 클래스 정식화
논문은 2절 말미에 Salimans et al. (2016), “Improved Techniques for Training GANs” 가 동시 연구로서 같은 방법을 제안하고 훨씬 철저한 실험 평가를 수행했다고 밝힙니다. 두 논문을 나란히 놓으면 SGAN이 직관적으로 제시한 것이 어떤 수학적 구조를 갖는지가 드러납니다. 아래 내용은 Improved GAN 논문(arXiv 1606.03498) 5절에 근거한 배경 설명이며, SGAN 논문 자체의 주장이 아닙니다.
📐 1. K+1 클래스 손실의 분해
$K$ 클래스 분류기에 “생성됨”을 뜻하는 $K+1$ 번째 출력을 추가하고 소프트맥스 출력을 $p_{\text{model}}(y \mid x)$ 라 하면, 손실은 지도 항과 비지도 항으로 나뉩니다.
\[L = L_{\text{supervised}} + L_{\text{unsupervised}}\] \[L_{\text{supervised}} = -\mathbb{E}_{x,y \sim p_{\text{data}}}\left[\log p_{\text{model}}(y \mid x,\ y < K+1)\right]\] \[L_{\text{unsupervised}} = -\left\{\mathbb{E}_{x \sim p_{\text{data}}}\left[\log\big(1 - p_{\text{model}}(y = K+1 \mid x)\big)\right] + \mathbb{E}_{x \sim G}\left[\log p_{\text{model}}(y = K+1 \mid x)\right]\right\}\]여기서 $D(x) = 1 - p_{\text{model}}(y = K+1 \mid x)$ 로 치환하면 $L_{\text{unsupervised}}$ 는 표준 GAN의 판별기 목적과 정확히 같아집니다. 즉 SGAN의 “N+1 소프트맥스 NLL”은 지도 분류 손실과 GAN 판별 손실의 합으로 해석할 수 있습니다.
🔢 2. 과잉 매개변수화와 로짓 고정
$K+1$ 개 로짓 모두에서 같은 함수 $f(x)$ 를 빼도 소프트맥스는 변하지 않으므로, 이 분류기는 과잉 매개변수화되어 있습니다. $l_{K+1}(x) = 0$ 으로 고정하면
\[D(x) = \frac{Z(x)}{Z(x) + 1},\qquad Z(x) = \sum_{k=1}^{K} \exp\big(l_k(x)\big)\]가 되어, 판별기 출력이 실제 클래스 로짓들의 합으로 결정됩니다. SGAN 서론에서 “분류기 출력의 엔트로피가 높은 입력은 가짜일 가능성이 높다”고 한 직관이 이 식에 수학적으로 담겨 있습니다. 실제 클래스 어느 쪽에도 큰 로짓을 주지 못하는 입력은 $Z(x)$ 가 작아 가짜로 판정됩니다.
🧲 3. 생성기 목적의 선택
Improved GAN은 준지도 학습에서 $G$ 를 특징 매칭(feature matching) 으로 학습하는 것이 매우 잘 작동하고, 미니배치 판별(minibatch discrimination)을 쓴 $G$ 는 전혀 작동하지 않는다고 보고합니다. 특징 매칭은 $D$ 중간층의 특징 통계를 실제 데이터와 맞추는 목적으로, 샘플 품질은 다소 떨어지지만 분류기에는 더 유용한 샘플을 만듭니다. 이는 “좋은 샘플”과 “분류에 도움이 되는 샘플”이 다를 수 있다는 점을 시사하며, 원래 minimax 목적을 그대로 쓴 SGAN과 대비됩니다.
| 항목 | SGAN (Odena, 2016) | Improved GAN (Salimans et al., 2016) |
|---|---|---|
| 판별기 출력 | $N+1$ 소프트맥스 | $K+1$ 소프트맥스 (동일) |
| 손실 해석 | NLL 하나로 기술 | 지도 + 비지도(GAN) 항으로 분해 |
| 생성기 목적 | 원래 minimax (NLL 최대화) | 특징 매칭 |
| 데이터셋 | MNIST | MNIST, SVHN, CIFAR-10 |
| MNIST 100 라벨 | 정확도 0.928 | 오류 93 ± 6.5개 (단일 모델) |
위 표의 두 MNIST 수치는 지표가 다르므로(정확도 대 오류 개수) 직접 비교할 수 없으며, 평가 프로토콜도 다릅니다.
💡 Key Takeaway SGAN이 “D의 출력을 N+1개로 늘리자”고 제안한 것을 Improved GAN은 지도 손실 + GAN 손실의 합으로 풀어 보였습니다. 같은 구조지만, 생성기 목적을 무엇으로 두느냐가 준지도 성능을 크게 좌우합니다.
왜 가중치 공유가 데이터 효율을 높이는가
SGAN 논문은 결과의 원인을 “$D$ 와 $C$ 가 가중치를 공유하도록 강제했기 때문”이라고만 설명합니다. 이 절에서는 그 주장을 뒷받침할 수 있는 일반적인 해석을 정리합니다. 아래는 논문의 실험으로 직접 검증된 내용이 아닌 해석적 배경입니다.
🧱 1. 판별 과제가 제공하는 표현 학습 신호
라벨이 25개뿐인 분류 문제에서 CNN은 과적합하기 쉽습니다. 반면 판별 과제는 라벨 없이도 매 반복마다 신호를 공급합니다. 생성 샘플과 실제 샘플을 구분하려면 획의 두께, 곡률, 배경의 균일성 같은 저수준 특징부터 숫자의 전역 구조까지 배워야 하고, 이 특징은 분류에도 재사용됩니다. DCGAN이 보인 “$D$ 의 특징이 좋은 분류 특징이 된다”는 사실이, SGAN에서는 학습 중에 실시간으로 작용합니다.
🔄 2. 적대적 신호의 비정상성이 주는 정규화 효과
$G$ 는 학습 내내 바뀌므로 FAKE 클래스의 분포도 계속 바뀝니다. D/C는 고정된 소수의 라벨 예제만이 아니라 끊임없이 이동하는 음성 예제에 대해서도 올바르게 반응해야 하므로, 소수 라벨 예제를 외우는 식의 해는 불안정해집니다. 이는 일종의 데이터 증강 또는 정규화로 볼 수 있으며, 라벨이 적을수록 그 상대적 효과가 커지는 Table 1의 패턴과 부합합니다.
🧭 3. 라벨 1000개에서 이득이 사라지는 이유
라벨이 충분하면 지도 신호만으로도 좋은 특징을 배울 수 있어 적대적 신호의 추가 가치가 줄어듭니다. 또한 FAKE 클래스 학습은 분류와 용량을 나눠 쓰는 비용을 수반하므로, 지도 데이터가 많을수록 이 비용이 이득을 상쇄할 수 있습니다. 논문 결론에서 “D와 C 사이에 가중치의 일부만 공유”하는 변형을 제안한 것도 바로 이 긴장 관계를 인식했기 때문으로 읽힙니다.
💡 Key Takeaway 판별 과제는 라벨 없는 표현 학습 신호를, 움직이는 생성기는 정규화 효과를 제공합니다. 둘 다 라벨이 희소할수록 가치가 커집니다.
한계와 열린 방향
SGAN은 ICML 2016 워크숍 논문답게 아이디어를 간결하게 제시하고 최소한의 실험으로 뒷받침하는 데 집중했습니다. 그만큼 한계도 분명하고, 저자 스스로 여러 후속 방향을 열어 두었습니다.
⚠️ 1. 실험적 한계
| 한계 | 내용 |
|---|---|
| 데이터셋 | MNIST 단일. SVHN, CIFAR-10 등 더 어려운 분포에서의 검증 없음 |
| 정량 지표 | 생성 품질은 Figure 1의 육안 비교만 존재 |
| 통계적 신뢰도 | 시드별 분산 미보고. 라벨 25개 조건은 특히 분산이 클 수 있음 |
| 구조 세부 | “DCGAN과 유사”라고만 기술, 재현에 필요한 세부는 코드 저장소에 위임 |
| 생성기 목적 | non-saturating 트릭 미사용. 더 큰 문제에서 학습 안정성은 미확인 |
이 한계의 상당 부분은 같은 달 공개된 Improved GAN이 더 큰 데이터셋, 특징 매칭 생성기, 반복 실험으로 보완했습니다.
🔭 2. 저자가 제안한 후속 방향 (4절)
- 부분 가중치 공유 : dual autoencoder(Sutskever et al., 2015)처럼 $D$ 와 $C$ 가 가중치의 일부만 공유하게 하여, 일부는 판별에, 일부는 분류에 특화시키는 방안입니다.
- 클래스 조건부 생성과 2N 라벨 : 조건부 GAN(Mirza & Osindero, 2014)처럼 $G$ 가 클래스 라벨을 받아 생성하게 한 뒤, D/C가 [REAL-ZERO, FAKE-ZERO, …, REAL-NINE, FAKE-NINE]의 $2N$ 개 라벨 중 하나를 할당하도록 하는 방안입니다. 이 방향은 이후 같은 저자의 AC-GAN(Odena et al., 2017)으로 이어지는 것으로 볼 수 있습니다.
- 사다리 네트워크와의 결합 : D/C 자리에 사다리 네트워크(Rasmus et al., 2015) $L$ 을 두고, $G$ 의 샘플을 라벨 없는 데이터로 삼아 $L$ 을 학습시키는 방안입니다.
🌱 3. 이후 연구에서의 위치
N+1 클래스 판별기는 이후 GAN 기반 준지도 학습의 표준 출발점이 되었습니다. Improved GAN이 손실 분해와 특징 매칭으로 이를 정교화했고, 이후 연구들은 “좋은 준지도 분류기에는 오히려 나쁜(bad) 생성기가 필요하다”는 관찰이나, 생성 샘플이 결정 경계 근처의 저밀도 영역을 채우는 역할에 주목하는 분석으로 나아갔습니다. SGAN이 서론에서 제기한 “세 구성요소의 피드백 루프”라는 질문은, 생성 품질과 분류 성능이 반드시 같은 방향으로 움직이지는 않는다는 형태로 답이 다듬어졌다고 볼 수 있습니다.
💡 Key Takeaway SGAN은 최소한의 수정으로 GAN을 준지도 분류기로 바꾼 출발점입니다. 검증은 MNIST에 그쳤지만, 여기서 제안된 N+1 클래스 구조와 2N 라벨 아이디어는 Improved GAN과 AC-GAN 등 후속 연구의 뼈대가 되었습니다.