 You know maize mean?
Progressive Growing of GANs for Improved Quality, Stability, and Variation
0. Summary
기본 정보 : ArXiv,2017.10.27 (ICLR 2018), Progressive Growing of GANs for Improved Quality, Stability, and Variation
연구 배경
2017년 시점의 GAN은 선명한 이미지를 만들 수 있었지만 해상도가 낮고, 다양성이 제한적이며, 학습이 불안정하다는 세 가지 약점을 안고 있었다. 자기회귀 모델(PixelCNN)은 선명하지만 느리고 잠재 표현이 없으며, VAE는 학습이 쉽지만 흐릿하다. 특히 고해상도 생성이 어려운 이유는 두 가지다. 첫째, 해상도가 높아질수록 판별기가 생성 이미지를 구별하기 쉬워져 생성 분포와 학습 분포가 겹치지 않게 되고, 그 결과 기울기가 거의 무작위 방향을 가리키게 된다(Arjovsky & Bottou, 2017). 둘째, 큰 해상도는 메모리 제약 때문에 작은 미니배치를 강제하고, 이는 학습 안정성을 다시 해친다. 기존의 계층적 GAN(LAPGAN, StackGAN 등)은 피라미드의 각 단계마다 별도의 GAN을 두는 방식으로 이 문제를 우회했지만, 하나의 네트워크로 메가픽셀 이미지를 안정적으로 만드는 방법은 없었다.
제안 방법
핵심 아이디어는 생성기와 판별기를 점진적으로 성장(progressive growing) 시키는 것이다. 두 네트워크를 $4\times4$ 해상도에서 시작해 학습이 진행됨에 따라 해상도를 두 배씩 높이는 층을 양쪽에 동기적으로 추가한다. 새 층은 잔차 블록처럼 취급하며 가중치 $\alpha$ 를 0에서 1로 선형 증가시켜 부드럽게 페이드인(fade-in)한다(Figure 2). 이로써 네트워크는 먼저 대규모 구조를 배운 뒤 점점 더 작은 규모의 세부로 주의를 옮기며, 사실상 암묵적 커리큘럼 학습이 된다. 여기에 학습 가능한 파라미터가 전혀 없는 세 가지 보조 기법을 더한다. 다양성을 높이는 미니배치 표준편차(minibatch standard deviation) 층, 층마다 학습 속도를 맞추는 균등 학습률(equalized learning rate), 생성기의 신호 크기 폭주를 막는 픽셀 단위 특징 벡터 정규화(pixelwise feature vector normalization) 다. 마지막으로 품질과 다양성을 동시에 재는 새 평가 지표 슬라이스 바서슈타인 거리(sliced Wasserstein distance, SWD) 를 제안하고, $1024\times1024$ 실험을 위해 CelebA-HQ 데이터셋(30,000장)을 새로 구축했다.
발견 사실
CelebA $128\times128$ 절제 실험(Table 1)에서 기본 WGAN-GP 설정의 평균 SWD $9.28$ 이 점진적 성장만 켜도 $4.28$ 로 떨어졌고, 미니배치를 64에서 16으로 줄이면 $46.23$ 으로 붕괴하던 것이 하이퍼파라미터 조정·미니배치 표준편차·균등 학습률·픽셀 정규화를 누적 적용하면서 $3.56$ 까지 회복되었으며, 완전 수렴 모델(h)은 $2.96$ 을 기록했다. 같은 실험에서 MS-SSIM은 (a)와 (h) 사이에 거의 변하지 않아 학습 분포와의 유사성을 반영하지 못함이 드러났고, Salimans et al.의 미니배치 판별(e*)은 어떤 지표도 개선하지 못한 반면 제안한 미니배치 표준편차(e)는 평균 SWD를 개선했다. 점진적 성장은 수렴점을 눈에 띄게 개선하면서 $128\times128$ 에서 총 학습 시간을 약 절반으로, $1024\times1024$ 에서는 96시간에 약 640만 장을 보여 주어 비점진 방식(외삽 약 520시간) 대비 약 5.4배 빨랐다(Figure 4). CelebA-HQ에서 8장의 Tesla V100으로 4일 학습해 $1024\times1024$ 얼굴을 생성했고(FID 7.30, 50K 이미지 기준), LSGAN 손실로도 같은 해상도를 안정적으로 학습했으며, CIFAR-10 비지도 설정에서 Inception Score 8.80(10회 평균 8.56)으로 당시 최고 기록(7.90)을 경신했다. LSUN 30개 카테고리에서 $256\times256$ 결과도 제시했다.
핵심 기여
- 점진적 성장 학습법 : 단일 GAN의 두 네트워크에 해상도별 층을 순차적으로 페이드인하여 메가픽셀 해상도를 안정적으로 학습하고, 대부분의 반복을 저해상도에서 수행해 해상도에 따라 2~6배의 학습 속도 향상을 얻었다.
- 파라미터 없는 안정화 기법 세 가지 : 미니배치 표준편차 층(다양성), 균등 학습률(층별 동적 범위 균일화), 픽셀 단위 특징 정규화(신호 크기 폭주 억제). 모두 학습 가능한 파라미터와 새 하이퍼파라미터가 없다.
- 평가 지표와 데이터셋 : 라플라시안 피라미드 패치 분포의 슬라이스 바서슈타인 거리로 품질과 다양성을 스케일별로 측정하는 SWD를 제안하고, MS-SSIM의 한계를 실증했으며, CelebA-HQ(30,000장, $1024\times1024$)를 공개해 고해상도 GAN 연구의 벤치마크를 열었다.
관련 개념
점진적 성장(Progressive Growing)과 페이드인
점진적 성장(progressive growing) 은 GAN의 생성기(G)와 판별기(D)를 처음부터 완전한 깊이로 두지 않고, $4\times4$ 해상도의 얕은 네트워크에서 시작해 학습 도중에 더 높은 해상도를 다루는 층을 하나씩 덧붙여 나가는 학습 방법론입니다. 잠재 벡터에서 $1024\times1024$ 이미지로 가는 복잡한 사상을 한 번에 배우는 대신, “조금 더 큰 이미지”라는 훨씬 쉬운 질문을 계속 던지는 셈입니다.
🌱 1. 기본 구조 (Section 2, Figure 1)
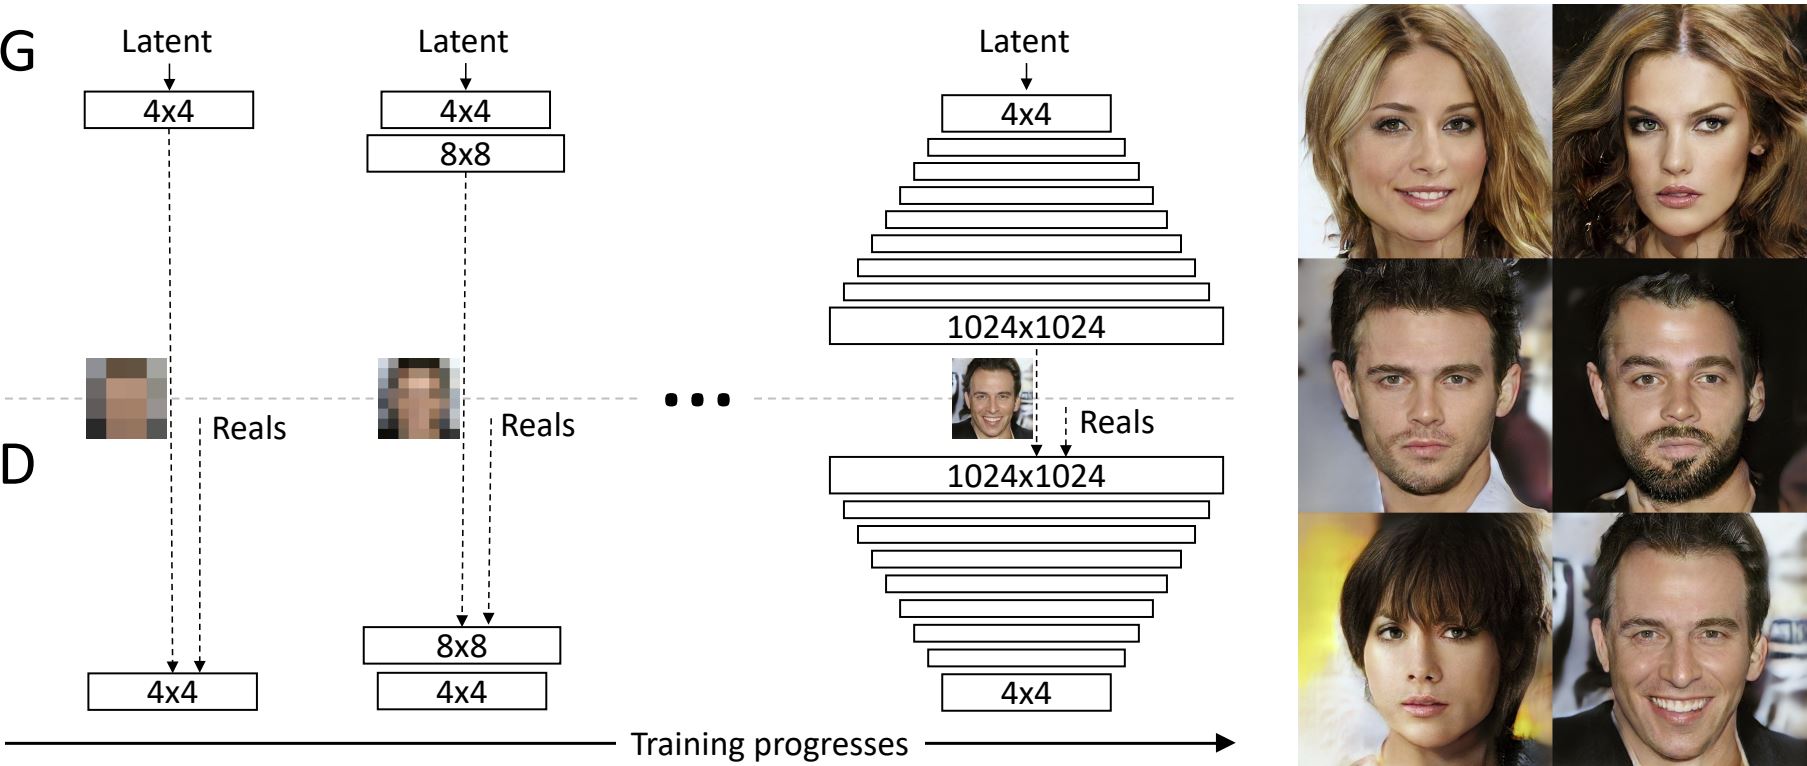
| 항목 | 내용 |
|---|---|
| 시작 해상도 | G와 D 모두 $4\times4$ |
| 성장 방식 | 해상도를 두 배로 올리는 층 블록을 G와 D에 동기적으로 추가 |
| 네트워크 관계 | G와 D는 서로의 거울상(mirror image) |
| 기존 층 | 학습 내내 모두 학습 가능 상태로 유지(고정하지 않음) |
| 효과 | 대규모 구조를 먼저 발견한 뒤 점점 더 미세한 세부로 주의 이동 |
저해상도에서는 클래스 정보와 모드 수가 적어 생성이 훨씬 안정적입니다(Odena et al., 2017). 논문은 이 방식이 WGAN-GP 손실뿐 아니라 LSGAN 손실로도 메가픽셀 이미지를 안정적으로 합성할 만큼 학습을 안정화한다고 보고합니다.
🔀 2. 새 층을 부드럽게 끼워 넣는 페이드인 (Figure 2)
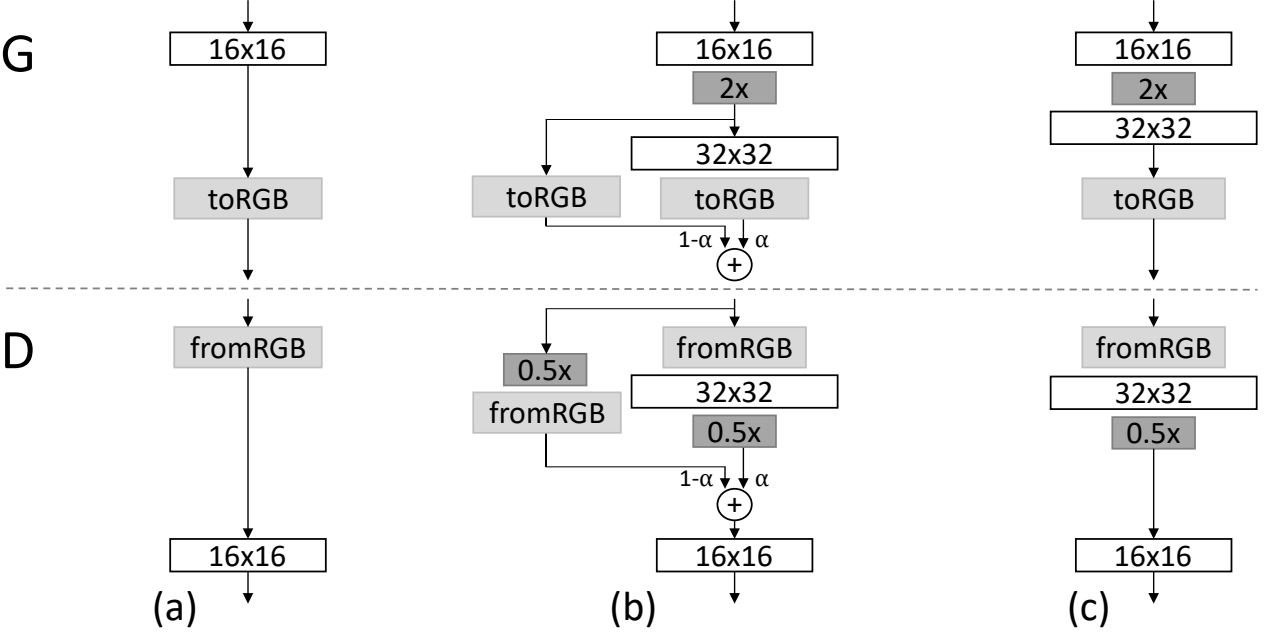
새 층을 갑자기 추가하면 이미 잘 학습된 저해상도 층이 충격을 받습니다. 그래서 $16\times16$ 에서 $32\times32$ 로 전환할 때 새 층을 잔차 블록처럼 취급하고, 그 가중치 $\alpha$ 를 0에서 1까지 선형으로 올립니다. 생성기 출력은 개념적으로
\[\text{out}=(1-\alpha)\cdot\text{Upsample}_{2\times}\big(\text{toRGB}_{16}(h_{16})\big)+\alpha\cdot\text{toRGB}_{32}\big(\text{Block}_{32}(h_{16})\big)\]의 형태가 되며, 판별기에서도 fromRGB를 거친 두 경로를 같은 $\alpha$ 로 섞습니다.
| 구성 요소 | 역할 |
|---|---|
| $2\times$ | 최근접 이웃(nearest neighbor) 업샘플링 |
| $0.5\times$ | 평균 풀링(average pooling) 다운샘플링 |
| toRGB | 특징 벡터를 RGB로 투영하는 $1\times1$ 합성곱 |
| fromRGB | RGB를 특징 벡터로 되돌리는 $1\times1$ 합성곱 |
| 실제 이미지 | 현재 해상도에 맞게 다운스케일해서 D에 입력. 전환 중에는 두 해상도의 실제 이미지도 같은 방식으로 보간 |
🧩 3. 관련 연구와의 차이
| 접근 | 방식 | ProGAN과의 차이 |
|---|---|---|
| 계층적 GAN (Denton 2015, Huang 2016, Zhang 2017) | 이미지 피라미드의 각 레벨마다 G/D 한 쌍 | ProGAN은 단일 GAN 하나만 사용 |
| 다중 판별기 (Wang 2017, Durugkar 2016) | 해상도별 여러 판별기 동시 운용 | ProGAN은 하나의 D가 성장 |
| 성장형 네트워크 (growing neural gas, NEAT) | 탐욕적으로 구조를 늘림 | ProGAN은 미리 설정된 층의 도입을 미룰 뿐 |
| 오토인코더의 층별 학습 (Bengio 2007) | 층을 순차적으로 학습 | 개념적으로 가장 유사 |
💡 Key Takeaway 점진적 성장은 네트워크 구조가 아니라 학습 일정에 대한 제안입니다. 저해상도에서 대규모 구조를 먼저 수렴시키고, 새 층은 $\alpha$ 페이드인으로 충격 없이 붙이는 것이 안정성과 속도 두 마리 토끼를 잡는 열쇠입니다.
미니배치 표준편차(Minibatch Standard Deviation)
미니배치 표준편차 층은 GAN이 학습 데이터 다양성의 일부만 포착하는 문제(모드 붕괴)를 완화하기 위해 판별기에 추가하는 층입니다. Salimans et al.(2016)의 미니배치 판별(minibatch discrimination)을 학습 파라미터도 하이퍼파라미터도 없는 형태로 극단적으로 단순화한 것입니다.
📊 1. 미니배치 판별과의 비교 (Section 3)
| 항목 | 미니배치 판별 (Salimans et al., 2016) | 미니배치 표준편차 (본 논문) |
|---|---|---|
| 아이디어 | 개별 이미지뿐 아니라 미니배치 전체의 특징 통계를 D가 보게 함 | 동일 |
| 구현 | 입력 활성을 통계 배열로 투영하는 큰 텐서를 학습 | 학습 파라미터 없음 |
| 출력 | 샘플마다 별도의 통계 집합을 출력에 연결 | 미니배치 전체에 대해 상수 특징 맵 1장 추가 |
| 결과 (Table 1) | (e*) 어떤 지표도 개선 못 함 | (e) 평균 SWD 개선 |
🧮 2. 계산 절차
- 미니배치 전체에 걸쳐 각 공간 위치의 각 특징에 대해 표준편차를 계산합니다.
- 이 추정값을 모든 특징과 공간 위치에 대해 평균해 스칼라 하나로 만듭니다.
- 그 값을 복제해 모든 공간 위치와 미니배치 전체에 이어 붙여, 추가 (상수) 특징 맵 한 장을 만듭니다.
이 층은 판별기 어디에나 넣을 수 있지만, 논문은 끝부분($4\times4$ 해상도 블록, Appendix A.1)에 넣는 것이 가장 좋았다고 보고합니다. 더 풍부한 통계량도 실험했지만 다양성을 더 개선하지는 못했습니다.
🔁 3. 다른 다양성 해법과의 관계
판별기 언롤링(Metz et al., 2016), EBGAN의 반발 정규화기(repelling regularizer, Zhao et al., 2017), 다중 생성기(Ghosh et al., 2017) 같은 대안들이 있습니다. 논문은 이들이 자신들의 방법보다 다양성을 더 높일 수도 있고 직교적일 수도 있다고 인정하며, 자세한 비교는 후속 과제로 남깁니다.
💡 Key Takeaway 생성 이미지 미니배치의 “퍼짐 정도”를 숫자 하나로 요약해 판별기에 보여 주기만 해도, 생성기는 미니배치 통계가 실제 데이터와 비슷해지도록 압박을 받습니다. 가장 단순한 형태가 학습형 변형보다 잘 작동했다는 점이 인상적입니다.
균등 학습률(Equalized Learning Rate)
균등 학습률은 신중한 가중치 초기화 대신 모든 가중치를 $\mathcal{N}(0,1)$ 로 초기화하고, 실행 시점에 층별 상수로 가중치를 나누어 쓰는 기법입니다. 생성기와 판별기 사이의 불건전한 경쟁으로 신호 크기가 폭주하는 문제를 다루는 두 가지 재료 중 첫 번째이며, 학습 가능한 파라미터는 없습니다.
⚖️ 1. 정의 (Section 4.1)
\[\hat{w}_i=\frac{w_i}{c}\]여기서 $w_i$ 는 가중치, $c$ 는 He 초기화(He et al., 2015)의 층별 정규화 상수입니다. 보통은 초기화 때 한 번만 $c$ 를 곱해 두지만, ProGAN은 순전파마다 동적으로 나눕니다.
🔍 2. 왜 초기화가 아니라 실행 시점인가
이점은 RMSProp과 Adam 같은 적응형 확률적 경사하강법의 스케일 불변성과 관련이 있습니다.
| 상황 | 결과 |
|---|---|
| 적응형 옵티마이저는 기울기 갱신을 추정 표준편차로 정규화 | 갱신 크기가 파라미터의 스케일과 무관해짐 |
| 어떤 파라미터의 동적 범위가 다른 것보다 크면 | 그 파라미터는 조정에 더 오래 걸림 |
| 현대적 초기화는 층마다 다른 스케일을 만들어냄 | 하나의 학습률이 동시에 너무 크고 너무 작을 수 있음 |
| 균등 학습률 적용 시 | 모든 가중치의 동적 범위와 학습 속도가 동일해짐 |
van Laarhoven(2017)도 독립적으로 비슷한 논리를 사용했습니다. Table 1에서 이 기법(f)을 켜면 CelebA 평균 SWD가 $7.04$ 에서 $4.39$ 로, LSUN은 $6.48$ 에서 $4.02$ 로 크게 떨어집니다.
💡 Key Takeaway Adam은 “기울기 크기”를 균등화하지만 “파라미터 크기”는 보지 않습니다. 가중치의 스케일을 실행 시점에 명시적으로 맞춰 주면 모든 층이 같은 속도로 배우게 됩니다.
픽셀 단위 특징 벡터 정규화(Pixelwise Feature Vector Normalization)
픽셀 단위 특징 벡터 정규화는 생성기의 각 합성곱 층 뒤에서 픽셀마다 특징 벡터를 단위 길이로 정규화하는 기법입니다. 기존 GAN들이 배치 정규화 계열로 억제하던 신호 크기 폭주를, 공변량 이동 제거가 아니라 “크기 제약” 자체를 목표로 삼아 직접 막습니다.
📐 1. 수식 (Section 4.2)
Krizhevsky et al.(2012)의 국소 응답 정규화(local response normalization)를 변형한 형태입니다.
\[b_{x,y}=\frac{a_{x,y}}{\sqrt{\dfrac{1}{N}\sum_{j=0}^{N-1}\big(a^{j}_{x,y}\big)^{2}+\epsilon}},\qquad \epsilon=10^{-8}\]| 기호 | 의미 |
|---|---|
| $N$ | 특징 맵 수 |
| $a_{x,y}$ | 픽셀 $(x,y)$ 의 원래 특징 벡터 |
| $b_{x,y}$ | 정규화된 특징 벡터 |
🛡️ 2. 배치 정규화와 무엇이 다른가
| 항목 | 배치 정규화 계열 | 픽셀 단위 정규화 |
|---|---|---|
| 원래 목적 | 공변량 이동(covariate shift) 제거 | 신호 크기와 경쟁의 제약 |
| 학습 파라미터 | 있음(스케일·시프트) | 없음 |
| 통계의 범위 | 미니배치 또는 층 전체 | 픽셀 하나의 채널 방향 |
| 미니배치 크기 의존 | 있음 | 없음 (고해상도의 작은 배치에 유리) |
논문은 GAN에서 공변량 이동이 문제라는 증거를 관찰하지 못했다고 말합니다. 진짜 필요한 것은 두 네트워크의 경쟁으로 크기가 나선형으로 커지는 것을 막는 일이라는 진단입니다.
🤔 3. 효과
이 강한 제약이 생성기를 해치지 않는다는 점이 놀랍다고 논문은 적습니다. 대부분의 데이터셋에서 결과를 크게 바꾸지는 않지만, 필요할 때 신호 크기 폭주를 매우 효과적으로 막아 줍니다. 논문은 모드 붕괴가 보통 판별기가 과도하게 반응해 과장된 기울기를 만들고, 이어 양쪽 신호 크기가 함께 커지는 식으로 십여 개 미니배치 만에 급속히 일어난다고 관찰했으며, 이 정규화는 생성기가 그 에스컬레이션에 참여하지 못하게 하는 장치입니다. Table 1에서 (g)는 CelebA 평균 SWD를 $4.39$ 에서 $3.56$ 으로 낮췄습니다.
💡 Key Takeaway ProGAN은 “정규화 = 공변량 이동 제거”라는 통념을 거부하고, GAN에 진짜 필요한 것은 크기 제약이라고 봅니다. 픽셀마다 특징 벡터를 단위 구에 올리는 단순한 장치가 그 역할을 합니다.
슬라이스 바서슈타인 거리(Sliced Wasserstein Distance)를 이용한 다중 스케일 평가
슬라이스 바서슈타인 거리(SWD) 기반 평가는 “좋은 생성기는 모든 스케일에서 학습 데이터와 비슷한 국소 이미지 구조를 만든다”는 직관을 수치화한 지표입니다. 기존의 MS-SSIM은 대규모 모드 붕괴는 잘 잡지만 색·질감의 다양성 손실 같은 작은 효과에는 반응하지 않고, 학습 데이터와의 유사성도 직접 재지 않는다는 한계가 있었습니다.
🔬 1. 계산 절차 (Section 5)
| 단계 | 내용 |
|---|---|
| 1. 피라미드 | 생성 이미지와 학습 이미지 각각의 라플라시안 피라미드를 만듭니다. 최저 해상도 $16\times16$ 에서 시작해 전체 해상도까지 두 배씩 올리며, 각 레벨은 이전 레벨 업샘플과의 차이를 부호화 |
| 2. 샘플링 | 이미지 $16{,}384$ 장을 무작위 추출하고 레벨당 이미지마다 $128$ 개 디스크립터를 뽑아 레벨당 $2^{21}$(약 210만) 개 확보 |
| 3. 디스크립터 | $7\times7$ 픽셀 이웃 $\times$ 3채널, 즉 $x\in\mathbb{R}^{7\times7\times3}=\mathbb{R}^{147}$ |
| 4. 정규화 | 색 채널별 평균과 표준편차로 $x$, $y$ 정규화 |
| 5. 거리 | 레벨 $l$ 의 학습 패치 집합 ${x_i^l}$ 와 생성 패치 집합 ${y_i^l}$ 사이의 $\mathrm{SWD}(x^l, y^l)$ 을 512개 투영으로 계산 (Rabin et al., 2011) |
SWD는 지구 이동 거리(earth mover’s distance)의 효율적인 랜덤 근사입니다. 1차원 투영 위에서는 바서슈타인 거리가 정렬만으로 계산되므로, 무작위 방향으로 투영해 평균을 내는 방식입니다.
🗺️ 2. 레벨별 해석
| 피라미드 레벨 | 거리가 말해 주는 것 |
|---|---|
| 최저 해상도 $16\times16$ | 대규모 이미지 구조의 유사성 |
| 최고 해상도(가장 미세한 레벨) | 에지 선명도, 노이즈 같은 픽셀 수준 속성 |
거리가 작다는 것은 해당 공간 주파수 대역에서 생성 샘플과 학습 이미지가 외관과 다양성 모두 비슷하다는 뜻입니다. 즉 SWD는 품질과 다양성을 한 번에 봅니다.
⚠️ 3. MS-SSIM이 놓치는 것 (Table 1 논의)
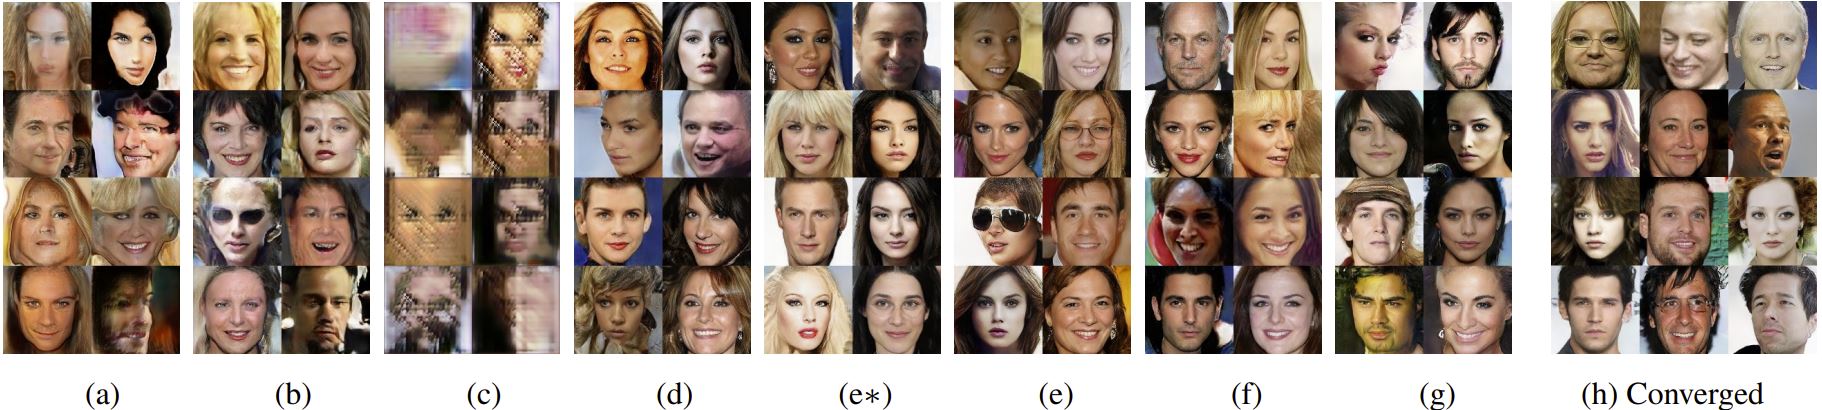
Table 1에서 설정 (h)는 (a)보다 눈에 띄게 좋은 이미지를 만들지만, MS-SSIM은 CelebA에서 $0.2854\to0.2828$ 로 거의 변하지 않습니다. MS-SSIM은 출력들 사이의 변동만 재고 학습 데이터와의 유사성은 재지 않기 때문입니다. 반면 SWD 평균은 $9.28\to2.96$ 으로 뚜렷한 개선을 보여 줍니다. 미니배치 크기를 줄여 이미지가 부자연스러워진 (c)는 두 지표 모두에서 악화가 드러났습니다.
💡 Key Takeaway SWD는 “이 스케일에서 생성 패치 분포가 실제 패치 분포와 얼마나 가까운가”를 묻습니다. 다양성만 보는 MS-SSIM과 달리 품질·다양성·스케일을 함께 평가할 수 있어, 이후 FID와 함께 ProGAN 계열 논문의 표준 지표가 되었습니다.
실험 설정과 절제 연구
논문은 각 기여를 누적적으로 하나씩 켜 가며 SWD와 MS-SSIM으로 효과를 분리해 측정했습니다. 비교 기준은 당시 최신 손실 함수와 학습 설정이었던 WGAN-GP(Gulrajani et al., 2017)이며, CelebA와 LSUN BEDROOM을 $128\times128$ 비지도 설정으로 사용했습니다.
🧪 1. 절제 실험 설계 (Section 6.1)
- 차이를 증폭하기 위해 의도적으로 용량이 작은 네트워크(Appendix A.2)를 쓰고, 판별기가 실제 이미지를 총 1,000만 장 본 시점에 학습을 중단했습니다. 따라서 (a)~(g)는 완전히 수렴하지 않은 결과입니다.
- CelebA는 학습 이미지 자체에 앨리어싱·압축·블러 같은 아티팩트가 있어 생성기가 충실히 재현하기 어렵기 때문에 비교에 적합하다고 보았습니다.
- MS-SSIM은 생성 이미지 쌍 10,000개의 평균입니다.
📋 2. Table 1 결과 (CelebA $128\times128$, SWD $\times10^{3}$)
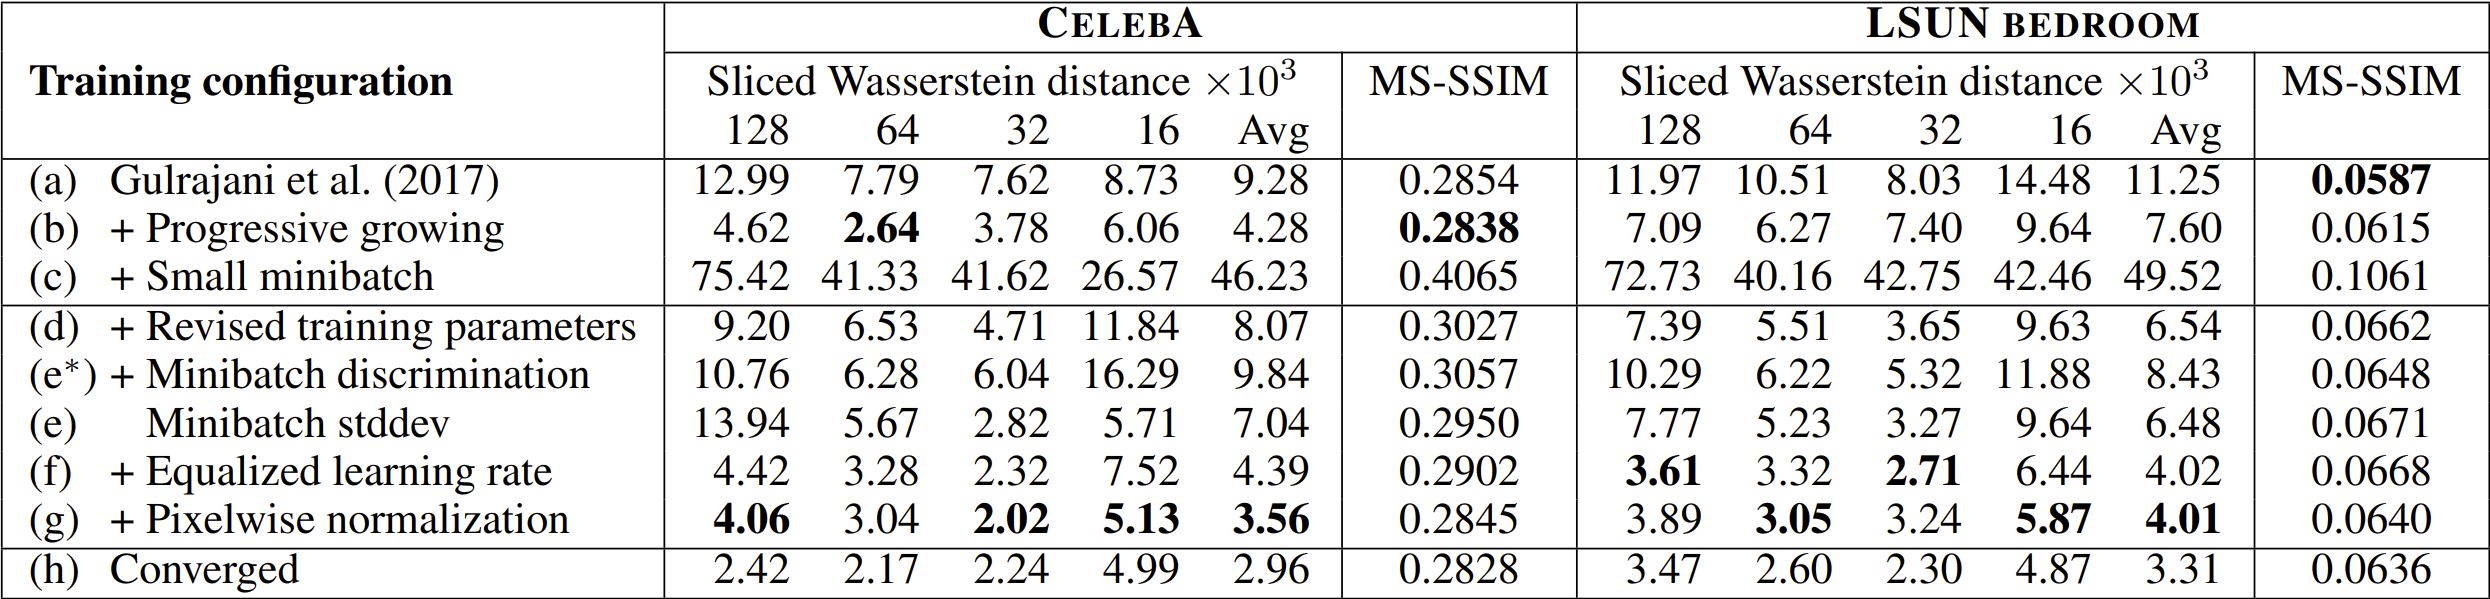
| 설정 | 128 | 64 | 32 | 16 | 평균 | MS-SSIM | LSUN 평균 SWD |
|---|---|---|---|---|---|---|---|
| (a) Gulrajani et al. 2017 | 12.99 | 7.79 | 7.62 | 8.73 | 9.28 | 0.2854 | 11.25 |
| (b) + 점진적 성장 | 4.62 | 2.64 | 3.78 | 6.06 | 4.28 | 0.2838 | 7.60 |
| (c) + 작은 미니배치(64→16) | 75.42 | 41.33 | 41.62 | 26.57 | 46.23 | 0.4065 | 49.52 |
| (d) + 학습 파라미터 수정 | 9.20 | 6.53 | 4.71 | 11.84 | 8.07 | 0.3027 | 6.54 |
| (e*) + 미니배치 판별 | 10.76 | 6.28 | 6.04 | 16.29 | 9.84 | 0.3057 | 8.43 |
| (e) 미니배치 표준편차 | 13.94 | 5.67 | 2.82 | 5.71 | 7.04 | 0.2950 | 6.48 |
| (f) + 균등 학습률 | 4.42 | 3.28 | 2.32 | 7.52 | 4.39 | 0.2902 | 4.02 |
| (g) + 픽셀 단위 정규화 | 4.06 | 3.04 | 2.02 | 5.13 | 3.56 | 0.2845 | 4.01 |
| (h) 수렴 모델 | 2.42 | 2.17 | 2.24 | 4.99 | 2.96 | 0.2828 | 3.31 |
읽는 법은 다음과 같습니다.
- (a)→(b) : 점진적 성장만으로 더 선명하고 그럴듯한 이미지가 나오며 SWD가 절반 이하로 떨어집니다.
- (b)→(c) : 고해상도를 위해 미니배치를 16으로 줄이면 이미지가 부자연스러워지고 두 지표 모두 악화합니다. 이것이 이후 모든 기법이 해결하려는 상황입니다.
- (c)→(d) : 하이퍼파라미터를 조정하고 배치 정규화와 층 정규화를 제거해 학습을 안정화합니다.
- (e*) vs (e) : 미니배치 판별은 출력 변동을 재는 MS-SSIM조차 개선하지 못했지만, 미니배치 표준편차는 평균 SWD와 이미지 품질을 개선했습니다.
- (f), (g) : 균등 학습률과 픽셀 정규화가 SWD와 주관적 품질을 추가로 끌어올립니다.
- (h) : 용량을 제한하지 않은 네트워크로 더 오래 학습한 결과이며, 논문은 당시 최고 공개 결과에 견줄 만하다고 평가합니다.
⏱️ 3. 수렴과 학습 속도 (Figure 4)
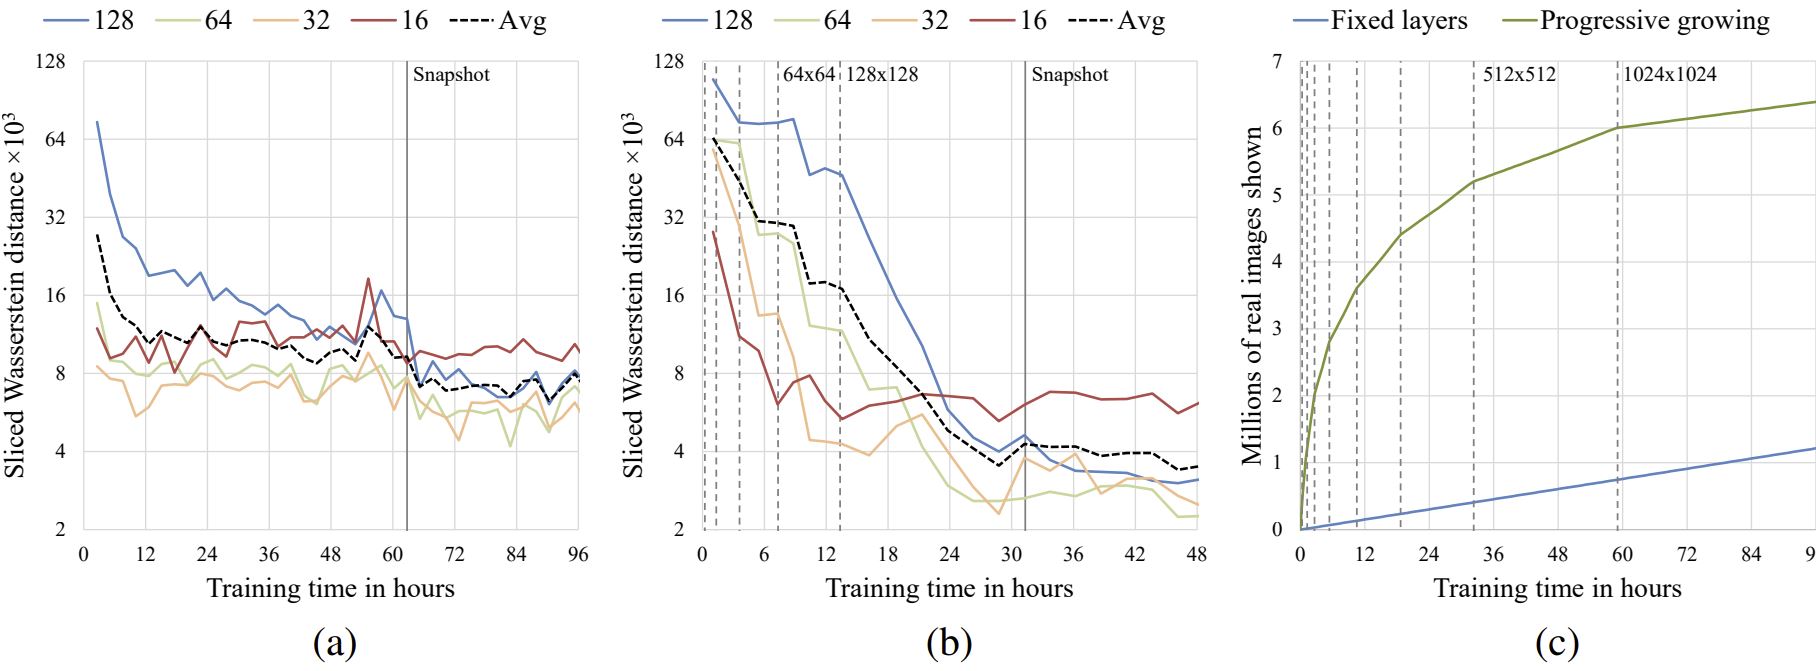
| 측정 | 비점진 | 점진적 성장 |
|---|---|---|
| $128\times128$ 수렴 | 모든 스케일의 SWD 곡선이 대략 함께 수렴 | 16 레벨 곡선이 매우 빨리 최적값에 도달해 유지되고, 32·64·128 곡선이 해상도 증가에 따라 차례로 안정화 |
| $128\times128$ 총 학습 시간 | 기준 | 약 절반 |
| $1024\times1024$ 처리량 | 같은 지점까지 외삽 약 520시간 | 96시간에 약 640만 장 → 약 5.4배 속도 향상 |
속도 향상의 원인은 초기에 네트워크가 얕아 평가가 빠르기 때문이며, 전체 해상도에 도달하면 두 방식의 이미지 처리량은 같아집니다. 수렴 개선은 네트워크 용량이 점차 커지며 부과되는 암묵적 커리큘럼 학습으로 설명됩니다. 비점진 방식에서는 모든 층이 대규모 변동과 소규모 세부의 중간 표현을 동시에 찾아야 하지만, 점진 방식에서는 저해상도 층이 일찍 수렴해 있어 새 층이 추가될 때마다 점점 작은 규모의 효과만 다듬으면 됩니다. 시간 측정은 Tesla P100 단일 GPU 기준입니다.
⚙️ 4. 학습 세부 (Appendix A)
| 항목 | 값 |
|---|---|
| 손실 | WGAN-GP, $n_{\text{critic}}=1$ |
| 드리프트 항 | $L’=L+\epsilon_{\text{drift}}\,\mathbb{E}{x\sim P_r}[D(x)^2]$, $\epsilon{\text{drift}}=0.001$ (판별기 출력이 0에서 너무 멀어지는 것을 방지) |
| 옵티마이저 | Adam, $\alpha=0.001,\ \beta_1=0,\ \beta_2=0.99,\ \epsilon=10^{-8}$ |
| 미니배치 | $4^2$~$128^2$ 에서 16, $256^2$ 에서 14, $512^2$ 에서 6, $1024^2$ 에서 3 |
| 단계 길이 | $4\times4$ 단계에 실제 이미지 80만 장, 이후 페이드인 80만 장과 안정화 80만 장을 번갈아 반복 |
| 시각화용 가중치 | 생성기 가중치의 지수 이동 평균(감쇠 0.999) |
| $1024^2$ 네트워크 | G와 D 각각 약 2,310만 개 학습 파라미터(Table 2) |
💡 Key Takeaway 절제 실험의 메시지는 명확합니다. 점진적 성장이 가장 큰 이득을 주고, 나머지 세 기법은 고해상도가 강제하는 작은 미니배치 환경에서 무너진 학습을 다시 세우는 역할을 합니다.
고해상도 결과와 CelebA-HQ
CelebA-HQ 는 GAN 문헌에서 쓰이던 공개 데이터셋이 $32^2$ 에서 $480^2$ 사이의 낮은 해상도에 머물러 있었기 때문에, 논문이 $1024\times1024$ 결과를 의미 있게 보여 주기 위해 CelebA in-the-wild에서 새로 만든 30,000장의 고품질 데이터셋입니다.
🖼️ 1. CelebA-HQ 구축 파이프라인 (Appendix C, Figure 8)
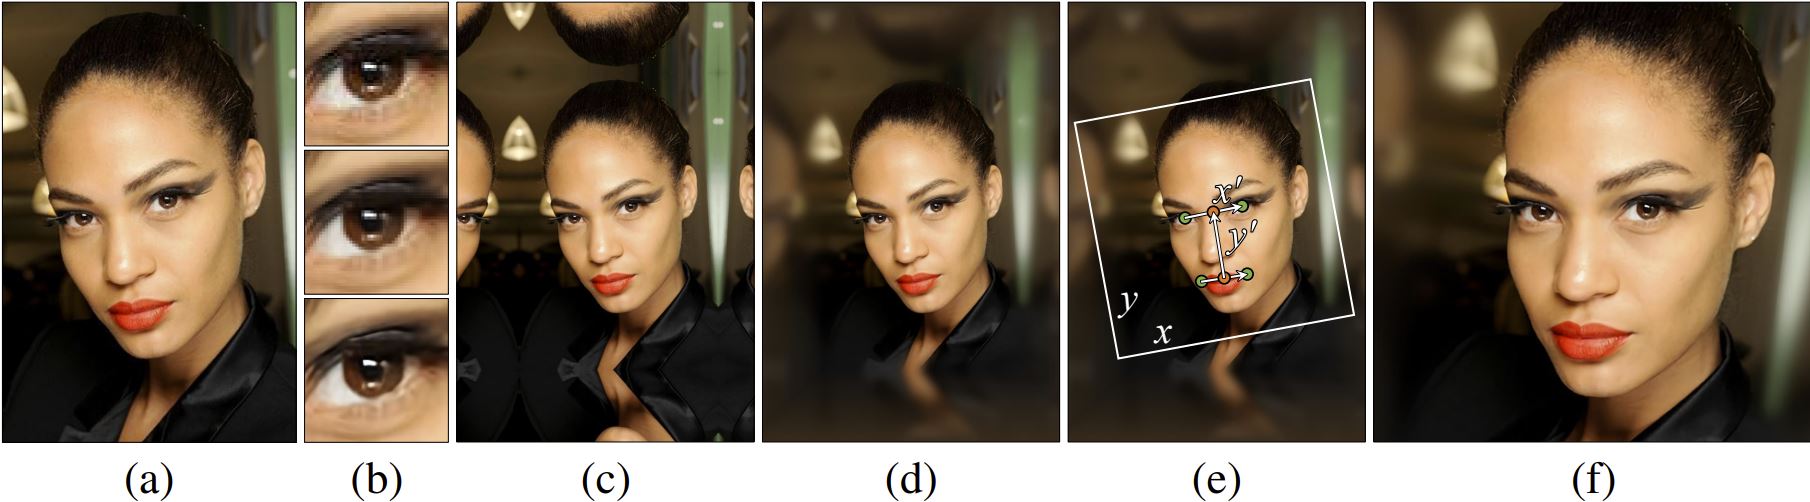
| 단계 | 처리 |
|---|---|
| (a) | CelebA in-the-wild의 JPEG 원본 |
| (b) | JPEG 아티팩트 제거와 $4\times$ 초해상도로 시각 품질 개선 |
| (c) | 미러 패딩으로 이미지 확장 |
| (d) | 가우시안 필터링으로 보기 좋은 피사계 심도 효과 |
| (e) | 얼굴 랜드마크 위치로 적절한 크롭 영역 선택 |
| (f) | 고품질 리샘플링으로 최종 $1024\times1024$ 이미지 생성 |
🌟 2. $1024\times1024$ 얼굴 생성 (Section 6.3, Figure 5)
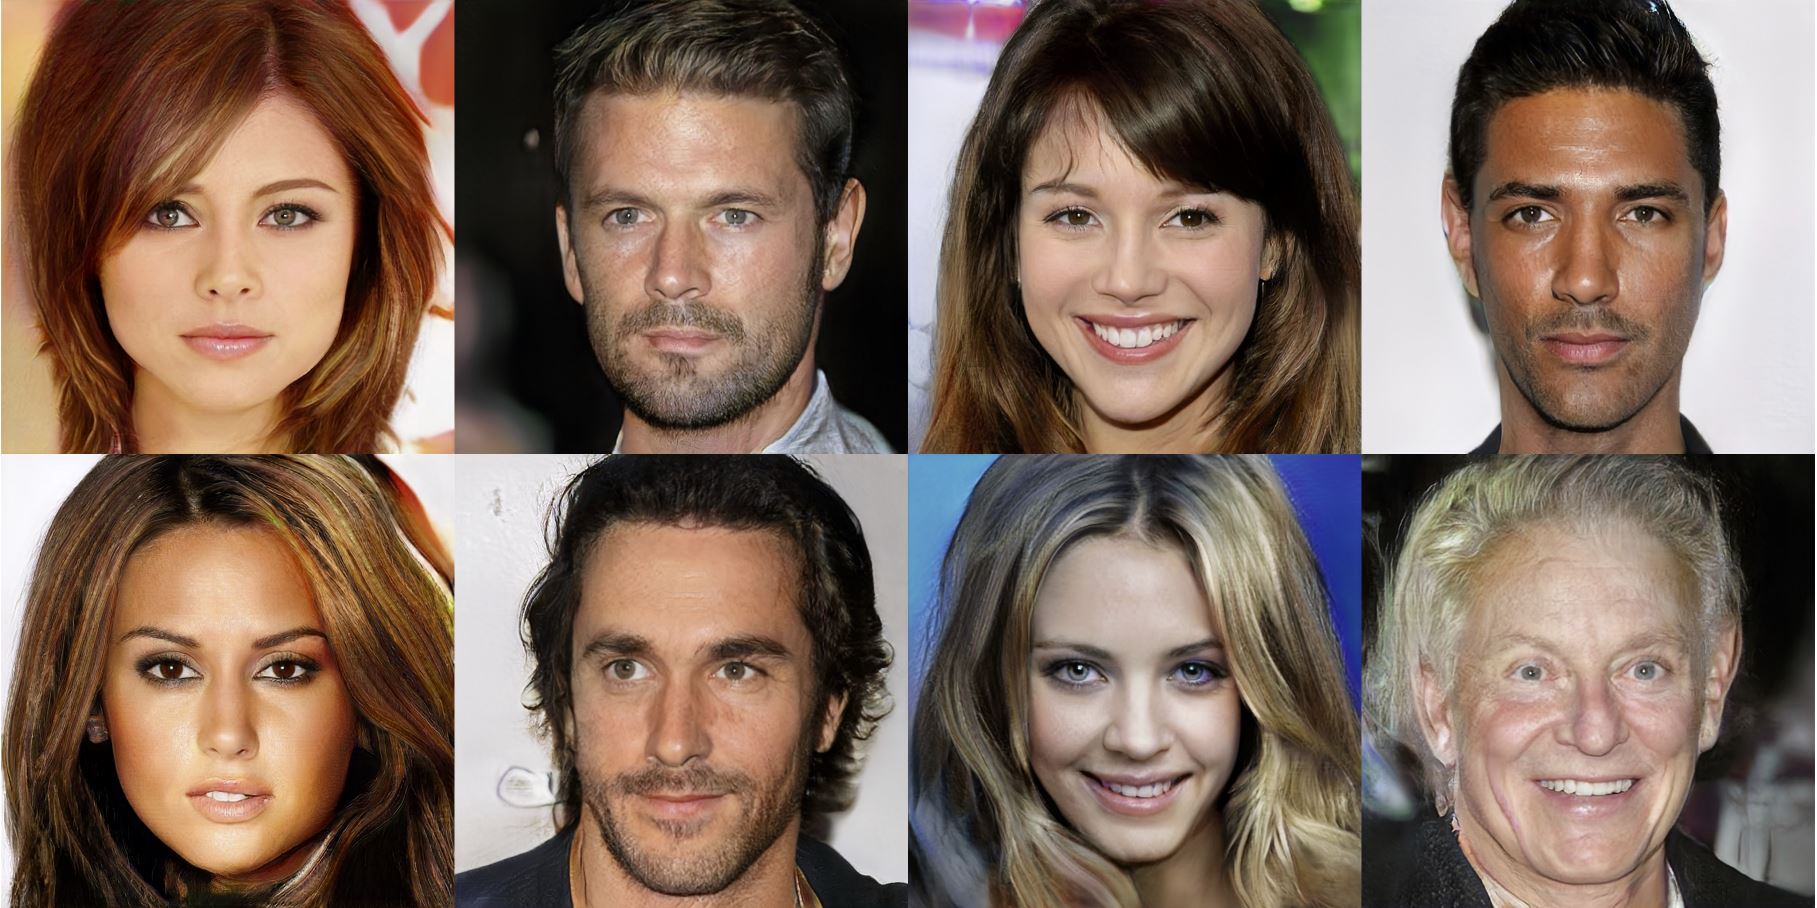
- 8장의 Tesla V100 GPU로 4일 학습했으며, 그 이후에는 연속 반복 사이에 질적 차이가 관찰되지 않았습니다. 해상도에 따라 미니배치 크기를 바꿔 메모리를 최대한 활용했습니다.
- Appendix F의 추가 결과에서 보고된 수치는 레벨 1024~16의 SWD $\times10^3$ 이 $7.48, 7.24, 6.08, 3.51, 3.55, 3.02, 7.22$(평균 $5.44$), 50K 이미지로 계산한 FID 7.30 입니다.
- 메가픽셀 GAN 결과는 이전에도 다른 데이터셋에서 보고된 바 있지만(Marchesi, 2017), 논문은 자신들의 결과가 훨씬 다양하고 지각 품질이 높다고 주장하며, 단순 암기가 아님을 보이기 위해 VGG 다섯 층의 특징 공간 거리로 찾은 학습 데이터 최근접 이웃을 함께 제시합니다(Figure 10).
- 기여가 손실 함수 선택과 직교적임을 보이기 위해 같은 네트워크를 LSGAN 손실로도 학습했고, Figure 1 우측의 $1024^2$ 예시 6장이 그 결과입니다.
🏙️ 3. LSUN과 CIFAR-10 (Section 6.4, 6.5)
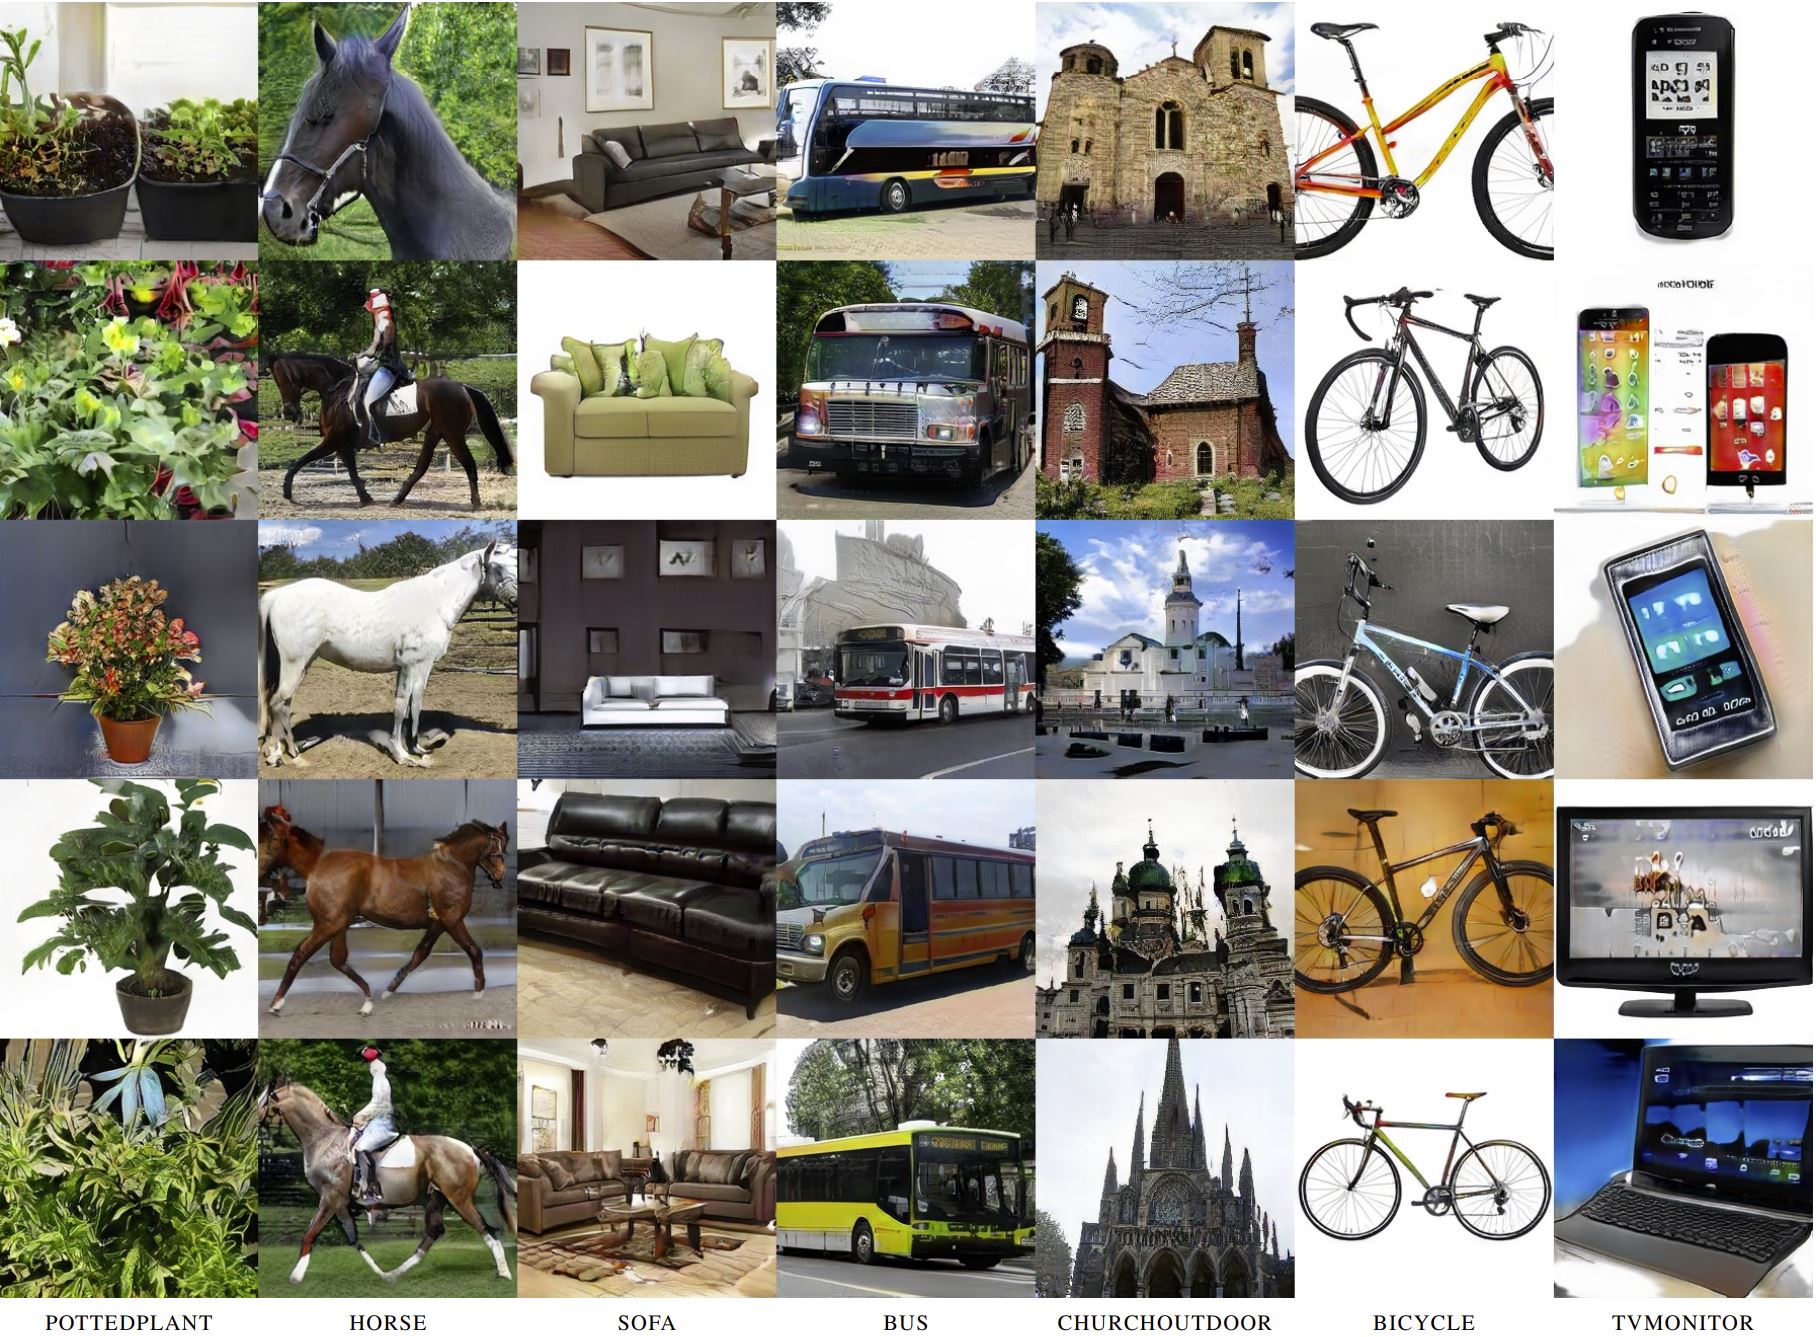
| 데이터셋 | 결과 |
|---|---|
| LSUN BEDROOM | 기존 결과와의 시각적 비교(Figure 6) |
| LSUN 30개 카테고리 | $256\times256$ 생성(Figure 7, Appendix G). 대부분 카테고리에 선행 결과가 없음 |
| CIFAR-10 비지도 | Inception Score 8.80 ± 0.05(최고 실행), 10회 평균 8.56 ± 0.06. 기존 비지도 최고 7.90(Splitting GAN), WGAN-GP 7.86 |
| CIFAR-10 라벨 조건부 (참고) | Splitting GAN 8.87, WGAN-GP 8.67 |
CIFAR-10에서 비지도와 조건부 점수의 차이는 주로 클래스 사이에 필연적으로 나타나는 “유령(ghost)” 이미지 때문입니다. 논문은 WGAN-GP의 기울기 벌점 항
\[\mathbb{E}_{\hat{x}\sim P_{\hat{x}}}\Big[\big(\lVert\nabla_{\hat{x}}D(\hat{x})\rVert-\gamma\big)^2/\gamma^2\Big]\]에서 Gulrajani et al.이 쓴 $\gamma=1.0$(1-Lipschitz) 대신 $\gamma=750$ 으로 빠른 전이를 선호하게 하는 것이 유령을 줄이는 데 훨씬 낫다는 것을 발견했습니다. 이 트릭은 다른 데이터셋에는 시도하지 않았습니다.
💡 Key Takeaway CelebA-HQ는 단순한 부산물이 아니라 이후 StyleGAN 계열이 FFHQ로 넘어가기 전까지 고해상도 얼굴 생성의 표준 벤치마크가 되었고, $1024^2$ 결과는 “GAN으로 메가픽셀이 가능하다”는 것을 처음으로 설득력 있게 보여 준 사례입니다.
한계와 열린 방향
ProGAN은 해상도·안정성·다양성 세 축에서 큰 진전을 이뤘지만, 논문 스스로도 진정한 사실감까지는 갈 길이 멀다고 적고 있습니다. 이 절에서는 논문이 밝힌 한계와 이후 연구가 어떻게 이어졌는지를 정리합니다.
🧱 1. 논문이 인정한 한계 (Section 7)
| 한계 | 설명 |
|---|---|
| 의미론적 타당성 | “특정 물체는 굽지 않고 곧아야 한다” 같은 데이터셋 의존 제약을 이해하지 못함 |
| 미세 구조 | 이미지의 마이크로 구조에 개선 여지 |
| 평가의 한계 | SWD는 제안 지표이며, 논문은 지각적 검증을 병행했지만 보편적 지표로 확립된 상태는 아님 |
| 비교의 범위 | 다른 다양성 기법(언롤링, 반발 정규화기, 다중 생성기)과의 정량 비교는 미뤄 둠 |
| 데이터셋 특수 트릭 | CIFAR-10의 $\gamma=750$ 설정은 다른 데이터셋에서 검증되지 않음 |
🔭 2. 후속 연구로의 연결
- StyleGAN(Karras et al., 2019) 은 ProGAN의 점진적 성장 학습 구조와 균등 학습률, 픽셀 정규화 등을 그대로 물려받고, 생성기 입력 구조를 스타일 기반으로 바꿨습니다. 또한 CelebA-HQ를 잇는 더 다양한 고해상도 얼굴 데이터셋 FFHQ를 공개했습니다.
- StyleGAN2(Karras et al., 2020) 는 점진적 성장이 세부 특징이 특정 위치에 고정되는 위상 아티팩트(phase artifacts) 를 낳는다고 진단하고, 성장 없이 스킵 연결 생성기와 잔차 판별기로 같은 목표를 달성하는 쪽으로 돌아섰습니다. 즉 ProGAN의 핵심 기법 자체가 후속 연구에서 교체 대상이 되었습니다.
- 미니배치 표준편차 층, 균등 학습률, 지수 이동 평균 생성기 가중치는 StyleGAN 계열은 물론 다양한 GAN 구현의 기본 구성 요소로 남아 있습니다.
- SWD와 함께 쓰인 FID(Heusel et al., 2017)는 이후 GAN 평가의 사실상 표준이 되었고, 논문이 제기한 “다양성과 품질을 함께 재야 한다”는 문제의식은 정밀도/재현율(precision/recall) 지표로 이어졌습니다.
❓ 3. 열린 질문
- 점진적 성장은 학습 일정이 만들어 내는 암묵적 커리큘럼인데, 같은 효과를 구조적 설계(다중 스케일 스킵 연결 등)만으로 얻을 수 있는가. StyleGAN2는 가능하다고 답했지만, 어느 쪽이 근본적으로 유리한지는 데이터와 해상도에 따라 달라질 수 있습니다.
- 픽셀 단위 정규화가 “대부분 결과를 바꾸지 않는다”면 어떤 조건에서 꼭 필요한가. 논문은 신호 폭주가 일어날 때라고만 말하며, 그 조건의 정량적 특성화는 남아 있습니다.
- SWD의 레벨별 거리를 학습 신호로 되먹일 수 있는가. 평가 지표에 머문 SWD를 손실에 통합하는 연구는 별도의 방향으로 열려 있습니다.
💡 Key Takeaway ProGAN의 가장 큰 유산은 “메가픽셀 GAN이 가능하다”는 증명과, 이후 StyleGAN 계열의 기본 재료가 된 파라미터 없는 안정화 기법들입니다. 정작 이름을 딴 점진적 성장 자체는 StyleGAN2에서 위상 아티팩트 때문에 폐기되었다는 점이 이 논문의 흥미로운 뒷이야기입니다.