 You know maize mean?
U-Net: Convolutional Networks for Biomedical Image Segmentation
0. Summary
기본 정보 : ArXiv,2015.05.18 (MICCAI 2015), U-Net: Convolutional Networks for Biomedical Image Segmentation
연구 배경
심층 합성곱 네트워크는 많은 시각 인식 과제에서 최고 성능을 넘어섰지만, 그 돌파구는 ImageNet 의 100 만 장 훈련 이미지처럼 대규모 훈련 집합에 의존했다. 합성곱 네트워크의 전형적 용도는 이미지 하나에 클래스 라벨 하나를 내는 분류지만, 생의학 영상 처리에서는 각 픽셀에 클래스 라벨을 부여하는 위치 추정(localization) 이 필요하고 수천 장의 훈련 이미지는 보통 손에 넣을 수 없다. Ciresan 등은 각 픽셀 주변의 국소 영역(패치)을 입력으로 그 픽셀의 라벨을 예측하는 슬라이딩 윈도우 방식으로 ISBI 2012 EM 분할 챌린지에서 큰 차이로 우승했지만, 패치마다 네트워크를 따로 실행해야 해서 매우 느리고 겹치는 패치 때문에 중복이 많으며, 위치 정확도와 문맥 사용 사이에 트레이드오프가 있었다. 큰 패치는 더 많은 맥스풀링으로 위치 정확도를 떨어뜨리고, 작은 패치는 문맥을 거의 보지 못한다.
제안 방법
“완전 합성곱 네트워크(fully convolutional network)” 를 수정·확장해 매우 적은 훈련 이미지로 작동하고 더 정밀한 분할을 내는 구조를 제안한다. 문맥을 포착하는 수축 경로(contracting path) 와 정밀한 위치 추정을 가능하게 하는 대칭적 확장 경로(expansive path) 로 이루어진 U 자형 구조다. 핵심 수정은 업샘플링 부분에도 많은 수의 특징 채널을 두어 문맥 정보를 더 높은 해상도 층으로 전파하게 한 것이며, 수축 경로의 고해상도 특징을 잘라내어 업샘플 출력과 연결한다. 완전연결층이 없고 각 합성곱의 유효(valid) 부분만 쓰므로 overlap-tile 전략으로 임의 크기 이미지를 끊김 없이 분할할 수 있고, 경계 영역은 입력 이미지를 거울 반사해 외삽한다. 훈련 데이터가 적으므로 탄성 변형(elastic deformation) 으로 과도한 데이터 증강을 하고, 붙어 있는 같은 클래스 세포를 분리하기 위해 세포 사이 배경 픽셀에 큰 가중치를 주는 가중 손실을 쓴다.
발견 사실
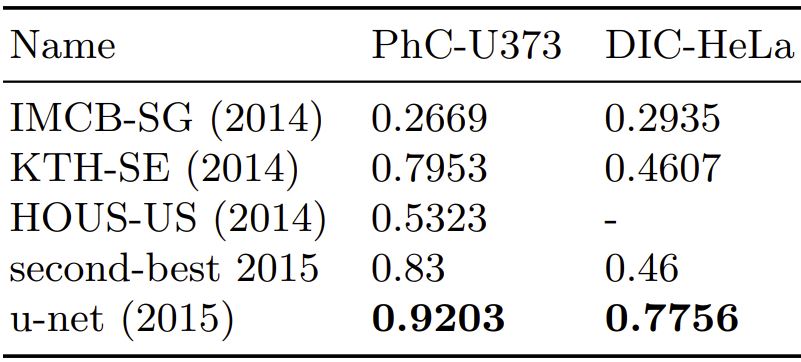
ISBI 2012 EM 분할 챌린지에서 입력의 7 개 회전 버전을 평균한 U-Net 은 추가 전·후처리 없이 warping error 0.0003529 로 새 최고 점수를 기록했고 rand error 는 0.0382 였다(Table 1). 이는 Ciresan 등의 슬라이딩 윈도우 네트워크(warping error 0.000420, rand error 0.0504)보다 유의하게 좋으며, rand error 에서 더 나은 알고리즘들은 Ciresan 등의 확률 맵에 데이터셋 특화 후처리를 적용한 것뿐이었다. ISBI 2015 세포 추적 챌린지의 두 가지 가장 어려운 2D 투과광 데이터셋에서는 35 장의 부분 주석 이미지로 학습한 PhC-U373 에서 IOU 92% (2 위 83%), 20 장으로 학습한 DIC-HeLa 에서 IOU 77.5% (2 위 46%) 로 큰 차이로 우승했다(Table 2). 네트워크는 빠르며 $512\times512$ 이미지 분할이 최신 GPU 에서 1 초 미만이고, 학습은 NVidia Titan GPU(6 GB)에서 10 시간이 걸렸다.
핵심 기여
- U 자형 인코더-디코더 구조 : 수축 경로와 확장 경로가 대칭을 이루고, 확장 경로에도 많은 특징 채널을 두며, 잘라낸 고해상도 특징 맵을 업샘플 출력과 연결해 문맥과 위치 정확도를 동시에 확보했다. 완전연결층 없이 23 개 합성곱 층으로 구성된다.
- 적은 데이터로 학습하는 전략 : 탄성 변형 중심의 강한 데이터 증강, 붙은 세포의 분리 경계를 강조하는 거리 기반 가중치 맵, 큰 입력 타일과 배치 1 에 높은 모멘텀(0.99)을 결합한 학습 설정으로 수십 장의 주석 이미지만으로 종단간 학습이 가능함을 보였다.
- Overlap-tile 전략과 빠른 추론 : 유효 합성곱과 거울 반사 외삽으로 GPU 메모리 제약 없이 임의 크기 이미지를 끊김 없이 분할하며, EM 분할과 두 종류의 광학 현미경 세포 분할 모두에서 당시 최고 성능을 달성했다.
관련 개념
네트워크 구조: 수축 경로와 확장 경로 (Section 2)
U-Net 구조는 Figure 1 처럼 왼쪽의 수축 경로와 오른쪽의 확장 경로로 이루어집니다. 수축 경로는 전형적인 합성곱 네트워크 구조를 따르고, 확장 경로는 그것을 거울상으로 뒤집은 뒤 스킵 연결로 잇습니다.
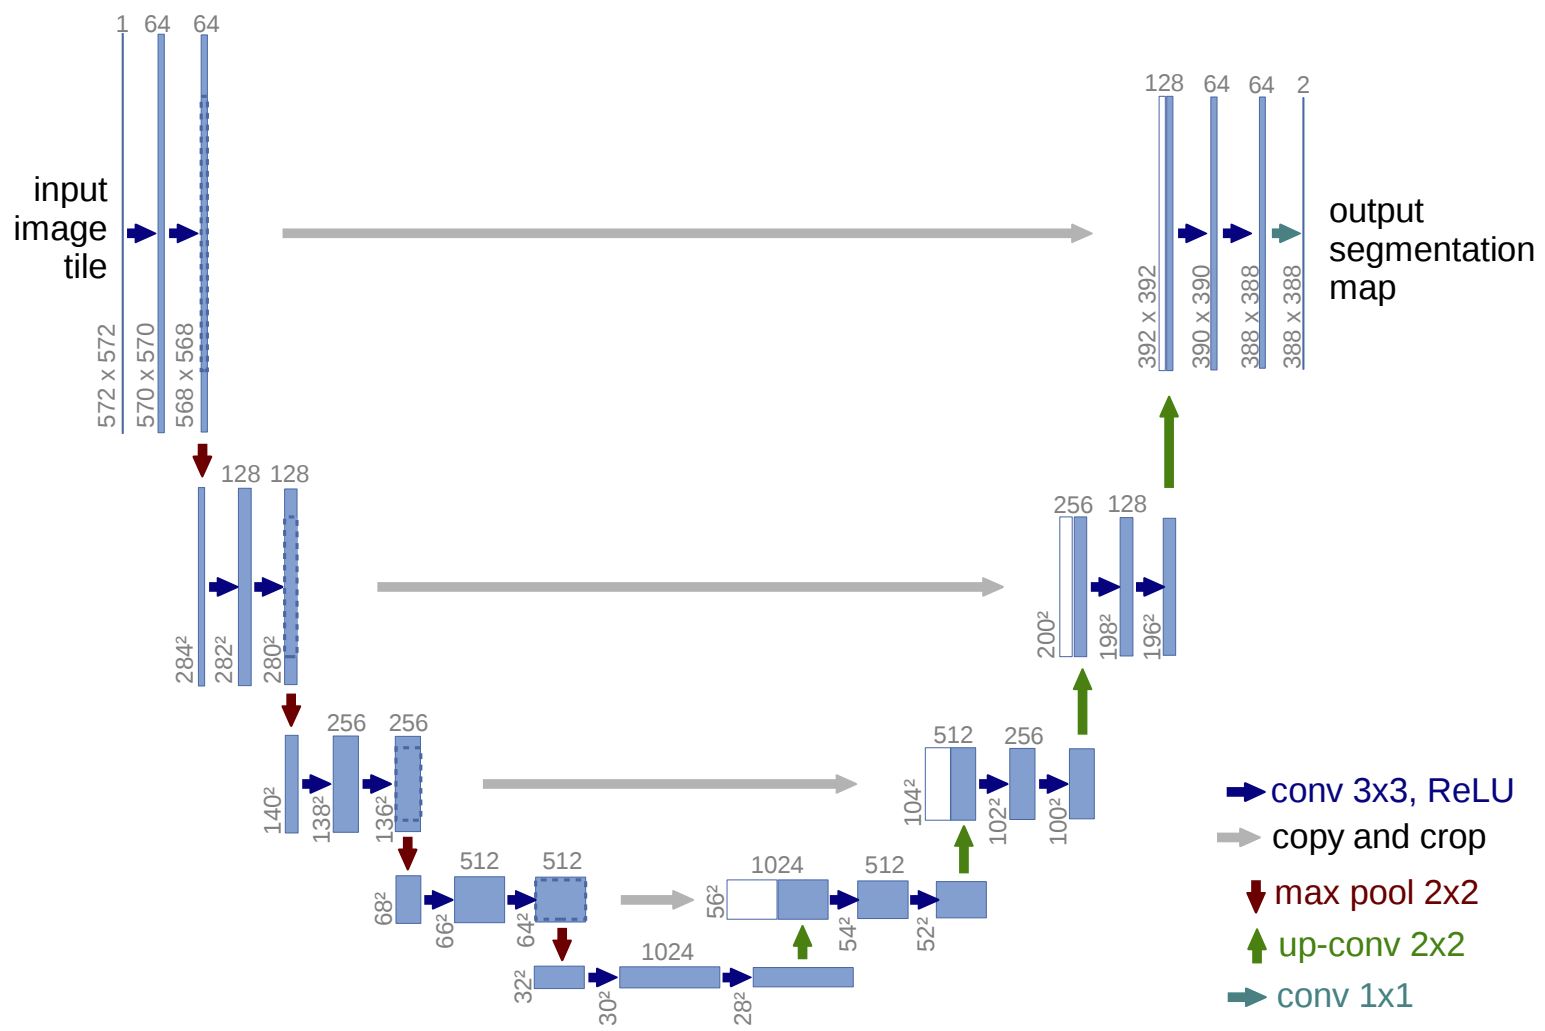
⬇️ 1. 수축 경로 (contracting path)
| 단계 | 연산 |
|---|---|
| 합성곱 블록 | $3\times3$ 합성곱(패딩 없음) 두 번, 각각 뒤에 ReLU |
| 다운샘플링 | 스트라이드 2 의 $2\times2$ 맥스풀링 |
| 채널 수 | 다운샘플링 단계마다 특징 채널 수를 2 배로 |
Figure 1 은 최저 해상도가 $32\times32$ 픽셀인 예시이며, 파란 상자는 다채널 특징 맵, 상자 위 숫자는 채널 수, 왼쪽 아래 숫자는 x-y 크기, 흰 상자는 복사된 특징 맵입니다.
⬆️ 2. 확장 경로 (expansive path)
| 단계 | 연산 |
|---|---|
| 업샘플링 | 특징 맵 업샘플링 후 채널 수를 절반으로 줄이는 $2\times2$ 합성곱(“up-convolution”) |
| 스킵 연결 | 수축 경로의 대응 특징 맵을 적절히 잘라내어(crop) 연결(concatenate) |
| 합성곱 블록 | $3\times3$ 합성곱 두 번, 각각 뒤에 ReLU |
| 출력층 | $1\times1$ 합성곱으로 64 채널 특징 벡터를 원하는 클래스 수로 사상 |
잘라내기가 필요한 이유는 모든 합성곱에서 경계 픽셀이 손실되기 때문입니다. 네트워크는 총 23 개의 합성곱 층을 가집니다.
🧩 3. 설계의 핵심 아이디어
| 아이디어 | 내용 |
|---|---|
| FCN 의 계승 | 통상의 수축 네트워크에 풀링을 업샘플링으로 바꾼 층들을 덧붙여 출력 해상도를 높이고, 위치 추정을 위해 수축 경로의 고해상도 특징을 업샘플 출력과 결합. 이어지는 합성곱 층이 이 정보로 더 정밀한 출력을 조립 |
| U-Net 의 수정 | 업샘플링 부분에도 많은 특징 채널을 두어 네트워크가 문맥 정보를 더 높은 해상도 층으로 전파. 그 결과 확장 경로가 수축 경로와 거의 대칭이 되어 U 자형 |
| 완전연결층 없음 | 각 합성곱의 유효 부분만 사용하므로 분할 맵은 입력 이미지에서 전체 문맥을 얻을 수 있는 픽셀만 포함 |
| 타일 크기 조건 | 출력 분할 맵의 끊김 없는 타일링을 위해 모든 $2\times2$ 맥스풀링이 짝수 x-y 크기의 층에 적용되도록 입력 타일 크기를 선택 |
📊 4. 완전 합성곱 네트워크(FCN)와의 비교
| 항목 | FCN (Long et al.) | U-Net |
|---|---|---|
| 업샘플링 경로 | 비교적 얕고 채널 수가 적음 | 수축 경로와 대칭이며 채널 수가 많음 |
| 저수준 특징 결합 | 일부 층의 예측을 더함(summation) | 잘라낸 특징 맵을 채널 방향으로 연결(concatenation) |
| 합성곱 | 패딩 사용 | 패딩 없는 유효 합성곱 |
| 목표 데이터 규모 | 대규모 자연 이미지 | 수십 장의 생의학 이미지 |
논문은 FCN 의 주 아이디어(“수축 네트워크에 풀링 대신 업샘플링을 쓰는 층들을 덧붙인다”)를 계승하되, 매우 적은 훈련 이미지로 작동하고 더 정밀한 분할을 내도록 수정·확장했다고 명시합니다.
💡 Key Takeaway U-Net 의 혁신은 “업샘플링 쪽에도 채널을 많이 두고, 수축 경로의 고해상도 특징을 잘라서 이어 붙인다”는 두 가지입니다. 문맥은 아래로, 위치는 옆으로 흐릅니다.
Overlap-tile 전략과 경계 처리 (Section 1, 2)
Overlap-tile 전략은 유효 합성곱만 쓰는 네트워크로 임의 크기 이미지를 분할하기 위한 추론 방식입니다. 이 전략이 없으면 해상도가 GPU 메모리에 제한됩니다.
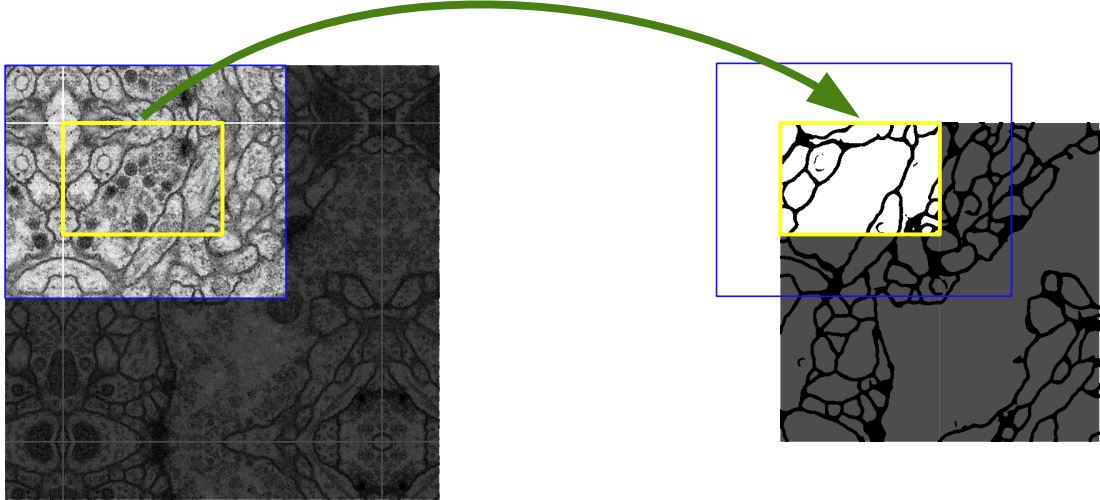
🧱 1. 타일링의 원리
| 영역 | 역할 |
|---|---|
| 노란 영역 | 분할을 예측할 출력 영역 |
| 파란 영역 | 그 예측에 입력으로 필요한 이미지 데이터. 노란 영역보다 넓음 |
유효 합성곱 때문에 출력은 입력보다 일정한 경계 폭만큼 작습니다. 큰 이미지는 서로 겹치는 입력 타일로 나누어 각 타일의 출력 영역을 이어 붙이면 끊김 없는 분할을 얻습니다.
🪞 2. 거울 반사 외삽
이미지 경계 영역의 픽셀을 예측하려면 이미지 바깥의 문맥이 필요합니다. 빠진 입력 데이터는 입력 이미지를 거울 반사(mirroring) 해 외삽합니다. 0 패딩과 달리 생의학 조직 이미지에서 자연스러운 연속성을 유지합니다.
⚖️ 3. 슬라이딩 윈도우와의 비교
| 항목 | Ciresan et al. 슬라이딩 윈도우 | U-Net overlap-tile |
|---|---|---|
| 실행 단위 | 픽셀마다 패치 하나씩 네트워크 실행 | 타일 하나로 영역 전체를 한 번에 예측 |
| 중복 계산 | 겹치는 패치로 매우 많음 | 겹치는 부분은 입력 경계뿐 |
| 속도 | 매우 느림 | $512\times512$ 이미지 1 초 미만 |
| 문맥 대 위치 | 패치 크기로 트레이드오프 | 스킵 연결로 동시에 확보 |
💡 Key Takeaway 유효 합성곱 + 거울 반사 + 겹치는 타일이라는 조합 덕분에 U-Net 은 GPU 메모리와 무관하게 큰 이미지를 처리하면서도 경계 품질을 유지합니다.
학습: 에너지 함수와 가중치 맵 (Section 3)
학습은 Caffe 의 확률적 경사하강 구현을 씁니다. 패딩 없는 합성곱 때문에 출력이 입력보다 작으므로, 오버헤드를 줄이고 GPU 메모리를 최대한 쓰기 위해 큰 배치보다 큰 입력 타일을 택하고 배치를 이미지 한 장으로 줄입니다. 그에 따라 높은 모멘텀(0.99) 을 써서 이전에 본 많은 훈련 샘플이 현재 최적화 스텝의 갱신을 결정하게 합니다.
📐 1. 픽셀별 소프트맥스와 교차 엔트로피
최종 특징 맵에 대한 픽셀별 소프트맥스와 교차 엔트로피 손실로 에너지 함수를 계산합니다.
\[p_{k}(\mathbf{x})=\frac{\exp(a_{k}(\mathbf{x}))}{\sum_{k'=1}^{K}\exp(a_{k'}(\mathbf{x}))}\]| 기호 | 의미 |
|---|---|
| $a_{k}(\mathbf{x})$ | 픽셀 위치 $\mathbf{x}\in\Omega$, $\Omega\subset\mathbb{Z}^{2}$ 에서 특징 채널 $k$ 의 활성화 |
| $K$ | 클래스 수 |
| $p_{k}(\mathbf{x})$ | 근사된 최대 함수. 최대 활성화를 가진 $k$ 에서 $\approx1$, 나머지에서 $\approx0$ |
교차 엔트로피는 각 위치에서 $p_{\ell(\mathbf{x})}(\mathbf{x})$ 가 1 에서 벗어난 정도에 벌점을 줍니다.
\[E=\sum_{\mathbf{x}\in\Omega}w(\mathbf{x})\log\big(p_{\ell(\mathbf{x})}(\mathbf{x})\big)\]여기서 $\ell:\Omega\to{1,\dots,K}$ 는 각 픽셀의 참 라벨이고 $w:\Omega\to\mathbb{R}$ 는 학습에서 일부 픽셀에 더 큰 중요도를 주기 위해 도입한 가중치 맵입니다.
🧮 2. 가중치 맵 (Figure 3)
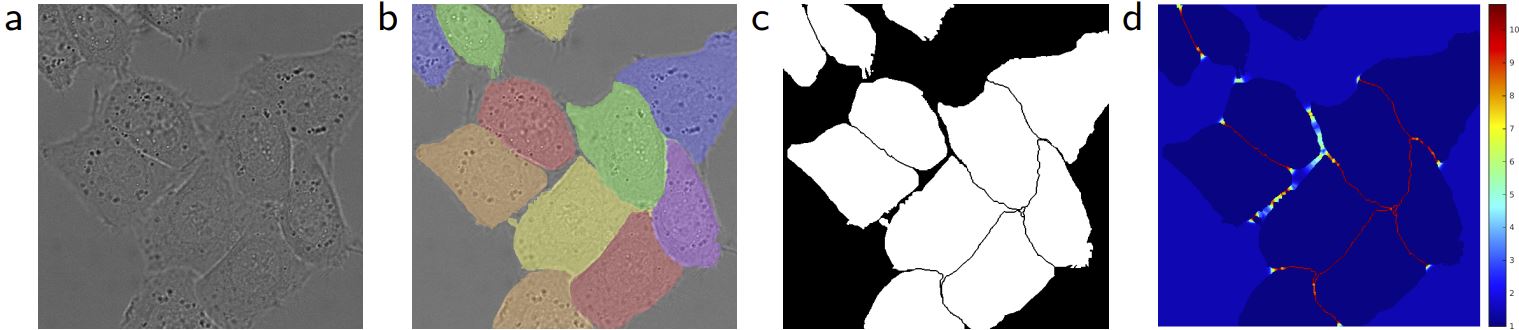
가중치 맵은 각 정답 분할에 대해 미리 계산하며 두 가지 목적을 가집니다. 훈련 집합에서 클래스별 픽셀 빈도 차이를 보상하고, 붙어 있는 세포 사이에 도입한 작은 분리 경계를 네트워크가 학습하도록 강제하는 것입니다(Figure 3c, d). 분리 경계는 형태학적 연산으로 계산합니다.
\[w(\mathbf{x})=w_{c}(\mathbf{x})+w_{0}\cdot\exp\Big(-\frac{(d_{1}(\mathbf{x})+d_{2}(\mathbf{x}))^{2}}{2\sigma^{2}}\Big)\]| 기호 | 의미 | 실험 값 |
|---|---|---|
| $w_{c}$ | 클래스 빈도 균형을 위한 가중치 맵 | – |
| $d_{1}$ | 가장 가까운 세포 경계까지의 거리 | – |
| $d_{2}$ | 두 번째로 가까운 세포 경계까지의 거리 | – |
| $w_{0}$ | 경계 강조 강도 | 10 |
| $\sigma$ | 경계 강조 폭 | 약 5 픽셀 |
두 세포 사이의 좁은 배경에서는 $d_{1}+d_{2}$ 가 작아 가중치가 커지고, 세포 내부나 넓은 배경에서는 지수 항이 0 에 가까워집니다. Figure 3 은 DIC 현미경으로 찍은 유리 위 HeLa 세포의 원본(a), 정답 오버레이(b), 생성된 분할 마스크(c), 경계 픽셀 학습을 강제하는 픽셀별 손실 가중치 맵(d)을 보여줍니다.
🎲 3. 가중치 초기화
합성곱 층이 많고 경로가 여러 개인 깊은 네트워크에서는 좋은 초기화가 극히 중요합니다. 그렇지 않으면 일부가 과도한 활성화를 내고 다른 부분은 전혀 기여하지 않습니다. 이상적으로는 각 특징 맵이 대략 단위 분산을 갖도록 초기 가중치를 맞춰야 하며, 합성곱과 ReLU 가 번갈아 나오는 이 구조에서는 표준편차 $\sqrt{2/N}$ 의 가우시안에서 초기 가중치를 뽑으면 됩니다. $N$ 은 뉴런 하나로 들어오는 노드 수로, 이전 층이 64 채널인 $3\times3$ 합성곱이라면 $N=9\cdot64=576$ 입니다.
💡 Key Takeaway 손실의 핵심은 $w(\mathbf{x})$ 입니다. 클래스 불균형 보정에 두 세포 경계까지의 거리 합에 대한 가우시안을 더해, 붙은 세포 사이의 가느다란 배경을 네트워크가 반드시 배우게 합니다.
데이터 증강: 탄성 변형 (Section 3.1)
데이터 증강은 훈련 샘플이 적을 때 네트워크에 원하는 불변성과 강건성을 가르치는 데 필수적입니다. 현미경 이미지에서는 주로 이동·회전 불변성과 변형·회색값 변동에 대한 강건성이 필요합니다.
🌊 1. 랜덤 탄성 변형
| 단계 | 내용 |
|---|---|
| 1 | 거친 $3\times3$ 격자 위의 랜덤 변위 벡터 생성 |
| 2 | 변위는 표준편차 10 픽셀의 가우시안에서 샘플링 |
| 3 | 픽셀별 변위는 쌍삼차 보간(bicubic interpolation) 으로 계산 |
훈련 샘플의 랜덤 탄성 변형은 매우 적은 주석 이미지로 분할 네트워크를 학습하는 핵심 개념으로 보입니다.
🧬 2. 왜 생의학 분할에 특히 중요한가
| 이유 | 설명 |
|---|---|
| 변형이 가장 흔한 변이 | 조직에서 변형은 가장 흔한 변이였고 현실적인 변형을 효율적으로 시뮬레이션할 수 있음 |
| 불변성 학습 | 주석 이미지 코퍼스에서 그런 변환을 보지 않고도 네트워크가 변형 불변성을 학습 |
| 선행 근거 | 데이터 증강으로 불변성을 학습하는 가치는 비지도 특징 학습 맥락에서 이미 입증됨 |
🎛️ 3. 암묵적 증강
수축 경로 끝의 드롭아웃 층이 추가적인 암묵적 데이터 증강을 수행합니다.
💡 Key Takeaway U-Net 이 30 장 안팎의 이미지로 학습될 수 있었던 비결은 구조만이 아니라 탄성 변형입니다. 조직의 자연스러운 변이를 흉내내는 증강이 데이터 부족을 메웠습니다.
실험: EM 분할과 세포 추적 챌린지 (Section 4)
실험은 세 가지 분할 과제에 U-Net 을 적용합니다. 전자 현미경 기록의 신경 구조 분할과, 두 종류의 광학 현미경 이미지에서의 세포 분할입니다.
🔬 1. ISBI 2012 EM 분할 챌린지 (Table 1)
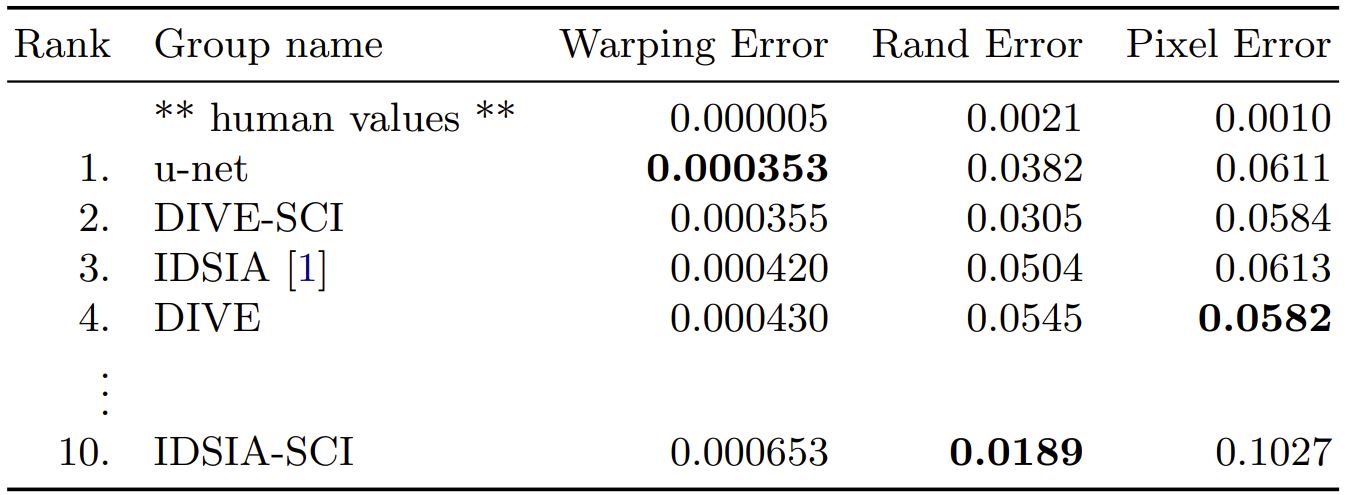
| 항목 | 내용 |
|---|---|
| 데이터 | 초파리 1 령 유충 복부 신경삭(VNC)의 연속 절편 투과 전자 현미경 이미지 30 장($512\times512$). 세포(흰색)와 막(검은색)에 대한 완전 주석 정답 |
| 테스트 | 테스트 집합은 공개되지만 분할 맵은 비공개. 예측 막 확률 맵을 주최측에 보내 평가 |
| 지표 | 맵을 10 개 수준으로 임계값 처리해 warping error, Rand error, pixel error 계산 |
| 설정 | 입력 데이터의 7 개 회전 버전을 평균, 추가 전·후처리 없음 |
| 방법 | Warping error | Rand error |
|---|---|---|
| U-Net | 0.0003529 (새 최고 점수) | 0.0382 |
| Ciresan et al. 최선 제출 | 0.000420 | 0.0504 |
Rand error 에서 U-Net 보다 나은 알고리즘은 Ciresan 등의 확률 맵에 데이터셋 특화 후처리를 적용한 것뿐이었습니다. 순위는 2015 년 3 월 6 일 기준이며 warping error 로 정렬되어 있습니다.
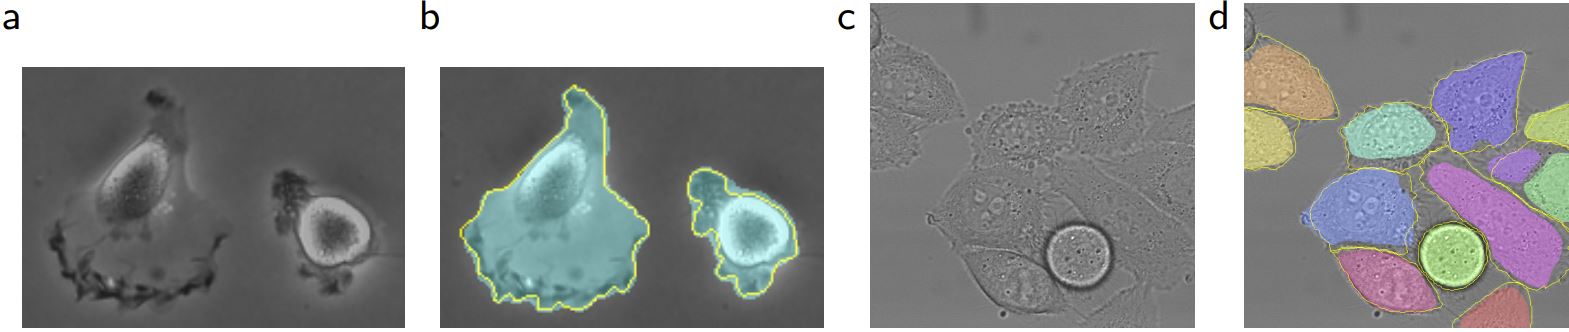
🧫 2. ISBI 2015 세포 추적 챌린지 (Table 2, Figure 4)
| 데이터셋 | 내용 | 훈련 이미지 | U-Net IOU | 2 위 IOU |
|---|---|---|---|---|
| PhC-U373 | 폴리아크릴아미드 기질 위 교모세포종-성상세포종 U373 세포, 위상차 현미경 | 35 장 (부분 주석) | 92% | 83% |
| DIC-HeLa | 평평한 유리 위 HeLa 세포, 미분 간섭 대비(DIC) 현미경 | 20 장 (부분 주석) | 77.5% | 46% |
두 데이터셋은 세포 추적 챌린지 2014·2015 의 일부이며, 가장 어려운 두 2D 투과광 데이터셋에서 큰 차이로 우승했습니다. Figure 4 는 PhC-U373 입력(a)과 분할 결과(b, 청록 마스크와 노란 정답 경계), DIC-HeLa 입력(c)과 분할 결과(d, 랜덤 색 마스크)를 보여줍니다.
⏱️ 3. 속도와 자원
| 항목 | 값 |
|---|---|
| 추론 | $512\times512$ 이미지 분할에 최신 GPU 에서 1 초 미만 |
| 학습 | NVidia Titan GPU(6 GB)에서 10 시간 |
| 공개 | Caffe 기반 전체 구현과 학습된 네트워크 공개 |
📏 4. 평가 지표의 의미
| 지표 | 측정 대상 |
|---|---|
| Warping error | 위상(topology) 오류. 분할 결과를 정답에 맞게 “휘어서” 맞출 때 바꿔야 하는 픽셀 수로, 막이 끊기거나 합쳐지는 오류에 민감 |
| Rand error | 픽셀 쌍이 같은 영역에 속하는지에 대한 일치도. 영역 분할 품질을 반영 |
| Pixel error | 단순 픽셀 단위 불일치 |
| IOU | 예측 마스크와 정답 마스크의 교집합 대 합집합 비율 |
EM 챌린지 순위는 warping error 로 정렬되므로, U-Net 이 후처리 없이 1 위를 차지한 것은 막의 연결 위상을 가장 잘 보존했다는 뜻입니다.
💡 Key Takeaway 전자 현미경, 위상차, DIC 라는 세 가지 다른 영상 양식에서 같은 구조로 최고 성능을 냈습니다. DIC-HeLa 의 77.5% 대 46% 는 가중 손실이 붙은 세포 분리에 얼마나 효과적인지를 보여줍니다.
한계와 열린 방향
논문의 한계는 본문에 많이 적혀 있지 않지만, 설계와 실험 범위에서 읽어낼 수 있는 것들과 이후 연구가 보완한 지점을 정리합니다.
⚠️ 1. 설계상의 제약
| 항목 | 내용 |
|---|---|
| 유효 합성곱의 비용 | 출력이 입력보다 작아 overlap-tile 과 거울 반사가 필수. 이후 많은 구현은 패딩 합성곱으로 단순화 |
| 입력 크기 제약 | 모든 맥스풀링이 짝수 크기 층에 적용되도록 타일 크기를 골라야 함 |
| 가중치 맵의 하이퍼파라미터 | $w_{0}=10$, $\sigma\approx5$ 는 실험적으로 정한 값이며 과제마다 조정 필요 |
| 배치 1 | 큰 타일을 위해 배치를 1 로 줄였으므로 배치 정규화 같은 후대 기법과의 결합은 별도 고려 필요 |
| 2D 전용 | 전자 현미경 스택과 세포 이미지 모두 2D 슬라이스 단위로 처리 |
🔬 2. 평가의 범위
- 세 데이터셋 모두 생의학 현미경 영상이며, 자연 이미지나 다른 도메인에서의 성능은 다루지 않습니다.
- 구조의 각 요소(스킵 연결, 채널 수, 가중 손실, 탄성 변형)에 대한 절제 실험이 없어 개별 기여도를 분리하기 어렵습니다.
- EM 챌린지 결과는 7 개 회전 평균이라는 테스트 시 증강을 포함합니다.
🔗 3. 후속 연구로의 연결
| 방향 | 내용 |
|---|---|
| 3D 확장 | 체적 데이터를 위한 3D U-Net 류 구조 |
| 범용 분할 백본 | 생의학을 넘어 다양한 분할 과제의 기본 구조로 채택 |
| 생성 모델의 생성기 | Pix2Pix 는 U-Net 의 스킵 연결 형태를 이미지 대 이미지 변환 생성기에 채택해, 인코더-디코더 대비 FCN-score 가 크게 오름을 보임(Pix2Pix Table 2) |
| 확산 모델의 잡음 예측기 | 이후 이미지 확산 모델들이 U-Net 을 잡음 예측 네트워크의 기본 구조로 사용 |
| 저자들의 전망 | “U-Net 구조는 더 많은 과제에 쉽게 적용될 수 있다고 확신한다”는 결론은 이후 폭넓게 실현됨 |
💡 Key Takeaway U-Net 은 생의학 분할을 위해 태어났지만, “고해상도 특징을 잘라 붙이는 대칭 인코더-디코더” 라는 형태 자체가 변환·생성 모델 전반의 기본 부품이 되었습니다.