 You know maize mean?
Conditional Generative Adversarial Nets
0. Summary
기본 정보 : ArXiv,2014.11.06, Conditional Generative Adversarial Nets
연구 배경
GAN 은 다루기 어려운 확률 계산의 근사를 피하면서 생성 모델을 학습하는 대안 프레임워크로 막 소개되었고, 마르코프 체인 없이 역전파만으로 학습되며 학습 중 추론이 필요 없고 다양한 인자와 상호작용을 쉽게 통합할 수 있다는 장점이 있었다. 그러나 조건 없는 생성 모델에서는 생성되는 데이터의 모드를 제어할 방법이 없다. 한편 지도 신경망은 예측해야 할 출력 범주가 극도로 많은 경우로 확장하기 어렵고, 대부분의 연구가 입력에서 출력으로의 일대일 사상에 집중했지만 이미지 태깅처럼 하나의 이미지에 여러 태그가 적절히 붙을 수 있는 문제는 본질적으로 확률적 일대다 사상이다. 전자는 다른 모달리티(자연어 코퍼스로 학습한 라벨 벡터 표현)의 추가 정보를 활용해, 후자는 조건부 확률 생성 모델로 접근할 수 있다.
제안 방법
조건으로 삼고 싶은 추가 정보 $y$ (클래스 라벨, 다른 모달리티의 데이터 등)를 생성기와 판별기 모두에 추가 입력층으로 공급하면 GAN 을 조건부 모델로 확장할 수 있다. 생성기에서는 사전 잡음 $p_{z}(z)$ 와 $y$ 가 결합 은닉 표현으로 합쳐지고, 적대적 학습 프레임워크는 이 은닉 표현의 구성 방식에 상당한 유연성을 허용한다. 판별기에는 $x$ 와 $y$ 가 입력으로 주어진다. 목적함수는 $\min_{G}\max_{D}V(D,G)=\mathbb{E}{x\sim p{data}(x)}[\log D(x\mid y)]+\mathbb{E}{z\sim p{z}(z)}[\log(1-D(G(z\mid y)))]$ 이다 (Eq. 2). 실험은 클래스 라벨을 조건으로 한 MNIST 숫자 생성(단일 모달)과, 이미지 특징을 조건으로 태그 단어 벡터를 생성하는 MIR Flickr 25,000 자동 태깅(다중 모달) 두 가지다.
발견 사실
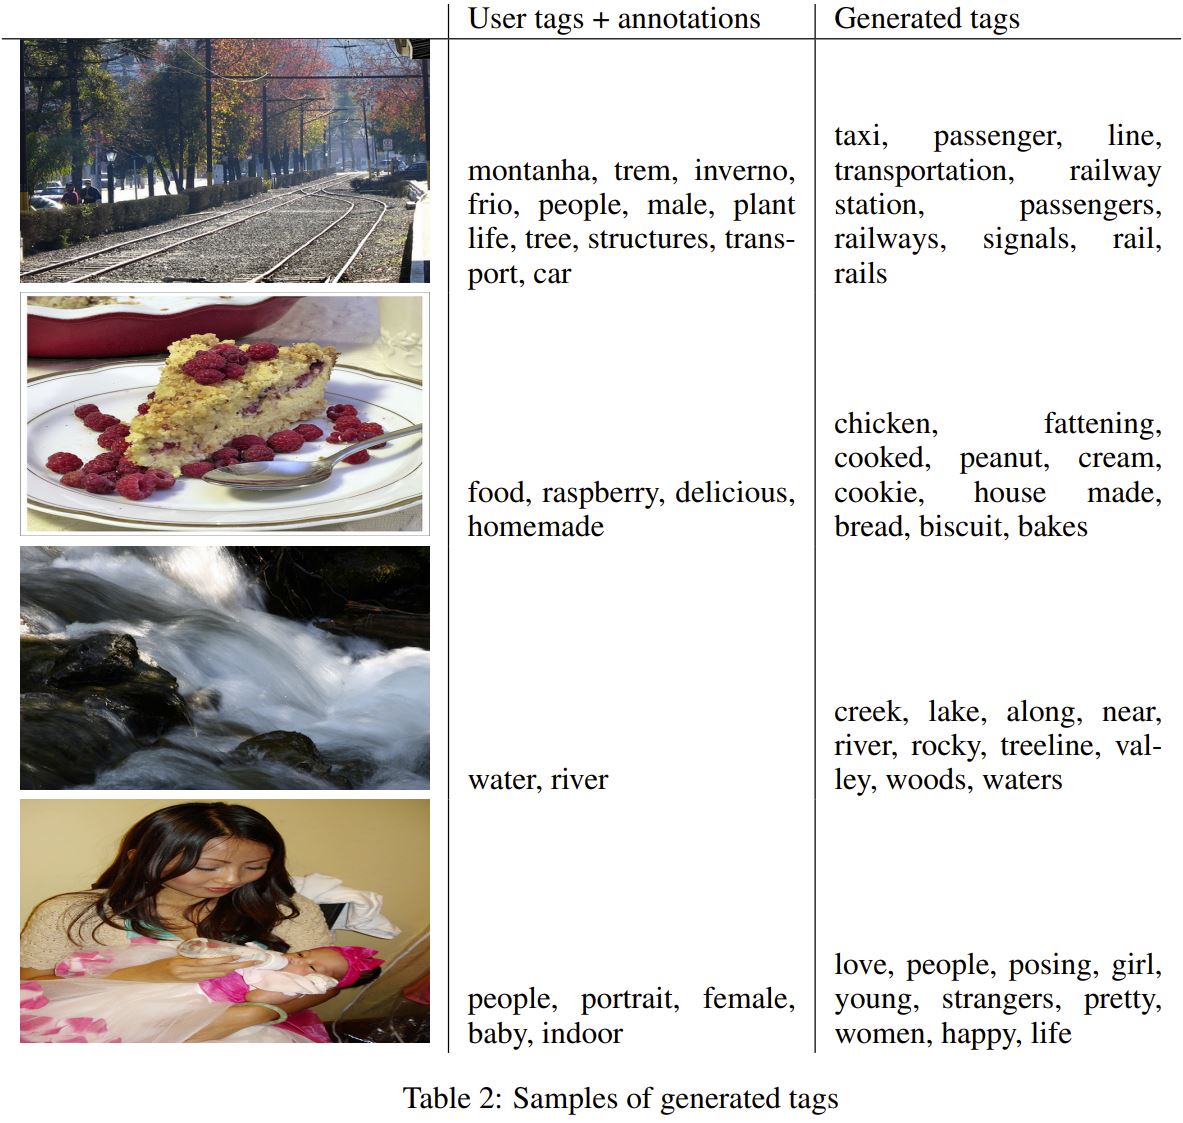
원-핫 클래스 라벨을 조건으로 학습한 MNIST 조건부 GAN 은 각 행이 하나의 라벨로 조건화된 숫자 샘플을 생성했다(Figure 2). 가우시안 Parzen window 로그우도 추정은 $132\pm1.8$ 로, DBN($138\pm2$), Deep GSN($214\pm1.1$), 비조건부 적대 신경망($225\pm2$) 등 여러 방법보다 낮았고 저자들은 이를 효능의 입증이 아니라 개념 증명(proof-of-concept) 으로 제시했다(Table 1). 다중 모달 실험에서는 ImageNet 21,000 라벨로 사전학습한 합성곱 모델의 4096 차원 특징과 YFCC100M 메타데이터로 학습한 200 차원 skip-gram 단어 벡터를 고정한 채 조건부 GAN 을 학습했고, 이미지당 100 개 샘플을 생성해 코사인 유사도 상위 20 단어 중 가장 흔한 10 개를 태그로 뽑았다. 사용자 태그가 “water, river” 인 이미지에 “creek, lake, river, rocky, valley, woods” 처럼 훈련 라벨에 없는 서술적 태그가 생성되었다(Table 2).
핵심 기여
- 조건부 GAN 의 정식화 : 생성기와 판별기 양쪽에 조건 $y$ 를 입력으로 주는 단순한 구성으로 GAN 을 조건부 생성 모델로 확장하고, 그 미니맥스 목적함수를 제시했다. 원 GAN 논문이 후속 연구로 제안한 첫 항목을 구현한 것이다.
- 클래스 조건 생성의 시연 : MNIST 에서 클래스 라벨로 조건화된 숫자를 생성해 데이터 생성 과정을 지시(direct) 할 수 있음을 보였다.
- 다중 모달 학습과 이미지 태깅 응용 : 이미지 특징을 조건으로 태그 단어 벡터의 (다중 모드일 수 있는) 분포를 생성하는 방식으로, 훈련 라벨의 일부가 아닌 서술적 태그를 생성하는 예비 결과를 제시했다.
관련 개념
조건부 적대 신경망의 구조 (Section 3)
조건부 적대 신경망(Conditional Adversarial Nets) 은 GAN 의 두 네트워크에 조건 변수 $y$ 를 추가 입력으로 넣은 것입니다. 논문은 먼저 GAN 을 복습한 뒤 조건부 확장을 정의합니다.
🎯 1. GAN 복습 (Section 3.1, Eq. 1)
생성 모델 $G$ 는 데이터 분포를 포착하고, 판별 모델 $D$ 는 샘플이 $G$ 가 아닌 훈련 데이터에서 왔을 확률을 추정합니다. 둘 다 다층 퍼셉트론 같은 비선형 사상일 수 있습니다. 생성기는 사전 잡음 분포 $p_{z}(z)$ 에서 데이터 공간으로의 사상 $G(z;\theta_{g})$ 를 만들고, 판별기 $D(x;\theta_{d})$ 는 $x$ 가 $p_{g}$ 가 아닌 훈련 데이터에서 왔을 확률을 나타내는 단일 스칼라를 출력합니다.
\[\min_{G}\max_{D}V(D,G)=\mathbb{E}_{x\sim p_{data}(x)}[\log D(x)]+\mathbb{E}_{z\sim p_{z}(z)}[\log(1-D(G(z)))]\]$G$ 는 $\log(1-D(G(z)))$ 를 최소화하도록, $D$ 는 가치 함수를 최대화하도록 동시에 학습됩니다.
🔗 2. 조건부 확장 (Section 3.2, Eq. 2)
$y$ 는 클래스 라벨이나 다른 모달리티의 데이터 같은 어떤 종류의 보조 정보도 될 수 있습니다. $y$ 를 판별기와 생성기 양쪽에 추가 입력층으로 공급해 조건화합니다.
| 네트워크 | 입력 | 처리 |
|---|---|---|
| 생성기 | $p_{z}(z)$ 와 $y$ | 결합 은닉 표현(joint hidden representation)으로 합쳐짐. 적대적 학습 프레임워크는 이 은닉 표현의 구성 방식에 상당한 유연성을 허용 |
| 판별기 | $x$ 와 $y$ | 판별 함수(여기서는 MLP)의 입력으로 제시 |
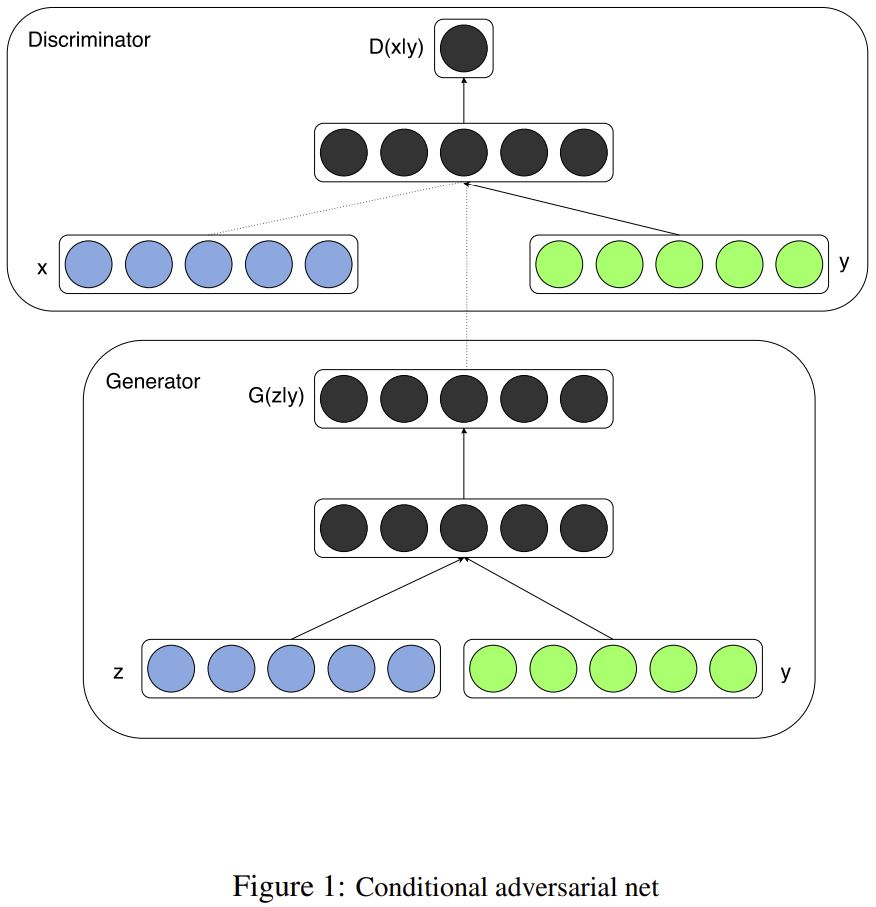
Figure 1 은 단순한 조건부 적대 신경망의 구조를 보여줍니다. 생성기 쪽에서 $z$ 와 $y$ 가, 판별기 쪽에서 $x$ 와 $y$ 가 각각 합쳐집니다.
🧭 3. 조건화의 종류
논문 서론은 조건화가 다음에 기반할 수 있다고 열거합니다.
| 조건의 종류 | 예 |
|---|---|
| 클래스 라벨 | MNIST 숫자 클래스 (Section 4.1) |
| 데이터의 일부 | 인페인팅처럼 이미지 일부를 조건으로 나머지 생성 |
| 다른 모달리티의 데이터 | 이미지 특징을 조건으로 태그 생성 (Section 4.2) |
이 셋은 각각 이후 class-conditional GAN, 이미지 조건부 GAN(Pix2Pix 등), 교차 모달 생성(text-to-image 등)으로 발전합니다.
🧪 4. 선행 다중 모달 연구와의 관계 (Section 2.1)
| 선행 연구 | 접근 | 조건부 GAN 과의 관계 |
|---|---|---|
| 이미지 특징 → 단어 표현 선형 사상 | 이미지 특징 공간에서 단어 벡터 공간으로의 단순 선형 사상으로 분류 성능 향상 | 같은 단어 임베딩 공간을 출력 공간으로 쓰되, 결정론적 사상 대신 조건부 분포를 생성 |
| 다중 모달 심층 볼츠만 머신 | MIR Flickr 25,000 에서 이미지·태그의 결합 분포를 학습 | 같은 데이터셋을 쓰지만 마르코프 체인 없이 역전파만으로 학습 |
| 지도 다중 모달 신경 언어 모델 | 이미지에 대한 서술 문장 생성 | 언어 모델을 과제에 맞게 학습할 수 있음을 보여, 논문이 제안한 공동 학습 방향의 근거 |
조건부 GAN 은 이 연구들과 달리 추론 없이 샘플링만으로 조건부 분포를 다루며, 조건 $y$ 의 모달리티에 아무 제약이 없습니다.
💡 Key Takeaway 조건부 GAN 의 전부는 “$y$ 를 $G$ 와 $D$ 둘 다에 넣는다“입니다. 판별기도 $y$ 를 보기 때문에 생성기는 그럴듯할 뿐 아니라 조건에 맞는 샘플을 만들어야 합니다.
단일 모달 실험: MNIST 클래스 조건 생성 (Section 4.1)
MNIST 실험은 원-핫 벡터로 부호화한 클래스 라벨을 조건으로 조건부 적대 신경망을 학습한 것입니다. 구조와 학습 설정이 상세히 기술되어 있어 조건부 GAN 의 초기 구현 방식을 엿볼 수 있습니다.
🏗️ 1. 생성기 구조
| 층 | 설정 |
|---|---|
| 잡음 사전 $z$ | 단위 초입방체 내 균등분포, 100 차원 |
| $z$ 은닉층 | ReLU, 200 유닛 |
| $y$ 은닉층 | ReLU, 1000 유닛 |
| 결합 은닉층 | 두 은닉층을 합친 ReLU, 1200 차원 |
| 출력층 | 시그모이드, 784 차원 MNIST 샘플 |
🏗️ 2. 판별기 구조
| 층 | 설정 |
|---|---|
| $x$ 층 | maxout, 240 유닛 × 5 조각 |
| $y$ 층 | maxout, 50 유닛 × 5 조각 |
| 결합 층 | maxout, 240 유닛 × 4 조각 |
| 출력 | 시그모이드 |
저자들은 판별기의 정확한 구조는 충분한 능력만 있으면 중요하지 않으며, maxout 유닛이 이 과제에 대체로 잘 맞는다고 적습니다.
⚙️ 3. 학습 설정
| 항목 | 값 |
|---|---|
| 최적화 | 확률적 경사하강, 미니배치 100 |
| 학습률 | 초기 0.1, 감쇠 인자 1.00004 로 지수적으로 0.000001 까지 감소 |
| 모멘텀 | 초기 0.5, 0.7 까지 증가 |
| 드롭아웃 | 확률 0.5, 생성기와 판별기 모두 |
| 종료 기준 | 검증 집합의 로그우도 최선 추정치 |
🔁 4. 비조건부 GAN 과의 구조 차이
| 항목 | GAN (Goodfellow et al.) | 조건부 GAN (본 논문) |
|---|---|---|
| 생성기 입력 | $z$ | $z$ 와 $y$ (각각 은닉층을 거쳐 결합) |
| 판별기 입력 | $x$ | $x$ 와 $y$ (각각 maxout 층을 거쳐 결합) |
| 판별기의 판단 | $x$ 가 진짜인가 | $x$ 가 조건 $y$ 아래에서 진짜인가 |
| 생성의 제어 | 불가능 (모드를 고를 수 없음) | $y$ 로 모드를 지시 |
| 학습 절차 | 교대 경사하강 | 동일 |
판별기가 $y$ 를 보지 않으면 생성기는 어떤 $y$ 에도 같은 그럴듯한 샘플을 내도 벌점을 받지 않습니다. 이 점은 이후 Pix2Pix 가 조건 없는 판별기 변형에서 입력과 무관한 출력으로의 붕괴를 관찰함으로써 실험적으로 확인됩니다.
💡 Key Takeaway 초기 조건부 GAN 은 $z$ 와 $y$ 를 각자 은닉층으로 올린 뒤 합치는 구조였습니다. 이후에는 라벨 임베딩을 단순 연결하거나 조건부 배치 정규화로 주입하는 방식으로 단순화됩니다.
MNIST 결과와 Parzen Window 평가 (Table 1, Figure 2)
평가는 원 GAN 논문과 같은 절차의 가우시안 Parzen window 로그우도 추정을 따릅니다. 결과는 조건부 모델이 비조건부 모델에 미치지 못했고, 저자들은 이를 숨기지 않습니다.
📊 1. Parzen Window 로그우도 (Table 1)
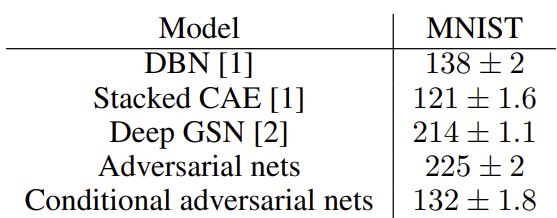
10 개 클래스 각각에서 1000 개 샘플을 뽑아 가우시안 Parzen window 를 맞추고, 그 분포로 테스트 집합의 로그우도를 추정했습니다.
| 모델 | MNIST |
|---|---|
| DBN | $138\pm2$ |
| Stacked CAE | $121\pm1.6$ |
| Deep GSN | $214\pm1.1$ |
| Adversarial nets | $225\pm2$ |
| Conditional adversarial nets | $132\pm1.8$ |
조건부 적대 신경망의 결과는 일부 네트워크 기반 방법과 비슷하지만 비조건부 적대 신경망을 포함한 여러 접근에 뒤집니다. 저자들은 이를 효능의 입증이 아니라 개념 증명으로 제시하며, 하이퍼파라미터 공간과 구조를 더 탐색하면 조건부 모델이 비조건부 결과에 필적하거나 넘어설 것이라고 믿는다고 적습니다.
🖼️ 2. 생성 샘플 (Figure 2)
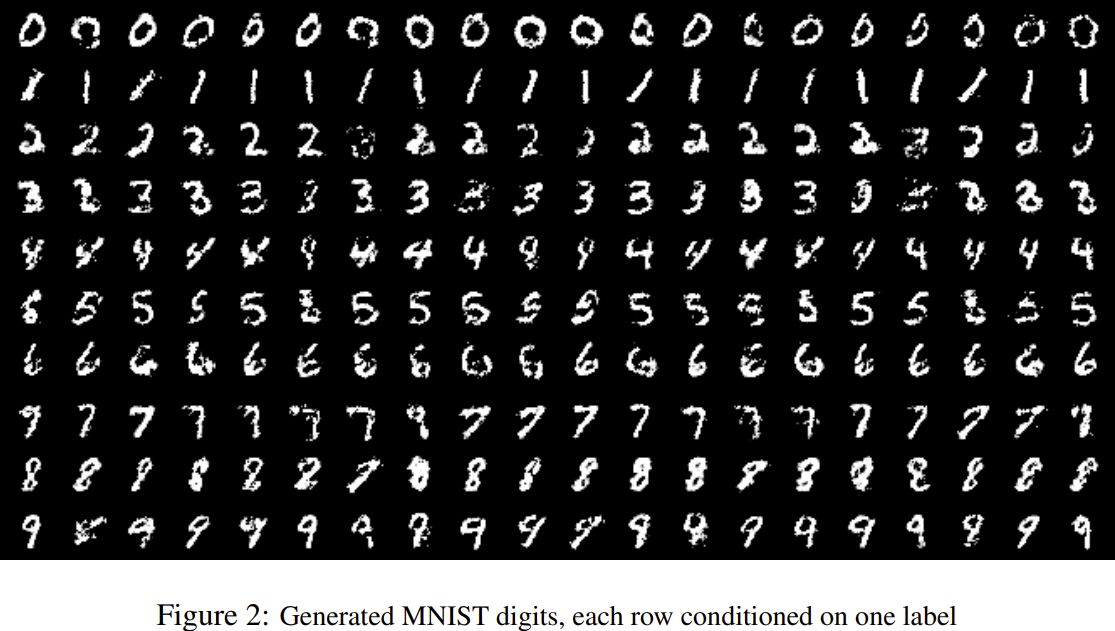
각 행은 하나의 라벨로 조건화되고 각 열은 서로 다른 생성 샘플입니다. 0 부터 9 까지 행마다 해당 숫자가 생성되어, 조건 $y$ 가 생성되는 데이터의 모드를 지시함을 보여줍니다.
🧐 3. 해석
- Parzen window 추정은 원 GAN 논문도 인정했듯 분산이 크고 고차원에서 잘 작동하지 않는 지표입니다. 조건부 모델의 낮은 수치가 샘플 품질의 열위를 직접 의미하지는 않습니다.
- 조건부 모델은 클래스당 1000 개씩 균등하게 샘플링했으므로 클래스 혼합 비율이 테스트 분포와 다를 수 있다는 점도 고려해야 합니다.
- 이 논문의 가치는 수치가 아니라 조건으로 생성을 제어할 수 있다는 것을 보인 데 있습니다.
💡 Key Takeaway Table 1 의 $132\pm1.8$ 은 비조건부 GAN 의 $225\pm2$ 보다 낮지만, 저자들은 이를 개념 증명으로 명확히 자리매김했습니다. 제어 가능성이 이 논문의 핵심 메시지입니다.
다중 모달 학습: 이미지 태깅 (Section 2.1, 4.2)
다중 모달 학습(multi-modal learning) 실험은 조건부 GAN 의 진짜 야심을 보여줍니다. Flickr 같은 사진 사이트는 이미지와 사용자 생성 메타데이터(user-generated metadata, UGM), 특히 사용자 태그 형태의 풍부한 라벨 데이터 원천입니다.
🏷️ 1. 사용자 태그의 특성과 두 가지 문제
| UGM 의 특성 | 함의 |
|---|---|
| 더 서술적이며, 객체 식별보다 사람이 자연어로 이미지를 묘사하는 방식에 의미적으로 가까움 | 정식 라벨링 체계와 다른 종류의 지도 신호 |
| 동의어가 만연하고 사용자마다 같은 개념에 다른 어휘 사용 | 라벨을 정규화할 효율적 방법이 중요. 관련 개념이 유사한 벡터로 표현되는 개념적 단어 임베딩이 유용 |
서론에서 제기한 두 문제에 대한 해법은 다음과 같습니다.
| 문제 | 해법 |
|---|---|
| 출력 범주가 극도로 많은 경우로 확장하기 어려움 | 다른 모달리티(자연어 코퍼스)의 정보로 기하 관계가 의미 있는 라벨 벡터 표현을 학습. 예측이 틀려도 종종 진실에 “가깝고”(table 대신 chair), 훈련 때 보지 못한 라벨로 자연스럽게 일반화. 이미지 특징 공간에서 단어 표현 공간으로의 단순 선형 사상도 분류 성능을 높인다는 선행 연구 |
| 일대일 사상에 집중 | 입력을 조건 변수로 삼고 일대다 사상을 조건부 예측 분포로 구현하는 조건부 확률 생성 모델 |
🧩 2. 특징 추출: 고정된 두 사전학습 모델
| 모달리티 | 모델 | 출력 |
|---|---|---|
| 이미지 | ImageNet 전체(21,000 라벨)로 사전학습한 합성곱 모델 | 마지막 완전연결층 4096 유닛 |
| 단어 | YFCC100M 메타데이터의 사용자 태그·제목·설명을 연결한 코퍼스로 학습한 skip-gram | 200 차원 단어 벡터. 200 회 미만 등장 단어 제외, 사전 크기 247,465 |
두 모델은 적대 신경망 학습 중 고정되며, 이 모델들까지 역전파하는 실험은 후속 연구로 남겼습니다.
📦 3. 데이터 구성
- MIR Flickr 25,000 데이터셋에서 위 두 모델로 이미지·태그 특징을 추출했습니다.
- 태그가 없는 이미지는 제외했고 주석(annotation)은 추가 태그로 취급했습니다.
- 처음 150,000 개 예시를 훈련 집합으로 썼으며, 태그가 여러 개인 이미지는 연관 태그마다 한 번씩 훈련 집합 안에 반복됩니다.
💡 Key Takeaway 이미지 태깅을 “분류”가 아니라 “이미지 특징을 조건으로 단어 벡터를 생성“하는 문제로 바꾼 것이 이 실험의 발상입니다. 단어 임베딩 공간 덕분에 훈련 라벨 밖의 태그도 나올 수 있습니다.
다중 모달 모델의 구조, 학습, 평가 (Section 4.2)
최선의 모델은 교차검증과 랜덤 그리드 서치·수동 선택의 혼합(다소 제한된 탐색 공간)으로 하이퍼파라미터와 구조를 정했습니다.
🏗️ 1. 생성기와 판별기
| 네트워크 | 구성 |
|---|---|
| 생성기 | 100 차원 가우시안 잡음 → 500 차원 ReLU 층. 4096 차원 이미지 특징 → 2000 차원 ReLU 은닉층. 둘을 200 차원 선형 결합층으로 사상해 생성 단어 벡터 출력 |
| 판별기 | 단어 벡터용 500 차원, 이미지 특징용 1200 차원 ReLU 은닉층. 결합층은 1000 유닛 × 3 조각 maxout. 최종 단일 시그모이드 유닛 |
생성기 출력층이 선형인 이유는 출력이 확률이나 픽셀이 아니라 실수값 단어 벡터이기 때문입니다.
⚙️ 2. 학습 설정
MNIST 와 동일합니다. 미니배치 100 의 확률적 경사하강, 초기 학습률 0.1 을 감쇠 인자 1.00004 로 0.000001 까지 지수 감소, 모멘텀 0.5 에서 0.7 로 증가, 생성기·판별기 모두 확률 0.5 드롭아웃입니다.
🔍 3. 평가 절차와 생성 태그 (Table 2)
| 단계 | 내용 |
|---|---|
| 1 | 각 이미지에 대해 100 개 샘플(단어 벡터) 생성 |
| 2 | 각 샘플에 대해 어휘 내 단어 벡터와의 코사인 유사도로 가장 가까운 20 단어 탐색 |
| 3 | 100 개 샘플 전체에서 가장 흔한 상위 10 단어 선택 |
| 사용자 태그 + 주석 | 생성 태그 |
|---|---|
| montanha, trem, inverno, frio, people, male, plant life, tree, structures, transport, car | taxi, passenger, line, transportation, railway station, passengers, railways, signals, rail, rails |
| food, raspberry, delicious, homemade | chicken, fattening, cooked, peanut, cream, cookie, house made, bread, biscuit, bakes |
| water, river | creek, lake, along, near, river, rocky, treeline, valley, woods, waters |
| people, portrait, female, baby, indoor | love, people, posing, girl, young, strangers, pretty, women, happy, life |
생성 태그는 사용자 태그와 어휘가 다르더라도 의미적으로 관련된 서술어(“water, river” → “creek, lake, valley, woods”)를 포함하며, 이것이 훈련 라벨의 일부가 아닌 서술적 태그를 생성한다는 주장의 근거입니다. 정량 평가 지표는 제시되지 않았습니다.
💡 Key Takeaway 생성된 100 개 단어 벡터를 어휘로 되돌려 투표하는 절차는 일대다 분포에서 다수 모드를 읽어내는 방식입니다. 조건부 GAN 이 태그의 분포를 모델링한다는 발상이 여기에 담겨 있습니다.
한계와 열린 방향 (Section 5)
결론에서 저자들은 결과가 “극도로 예비적(extremely preliminary)” 이라고 명시합니다. 이 논문은 워크숍 발표를 앞둔 초기 보고서 성격이 강하며, 한계와 후속 계획이 비교적 투명하게 적혀 있습니다.
⚠️ 1. 명시된 한계
| 항목 | 내용 |
|---|---|
| MNIST 정량 성능 | Parzen window 로그우도가 비조건부 GAN 보다 낮음. 하이퍼파라미터·구조 탐색이 충분하지 않았음을 인정 |
| 태깅 평가 | 생성 태그의 정성적 예시만 제시. 정량 지표 없음 |
| 태그 단위 처리 | 현재 실험은 각 태그를 개별적으로 사용. 태그가 여러 개인 이미지는 태그마다 반복 |
| 고정된 특징 추출기 | 합성곱 모델과 언어 모델을 고정하고 적대 신경망만 학습 |
| 탐색 공간 | 하이퍼파라미터·구조 선택이 다소 제한된 탐색 공간에서 이루어짐 |
🔭 2. 저자들이 제안한 후속 방향
| 방향 | 내용 |
|---|---|
| 더 정교한 모델 | 워크숍까지 더 정교한 모델과 성능·특성에 대한 더 상세하고 철저한 분석을 제시할 계획 |
| 집합 생성 | 여러 태그를 동시에 사용해 생성 문제를 “집합 생성(set generation)” 으로 제기하면 더 나은 결과 기대 |
| 언어 모델 공동 학습 | 특정 과제에 맞는 언어 모델을 학습할 수 있다는 선행 연구에 따라, 언어 모델을 함께 학습하는 공동 학습 체계 구축 |
🔗 3. 이후 연구에서의 위치
- 클래스 조건 생성 : DCGAN 의 보충 자료는 조건부 DCGAN 으로 MNIST 조건부 분포를 평가했고, 이후 class-conditional GAN 은 대규모 이미지 생성의 표준이 되었습니다.
- 이미지 조건부 생성 : Pix2Pix 는 “조건을 $G$ 와 $D$ 모두에 넣는다”는 원리를 이미지 대 이미지 변환에 적용하면서, 판별기가 조건을 보지 않는 비조건부 변형이 입력과 무관한 출력으로 붕괴함을 실험으로 보여 조건부 판별기의 중요성을 확인했습니다.
- 교차 모달 생성 : 이미지 특징 → 단어 벡터라는 방향은 이후 텍스트 → 이미지 생성으로 뒤집혀 발전했습니다.
- 조건 주입 방식 : 은닉층을 따로 두고 합치는 방식에서 임베딩 연결, 조건부 배치 정규화, 사영 판별기 등으로 다양화되었습니다.
💡 Key Takeaway 이 논문은 수치보다 아이디어의 단순함으로 기억됩니다. “조건을 양쪽에 넣는다”는 한 줄이 이후 조건부 생성 연구 전체의 공통 출발점이 되었습니다.