 You know maize mean?
Image-to-Image Translation with Conditional Adversarial Networks
0. Summary
기본 정보 : ArXiv,2016.11.21 (CVPR 2017), Image-to-Image Translation with Conditional Adversarial Networks
연구 배경
이미지 처리·그래픽스·비전의 많은 문제는 입력 이미지를 대응하는 출력 이미지로 “번역”하는 것으로 볼 수 있다. 한 장면은 RGB 이미지, 기울기 장, 에지 맵, 시맨틱 라벨 맵 등으로 렌더링될 수 있고, 저자들은 충분한 훈련 데이터가 주어졌을 때 한 표현을 다른 표현으로 옮기는 문제를 이미지 대 이미지 변환(image-to-image translation) 이라 정의한다. 설정은 언제나 “픽셀에서 픽셀을 예측”으로 같은데도 과제마다 특수 목적의 기계가 따로 개발되어 왔다. CNN 이 공통 일꾼이 되었지만 손실 함수 설계에는 여전히 많은 수작업이 들어간다. 예측과 정답 픽셀 사이의 유클리드 거리를 최소화하라고 하면 CNN 은 그럴듯한 모든 출력을 평균해 흐릿한 결과를 낸다. “출력을 현실과 구별할 수 없게 만들라”는 고수준 목표만 지정하고 손실을 자동으로 학습하는 것이 바람직하며, GAN 이 바로 그 일을 한다. 조건부 GAN 을 쓴 선행 연구는 있었지만 특정 응용에 집중했고, 이미지 조건부 GAN 이 범용 해법으로 얼마나 효과적인지는 불분명했다.
제안 방법
조건부 GAN 의 목적 $\mathcal{L}{cGAN}(G,D)=\mathbb{E}{x,y}[\log D(x,y)]+\mathbb{E}{x,z}[\log(1-D(x,G(x,z)))]$ 에 L1 거리 $\mathcal{L}{L1}(G)=\mathbb{E}{x,y,z}[|y-G(x,z)|{1}]$ 를 $\lambda=100$ 으로 더한 $G^{*}=\arg\min_{G}\max_{D}\mathcal{L}{cGAN}+\lambda\mathcal{L}{L1}$ 을 최종 목적으로 쓴다(Eq. 4). 생성기는 인코더-디코더에 층 $i$ 와 층 $n-i$ 를 잇는 스킵 연결을 더한 U-Net 구조로 입력과 출력이 공유하는 저수준 정보를 병목 없이 전달하고, 판별기는 $N\times N$ 패치 단위로 진짜/가짜를 판정해 응답을 평균하는 PatchGAN 으로 고주파 구조만 모델링하며 저주파 정확성은 L1 에 맡긴다. 잡음은 생성기 여러 층의 드롭아웃으로만 주입하며 테스트 시에도 적용한다. 생성기·판별기 모듈은 DCGAN 의 convolution-BatchNorm-ReLU 를 따르고, 최적화는 Adam(lr 0.0002, $\beta_{1}=0.5$)으로 $D$ 와 $G$ 를 한 스텝씩 교대한다.
발견 사실
Cityscapes 라벨→사진에서 FCN-score 로 측정한 결과, L1 단독은 흐리고(픽셀 정확도 0.42), 조건 없는 GAN 은 입력과 무관한 출력으로 붕괴했으며(0.22), cGAN 은 0.57, L1+cGAN 은 0.66 으로 가장 좋았다(Table 1). U-Net 은 인코더-디코더보다 L1, L1+cGAN 양쪽에서 우수했다(Table 2). 판별기 수용 영역은 $1\times1$ PixelGAN(0.39), $16\times16$(0.65), $70\times70$(0.66), $286\times286$ ImageGAN(0.42) 순으로 $70\times70$ 이 최선이었다(Table 3). AMT 지각 실험에서 지도→항공사진은 18.9% 의 시행에서 참가자를 속였고 L1 베이스라인(0.8%)을 크게 앞섰으나, 사진→지도는 6.1% 로 L1(2.8%)과 유의한 차이가 없었다(Table 4). 컬러화에서는 22.5% 로 Zhang et al. 의 L2 변형(16.3%)과 비슷했지만 전용 방법(27.8%)에는 못 미쳤다(Table 5). 사진→라벨 시맨틱 분할에서는 cGAN 단독도 어느 정도 성공했지만 L1 회귀가 더 좋았다(Table 6). cGAN 은 L1 이 만드는 회색빛 평균 색 대신 실제 색 분포에 가까운 출력을 냈다(Figure 6).
핵심 기여
- 범용 이미지 대 이미지 변환 프레임워크 : 같은 구조와 목적함수로 라벨→사진, 에지→사진, 컬러화, 지도↔항공사진, 낮→밤 등 다양한 과제에서 합리적인 결과를 얻음을 보여, 손실 함수를 수작업 설계하지 않아도 됨을 입증했다.
- 구조적 선택의 분석 : L1, GAN, cGAN 의 조합, U-Net 대 인코더-디코더, PatchGAN 패치 크기에 대한 체계적 절제 실험으로 L1+cGAN, U-Net, $70\times70$ PatchGAN 이라는 레시피를 확립했다.
- PatchGAN 과 완전 합성곱 변환 : 패치 단위 마르코프 판별기가 적은 파라미터로 빠르게 작동하며, $256\times256$ 으로 학습한 생성기를 $512\times512$ 이미지에 합성곱적으로 적용할 수 있음을 보였다. 공개 코드 pix2pix 는 커뮤니티 주도의 수많은 응용(#edges2cats 등)을 낳았다.
관련 개념
목적함수: cGAN + L1 (Section 3.1)
목적함수는 조건부 적대 손실과 L1 재구성 손실의 가중합입니다. 조건부 GAN 은 관측 이미지 $x$ 와 잡음 $z$ 에서 출력 $y$ 로의 사상 $G:(x,z)\to y$ 를 학습하며, 판별기 $D$ 는 생성기의 “가짜”를 최대한 잘 탐지하도록 적대적으로 학습됩니다 (Figure 2).

🎯 1. 네 개의 식
| 식 | 내용 | 역할 |
|---|---|---|
| (1) | $\mathcal{L}{cGAN}(G,D)=\mathbb{E}{x,y}[\log D(x,y)]+\mathbb{E}_{x,z}[\log(1-D(x,G(x,z)))]$ | 조건부 적대 손실. $D$ 가 입력 $x$ 를 관측 |
| (2) | $\mathcal{L}{GAN}(G,D)=\mathbb{E}{y}[\log D(y)]+\mathbb{E}_{x,z}[\log(1-D(G(x,z)))]$ | 판별기가 $x$ 를 보지 않는 비조건부 변형. 조건화의 중요성을 검증하기 위한 대조군 |
| (3) | $\mathcal{L}{L1}(G)=\mathbb{E}{x,y,z}[|y-G(x,z)|_{1}]$ | 정답과의 L1 거리. L2 보다 덜 흐리게 만들므로 L1 선택 |
| (4) | $G^{*}=\arg\min_{G}\max_{D}\mathcal{L}{cGAN}(G,D)+\lambda\mathcal{L}{L1}(G)$ | 최종 목적. 실험에서 $\lambda=100$ |
선행 연구는 GAN 목적을 L2 같은 전통적 손실과 섞는 것이 유익함을 발견했습니다. 판별기의 역할은 그대로이고, 생성기는 판별기를 속일 뿐 아니라 정답 출력에 가까워야 합니다.
🎲 2. 잡음 $z$ 의 처리
| 선택지 | 결과 |
|---|---|
| $z$ 없음 | $x\to y$ 사상은 학습되지만 결정론적 출력이 되어 델타 함수 외의 분포를 맞출 수 없음 |
| 가우시안 잡음 $z$ 를 입력에 추가 | 초기 실험에서 효과 없음. 생성기가 잡음을 그냥 무시하도록 학습 (Mathieu et al. 과 일치) |
| 드롭아웃 (채택) | 생성기 여러 층에 학습과 테스트 시 모두 적용 |
드롭아웃 잡음에도 불구하고 출력의 확률성은 미미하게만 관찰되었습니다. 조건부 분포의 전체 엔트로피를 포착하는 고도로 확률적인 출력을 내는 조건부 GAN 설계는 중요한 열린 문제로 남겨 두었습니다.
🧱 3. 구조적 손실(structured loss)의 관점 (Section 2)
이미지 대 이미지 변환은 흔히 픽셀별 분류·회귀로 정식화되는데, 이는 입력이 주어졌을 때 각 출력 픽셀이 다른 모든 픽셀과 조건부 독립이라고 보는 “비구조적” 출력 공간 취급입니다. 조건부 GAN 은 출력의 결합 구성에 벌점을 주는 구조적 손실을 학습합니다. 조건부 랜덤 필드, SSIM, 특징 매칭, 비모수 손실, 합성곱 유사 사전, 공분산 통계 매칭 같은 구조적 손실이 있었지만, 조건부 GAN 은 손실이 학습되며 이론상 출력과 목표 사이의 어떤 구조 차이에도 벌점을 줄 수 있다는 점이 다릅니다.
💡 Key Takeaway L1 은 “대체로 맞게”, cGAN 은 “진짜처럼 보이게” 만듭니다. 둘을 $\lambda=100$ 으로 섞은 것이 Pix2Pix 의 손실이며, 잡음은 드롭아웃으로만 들어갑니다.
생성기: 스킵 연결을 가진 U-Net (Section 3.2.1)
생성기 구조는 이미지 대 이미지 변환 문제의 정의적 특징에서 출발합니다. 고해상도 입력 격자를 고해상도 출력 격자로 사상하며, 입력과 출력은 표면 외양은 다르지만 같은 기저 구조의 렌더링이므로 입력의 구조가 출력의 구조와 대략 정렬되어 있습니다.
🔀 1. 인코더-디코더의 병목 문제
이 영역의 많은 선행 해법은 입력을 점진적으로 다운샘플링해 병목층에 이른 뒤 과정을 뒤집는 인코더-디코더 네트워크를 썼습니다. 이런 네트워크는 모든 정보 흐름이 병목을 포함한 모든 층을 지나야 합니다. 그러나 많은 이미지 변환 문제에서는 입력과 출력이 많은 저수준 정보를 공유하므로 이를 네트워크를 가로질러 직접 전달하는 것이 바람직합니다. 컬러화에서 입력과 출력이 두드러진 에지의 위치를 공유하는 것이 그 예입니다.
🪢 2. U-Net 스킵 연결
| 항목 | 내용 |
|---|---|
| 형태 | “U-Net” 의 일반적 형태를 따름 |
| 연결 규칙 | 층 $i$ 와 층 $n-i$ 사이에 스킵 연결 ($n$ 은 총 층 수) |
| 연산 | 층 $i$ 의 모든 채널을 층 $n-i$ 의 채널과 단순 연결(concatenate) |
| 모듈 | 생성기·판별기 모두 DCGAN 에서 가져온 convolution-BatchNorm-ReLU 모듈 사용 |
📊 3. 효과 (Section 4.3, Figure 4, Table 2)
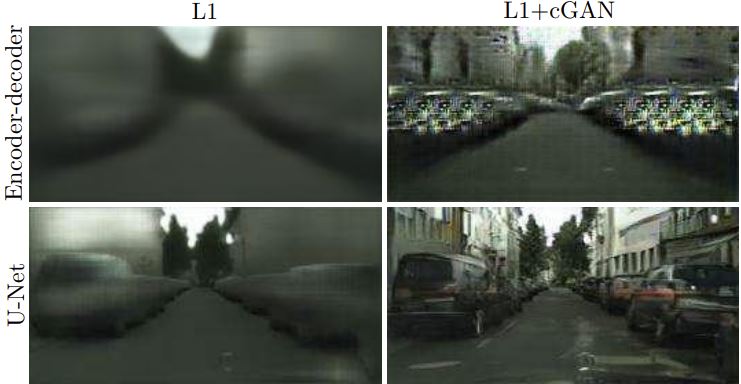
인코더-디코더는 U-Net 의 스킵 연결을 끊어 만들었습니다. Cityscapes 생성에서 인코더-디코더는 현실적인 이미지 생성을 학습하지 못했습니다.
| 생성기 | 손실 | 픽셀 정확도 | 클래스 정확도 | 클래스 IOU |
|---|---|---|---|---|
| Encoder-decoder | L1 | 0.35 | 0.12 | 0.08 |
| Encoder-decoder | L1+cGAN | 0.29 | 0.09 | 0.05 |
| U-Net | L1 | 0.48 | 0.18 | 0.13 |
| U-Net | L1+cGAN | 0.55 | 0.20 | 0.14 |
U-Net 의 이점은 조건부 GAN 에 국한되지 않습니다. 둘 다 L1 손실만으로 학습해도 U-Net 이 다시 우수합니다. 이 실험은 배치 크기 10 을 썼기 때문에 다른 표의 수치와 직접 비교되지 않습니다.
💡 Key Takeaway 입력과 출력이 에지 위치 같은 저수준 구조를 공유한다면 그 정보를 병목을 우회해 직접 넘겨야 합니다. U-Net 의 스킵 연결이 바로 그 통로입니다.
판별기: 마르코프 PatchGAN (Section 3.2.2, 4.4)
PatchGAN 은 이미지 전체가 아니라 $N\times N$ 패치 단위로 진짜/가짜를 판정하는 판별기입니다. 설계의 출발점은 L1·L2 손실이 고주파 선명함은 만들지 못해도 저주파는 대체로 정확히 포착한다는 관찰입니다.
🧠 1. 설계 논리
| 관찰 | 결론 |
|---|---|
| L2 와 L1 은 이미지 생성에서 흐릿한 결과를 냄 (Figure 3) | 고주파 선명함을 장려하지 못함 |
| 그럼에도 저주파는 정확히 포착하는 경우가 많음 | 저주파 정확성에는 새 프레임워크가 필요 없고 L1 로 충분 |
| 따라서 GAN 판별기는 고주파 구조만 모델링하면 됨 | 고주파는 국소 패치의 구조만 보면 충분 |
PatchGAN 은 이미지의 각 $N\times N$ 패치가 진짜인지 가짜인지 분류하려 하고, 이미지 전체에 합성곱적으로 실행되어 모든 응답을 평균해 $D$ 의 최종 출력을 냅니다.
🧮 2. 마르코프 랜덤 필드 해석
$N$ 은 이미지 전체 크기보다 훨씬 작아도 고품질 결과를 냅니다. 작은 PatchGAN 은 파라미터가 적고, 빠르며, 임의 크기 이미지에 적용 가능합니다. 이런 판별기는 패치 지름보다 멀리 떨어진 픽셀 사이의 독립을 가정하므로 이미지를 사실상 마르코프 랜덤 필드(Markov random field) 로 모델링합니다. 이 연결은 선행 연구에서도 탐구되었고 질감·스타일 모델의 흔한 가정이기도 하므로, PatchGAN 은 일종의 질감/스타일 손실로 이해할 수 있습니다.
📏 3. PixelGAN 에서 ImageGAN 까지 (Table 3, Figure 5)
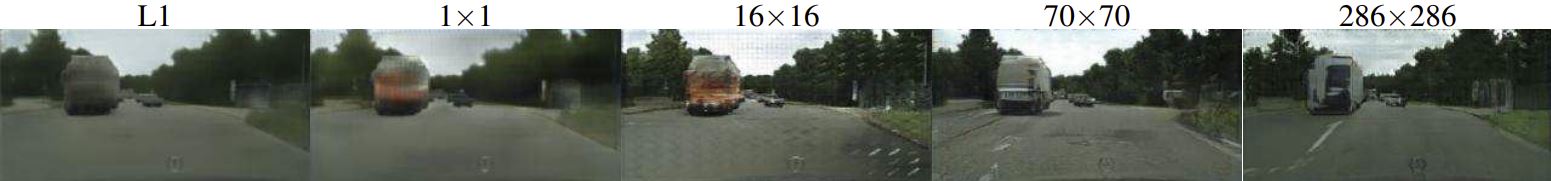
판별기 깊이를 조정해 패치 크기 $N$ 을 $1\times1$ “PixelGAN” 에서 전체 $286\times286$ “ImageGAN” 까지 바꾸었습니다. 이 절의 모든 실험은 L1+cGAN 손실을 썼고, 다른 모든 실험은 별도 언급이 없으면 $70\times70$ PatchGAN 을 씁니다. 입력은 $256\times256$ 이며 더 큰 수용 영역은 0 으로 패딩됩니다.
| 수용 영역 | 픽셀 정확도 | 클래스 정확도 | 클래스 IOU | 정성적 특징 |
|---|---|---|---|---|
| $1\times1$ | 0.39 | 0.15 | 0.10 | 공간 선명도에는 영향 없지만 색 다양성 증가. L1 로는 회색이던 버스가 빨갛게 됨. 색 히스토그램 매칭의 경량 해법 가능성 |
| $16\times16$ | 0.65 | 0.21 | 0.17 | 선명한 출력과 좋은 FCN-score 를 내지만 관찰 범위를 넘는 타일링 아티팩트 |
| $70\times70$ | 0.66 | 0.23 | 0.17 | 아티팩트 완화, 공간·스펙트럼 양쪽에서 선명. 기본값 |
| $286\times286$ | 0.42 | 0.16 | 0.11 | 시각 품질은 $70\times70$ 과 비슷하지만 FCN-score 가 상당히 낮음. 파라미터가 많고 깊어 학습이 어려운 것으로 추정 |
🖼️ 4. 완전 합성곱 변환 (Figure 7)
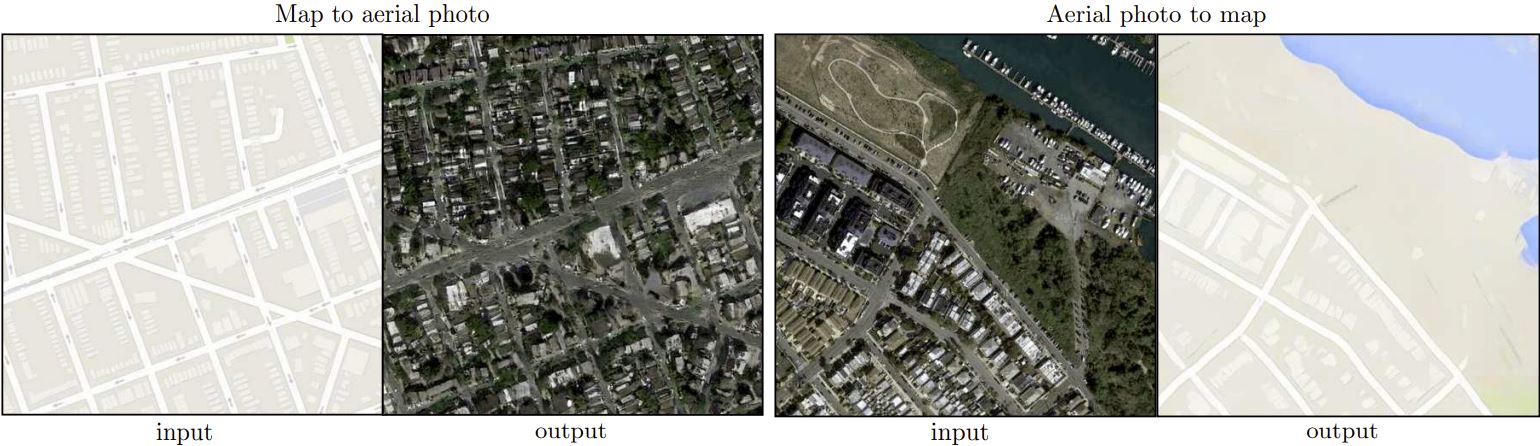
고정 크기 패치 판별기는 임의 크기 이미지에 적용될 수 있고, 생성기도 학습 때보다 큰 이미지에 합성곱적으로 적용할 수 있습니다. 지도↔항공사진 과제에서 $256\times256$ 으로 학습한 생성기를 $512\times512$ 이미지에서 테스트해 효과를 확인했습니다.
💡 Key Takeaway “저주파는 L1, 고주파는 패치 판별기”라는 역할 분담이 PatchGAN 의 정수입니다. $70\times70$ 이 선명함과 아티팩트 사이의 최적점이었습니다.
평가 지표와 목적함수 절제 실험 (Section 4.1, 4.2)
합성 이미지 품질 평가는 열려 있는 어려운 문제입니다. 픽셀별 평균제곱오차 같은 전통적 지표는 결과의 결합 통계를 평가하지 않으므로 구조적 손실이 포착하려는 바로 그 구조를 측정하지 못합니다. 논문은 두 가지 전략을 씁니다.
🧪 1. 두 가지 평가 전략
| 전략 | 내용 |
|---|---|
| AMT 지각 실험 | Amazon Mechanical Turk 에서 “진짜 대 가짜” 연구. 각 시행에서 진짜와 가짜가 1 초씩 제시된 뒤 사라지고 참가자가 어느 것이 가짜인지 무제한 시간으로 응답. 세션당 처음 10 개는 피드백 있는 연습, 본 실험 40 개는 피드백 없음. 한 세션은 한 알고리즘만, 참가자당 한 세션, 알고리즘당 약 50 명. 모든 이미지 $256\times256$. 컬러화는 같은 그레이스케일 입력에서 진짜·가짜 생성, 지도↔항공사진은 과제를 어렵게 하려고 다른 입력에서 생성 |
| FCN-score | 사전학습 시맨틱 분류기로 생성 자극의 판별 가능성을 측정하는 유사 지표. Cityscapes 로 학습한 FCN-8s 로 합성 사진을 분할하고, 그 사진을 합성할 때 쓴 라벨과의 분류 정확도로 점수화. 생성 이미지가 현실적이면 실제 이미지로 학습한 분류기도 올바르게 분류할 것이라는 직관 |
📊 2. 손실 절제 (Table 1, Figure 3)
| 손실 | 픽셀 정확도 | 클래스 정확도 | 클래스 IOU |
|---|---|---|---|
| L1 | 0.42 | 0.15 | 0.11 |
| GAN | 0.22 | 0.05 | 0.01 |
| cGAN | 0.57 | 0.22 | 0.16 |
| L1+GAN | 0.64 | 0.20 | 0.15 |
| L1+cGAN | 0.66 | 0.23 | 0.17 |
| Ground truth | 0.80 | 0.26 | 0.21 |
- L1 단독 : 합리적이지만 흐릿한 결과.
- cGAN 단독 ($\lambda=0$) : 훨씬 선명하지만 특정 응용에서 시각적 아티팩트. 두 항을 합치면($\lambda=100$) 아티팩트가 줄어듦.
- GAN (비조건부 판별기) : 손실이 입력과 출력의 불일치에 벌점을 주지 않고 출력이 현실적인지만 따지므로 매우 나쁜 성능. 생성기가 입력 사진과 무관하게 거의 같은 출력을 내도록 붕괴.
- L1+GAN : L1 항은 정답 출력(입력과 올바르게 대응)과 합성 출력 사이의 거리에 벌점을 주므로 출력이 입력을 존중하도록 장려. 그래서 조건 없는 GAN 에 L1 만 더해도 입력 라벨 맵을 존중하는 현실적 렌더링이 가능.
🎨 3. 색다움(colorfulness) 분석 (Figure 6)
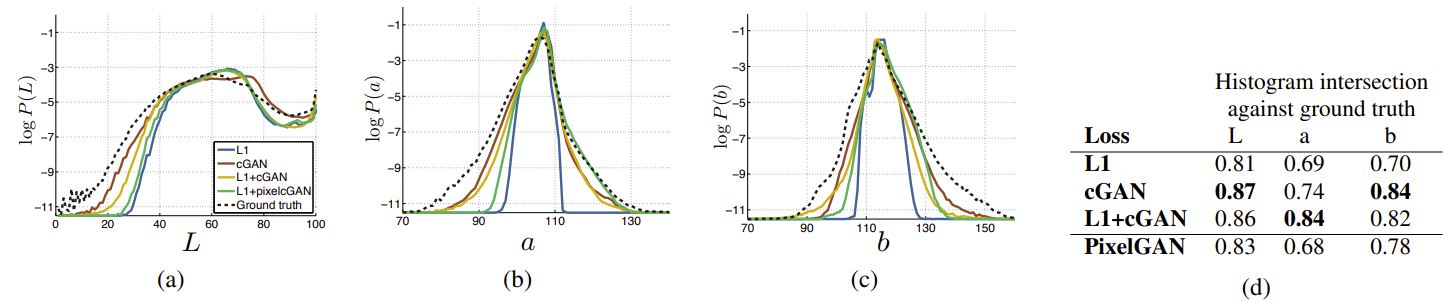
조건부 GAN 은 입력 라벨 맵에 없는 공간 구조까지 환각해 선명한 이미지를 만듭니다. 스펙트럼 차원에서도 비슷한 “선명화”가 일어날까요? L1 은 에지 위치가 불확실할 때 흐림을 유도하듯, 어떤 색이어야 할지 불확실할 때 평균적인 회색빛 색을 유도합니다. 구체적으로 L1 은 가능한 색에 대한 조건부 확률 밀도의 중앙값을 택할 때 최소화됩니다. 반면 적대 손실은 원리상 회색 출력이 비현실적임을 알아차리고 참 색 분포에 맞추도록 장려할 수 있습니다. Cityscapes 에서 Lab 색 공간의 출력 색 주변분포를 그려 보면 L1 은 정답보다 좁은 분포를 내고, cGAN 은 출력 분포를 정답에 더 가깝게 밀어냅니다.
💡 Key Takeaway 비조건부 GAN 은 입력을 무시하고 붕괴하지만, 조건부 판별기나 L1 항 중 하나만 있어도 입력을 존중합니다. cGAN 은 공간만이 아니라 색까지 선명하게 만듭니다.
지각 검증, 시맨틱 분할, 커뮤니티 응용 (Section 4.5–4.7)
지각 검증은 지도↔항공사진과 그레이스케일→컬러 과제에서 수행되었고, 시맨틱 분할은 출력이 입력보다 덜 복잡한 비전 문제에서 cGAN 이 어떻게 작동하는지 시험합니다.
👁️ 1. AMT 결과 (Table 4, 5)
| 과제 | 손실 | 진짜로 라벨된 비율 |
|---|---|---|
| 사진→지도 | L1 | $2.8\%\pm1.0\%$ |
| 사진→지도 | L1+cGAN | $6.1\%\pm1.3\%$ |
| 지도→사진 | L1 | $0.8\%\pm0.3\%$ |
| 지도→사진 | L1+cGAN | $18.9\%\pm2.5\%$ |
- 생성된 항공사진은 18.9% 의 시행에서 참가자를 속여 흐릿한 결과를 내고 거의 속이지 못한 L1 베이스라인을 유의하게 앞섰습니다.
- 사진→지도 방향은 6.1% 에 그쳤고 부트스트랩 검정에서 L1 과 유의한 차이가 없었습니다. 엄격한 기하를 가진 지도에서는 작은 구조 오류가 더 혼란스러운 항공사진보다 눈에 잘 띄기 때문으로 추정됩니다.
| 컬러화 방법 | 진짜로 라벨된 비율 |
|---|---|
| L2 regression (Zhang et al. 2016 변형) | $16.3\%\pm2.4\%$ |
| Zhang et al. 2016 | $27.8\%\pm2.7\%$ |
| Ours (L1+cGAN) | $22.5\%\pm1.6\%$ |
ImageNet 으로 컬러화를 학습하고 선행 연구의 테스트 분할로 평가했습니다. 조건부 GAN 은 Zhang et al. 의 L2 변형과 비슷했지만(부트스트랩 검정에서 차이 유의하지 않음) 컬러화에 특별히 설계된 전체 방법에는 못 미쳤습니다.
🗺️ 2. 시맨틱 분할: 사진→라벨 (Table 6, Figure 11)

| 손실 | 픽셀 정확도 | 클래스 정확도 | 클래스 IOU |
|---|---|---|---|
| L1 | 0.86 | 0.42 | 0.35 |
| cGAN | 0.74 | 0.28 | 0.22 |
| L1+cGAN | 0.83 | 0.36 | 0.29 |
- L1 없이 학습한 cGAN 도 합리적인 정확도로 이 문제를 풀 수 있었습니다. 저자들이 아는 한 연속값 변이를 가진 “이미지”가 아니라 거의 이산적인 “라벨”을 GAN 이 성공적으로 생성한 첫 시연입니다.
- 그러나 단순 L1 회귀가 cGAN 보다 좋은 점수를 냅니다. 비전 문제에서는 목표(정답에 가까운 출력 예측)가 그래픽스 과제보다 덜 모호하므로 L1 같은 재구성 손실로 대체로 충분하다고 논문은 주장합니다.
- Figure 11 에서 cGAN 은 언뜻 정답처럼 보이는 선명한 이미지를 만들지만 실제로는 환각된 작은 객체가 많습니다.
🌐 3. 커뮤니티 주도 연구 (Figure 10)
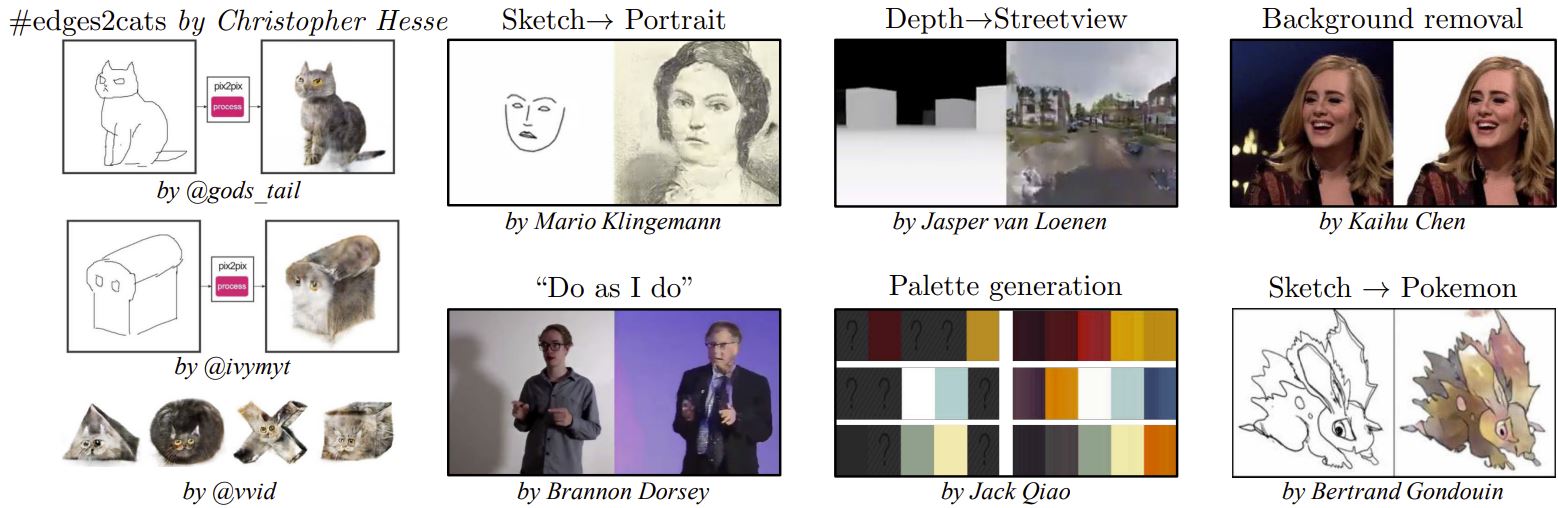
논문과 pix2pix 코드베이스의 초기 공개 이후 컴퓨터 비전·그래픽스 종사자와 예술가를 포함한 Twitter 커뮤니티가 원 논문의 범위를 훨씬 넘는 새로운 변환 과제에 프레임워크를 적용했습니다. Sketch→Portrait, “Do as I Do” 포즈 전이, Depth→Streetview, 배경 제거, 팔레트 생성, Sketch→Pokemon, 그리고 기묘하게 인기를 끈 #edges2cats 가 그 예입니다.
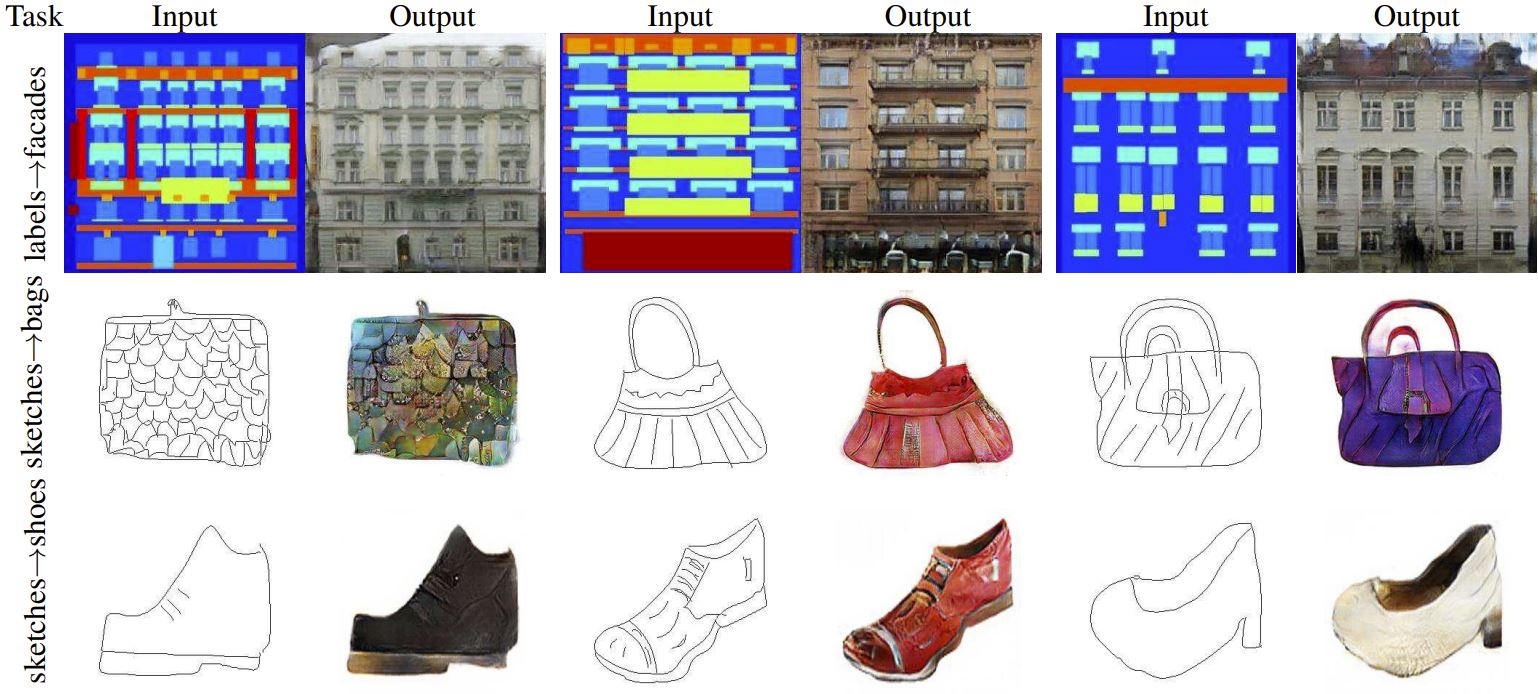
💡 Key Takeaway cGAN 은 출력이 고도로 세밀하거나 사진 같은 그래픽스 과제에서 강하고, 정답이 덜 모호한 비전 과제에서는 L1 회귀에 밀립니다. 이 경계를 논문 스스로 그었습니다.
학습 세부 설정과 추론 (Section 3.3)
최적화와 추론은 원 GAN 논문의 표준 접근을 따르면서 몇 가지 세부 조정을 더합니다.
⚙️ 1. 최적화
| 항목 | 설정 |
|---|---|
| 갱신 순서 | $D$ 한 스텝, $G$ 한 스텝 교대 |
| 최적화기 | 미니배치 SGD, Adam. 학습률 0.0002, $\beta_{1}=0.5$ |
| $D$ 손실 스케일 | $D$ 의 목적을 2 로 나눠 $G$ 에 비해 $D$ 의 학습 속도를 늦춤 |
| $G$ 손실 | 원 GAN 논문의 제안대로 $\log(1-D(x,G(x,z)))$ 최소화 대신 $\log D(x,G(x,z))$ 최대화 |
| 배치 크기 | 실험에 따라 1 에서 10 사이 |
| 가중치 초기화 | 평균 0, 표준편차 0.02 가우시안 |
| 데이터 증강 | 랜덤 지터($286\times286$ 로 리사이즈 후 $256\times256$ 랜덤 크롭)와 미러링 |
🔁 2. 추론 시의 특이점
| 항목 | 내용 |
|---|---|
| 드롭아웃 | 통상 관행과 달리 테스트 시에도 적용 |
| 배치 정규화 | 훈련 배치의 집계 통계가 아니라 테스트 배치의 통계 사용 |
| 인스턴스 정규화 | 배치 크기가 1 일 때 이 방식은 “인스턴스 정규화(instance normalization)” 라 불리며 이미지 생성 과제에서 효과적임이 입증됨 |
즉 생성기는 학습 때와 정확히 같은 방식으로 실행됩니다.
📋 3. 과제와 데이터셋 (Section 4)
| 과제 | 데이터 |
|---|---|
| 시맨틱 라벨↔사진 | Cityscapes |
| 건축 라벨→사진 | CMP Facades |
| 지도↔항공사진 | Google Maps 에서 수집 |
| 흑백→컬러 사진 | ImageNet |
| 에지→사진 | HED 에지 검출기와 후처리로 이진 에지 생성 |
| 스케치→사진 | 에지→사진 모델을 사람이 그린 스케치로 테스트 |
| 낮→밤 | 야외 장면 데이터셋 |
모든 경우 입력과 출력은 단순히 1–3 채널 이미지입니다.
💡 Key Takeaway Pix2Pix 의 학습 레시피는 DCGAN 의 것(Adam 0.0002, $\beta_{1}$ 0.5, 초기화 0.02)에 “$D$ 손실 절반, 테스트 시 드롭아웃, 테스트 배치 통계“를 더한 것입니다.
한계와 열린 방향
이 논문의 한계는 본문 곳곳에 명시되어 있으며, 그 상당수가 이후 연구의 직접적 동기가 되었습니다.
⚠️ 1. 명시된 한계
| 항목 | 내용 |
|---|---|
| 출력의 확률성 | 드롭아웃 잡음에도 출력 변동이 미미. 조건부 분포의 전체 엔트로피를 포착하는 고도로 확률적인 cGAN 설계는 열린 문제 |
| 짝지어진 데이터 필요 | 모든 과제가 입력-출력 쌍 $(x,y)$ 를 요구 |
| 비전 과제에서의 열위 | 시맨틱 분할에서 L1 회귀가 cGAN 보다 우수 |
| 지도 생성의 지각 품질 | 사진→지도는 6.1% 로 L1 과 유의한 차이 없음 |
| 컬러화 | 전용 방법(27.8%)에 못 미침(22.5%) |
| ImageGAN 학습 난이도 | $286\times286$ 판별기는 파라미터와 깊이 때문에 FCN-score 가 낮음 |
| 환각 | 분할에서 선명하지만 환각된 작은 객체가 다수 |
🔬 2. 평가의 한계
- FCN-score 는 Cityscapes 라벨→사진에만 적용되는 과제 특화 대리 지표이며, 사전학습 분류기의 편향을 물려받습니다.
- AMT 실험은 선행 연구와 달리 경계(vigilance) 시행을 포함하지 않았습니다.
- 일부 표(Table 2)는 다른 배치 크기로 측정되어 교차 비교가 어렵습니다.
🔗 3. 후속 연구로의 연결
| 방향 | 내용 |
|---|---|
| 짝 없는 변환 | 짝지어진 데이터 요구를 제거하는 순환 일관성 기반 변환(CycleGAN 등)이 같은 그룹에서 이어짐 |
| 다중 모드 출력 | 출력 다양성을 명시적으로 모델링하는 조건부 변환 연구 |
| 고해상도 | 더 큰 해상도의 라벨→사진 합성을 위한 다중 스케일 생성기·판별기 |
| PatchGAN 의 재사용 | 패치 판별기는 이후 수많은 변환·복원 모델의 기본 판별기가 됨 |
| 의류 합성 등 응용 | 사람 이미지와 의류 이미지를 조건으로 한 가상 착용(virtual try-on) 연구가 Pix2Pix 류 조건부 변환을 기반 구성 요소로 채택 |
💡 Key Takeaway Pix2Pix 가 남긴 두 숙제는 “짝 없는 데이터“와 “다양한 출력“입니다. 전자는 CycleGAN 이, 후자는 다중 모드 조건부 변환 연구가 이어받았습니다.