 You know maize mean?
DiffFashion: Reference-based Fashion Design with Structure-aware Transfer by Diffusion Models
0. Summary
기본 정보 : ArXiv,2023.02.14, DiffFashion: Reference-based Fashion Design with Structure-aware Transfer by Diffusion Models
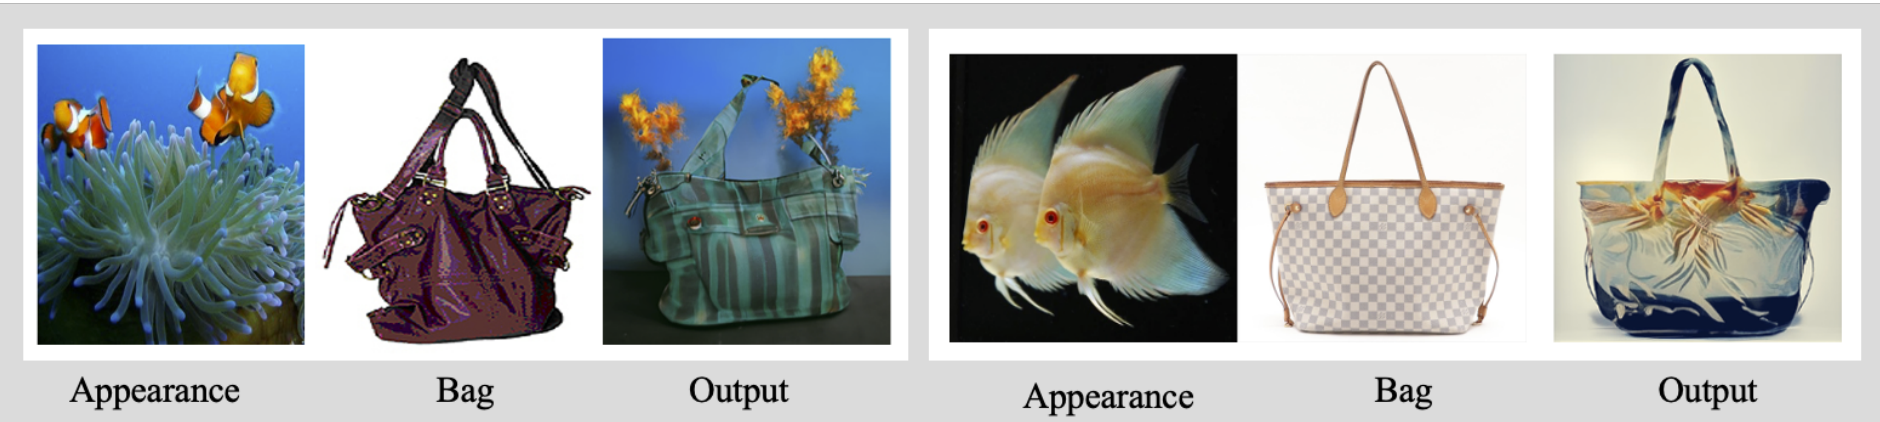
이 글은 DiffFashion 논문의 구조 분석·구현 관점 정리다. 과제 배경과 실험 결과 중심의 리뷰는 별도 글에 있으며, 여기서는 네트워크 구성, 손실, 추론 절차, 재현 시 주의점에 비중을 둔다.
연구 배경
DiffFashion 은 새 네트워크를 학습하지 않는다. ImageNet 에서 사전 학습된 레이블 조건부 guided diffusion 모델 하나와 고정된 DINO-ViT 하나를 추론 시에 조합할 뿐이다. 따라서 이 논문을 이해하고 재현하는 일은 “무엇을 학습하는가”가 아니라 “추론 파이프라인의 각 단계에서 어떤 텐서가 어디로 흐르고, 어떤 기울기가 어디에 더해지는가” 를 정확히 파악하는 일이다. 기반이 되는 DiffuseIT 역시 같은 구성(guided diffusion + DINO-ViT 손실 안내)을 쓰므로, DiffFashion 의 기여는 그 파이프라인에서 세 지점, 즉 마스크 생성 단계의 추가, 출발 잠재의 교환, 그리고 마스크 혼합 단계의 삽입으로 요약된다.
제안 방법
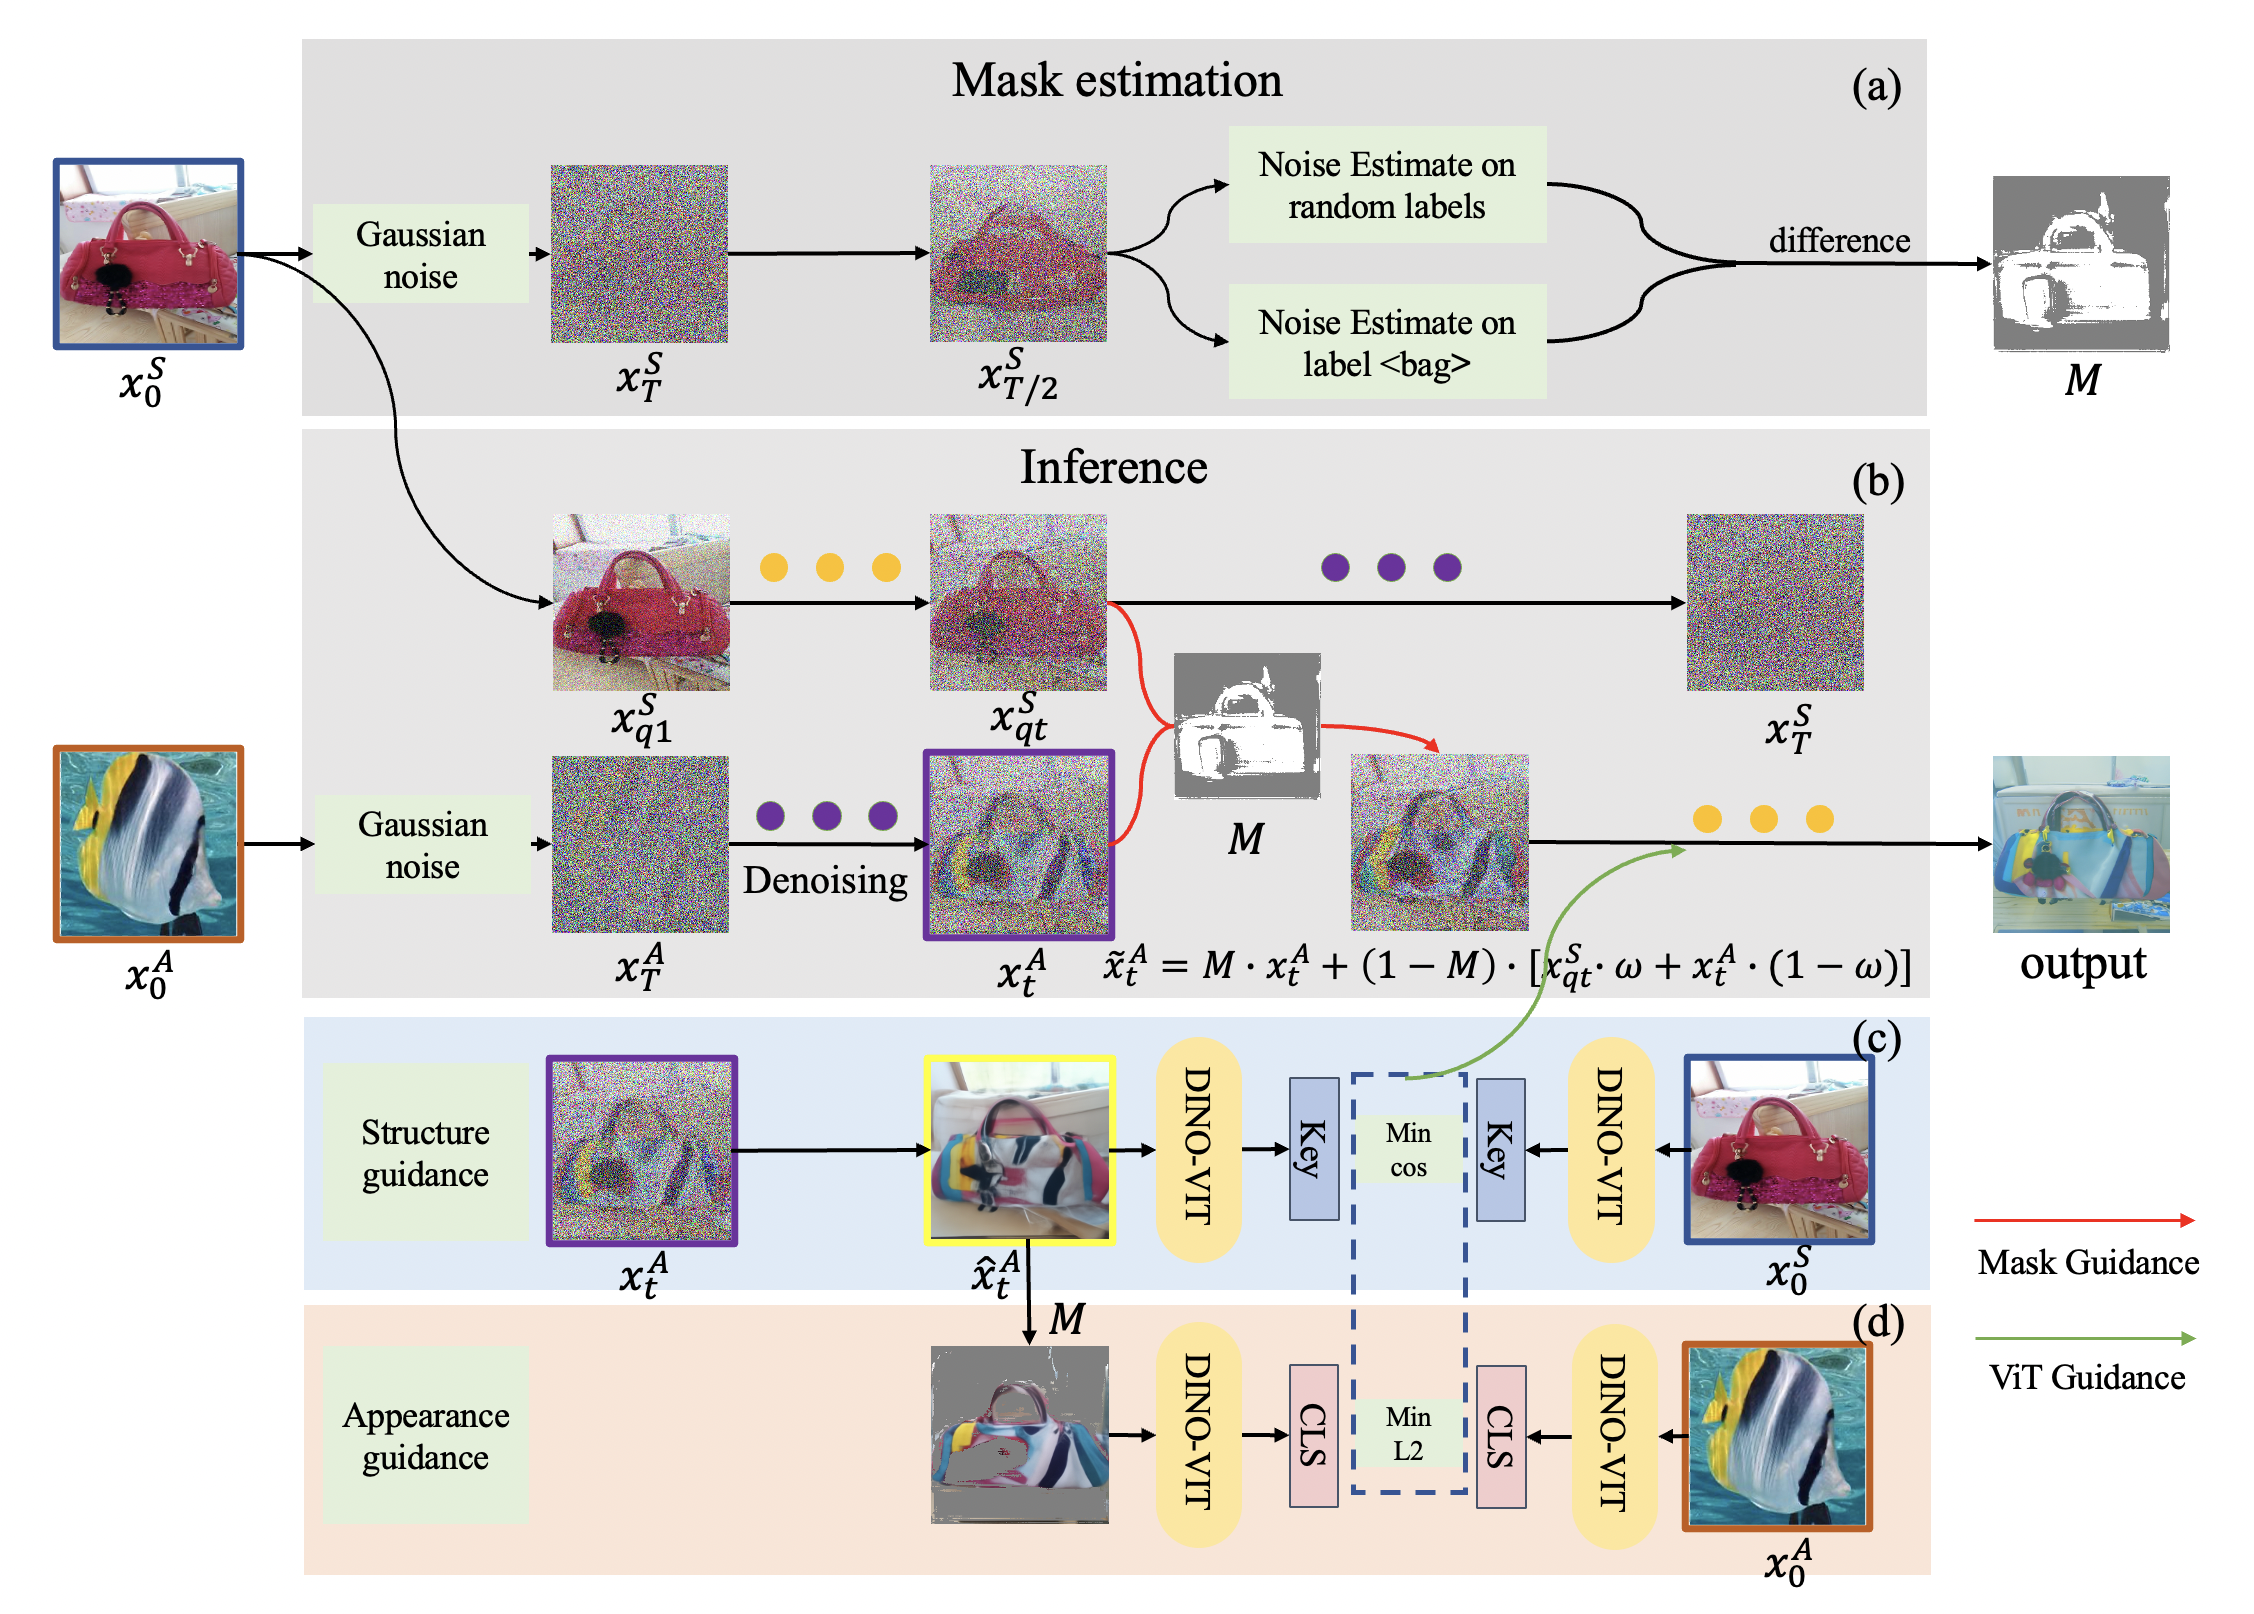
추론은 세 단계로 구성된다. (1) 마스크 생성: 의류 이미지 $x_0^{S}$ 를 $T/2$ 까지 노이즈화한 뒤 역방향 잠재의 Tweedie 추정 $\hat{x}{T/2}^{S}$ 에 대해 전경 레이블 $y_p$ 와 비전경 레이블 $N$ 개의 노이즈 예측 차이를 임계값 $-0.2$ 로 이진화해 $M$ 을 얻는다. (2) 마스크 유도 노이즈 제거: 외관 이미지 $x_0^{A}$ 를 순방향으로 $x_T^{A}$ 까지 보낸 뒤 레이블 $y_p$ 조건으로 역방향 단계를 밟되, 처음 50% 단계 동안 매 단계 $M$ 바깥을 의류의 순방향 잠재 $x{qt}^{S}$ 와 $\omega_{mix}=0.98$ 로 섞는다. (3) ViT 기울기 안내: 각 단계의 Tweedie 추정 $\hat{x}t^{A}$ 에 대해 DINO-ViT 외관 손실(마스크 안 [CLS])과 구조 손실(의류 이미지 키와의 패치 대조)을 계산하고, 총 손실 $L{total}=1\cdot L_{struct}+0.1\cdot L_{app}$ 의 기울기로 평균을 보정한다. $T=60$, 재샘플링 $N=10$, 해상도 $256^2$ 이다.
발견 사실
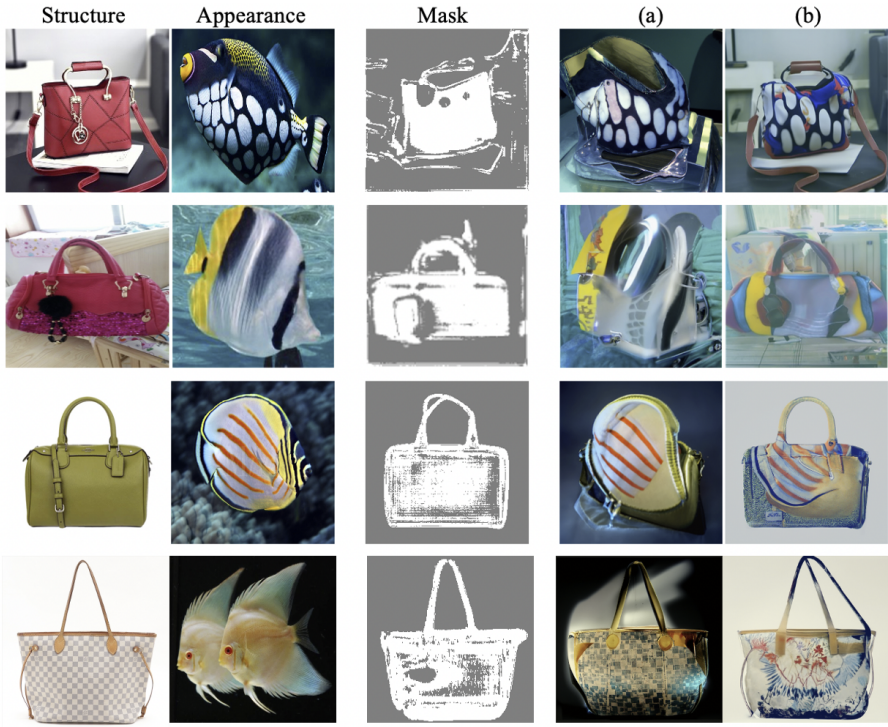
구현 관점에서 중요한 발견은 세 가지다. 첫째, 마스크는 순방향 잠재 $x_{qt}^{S}$ 가 아니라 역방향 잠재의 Tweedie 추정에서 뽑아야 전경 구조가 잘 드러난다. 둘째, 마스크 혼합은 전 구간이 아니라 초반 50% 에만 적용해야 두 객체의 구조 차이가 클 때 정보 손실과 마스크 불안정을 피할 수 있고, 일부 이미지에서는 마스크가 외관 상관을 떨어뜨리므로 확률 0.2 로 마스크를 끄는 것이 전체 품질에 유리했다. 셋째, 같은 레이블 조건부 모델을 DiffuseIT 에 넣고 “bag” 을 조건으로 줘도(Fig. 8) 또는 텍스트 안내를 줘도(Fig. 9) DiffFashion 의 결과가 나오지 않으므로, 성능은 잠재 교환과 마스크 혼합이라는 절차에서 나온다. 비용은 RTX 3090 에서 마스크 20초, 이미지 120초다.
핵심 기여
- 학습 없는 3단계 추론 파이프라인 : 사전 학습 레이블 조건부 확산 모델과 DINO-ViT 만으로 마스크 생성 → 마스크 유도 노이즈 제거 → ViT 기울기 안내를 수행하며, 각 단계가 서로 다른 입력(의류 / 외관 / 둘 다)을 소비한다는 점을 명확히 분리했다.
- 레이블 차이 기반 마스크 연산자 : $\epsilon_\theta(\hat{x},T/2,y_p)-\tfrac1N\sum_i\epsilon_\theta(\hat{x},T/2,y_i)$ 라는 단일 식으로 분할 모델 없이 전경 마스크를 만드는 재사용 가능한 모듈을 제시했다.
- 재현 가능한 하이퍼파라미터 공개 : $T$, $N$, 임계값, $\omega_{mix}$, 적용 구간, 손실 가중치, 레이블 집합, 마스크 미적용 확률까지 추론에 필요한 모든 값을 명시해, DiffuseIT 코드베이스 위에서 재현할 수 있게 했다.
관련 개념
전체 파이프라인 구조: 입력, 모듈, 출력
파이프라인은 두 입력 이미지와 두 고정 네트워크, 세 처리 단계로 이루어집니다. 재현의 첫 단계는 각 단계가 어떤 입력을 읽고 어떤 중간 산출물을 다음 단계에 넘기는지 표로 고정하는 것입니다.
🧩 1. 구성 요소
| 구성 요소 | 역할 | 학습 여부 |
|---|---|---|
| 레이블 조건부 확산 모델 $\epsilon_\theta(x_t,t,y)$ | ImageNet $256^2$ guided diffusion. 마스크 생성과 노이즈 제거 모두 담당 | 고정 (사전 학습) |
| DINO-ViT | [CLS] 토큰(외관)과 어텐션 키(구조) 추출 | 고정 (사전 학습) |
| 의류 이미지 $x_0^{S}$ | 구조 참조. 마스크 생성의 입력, 혼합의 배경 소스, 구조 손실의 기준 | 입력 |
| 외관 이미지 $x_0^{A}$ | 외관 참조. 노이즈 제거의 출발 잠재, 외관 손실의 기준 | 입력 |
| 전경 레이블 $y_p$, 비전경 레이블 ${y_i}$ | ImageNet 클래스. 마스크 생성과 조건부 노이즈 제거에 사용 | 입력 (하이퍼파라미터) |
🔀 2. 단계별 데이터 흐름
| 단계 | 읽는 것 | 만드는 것 | 넘기는 것 |
|---|---|---|---|
| (a) 마스크 생성 | $x_0^{S}$, $y_p$, ${y_i}$ | $x_{T/2}^{S}$, $\hat{x}_{T/2}^{S}$, $M_p$, $M_n$ | 이진 마스크 $M$ |
| (b) 마스크 유도 노이즈 제거 | $x_0^{A}$, $x_0^{S}$, $M$, $y_p$ | 매 단계 $x_t^{A}$, $x_{qt}^{S}$, $\tilde{x}_t^{A}$ | 혼합된 잠재 $\tilde{x}_t^{A}$ |
| (c) ViT 안내 | $\hat{x}_t^{A}$, $x_0^{A}$, $x_0^{S}$, $M$ | $L_{app}$, $L_{struct}$, $\nabla L_{total}$ | 보정된 평균 → 다음 $x_{t-1}^{A}$ |
(b)와 (c)는 같은 루프 안에서 매 단계 번갈아 실행됩니다. (a)는 루프 전에 한 번만 실행됩니다.
🔁 3. DiffuseIT 와의 차이 지점
DiffuseIT 파이프라인을 기준으로 DiffFashion 이 바꾼 곳은 정확히 세 군데입니다.
- 루프 전에 (a) 마스크 생성 단계가 추가됩니다.
- 루프의 출발 잠재가 $x_T^{S}$ 에서 $x_T^{A}$ 로 교환됩니다.
- 루프 안에 (b) 의 마스크 혼합 식이 삽입되고, 외관 손실 계산 시 마스크로 배경이 제거됩니다.
나머지(DDPM 순방향·역방향 식, 재샘플링, 구조 손실 형태, 기타 파라미터)는 DiffuseIT 와 동일합니다. 재현 시 DiffuseIT 코드베이스에서 이 세 지점만 수정하는 것이 가장 안전한 경로입니다.
💡 Key Takeaway DiffFashion 은 “DiffuseIT + 세 가지 패치” 로 읽는 것이 정확합니다. 두 입력이 서로 다른 역할(출발 잠재는 외관, 구조 기준과 혼합 소스는 의류)을 맡는다는 점을 먼저 고정해야 이후 식이 헷갈리지 않습니다.
단계 (a): 마스크 생성 연산의 구현
마스크 생성은 확산 모델을 분할기로 전용하는 단계입니다. 식 자체는 단순하지만 어떤 잠재에서, 어떤 시점에, 어떤 레이블로 노이즈를 예측하는지가 결과를 좌우합니다.
🧮 1. 연산 순서 (Eq. 5 ~ 7)
- 순방향 인코딩: $x_0^{S}$ 를 Eq. 1 로 $T$ 까지 노이즈화합니다.
- 역방향 절반 진행: 역방향 과정을 $T/2$ 까지 진행해 $x_{T/2}^{S}$ 를 얻습니다. 순방향 잠재 $x_{q,T/2}^{S}$ 가 아니라 역방향 잠재를 쓰는 것이 핵심입니다. 역방향 잠재는 지각적 외관 정보가 덜하고 전경의 전반적 구조를 더 잘 나타냅니다.
- Tweedie 추정: 전경 레이블 조건으로 깨끗한 이미지를 추정합니다.
- 노이즈 맵 두 장: 같은 $\hat{x}_{T/2}^{S}$ 에 대해 전경 레이블과 비전경 레이블 평균의 노이즈 예측을 구합니다.
- 차이와 이진화: $M_p-M_n$ 에 임계값 $-0.2$ 를 적용해 이진 마스크 $M$ 을 만듭니다.
⚙️ 2. 구현 세부와 자유도
| 항목 | 논문 값 | 재현 시 주의 |
|---|---|---|
| 임계값 | $-0.2$ | 부호가 음수라는 점에 주의. 노이즈 맵 차이의 스케일은 모델 출력 범위에 의존하므로 다른 모델에서는 재조정 필요 |
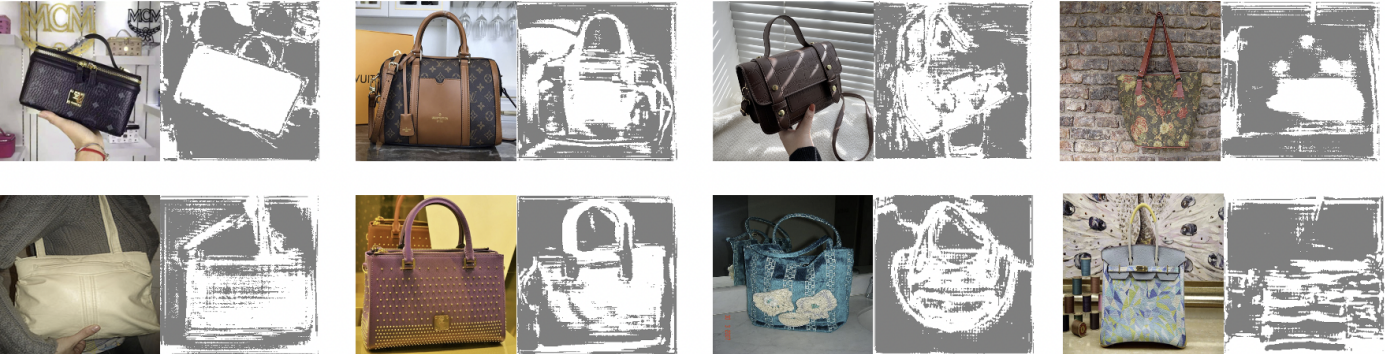
| 비전경 레이블 집합 | 3벌 (“cellphone, forklift, pillow” / “waffle iron, washer, guinea pig” / “brambling, echidna, custard apple”) | 각 벌로 마스크를 만들어 가장 좋은 것을 수동 선택. 자동 선택 기준은 논문에 없음 |
| 노이즈 맵의 채널 처리 | 명시 없음 | $\epsilon_\theta$ 출력은 3채널이므로 채널 평균 또는 노름으로 1채널화한 뒤 이진화하는 것이 자연스러움. 재현 시 선택 사항 |
| “수정 가능한” 마스크 | 논문이 명시 | 사용자가 후처리(팽창·침식·수동 보정)할 수 있음을 전제 |
| 소요 시간 | 20초 / 마스크 (RTX 3090) | 순방향 + 역방향 $T/2$ + $(1+N)$ 회 노이즈 예측 |
🧠 3. 왜 작동하는가
레이블 조건부 모델에서 레이블은 객체 영역의 노이즈 예측에 주로 영향을 줍니다. 배경은 어떤 레이블을 줘도 비슷하게 복원되므로 $M_p$ 와 $M_n$ 이 거의 같고, 객체 영역은 레이블마다 “무엇으로 복원할지”가 달라 차이가 큽니다. 비전경 레이블을 여러 개 평균하는 이유는 특정 레이블 하나가 우연히 객체와 비슷한 형태를 유도하는 경우를 상쇄하기 위해서입니다.
💡 Key Takeaway 마스크는 역방향 잠재 → Tweedie 추정 → 레이블 차이 → 임계값 네 단계입니다. 재현 시 가장 많이 틀리는 지점은 순방향 잠재를 쓰는 것과 임계값 부호입니다.
단계 (b): 출발 잠재 교환과 마스크 혼합
마스크 유도 노이즈 제거는 DiffFashion 의 핵심 설계가 들어 있는 루프입니다. 출발점이 외관 이미지라는 점, 혼합 소스가 의류의 순방향 잠재라는 점, 그리고 혼합이 초반에만 적용된다는 점이 세 가지 구현 포인트입니다.
🔄 1. 루프 구조 (Eq. 8, 9)
x_T^A  <- forward(x_0^A, T)                      # 외관 이미지를 출발 잠재로
for t = T-1 ... 0:
    x_t^A  <- denoise(x_{t+1}^A, t+1, y_p)        # Eq. 8, 전경 레이블 조건
    if t >= T/2:                                  # 초반 50% 단계에서만
        if rand() > 0.2:                          # 확률 0.2 로 마스크 생략
            x_qt^S <- forward(x_0^S, t)           # 의류의 같은 시점 순방향 잠재
            x_t^A  <- M*x_t^A + (1-M)*[w*x_qt^S + (1-w)*x_t^A]   # Eq. 9, w = 0.98
    x_hat_t^A <- tweedie(x_t^A, t, y_p)           # ViT 손실 계산용 깨끗한 추정
    x_t^A  <- x_t^A - step * grad(L_total(x_hat_t^A))            # 단계 (c)
    (재샘플링 N = 10 회 반복)
노이즈 제거 식은
\[x_t^{A}=\frac{1}{\sqrt{\alpha_{t+1}}}\Big(x_{t+1}^{A}-\frac{1-\alpha_{t+1}}{\sqrt{1-\bar\alpha_{t+1}}}\,\epsilon_\theta\big(x_{t+1}^{A},\ t+1,\ y_p\big)\Big)\]이고 혼합 식은
\[\tilde{x}_t^{A}=M\cdot x_t^{A}+(1-M)\cdot\Big[\omega_{mix}\cdot x_{qt}^{S}+(1-\omega_{mix})\cdot x_t^{A}\Big]\]입니다.
🎯 2. 세 가지 구현 포인트
| 포인트 | 내용 | 틀리기 쉬운 지점 |
|---|---|---|
| 출발 잠재 = 외관 | $x_T^{A}$ 에서 시작. 같은 잠재를 다른 레이블로 복원하면 질감·의미 구조가 비슷하다는 성질로 외관 텍스처를 의류에 맞게 옮김 | DiffuseIT 습관대로 $x_T^{S}$ 에서 시작하면 전혀 다른 방법이 됨 |
| 혼합 소스 = 의류의 순방향 잠재 | $x_{qt}^{S}$ 는 Eq. 1 로 $x_0^{S}$ 에 $t$ 시점 노이즈를 더한 것. 매 단계 새로 계산 | 역방향 잠재가 아님. 마스크 생성 단계와 반대라는 점에 주의 |
| 마스크 안쪽은 외관, 바깥쪽은 거의 의류 | $\omega_{mix}=0.98$ 이므로 배경의 98%는 의류 잠재, 2%만 외관 잠재 | $(1-M)$ 영역에도 외관 잠재가 2% 섞이므로 완전한 복사·붙여넣기가 아님 |
⏱️ 3. 적용 구간과 확률적 생략
| 설정 | 값 | 이유 |
|---|---|---|
| 마스크 혼합 적용 구간 | 노이즈 제거의 처음 50% 단계 | 두 객체의 구조 차이가 너무 커지면 정보 손실이 생기고 마스크의 불안정 효과가 커지므로, 구조가 결정되는 초반에만 주입 |
| 마스크 미적용 확률 | 0.2 | 일부 이미지에서 마스크가 외관 상관을 떨어뜨리므로(Fig. 7 마지막 행), 확률적으로 생략해 외관 전이 여지를 남김 |
재현 시 “확률 0.2” 가 단계마다 독립 추첨인지 이미지마다 한 번 추첨인지는 논문에 명시되어 있지 않습니다. 단계마다 추첨하면 평균적으로 80% 의 초반 단계에서만 혼합이 일어나는 완화된 효과가 되고, 이미지마다 추첨하면 20% 의 샘플이 마스크 없이 생성되는 효과가 됩니다. 두 해석의 결과가 다르므로 재현 보고에서 선택을 명시해야 합니다.
💡 Key Takeaway 루프의 본질은 “외관에서 출발, 초반 절반 동안 배경을 의류로 덮어쓰기” 입니다. 혼합 소스가 순방향 잠재이고, 혼합이 초반에만 적용되며, 2% 의 외관 누설과 20% 의 확률적 생략이 있다는 세부가 결과를 좌우합니다.
단계 (c): DINO-ViT 손실과 기울기 안내의 구현
ViT 기울기 안내는 분류기 안내(classifier guidance)의 분류기 자리에 DINO-ViT 손실을 넣은 것입니다. 손실은 노이즈 잠재가 아니라 Tweedie 추정 $\hat{x}_t^{A}$ 에 대해 계산하고, 그 기울기를 잠재에 되돌립니다.
🎨 1. 외관 손실의 구현 (Eq. 10)
\[L_{app}=\big\|e_{[CLS]}^{L}(x_0^{A})-e_{[CLS]}^{L}(\hat{x}_t^{A}\odot M)\big\|_2+\lambda_{MSE}\big\|x_0^{A}-\hat{x}_t^{A}\big\|_2\]| 항목 | 구현 |
|---|---|
| 기준 | 외관 이미지 $x_0^{A}$ 의 마지막 층 [CLS] 토큰. 루프 전에 한 번 계산해 캐시 |
| 비교 대상 | $\hat{x}_t^{A}$ 에서 마스크 $M$ 으로 배경 픽셀을 제거한 뒤 ViT 통과 (논문: “마스크 내 객체의 외관 손실만 계산”) |
| $\lambda_{MSE}$ | 전역 통계 손실 계수. 값은 DiffuseIT 와 동일하게 두었다고만 명시 |
| 비용 | 매 단계 ViT 순전파 1회 + 역전파 |
마스크 적용 방식(0 으로 채우기, 평균색 채우기 등)은 논문에 명시되어 있지 않습니다. [CLS] 토큰은 전역 특징이므로 채우는 값이 결과에 영향을 줄 수 있어, 재현 시 선택을 기록해야 합니다.
🏗️ 2. 구조 손실의 구현 (Eq. 11, 12)
\[L_{struct}=-\sum_i\log\frac{\mathrm{sim}(k_i^{l,S},k_i^{l,A})}{\mathrm{sim}(k_i^{l,S},k_i^{l,A})+\sum_{j\neq i}\mathrm{sim}(k_i^{l,S},k_j^{l,A})},\qquad \mathrm{sim}(k_i^{l,S},k_j^{l,A})=\exp\Big(\cos\big(k_i^{l}(x_0^{S}),k_j^{l}(\hat{x}_t^{A})\big)/\tau\Big)\]| 항목 | 구현 |
|---|---|
| 기준 | 의류 이미지 $x_0^{S}$ 의 $l$ 번째 어텐션 층 키 ${k_i^{l,S}}$. 루프 전에 캐시 |
| 비교 대상 | $\hat{x}_t^{A}$ (마스크 없이 전체) 의 같은 층 키 ${k_j^{l,A}}$ |
| 형태 | 패치 수 $P$ 에 대해 $P\times P$ 코사인 유사도 행렬을 만들고 대각(같은 위치)을 양성, 비대각을 음성으로 하는 InfoNCE |
| $l$, $\tau$ | 논문에 명시 없음. DiffuseIT 설정을 따른다고만 기술 |
구조 기준이 의류 이미지라는 점이 출발 잠재(외관)와 교차한다는 것을 다시 강조합니다. 이 교차 덕분에 “외관 잠재에서 출발하되 의류 구조로 수렴” 합니다.
⚖️ 3. 총 손실과 기울기 적용 (Eq. 13)
\[L_{total}=\lambda_{struct}L_{struct}+\lambda_{app}L_{app},\qquad \lambda_{struct}=1,\ \lambda_{app}=0.1\]| 항목 | 내용 |
|---|---|
| 기울기 경로 | $\hat{x}t^{A}$ 는 $x_t^{A}$ 의 미분 가능한 함수(Tweedie)이므로 $\nabla{x_t^{A}}L_{total}$ 을 자동 미분으로 계산 |
| 적용 위치 | 분류기 안내처럼 역방향 평균에 기울기 항을 더함. 단계 크기는 DiffuseIT 설정 |
| 재샘플링 | $N=10$. 각 단계에서 노이즈 제거 → 재노이즈화를 반복해 안내 효과를 강화 (RePaint 류) |
| 가중치 해석 | 구조가 외관의 10배. 출발 잠재가 이미 외관이므로 외관은 약하게만 당기고, 구조는 강하게 끌어옴 |
💡 Key Takeaway 외관 손실은 마스크 안의 [CLS], 구조 손실은 의류 키와의 패치 대조이며, 둘 다 Tweedie 추정에 대해 계산해 잠재로 역전파합니다. $l$, $\tau$, $\lambda_{MSE}$, 단계 크기는 논문에 없으므로 DiffuseIT 코드의 기본값을 그대로 쓰는 것이 의도된 재현입니다.
하이퍼파라미터 총정리와 계산 비용
하이퍼파라미터는 논문 Section V-B 에 흩어져 있습니다. 재현을 위해 한 표로 모으고, 각 값이 어느 단계에 속하는지와 민감도를 함께 적습니다.
📋 1. 전체 설정표
| 단계 | 파라미터 | 값 | 비고 |
|---|---|---|---|
| 공통 | 확산 모델 | ImageNet $256^2$ 레이블 조건부 guided diffusion | 추가 학습 없음 |
| 공통 | 확산 단계 $T$ | 60 | 전체 1000 단계 스케줄의 서브샘플링 |
| 공통 | 재샘플링 $N$ | 10 | 마스크 생성의 비전경 레이블 수 $N$ 과 기호가 겹치지만 다른 양 |
| 공통 | 해상도 | $256\times256$ | |
| (a) | 마스크 추출 시점 | $T/2$ | 역방향 잠재 |
| (a) | 이진화 임계값 | $-0.2$ | |
| (a) | 비전경 레이블 | 3벌 × 3개 | 최선 선택 |
| (b) | $\omega_{mix}$ | 0.98 | |
| (b) | 혼합 적용 구간 | 초반 50% 단계 | |
| (b) | 마스크 미적용 확률 | 0.2 | 추첨 단위 미명시 |
| (c) | $\lambda_{app}$ | 0.1 | |
| (c) | $\lambda_{struct}$ | 1 | |
| (c) | $\lambda_{MSE}$, $l$, $\tau$, 단계 크기 | DiffuseIT 와 동일 | 논문 미명시 |
| 비교 | DiffuseIT 실행 횟수 | 3회 | 공정 비교를 위해 DiffFashion 과 동일 |
⏱️ 2. 계산 비용 분해 (RTX 3090 1장)
| 단계 | 시간 | 주요 연산 |
|---|---|---|
| 마스크 생성 | 20초 | 순방향 + 역방향 $T/2=30$ 단계 + $(1+N)$ 회 노이즈 예측 (레이블 집합 3벌이면 ×3) |
| 이미지 생성 | 120초 | $T=60$ 단계 × 재샘플링 10 × (노이즈 예측 + ViT 순전파·역전파 2회) |
ViT 손실이 매 재샘플링 반복마다 외관·구조 두 번의 ViT 순전파와 역전파를 요구하므로, 전체 비용의 대부분은 (c) 단계에 있습니다. 확산 모델 호출 자체는 상대적으로 가볍습니다.
🎚️ 3. 민감도에 대한 논문의 힌트
| 파라미터 | 절제 근거 | 방향 |
|---|---|---|
| 마스크 유무 | Fig. 7 | 없으면 구조 붕괴. 있으면 일부 외관 상관 감소 |
| 마스크 적용 구간 | 본문 설명 | 전 구간 적용 시 구조 차이가 큰 쌍에서 정보 손실 |
| 마스크 품질 | Fig. 5, 6 | 나쁜 마스크에서도 비교 방법보다는 우수하나 품질 저하 |
| 레이블 조건 | Fig. 8 | DiffuseIT 에 같은 모델·레이블을 줘도 DiffFashion 수준에 못 미침 |
| 텍스트 안내 | Fig. 9 | “ocean-style handbag” 류 프롬프트는 과제 실패 |
💡 Key Takeaway 명시된 값은 열 개 남짓이고 나머지는 DiffuseIT 기본값입니다. 비용의 대부분은 ViT 기울기 계산이므로, 속도를 올리려면 재샘플링 $N$ 이나 ViT 호출 빈도를 줄이는 것이 첫 번째 선택지입니다.
재현 시 주의점과 설계 변형 가능성
재현 주의점은 논문이 명시하지 않은 자유도와, 논문의 설계 결정이 다른 모델·과제로 옮겨질 때 바뀌어야 하는 지점으로 나뉩니다.
⚠️ 1. 논문이 명시하지 않아 선택해야 하는 것
| 미명시 항목 | 선택지 | 권장 |
|---|---|---|
| 노이즈 맵 차이의 1채널화 | 채널 평균 / L2 노름 / 채널별 이진화 후 OR | 채널 평균 후 임계값. 임계값 $-0.2$ 의 부호가 평균 기반임을 시사 |
| 마스크 후처리 | 없음 / 모폴로지 / 최대 연결 성분 | 논문의 “수정 가능” 표현상 간단한 모폴로지는 허용 범위 |
| 마스크 미적용 확률의 추첨 단위 | 단계별 / 이미지별 | 두 해석 모두 실험하고 보고 |
| 외관 손실의 마스크 적용 방식 | 0 채우기 / 평균색 / 크롭 | [CLS] 가 전역 특징이므로 결과에 영향. 명시 필요 |
| 구조 손실의 $l$, $\tau$ | DiffuseIT 값 | DiffuseIT 코드 기본값 사용 |
| 세 마스크 중 “최선” 선택 기준 | 수동 / IoU 기반 / 분류 손실 기반 | 논문은 수동. 자동화하려면 별도 기준 필요 |
🔁 2. 다른 모델로 옮길 때 바뀌어야 하는 것
- 레이블 → 텍스트 조건: 레이블 차이 마스크는 “전경 레이블 대 비전경 레이블” 구조에 의존합니다. 텍스트 조건부 모델에서는 “a bag” 대 무관한 프롬프트들의 노이즈 차이로 대체할 수 있으나, 임계값과 추출 시점은 재탐색이 필요합니다. 단순 텍스트 안내만으로는 과제가 실패한다는 Fig. 9 의 결과가, 마스크 혼합 없이 모델만 바꾸는 접근을 경고합니다.
- 잠재 확산 모델(LDM)로 이전: 혼합 식 Eq. 9 는 픽셀 잠재에서 정의되어 있습니다. LDM 에서는 마스크를 잠재 해상도로 다운샘플링해야 하고, 오토인코더의 수용 영역 때문에 경계가 번질 수 있습니다.
- 해상도 상향: ViT 패치 수 $P$ 가 늘면 구조 손실의 $P\times P$ 유사도 행렬과 메모리가 제곱으로 늘어납니다.
- 의류 범주 확장: 전경 레이블이 ImageNet 에 있어야 하므로, 없는 범주(특정 의복)는 가장 가까운 클래스로 대체하거나 조건 방식을 바꿔야 합니다.
🧪 3. 검증을 위한 최소 재현 체크리스트
- 마스크 생성만 떼어 Fig. 5 의 가방 이미지에 대해 전경이 분리되는지 확인한다. 실패하면 역방향 잠재·Tweedie·임계값 부호를 점검한다.
- 마스크 없이(확률 1.0 생략) 돌려 Fig. 7(a) 처럼 구조가 무너지는지 확인한다. 무너지지 않으면 출발 잠재가 외관이 아닐 가능성이 크다.
- 마스크를 켜고 $\omega_{mix}=0.98$, 초반 50% 로 돌려 Fig. 7(b) 수준의 구조 보존을 확인한다.
- 외관 손실의 마스크를 끄고 켜서 배경으로 외관이 새는지 비교한다.
- 같은 설정의 DiffuseIT(레이블 조건부 모델, “bag” 조건)와 나란히 돌려 Fig. 8 의 차이가 재현되는지 본다.
💡 Key Takeaway 재현의 관건은 명시되지 않은 여섯 가지 자유도를 고정해 기록하는 것과, 마스크 → 출발 잠재 → 혼합 → 외관 마스크 순으로 절제하며 각 패치의 효과를 Fig. 5, 7, 8 과 대조하는 것입니다. 다른 모델로 옮길 때는 마스크 연산자와 혼합 해상도가 먼저 바뀌어야 합니다.