 You know maize mean?
DiffFashion: Reference-based Fashion Design with Structure-aware Transfer by Diffusion Models
0. Summary
기본 정보 : ArXiv,2023.02.14, DiffFashion: Reference-based Fashion Design with Structure-aware Transfer by Diffusion Models
연구 배경
참조 기반 패션 디자인은 주어진 의류 이미지(예: 핸드백)의 구조를 유지하면서 의류가 아닌 자연 이미지(예: 해양 생물)의 외관을 옮겨 새로운 디자인을 만드는 과제다. GAN 기반 이미지 변환은 참조 외관이 의류 도메인 밖에 있을 때 구조와 외관을 함께 제어하기 어렵고, 신경 스타일 변환(NST)은 색 변환 수준에 머물거나 색 번짐 아티팩트를 남긴다. 확산 모델 기반 변환인 DiffuseIT 와 SplicingViT 는 DINO-ViT 특징으로 구조와 외관을 분리해 비슷한 도메인 간 외관 전이에서 좋은 결과를 냈지만, 의류와 자연물처럼 도메인 격차가 크면 단일 가이드 손실로는 구조 참조에 남은 외관 정보를 제거하지 못하고, 옮겨진 텍스처가 옷감으로서 부자연스럽다. 또한 패션 디자인에는 정답 출력이 없어 지도 학습이 불가능하고, 감독 없이 추론하면 입력 의류의 구조가 소실되기 쉽다.
제안 방법
DiffFashion 은 추가 학습 없이 ImageNet 사전 학습 레이블 조건부 확산 모델(guided diffusion)만으로 동작하는 구조 인식 전이 프레임워크다. 첫째, 전경 레이블 $y_p$ 와 여러 비전경 레이블 $y_i$ 로 예측한 노이즈 맵의 차이를 이진화해 외부 분할 모델 없이 의류 전경 마스크 $M$ 을 생성한다(Eq. 5 ~ 7). 둘째, 기존 방법과 반대로 외관 이미지 $x_0^{A}$ 의 잠재를 노이즈 제거의 출발점으로 삼고, 매 단계 마스크 바깥 영역을 의류 이미지의 같은 시점 순방향 잠재 $x_{qt}^{S}$ 와 혼합(Eq. 9, $\omega_{mix}=0.98$)해 구조를 의류와 일치시킨다. 셋째, DINO-ViT 의 [CLS] 토큰으로 외관 손실(마스크 안에서만), 어텐션 키의 패치별 대조 손실로 구조 손실을 정의해 노이즈 제거를 안내한다(Eq. 10 ~ 13, $\lambda_{app}=0.1$, $\lambda_{struct}=1$).
발견 사실
저자들이 수집한 OceanBag 데이터셋(핸드백 6,000장, 해양 생물 2,400장, $256\times256$)에서 30명 사용자 연구 결과 DiffFashion 은 종합 75.04점으로 SplicingViT(60.98), DiffuseIT(67.09), WCT2(65.45), STROTSS(63.00)를 앞섰고, 외관 유사도 52.89 로 1위, 사실성 81.15 와 구조 유사도 91.07 로 2위였다(Table II). 자동 지표에서는 ImageNet 분류 손실 5.93 으로 가장 낮았고, Mask-RCNN 재현율은 WCT2 다음인 0.2, 색 차이 히스토그램(CDH)은 0.22 였다(Table III). WCT2 는 색만 바꿔 사실성·구조에서는 가장 높지만 외관 점수가 17.69 로 최하위였다. 절제 실험에서 마스크 가이드를 빼면 가방 구조가 자주 무너졌고(Fig. 7), DiffuseIT 에 같은 레이블 조건부 모델을 쓰거나 텍스트 프롬프트(“ocean-style handbag”)를 줘도 과제를 완수하지 못했다(Fig. 8, 9). 마스크 생성은 확산의 확률성 때문에 항상 좋지는 않지만, 나쁜 마스크에서도 비교 방법보다 나은 결과를 냈다(Fig. 5, 6). RTX 3090 한 장에서 마스크 20초, 이미지 120초가 걸린다.
핵심 기여
- 레이블 조건으로 만드는 자동 전경 마스크 : 전경 레이블과 비전경 레이블의 노이즈 추정 차이만으로 의류 마스크를 만들어, 분할 모델이나 수동 주석 없이 구조 보존에 쓸 수 있게 했다.
- 입력 잠재와 구조 전이를 맞바꾼 마스크 유도 확산 : 의류 잠재에서 출발해 외관을 입히는 대신 외관 잠재에서 출발해 의류 구조를 입히는 역발상으로, 의류에 어울리는 현실적인 텍스처를 옮기면서도 마스크 혼합으로 구조를 유지했다.
- 새 과제와 데이터셋, 그리고 검증 : 비의류 자연 이미지를 참조로 쓰는 패션 디자인 과제를 정의하고 OceanBag 데이터셋을 공개했으며, 사용자 연구·자동 지표·절제 실험으로 구조 보존과 외관 전이의 균형이 기존 방법보다 낫다는 것을 보였다.
관련 개념
참조 기반 패션 디자인 과제와 기존 접근의 한계
참조 기반 패션 디자인은 의류 이미지 $x_0^{S}$ 의 구조를 보존하면서 참조 외관 이미지 $x_0^{A}$ 의 외관을 옮겨 자연스러운 새 의류를 만드는 과제입니다(Fig. 1). 전통적 스타일 변환의 콘텐츠·스타일 대신 이 논문은 의류(구조)·외관 이라는 용어를 씁니다.
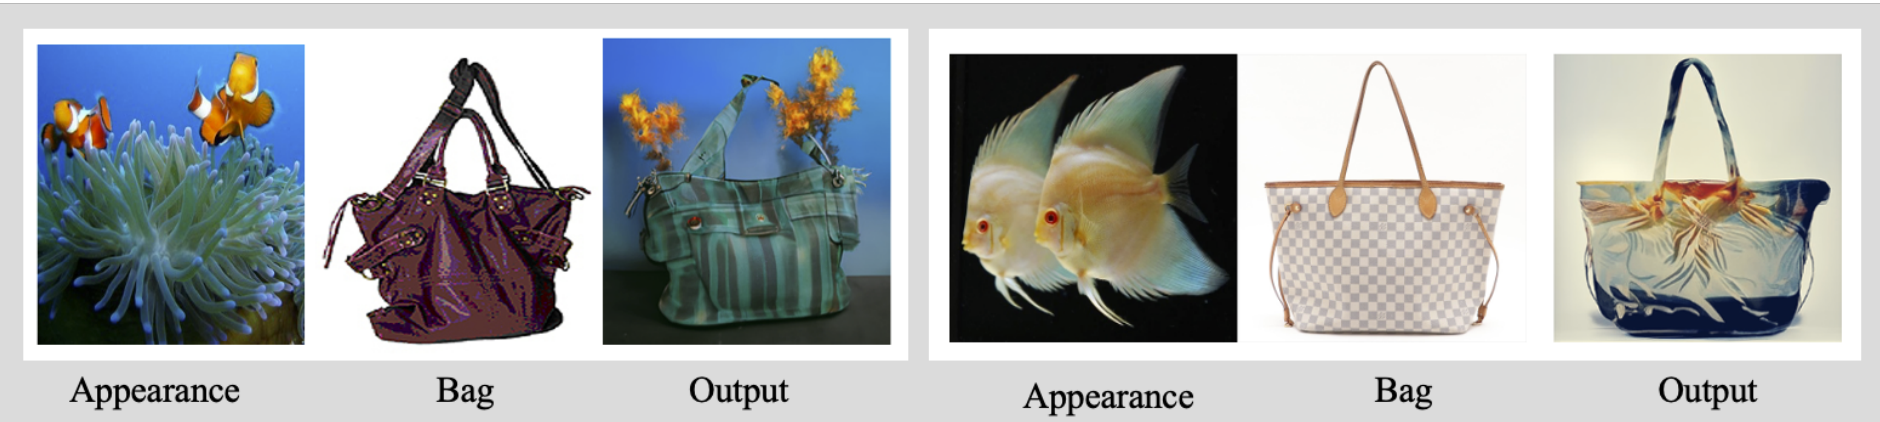
🧭 1. 두 가지 도전 과제 (Section IV-A)
| 도전 | 내용 |
|---|---|
| 정답 없음 | 패션 디자인에는 표준 출력이 없어 참조 결과 이미지를 제공할 수 없고, 실제 상황의 지도 없이 모델을 학습하기 어려움 |
| 구조 보존 미비 | 외관을 옮기면서 입력 의류의 구조 정보를 보존하는 문제는 연구가 부족 |
DiffFashion 은 두 문제를 사전 학습 확산 모델의 추론 시 안내만으로 풀어 학습 자체를 없앱니다.
🗂️ 2. 기존 접근 비교 (Section II)
| 계열 | 대표 | 강점 | 한계 |
|---|---|---|---|
| GAN 기반 패션 디자인 | Design Inspiration from Generative Networks, FashionGAN | 의류 도메인 내 스타일 전이 | 외관이 의류 도메인 밖이면 구조·외관 제어 어려움 |
| GAN 기반 이미지 변환 | CycleGAN 류 | 쌍 없는 변환 | 대량 학습 데이터, 도메인 격차에 취약 |
| 확산 기반 변환 | DiffuseIT, SplicingViT | DINO-ViT 로 구조·외관 분리, 유사 도메인에서 우수 | 격차가 크면 구조 참조의 잔여 외관을 못 지우고 텍스처가 옷감에 부적합 |
| 신경 스타일 변환 | WCT2, STROTSS | 구조 유지 | WCT2 는 색 조정 수준, STROTSS 는 색 번짐 |
🔍 3. DiffuseIT 와의 관계
DiffuseIT 는 이 논문의 기반입니다. DDPM 잠재에서 출발해 DINO-ViT 구조·외관 손실로 노이즈 제거를 안내하는 틀을 공유하되, DiffFashion 은 (1) 출발 잠재를 외관 이미지로 바꾸고, (2) 마스크 혼합으로 구조를 주입하며, (3) 외관 손실을 마스크 안에서만 계산한다는 점이 다릅니다. 실험 설정의 나머지 파라미터는 공정한 비교를 위해 DiffuseIT 와 동일하게 두었습니다.
💡 Key Takeaway 과제의 본질은 “도메인 격차가 큰 외관을 옷감처럼 자연스럽게 옮기면서 구조는 그대로 두기”이며, 기존 확산 변환은 구조 참조에 남은 외관과 옷감에 맞지 않는 텍스처 두 지점에서 실패합니다.
예비 지식: DDPM 과 레이블 조건부 확산
DDPM(Denoising Diffusion Probabilistic Model) 은 데이터에 점진적으로 가우시안 노이즈를 더하는 순방향 과정과 이를 신경망으로 되돌리는 역방향 과정으로 이루어진 잠재변수 모델입니다. DiffFashion 의 모든 노이즈 제거는 ImageNet 사전 학습 레이블 조건부 확산 모델을 사용합니다.
➡️ 1. 순방향 과정 (Section III, Eq. 1)
각 단계의 전이는 $q(x_t\mid x_{t-1})=\mathcal{N}\big(\sqrt{1-\beta_t}\,x_{t-1},\ \beta_t I\big)$ 이고, 분산 스케줄 $(\beta_t)_{t=0}^{T}$ 는 학습하거나 고정합니다. 임의 시점의 잠재는 한 번에 얻을 수 있습니다.
\[x_t=\sqrt{\bar\alpha_t}\,x_0+\sqrt{1-\bar\alpha_t}\,\epsilon,\qquad \epsilon\sim\mathcal{N}(0,I),\qquad \alpha_t=1-\beta_t,\quad \bar\alpha_t=\prod_{s=1}^{t}\alpha_s\]⬅️ 2. 역방향 과정과 학습 목적 (Eq. 2 ~ 4)
\[p_\theta(x_{t-1}\mid x_t)=\mathcal{N}\big(x_{t-1};\ \mu_\theta(x_t,t),\ \sigma^{2}I\big),\qquad \mu_\theta(x_t,t)=\frac{1}{\sqrt{\alpha_t}}\Big(x_t-\frac{1-\alpha_t}{\sqrt{1-\bar\alpha_t}}\,\epsilon_\theta(x_t,t)\Big)\]네트워크는 평균을 직접 예측하는 대신 더해진 노이즈 $\epsilon_\theta$ 를 예측하며,
\[\min_\theta L(\theta)=\mathbb{E}_{t,x_0,\epsilon}\Big[\big\|\epsilon-\epsilon_\theta\big(\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\,\epsilon,\ t\big)\big\|^{2}\Big]\]로 학습합니다.
🏷️ 3. 조건부 확산의 두 방식
| 방식 | 형태 | DiffFashion 에서의 역할 |
|---|---|---|
| 조건부 모델 | $\epsilon_\theta(x_t,t,y)$, 레이블·텍스트를 입력으로 | ImageNet 클래스 레이블 $y$ 를 조건으로 받는 guided diffusion 모델 사용. 마스크 생성과 구조 전이 모두 이 레이블 의존성을 활용 |
| 분류기 안내 | 고정 확산 모델 + 사전 학습 분류기 $p_\phi(y\mid x_t)$ 의 기울기로 평균 보정: $\hat\mu_\theta=\mu_\theta+\sigma_t\nabla\log p_\phi(y\mid x_t)$ | DiffFashion 은 분류기 대신 DINO-ViT 손실의 기울기로 같은 자리를 안내 |
💡 Key Takeaway DiffFashion 은 새 모델을 학습하지 않습니다. 레이블 조건부 $\epsilon_\theta(x_t,t,y)$ 의 레이블 의존성과 외부 손실 기울기에 의한 안내라는 기존 확산 모델의 두 성질을 조합합니다.
레이블 조건에 의한 마스크 생성
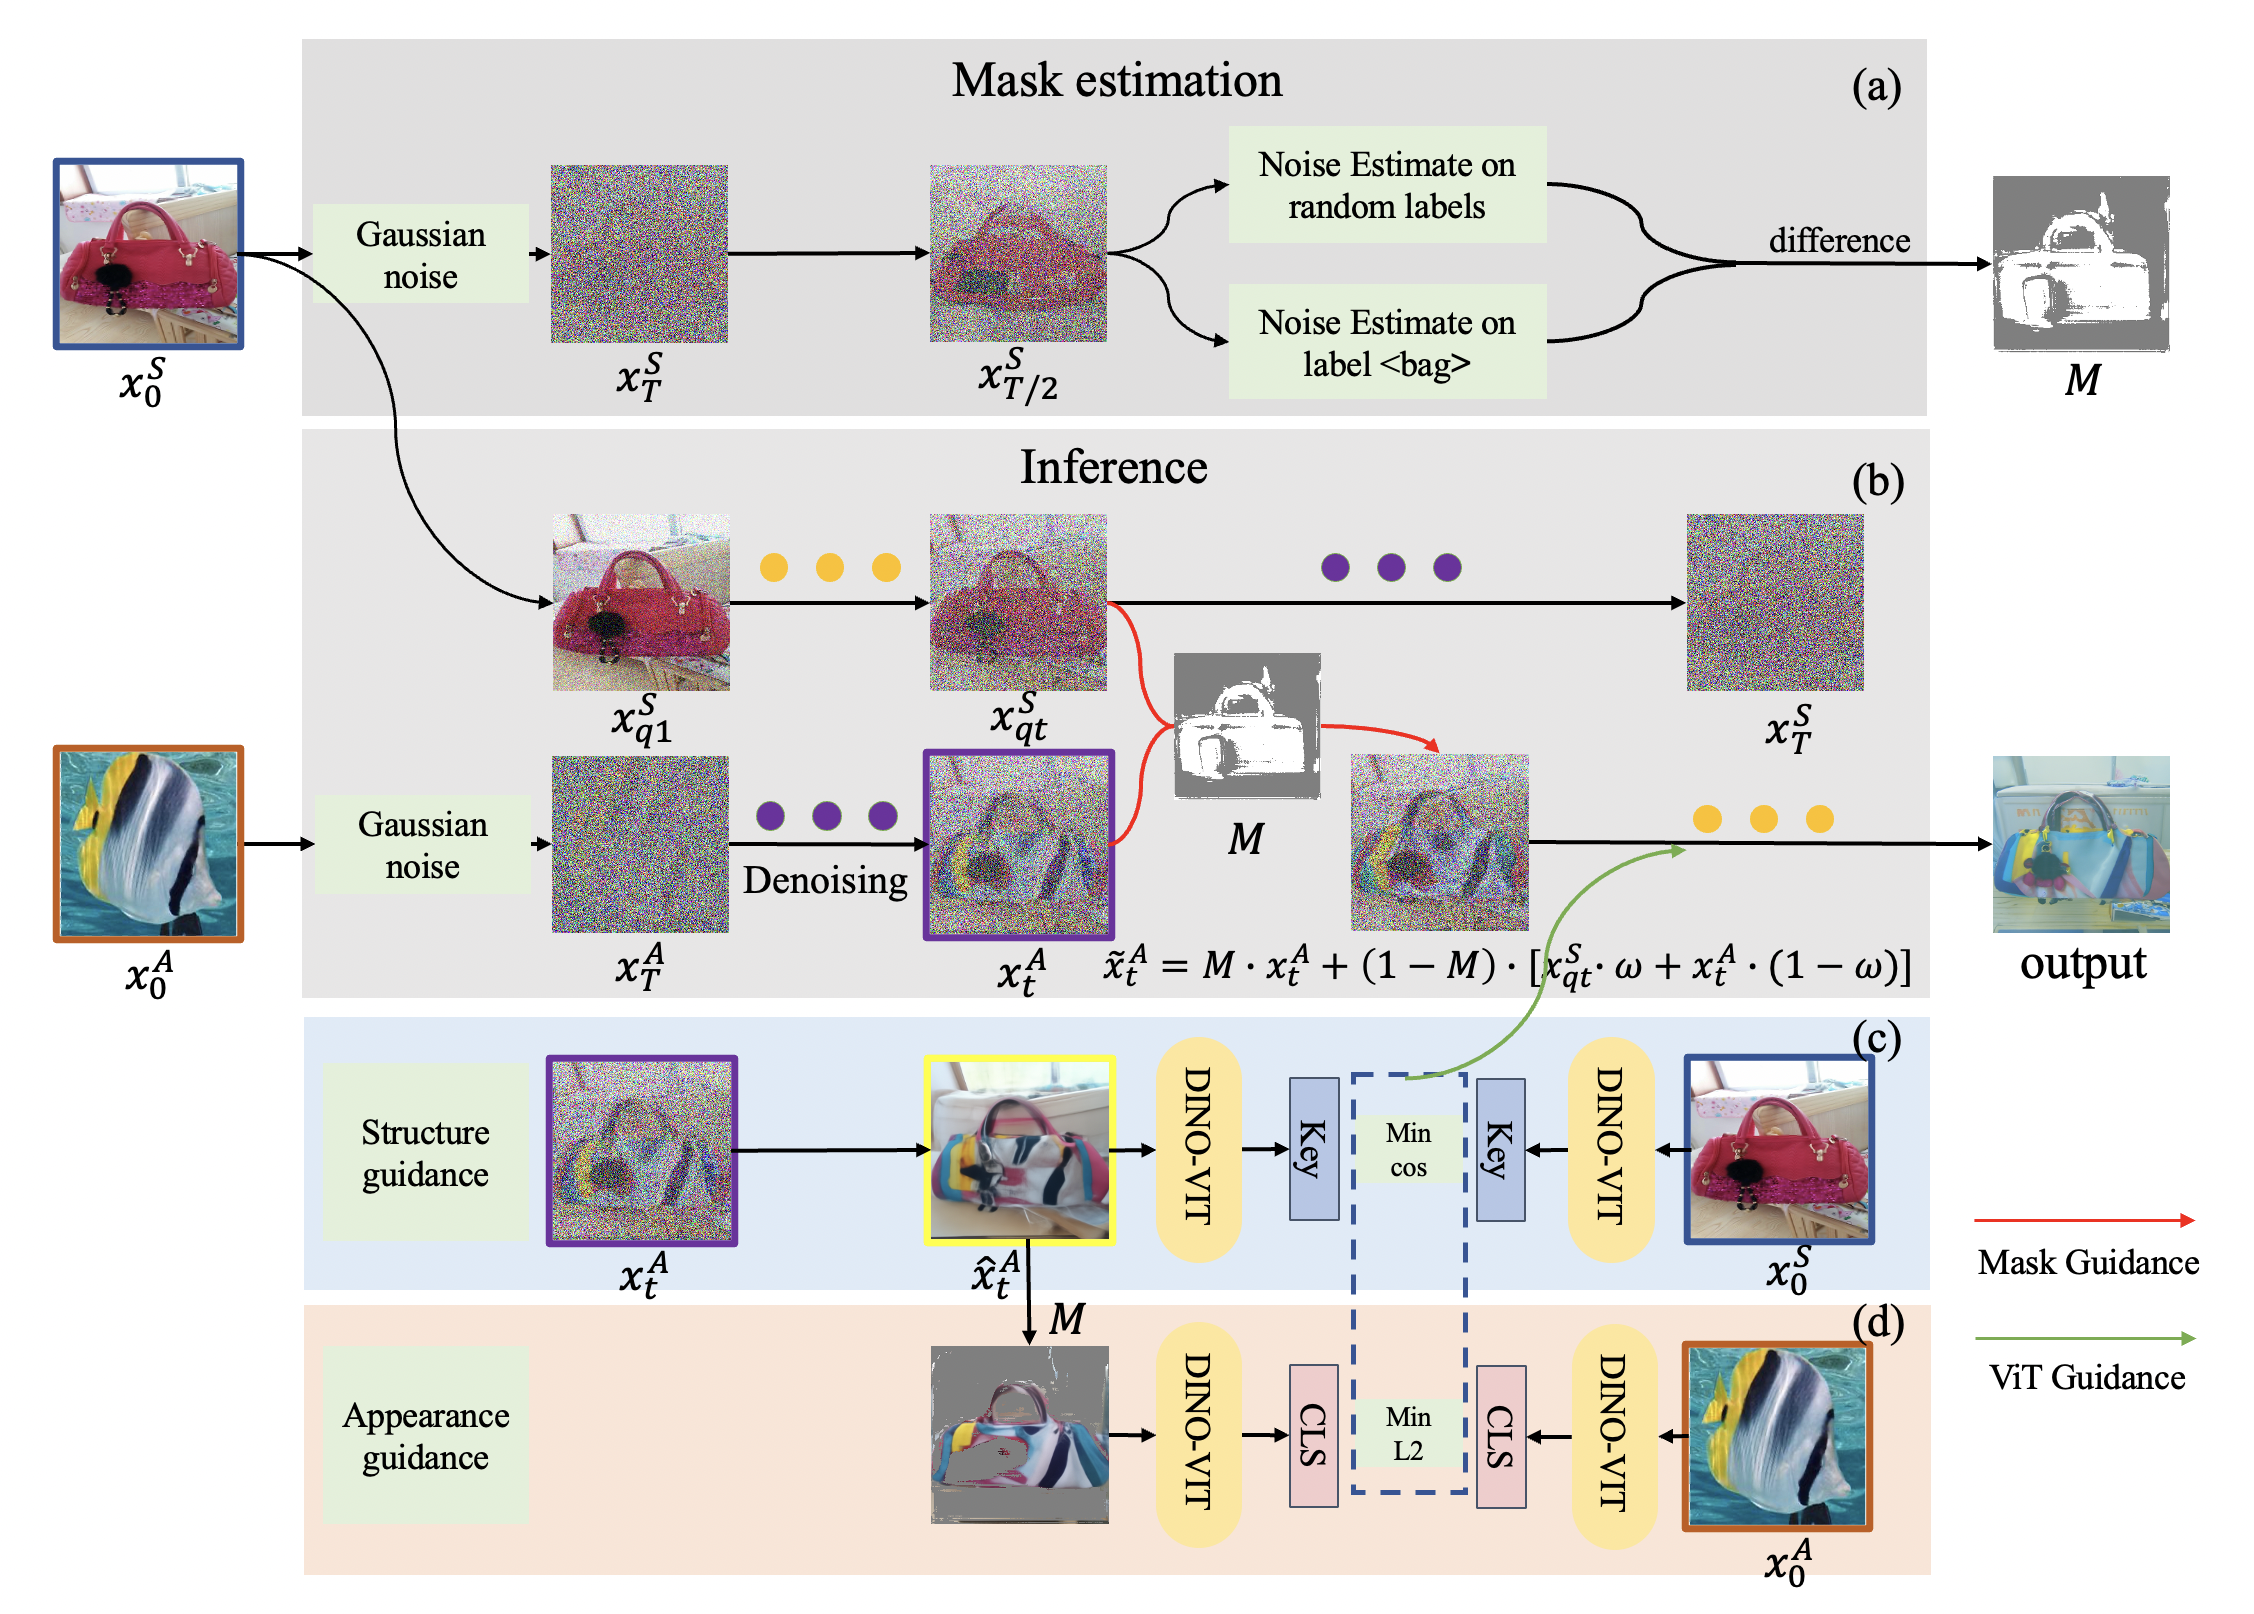
마스크 생성(Section IV-B) 은 전경 의류와 배경을 분리하는 의미 마스크 $M$ 을 외부 정보나 분할 모델 없이 얻는 단계입니다. 레이블 조건부 모델이 다른 레이블에 대해 다른 노이즈를 추정한다는 성질을 이용합니다.
💡 1. 핵심 관찰
같은 잠재에 대해 “핸드폰”, “가방” 처럼 다른 레이블 조건을 주면 노이즈 추정이 달라집니다. 이때 배경 영역의 추정은 레이블에 둔감해 거의 변하지 않지만, 전경 객체 영역은 크게 변합니다. 두 노이즈 맵의 차이를 취하면 편집 대상 객체의 마스크가 드러납니다(Fig. 2(a)).
🧮 2. 절차 (Eq. 5 ~ 7)
- 의류 이미지 $x_0^{S}$ 를 순방향으로 인코딩한 뒤 역방향 절반 지점의 잠재 $x_{T/2}^{S}$ 를 얻습니다. 순방향 잠재 $x_{qt}^{S}$ 대신 역방향 과정의 잠재를 쓰는 이유는, 그것이 지각적 외관 정보는 덜 담고 전경 객체의 전반적 구조는 더 잘 나타내기 때문입니다.
- Tweedie 공식으로 깨끗한 추정 $\hat{x}_{T/2}^{S}$ 를 계산합니다.
- 전경 레이블 $y_p$ 와 $N$ 개 비전경 레이블 $y_i$ 에 대한 노이즈 맵을 구합니다.
- 차이 $M_p-M_n$ 을 임계값으로 이진화해 수정 가능한 의미 마스크 $M$ 을 얻습니다.
⚙️ 3. 실제 설정 (Section V-B)
| 항목 | 값 |
|---|---|
| 이진화 임계값 | $-0.2$ |
| 비전경 레이블 집합 (세 벌) | “cellphone, forklift, pillow” / “waffle iron, washer, guinea pig” / “brambling, echidna, custard apple” |
| 선택 | 확산의 확률성 때문에 세 집합으로 각각 마스크를 만들고 가장 좋은 것을 선택 |
| 소요 시간 | 마스크당 20초 (RTX 3090) |
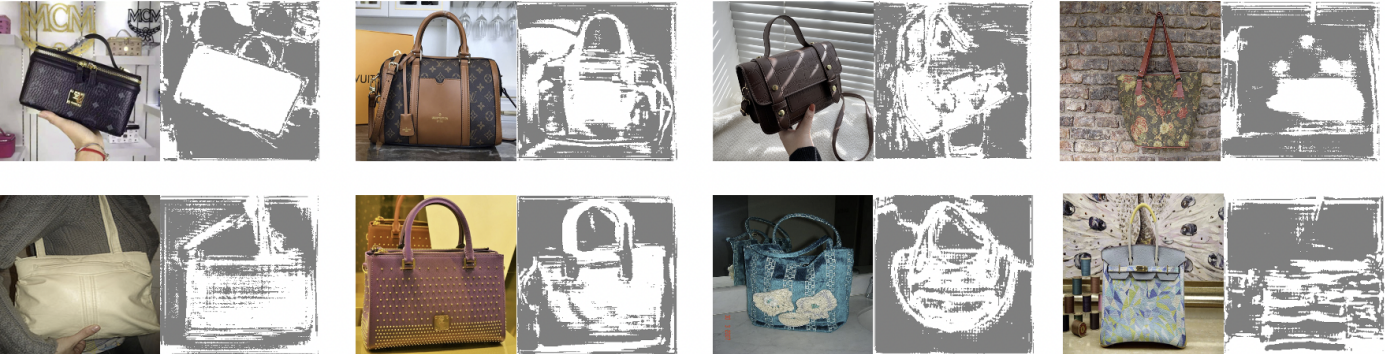
마스크는 대부분의 이미지에서 적절했으나(Fig. 5), 마지막 열처럼 확산의 무작위성으로 품질이 떨어지는 경우도 있습니다. 그런 경우에도 모델은 비교 방법보다 나은 결과를 냈습니다(Fig. 6).
💡 Key Takeaway “레이블을 바꾸면 전경만 노이즈 추정이 흔들린다”는 성질이 분할 모델 없는 마스크를 만들어 줍니다. 깨끗한 Tweedie 추정에서 노이즈 맵을 뽑는 것과 역방향 잠재를 쓰는 것이 품질의 열쇠입니다.
마스크 유도 구조 전이 확산
마스크 유도 구조 전이(Section IV-C) 는 DiffFashion 의 가장 독창적인 부분으로, 노이즈 제거의 출발 잠재를 의류가 아니라 외관 이미지로 바꾸고 마스크로 구조를 주입합니다.
🔄 1. 왜 출발점을 바꾸는가
| 접근 | 출발 잠재 | 문제 |
|---|---|---|
| DiffuseIT 등 기존 | 의류(구조) 이미지 $x_0^{S}$ | 단일 가이드 손실로 외관을 제어하므로 구조 참조에 남은 잉여 외관 정보를 완전히 제거하지 못함. 자연 이미지의 텍스처가 옷감에 부적합 |
| DiffFashion | 외관 이미지 $x_0^{A}$ | 같은 DDPM 잠재를 다른 레이블로 복원하면 질감과 의미 구조가 비슷한 이미지가 나온다는 성질을 이용해, 외관 잠재가 가진 더 적합하고 사실적인 텍스처를 의류로 옮김 |
즉 “의류에 외관을 입히는” 대신 “외관에 의류 구조를 입히는” 방향으로 문제를 뒤집습니다.
🧮 2. 노이즈 제거와 마스크 혼합 (Eq. 8, 9)
외관 이미지를 순방향으로 인코딩한 뒤, 매 단계 전경 레이블 $y_p$ 조건으로 새 추정을 얻습니다.
\[x_t^{A}=\frac{1}{\sqrt{\alpha_{t+1}}}\Big(x_{t+1}^{A}-\frac{1-\alpha_{t+1}}{\sqrt{1-\bar\alpha_{t+1}}}\,\epsilon_\theta\big(x_{t+1}^{A},\ t+1,\ y_p\big)\Big)\]그리고 마스크 $M$ 으로 전경은 전이된 외관을, 배경은 의류 이미지의 같은 시점 순방향 잠재 $x_{qt}^{S}$ 를 주로 쓰도록 섞습니다.
\[\tilde{x}_t^{A}=M\cdot x_t^{A}+(1-M)\cdot\Big[\omega_{mix}\cdot x_{qt}^{S}+(1-\omega_{mix})\cdot x_t^{A}\Big]\]$\omega_{mix}$ 는 외관 이미지와 의류 이미지의 혼합 비율입니다. 마스크 안의 외관 정보는 전이되고, 그 밖의 구조 정보는 의류 이미지와 일관되게 유지됩니다.
⚙️ 3. 설정과 절제 결과
| 항목 | 값 / 결과 |
|---|---|
| $\omega_{mix}$ | 0.98 |
| 마스크 가이드 적용 구간 | 노이즈 제거 처음 50% 단계에만. 두 객체의 구조 차이가 너무 커질 때의 정보 손실과 마스크 불안정 효과를 완화 |
| 마스크 미적용 확률 | 0.2. 일부 이미지에서 마스크가 외관 상관을 떨어뜨리는 문제를 완화 |
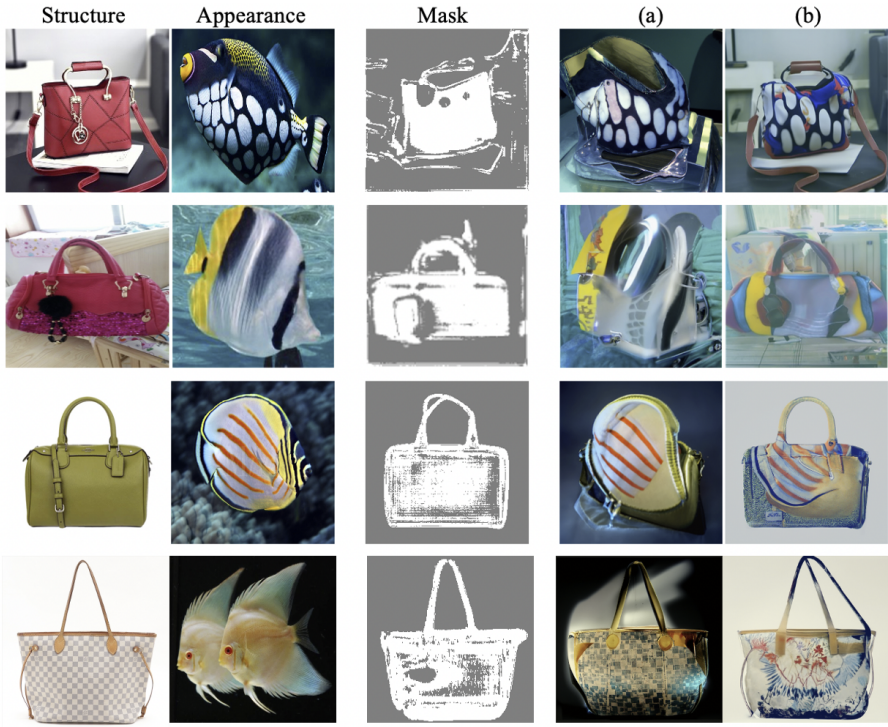
| 마스크 없이 (Fig. 7(a)) | 많은 이미지에서 확산 중 가방 구조가 파괴됨 |
| 마스크 있음 (Fig. 7(b)) | 구조 유지. 일부는 외관 상관이 약간 줄지만 전이는 완료 |
💡 Key Takeaway “입력 잠재와 구조 전이를 맞바꾼다” 가 DiffFashion 의 한 줄 요약입니다. 외관 잠재에서 출발해 사실적 텍스처를 확보하고, 마스크 혼합이 초반 50% 동안 의류 구조를 고정합니다.
DINO-ViT 특징 안내: 외관 손실과 구조 손실
ViT 특징 안내(Section IV-D) 는 DiffuseIT·SplicingViT 에서 확립된 DINO-ViT 의 구조·외관 분리를 사용해, 노이즈 제거 과정 전체에서 출력이 사실적이고 입력과 일치하도록 안내합니다.
🎨 1. 외관 손실 (Eq. 10)
ViT 마지막 층의 [CLS] 토큰 $e_{[CLS]}^{L}$ 이 의미적 외관 정보를 담는다는 관찰에 따라,
\[L_{app}\big(x_0^{A},\hat{x}_t^{A}\big)=\big\|e_{[CLS]}^{L}(x_0^{A})-e_{[CLS]}^{L}(\hat{x}_t^{A})\big\|_2+\lambda_{MSE}\big\|x_0^{A}-\hat{x}_t^{A}\big\|_2\]두 번째 항은 이미지 간 전역 통계 손실입니다. DiffFashion 은 여기서 한 걸음 더 나아가 마스크 $M$ 으로 $\hat{x}_t^{A}$ 의 배경 픽셀을 제거하고 마스크 안 객체의 외관 손실만 계산합니다. 외관을 배경이 아니라 의류 객체에 집중시키기 위해서입니다.
🏗️ 2. 구조 손실 (Eq. 11, 12)
ViT 의 $l$ 번째 어텐션 층 $i$ 번째 패치의 키 벡터 $k_i^{l}$ 가 지역 구조를 담는다는 관찰에 따라, 같은 위치의 키는 가깝게, 다른 위치의 키는 멀게 하는 패치별 대조 손실을 씁니다.
\[L_{struct}\big(x_0^{A},\hat{x}_t^{A}\big)=-\sum_i\log\Bigg(\frac{\mathrm{sim}\big(k_i^{l,S},k_i^{l,A}\big)}{\mathrm{sim}\big(k_i^{l,S},k_i^{l,A}\big)+\sum_{j\neq i}\mathrm{sim}\big(k_i^{l,S},k_j^{l,A}\big)}\Bigg)\] \[\mathrm{sim}\big(k_i^{l,S},k_j^{l,A}\big)=\exp\Big(\cos\big(k_i^{l}(x_0^{S}),\ k_j^{l}(\hat{x}_t^{A})\big)/\tau\Big)\]$\tau$ 는 온도입니다. 구조는 의류 이미지 $x_0^{S}$ 의 키를 기준으로 하므로, 출발 잠재가 외관 이미지여도 구조는 의류를 따릅니다.
⚖️ 3. 총 손실과 가중치 (Eq. 13)
\[L_{total}=\lambda_{struct}L_{struct}+\lambda_{app}L_{app},\qquad \lambda_{struct}=1,\quad \lambda_{app}=0.1\]| 항목 | 값 |
|---|---|
| 확산 단계 $T$ | 60 |
| 재샘플링 반복 $N$ | 10 |
| 해상도 | $256\times256$ |
| 기타 파라미터 | DiffuseIT 와 동일 |
| 이미지당 소요 | 120초 (RTX 3090) |
구조 손실 가중치가 외관의 10배라는 점은 이 과제에서 구조 보존이 우선임을 반영합니다. 외관은 출발 잠재가 이미 외관 이미지이므로 손실로 강하게 당길 필요가 적습니다.
💡 Key Takeaway 외관은 [CLS] 토큰, 구조는 어텐션 키라는 DINO-ViT 의 분리를 그대로 쓰되, 외관 손실을 마스크 안으로 제한하고 구조 기준을 의류 이미지로 두는 것이 DiffFashion 의 변형입니다.
OceanBag 데이터셋과 실험 결과
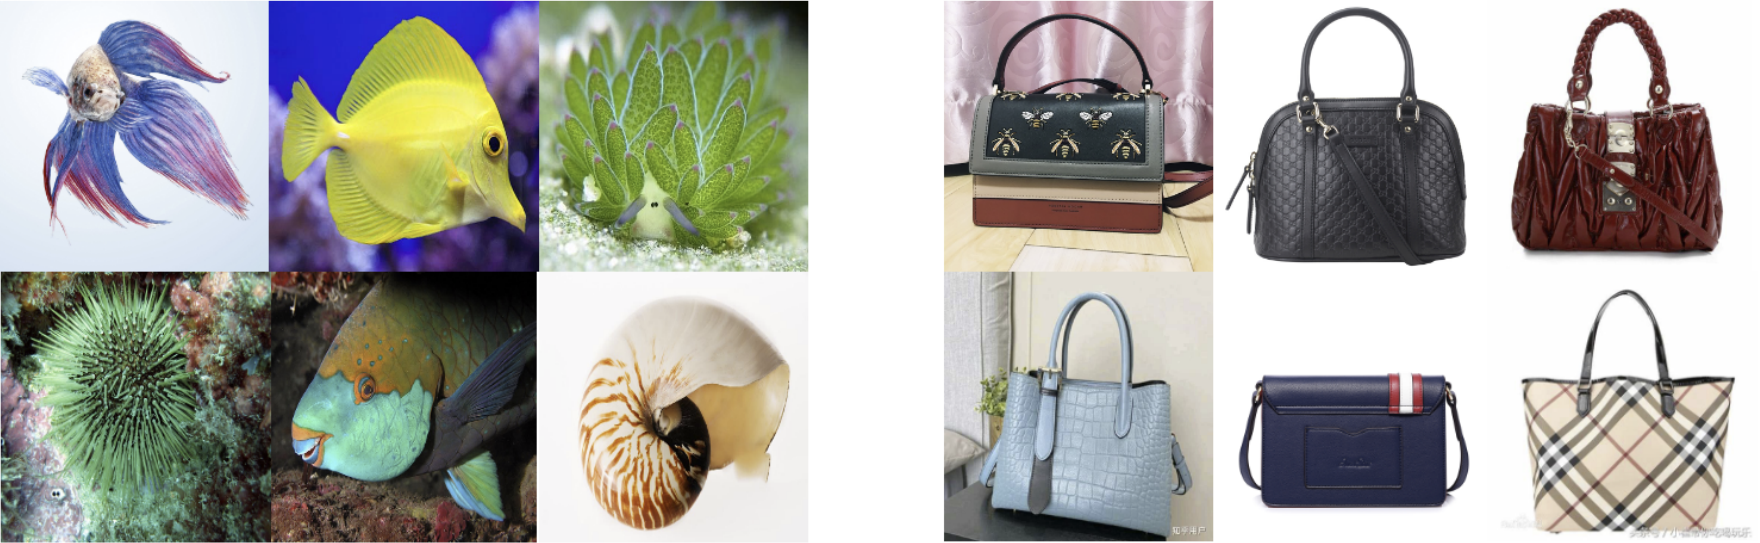
OceanBag 은 참조 기반 패션 디자인용 데이터셋이 없어 저자들이 직접 수집한 것으로, 실제 핸드백 이미지와 해양 생물 이미지로 구성됩니다. 평가는 자동 지표가 마땅치 않아 사용자 연구를 중심으로 하고 사전 학습 모델 기반 지표를 보조로 씁니다.
🐠 1. 데이터셋 (Section V-A, Table I)
| 구성 | 수량 | 크기 | 복잡 배경 비율 |
|---|---|---|---|
| 핸드백 | 6,000 | $256\times256$ | 0.16 |
| 해양 생물 | 2,400 | $256\times256$ | 0.43 |
해양 생물 이미지는 80종 이상이며 절반이 물고기이고 게, 해초 등도 포함됩니다. 단색 배경은 단순, 실제 장면은 복잡 배경으로 분류합니다. 실험에는 배경 복잡도·종류·개체 수 다양성을 기준으로 30장을 선별했습니다.
🧑⚖️ 2. 사용자 연구 (Table II, 30명, 0 ~ 100점)
세 질문, 즉 (1) 사실적인가, (2) 구조가 입력 의류와 유사한가, (3) 외관이 참조 이미지와 유사한가를 묻고 평균을 종합 점수로 삼았습니다.
| 방법 | 종합 | 사실성 | 구조 | 외관 |
|---|---|---|---|---|
| SplicingViT | 60.98 | 68.44 ± 4.36 | 80.80 ± 7.82 | 33.70 ± 8.32 |
| DiffuseIT | 67.09 | 75.53 ± 4.68 | 88.46 ± 5.40 | 37.27 ± 8.36 |
| WCT2 | 65.45 | 82.89 ± 5.42 | 95.76 ± 1.84 | 17.69 ± 5.77 |
| STROTSS | 63.00 | 63.33 ± 6.43 | 82.55 ± 6.65 | 43.11 ± 8.93 |
| DiffFashion | 75.04 | 81.15 ± 4.76 | 91.07 ± 3.82 | 52.89 ± 7.92 |
WCT2 는 색 외에는 거의 바꾸지 않아 사실성·구조에서 최고지만 외관에서 최하위입니다. DiffFashion 은 종합과 외관에서 1위, 사실성과 구조에서 2위로 균형이 가장 좋습니다.
📊 3. 자동 지표 (Table III)
| 방법 | 분류 손실 ↓ | Mask-RCNN 재현율 ↑ | CDH ↓ |
|---|---|---|---|
| DiffuseIT | 7.62 ± 4.38 | 0.17 | 0.13 |
| SplicingViT | 6.03 ± 3.68 | 0.03 | 0.07 |
| WCT2 | 9.56 ± 4.16 | 0.53 | 0.23 |
| STROTSS | 11.20 ± 3.52 | 0.06 | 0.43 |
| DiffFashion | 5.93 ± 4.72 | 0.2 | 0.22 |
- 분류 손실은 improved DDPM 이 제공한 ImageNet 사전 학습 분류기의 평균 손실로, DiffFashion 이 가장 낮아 가방으로 인식되는 정도가 가장 높습니다.
- Mask-RCNN(COCO) 재현율은 분포 밖 데이터라 전반적으로 낮고, 전체 이미지 색만 바꾸는 WCT2 다음으로 DiffFashion 이 높습니다.
- 색 차이 히스토그램(CDH)은 결과와 외관 이미지의 색 분포 차이로, 이미지 변환 계열보다 NST 계열이 낮지만 이는 단순 색 변환의 결과라고 저자들은 해석합니다.
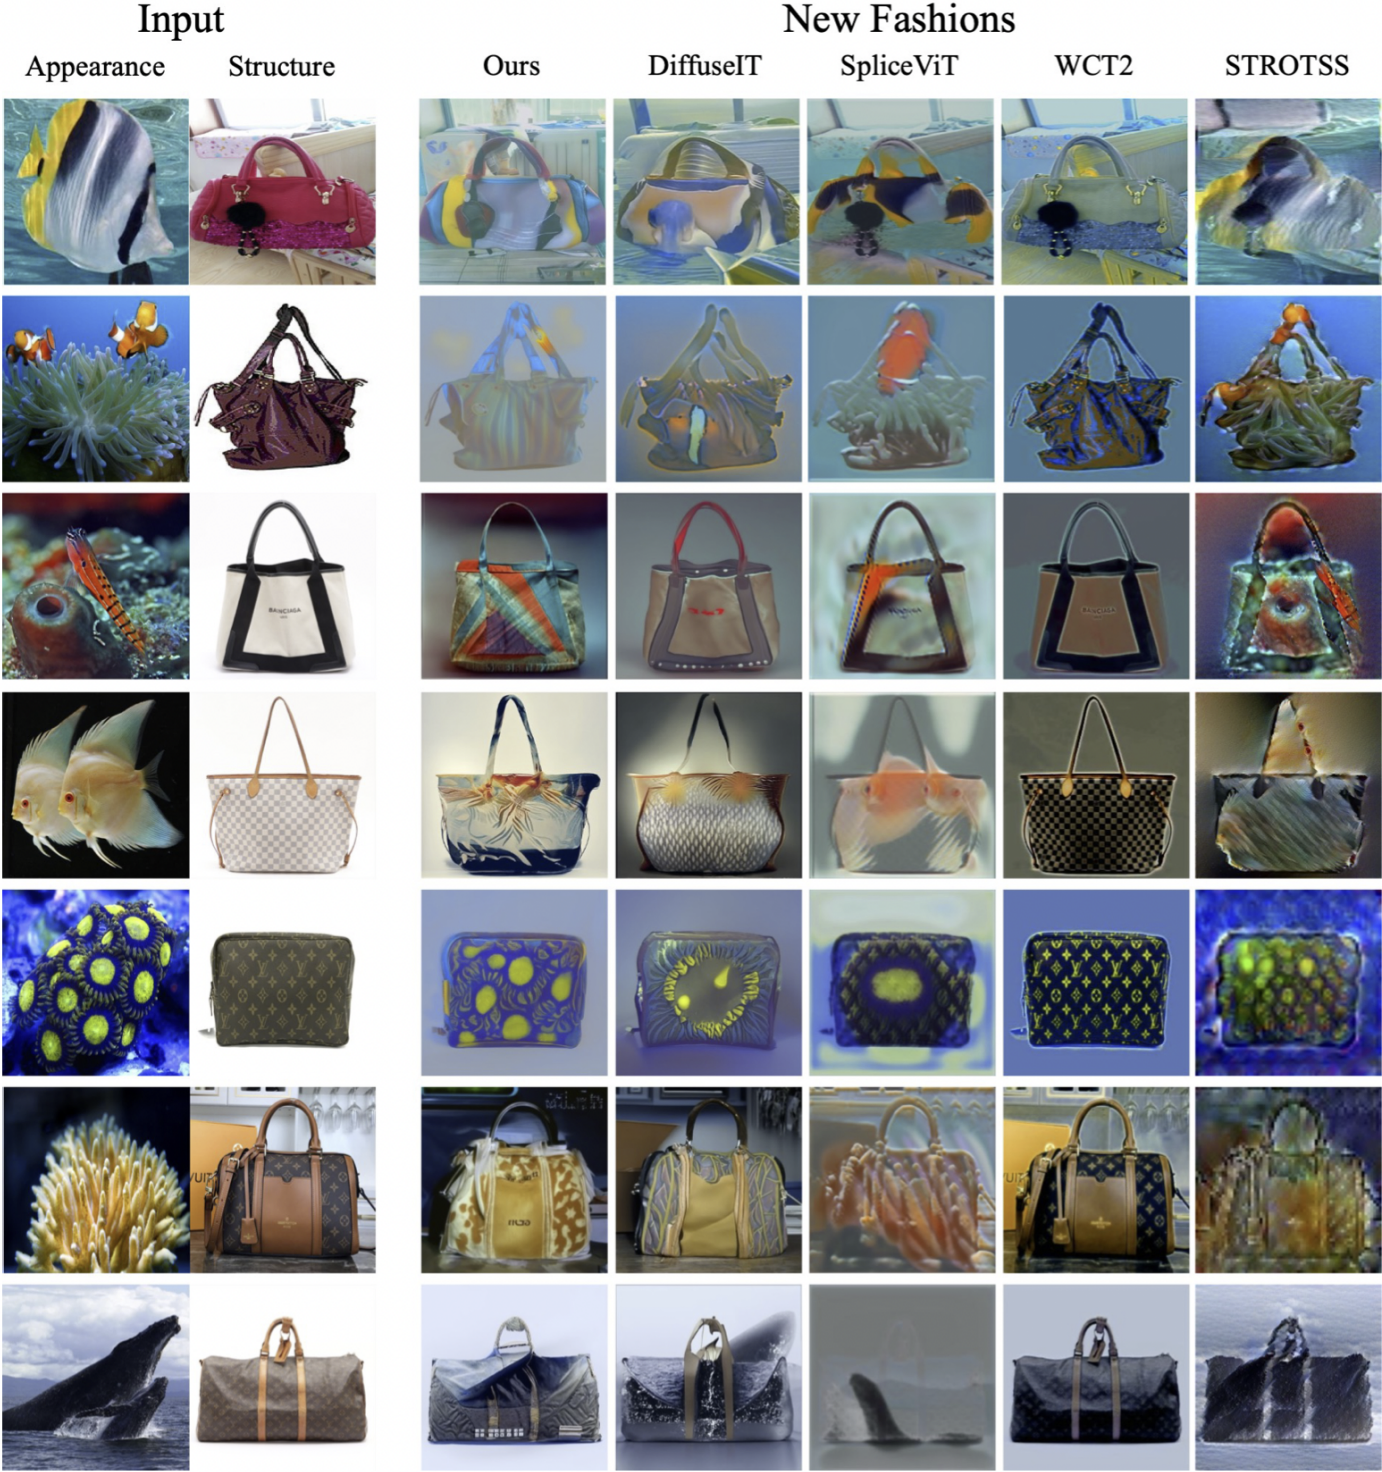
🖼️ 4. 정성 비교와 절제 (Fig. 4, 8, 9)
| 비교 | 관찰 |
|---|---|
| DiffuseIT | 구조는 유지하지만 외관 유사도 낮음 |
| SplicingViT | 외관은 잘 옮기지만 사실적 패션 이미지와 거리가 멂 |
| WCT2 / STROTSS | 구조 유지. WCT2 는 색 조정 수준, STROTSS 는 색 번짐 |
| DiffuseIT + 레이블 조건부 모델 + “bag” 조건 (Fig. 8) | 여전히 DiffFashion 이 구조·외관·사실성에서 우세 |
| DiffuseIT + 텍스트 안내 “ocean-style handbag” 등 (Fig. 9) | 과제 완수 실패 |
💡 Key Takeaway 사용자 연구와 분류 손실 모두에서 DiffFashion 이 구조와 외관의 균형에서 앞섭니다. 레이블 조건부 모델을 DiffuseIT 에 그대로 붙여도 같은 결과가 나오지 않는다는 절제가, 이득이 모델이 아니라 잠재 교환 + 마스크 혼합 설계에서 온다는 것을 보여 줍니다.
한계와 열린 방향
한계는 마스크 생성의 확률성, 느린 추론, 평가의 주관성, 그리고 ImageNet 레이블 의존에서 나옵니다. 저자들은 마스크 품질을 명시적 향후 과제로 남깁니다.
⚠️ 1. 논문이 밝힌 한계
- 마스크의 불안정성: 확산의 무작위성 때문에 마스크가 항상 좋은 결과를 보장하지 못합니다. 저자들은 세 레이블 집합으로 만든 마스크 중 최선을 고르는 방식과 마스크 미적용 확률 0.2 로 완화했지만, 근본 해결은 아닙니다. 향후 다른 모달리티 정보로 확산을 제약해 더 좋은 마스크를 만드는 것을 과제로 제시합니다.
- 추론 비용: $256\times256$ 한 장에 마스크 20초 + 생성 120초(RTX 3090)이며, 공정 비교를 위해 DiffuseIT 도 세 번 실행했습니다. 재샘플링 $N=10$ 과 ViT 기울기 계산이 주된 비용입니다.
- 평가의 주관성: 적합한 자동 지표가 없어 30명 사용자 연구가 주 지표이며, 자동 지표는 분포 밖 모델(Mask-RCNN) 의존이라 재현율이 전반적으로 낮습니다.
🔗 2. 구조적 의존성
| 의존 | 설명 |
|---|---|
| ImageNet 레이블 공간 | 전경 레이블 $y_p$ 가 ImageNet 클래스(“bag” 등)에 있어야 마스크 생성과 구조 전이가 작동. 레이블이 없는 의류 범주로의 확장은 불명 |
| $256^2$ 해상도 | 사전 학습 guided diffusion 의 해상도에 묶여 실제 디자인 작업에 쓰기에는 낮음 |
| 데이터셋 범위 | OceanBag 은 핸드백 + 해양 생물이라는 한 쌍의 도메인만 다루며, 의복·신발 등 다른 의류와 다른 참조 도메인으로의 일반화는 검증되지 않음 |
| ω_mix 와 50% 구간 | 혼합 비율과 적용 구간이 경험적으로 고정되어 있어 구조 차이가 매우 큰 쌍에서는 재조정이 필요할 수 있음 |
🚀 3. 열린 방향
- 레이블 대신 텍스트 또는 이미지 조건(CLIP, Stable Diffusion 류)으로 마스크 생성과 전이를 옮기면 레이블 공간 제약과 해상도 한계를 동시에 풀 수 있습니다. 다만 Fig. 9 가 보여 주듯 단순 텍스트 안내만으로는 부족하므로, 마스크 혼합 같은 구조 주입이 함께 필요합니다.
- 외부 분할 모델(SAM 등)로 마스크를 대체하거나 보정하면 확률성 문제를 줄일 수 있고, 반대로 이 논문의 레이블 차이 마스크는 분할 모델이 없는 도메인에서의 대안으로 남습니다.
- 외관 손실을 [CLS] 토큰 하나에 의존하는 대신 패치 수준 외관 통계로 확장하면 패턴의 공간 배치까지 제어할 여지가 있습니다.
💡 Key Takeaway DiffFashion 의 병목은 마스크의 확률성과 ImageNet 레이블 의존입니다. “외관 잠재에서 출발 + 마스크로 구조 주입” 이라는 설계는 모델과 독립적이므로, 더 큰 텍스트 조건부 모델로 옮기는 것이 자연스러운 다음 단계입니다.