 You know maize mean?
VITON: An Image-based Virtual Try-on Network
0. Summary
기본 정보 : ArXiv,2017.11.22 (CVPR 2018), VITON: An Image-based Virtual Try-on Network
연구 배경
온라인 의류 쇼핑이 급성장했지만 “입어 보지 못한다”는 근본적 제약은 그대로였다. 기존 가상 피팅은 3D 신체 스캔과 물리 기반 옷 시뮬레이션에 의존해 비용이 높고 일반 소비자가 접근하기 어려웠다. 한편 2D 이미지 생성 연구에서는 조건부 GAN과 encoder-decoder가 발전했지만, 가상 피팅에 바로 적용하기에는 두 가지 문제가 있었다. 첫째, 학습에 쓸 수 있는 정답은 “같은 사람이 대상 옷을 입은 사진” 하나뿐이고 그 사진이 곧 입력이기도 해서, 원래 옷 정보가 입력에 남아 있으면 네트워크가 복사 지름길을 배운다. 둘째, 생성 모델은 전역적으로 비슷한 이미지는 잘 만들지만 로고·텍스트·패턴 같은 옷의 세부를 보존하지 못한다. 당시 CAGAN은 조건부 순환 일관성으로 옷을 바꾸려 했지만 세부 보존과 큰 자세 변화 처리에 한계가 있었다.
제안 방법
VITON은 3D 정보 없이 RGB 이미지만으로 동작하는 coarse-to-fine 2단계 파이프라인이다. 먼저 자세 히트맵(18채널), 흐린 체형 마스크(1채널), 얼굴·머리 RGB(3채널)로 이루어진 의류 무관 사람 표현(clothing-agnostic person representation) $p\in\mathbb{R}^{256\times192\times22}$ 을 만들어 원래 옷을 지운다. 1단계 다중 과제 encoder-decoder $G_C$ 는 $p$ 와 대상 옷 $c$ 를 받아 거친 결과 $I’$ 과 옷 영역 마스크 $M$ 을 동시에 출력하며, VGG19 지각 손실과 마스크 L1 손실로 학습된다. 2단계에서는 예측된 마스크 $M$ 과 옷 이미지의 전경 마스크 사이에 형상 문맥(shape context) 매칭으로 TPS 변형을 추정해 옷을 왜곡한 $c’$ 을 만들고, 정제 네트워크 $G_R$ 이 합성 마스크 $\alpha$ 를 예측해 $\hat{I}=\alpha\odot c’ + (1-\alpha)\odot I’$ 로 세부를 “복사해 붙인다”. 정제 손실은 상위 VGG 층만 쓰는 지각 손실에 $-\lambda_{warp}|\alpha|_1$ 과 TV 정규화를 더한 형태다.
발견 사실
새로 수집한 Zalando 데이터셋(16,253쌍, 학습 14,221 / 테스트 2,032, 테스트는 옷을 뒤섞은 비쌍)에서 AMT 쌍별 사용자 평가 결과 VITON은 77.2%로 가장 높은 선호도를 얻었고, CRN(69.1%), encoder-decoder 단독(58.4%), 비모수적 복사-붙여넣기(46.4%), PRGAN(27.3%), CAGAN(21.8%)이 뒤를 이었다. 반면 Inception Score는 비모수 기준선(3.373)이 실제 데이터(3.312)보다 높고 VITON(2.514)은 중간에 그쳐, IS가 가상 피팅 평가에 부적합하다는 것을 명시적으로 보였다. 0.25초 제한 실제/가짜 판별 테스트에서 생성 이미지의 17.18%가 실제로, 실제 이미지의 11.46%가 생성으로 판정되었다. 사람 표현 ablation에서는 체형을 뺀 표현 대비 67.6%, 자세를 뺀 표현 대비 77.4%로 완전한 표현이 선호되었다. 실패는 드문 자세와 원래 옷과 대상 옷의 형태가 크게 다른 경우에 집중되었다.
핵심 기여
- 의류 무관 사람 표현 : 자세·체형·정체성만 남기고 옷 정보를 제거한 22채널 표현을 제안해, 단일 사진만으로 자기 지도(self-supervised) 재구성 학습이 가능하게 했다(Sec. 3.1). 이 표현은 CP-VTON 등 후속 연구에서 그대로 재사용된다.
- coarse-to-fine 합성과 학습된 합성 마스크 : 거친 생성 → 옷 왜곡 → 마스크 합성의 3단계로 “생성이 못 하는 세부는 원본에서 복사한다”는 원칙을 처음 체계화했다(Sec. 3.2–3.3, Eq. 1–4).
- 데이터셋과 평가 프로토콜 : 정면 여성·상의 16,253쌍의 데이터셋을 구축하고, IS의 한계를 실증하며 쌍별 사용자 평가를 표준 프로토콜로 제시했다(Sec. 4, Table 1). 이 데이터셋은 이후 VITON 벤치마크로 널리 쓰였다.
관련 개념
의류 무관 사람 표현(Clothing-agnostic Person Representation)
사람 표현 $p$ 는 가상 피팅 네트워크의 입력이며, “대상 옷으로 바꿔도 그대로여야 할 것”만 담도록 설계됩니다. 논문은 이를 세 가지 신호의 결합으로 정의하고, 각각이 왜 필요한지 ablation으로 보입니다.
🧍 1. 세 가지 구성 요소 (Sec. 3.1, Fig. 3)
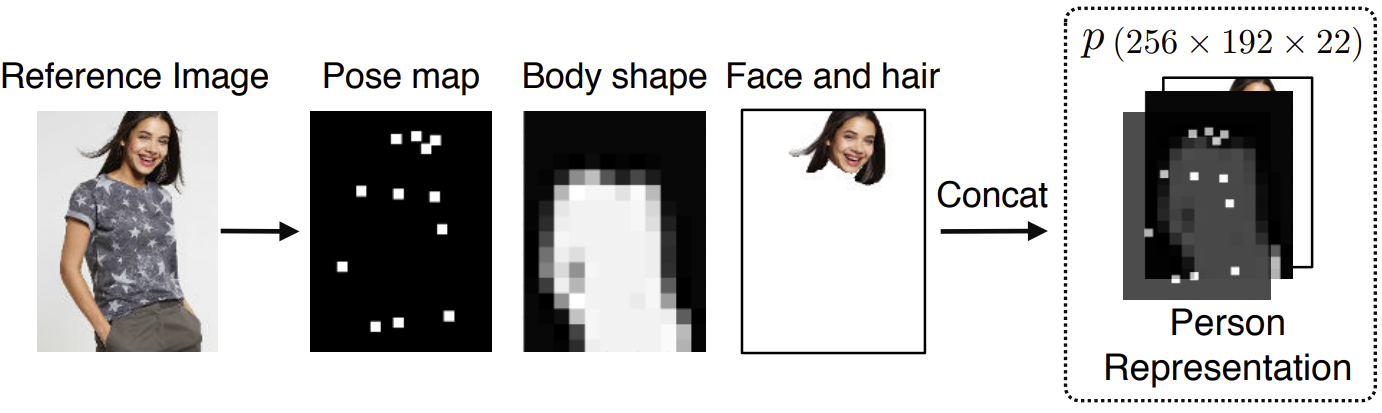
| 구성 요소 | 채널 | 생성 방법 | 역할 |
|---|---|---|---|
| 자세 히트맵 | 18 | 자세 추정기의 키포인트마다 $11\times11$ 흰 사각형 | 팔·어깨 위치 등 옷이 변형되어야 할 방식 결정 |
| 체형 | 1 | 사람 파서의 전경 마스크를 $16\times12$ 로 다운샘플한 뒤 다시 확대(흐림) | 옷의 크기를 체형에 맞추되 원래 옷의 윤곽은 지움 |
| 얼굴·머리 | 3 | 파서로 얼굴·머리 영역만 잘라낸 RGB | 정체성(피부색, 머리 모양) 유지 |
세 맵을 $256\times192$ 로 맞춰 채널 방향으로 이어 붙이면 $k=18+1+3=22$ 채널이 됩니다.
🔎 2. 왜 체형을 일부러 흐리게 만드는가
체형 마스크를 원 해상도 그대로 쓰면 원래 입은 옷의 윤곽(긴소매, 넓은 밑단)이 그대로 드러납니다. 대상 옷이 반소매라면 네트워크는 “소매가 있는 윤곽”과 “소매가 없는 옷” 사이에서 충돌을 겪고, 결과적으로 원래 옷의 잔상이 남습니다. $16\times12$ 까지 줄였다 키우면 큰 체형 정보는 남고 옷의 윤곽은 사라집니다. 이 설계는 선행 연구(Lassner 등)에서 비슷한 충돌 아티팩트가 보고된 데서 가져왔습니다.
🧪 3. Ablation: 무엇이 빠지면 무너지나 (Fig. 7)
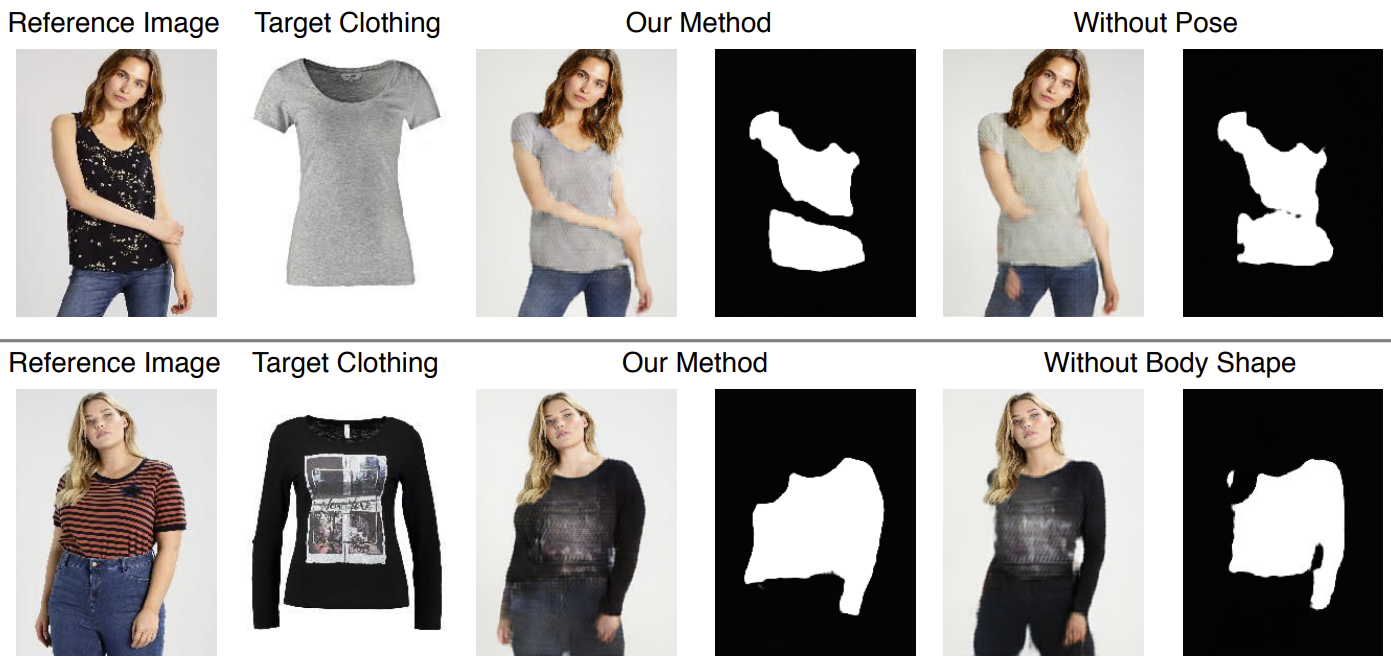
| 비교 | 완전한 표현이 선호된 비율 |
|---|---|
| vs 체형 없음(자세·얼굴만) | 67.6% |
| vs 자세 없음(체형·얼굴만) | 77.4% |
복잡한 자세에서는 체형 정보만으로 폐색과 자세 모호성을 풀 수 없고, 반대로 자세만 있으면 옷의 크기를 체형에 맞추지 못합니다. 두 정보가 상보적입니다.
💡 Key Takeaway 사람 표현은 “입력에서 옷을 지우는” 자기 지도 학습의 전제 조건입니다. 자세로 어떻게 변형할지, 체형으로 얼마나 크게, 얼굴·머리로 누구인지를 전달하며, 셋 중 하나라도 빠지면 사용자 평가가 뚜렷이 떨어집니다.
다중 과제 Encoder-Decoder 생성기
1단계 생성기 $G_C$ 는 사람 표현 $p$ 와 대상 옷 $c$ 를 받아 “옷을 입은 사람”의 거친 이미지와 옷 영역 마스크를 동시에 만드는 U-Net입니다. 마스크를 함께 예측하는 다중 과제 설계는 네트워크가 옷 영역에 집중하게 하고, 2단계 왜곡의 목표 형태를 제공합니다.
🏗️ 1. 입력·출력과 구조 (Sec. 3.2, Fig. 2 상단)
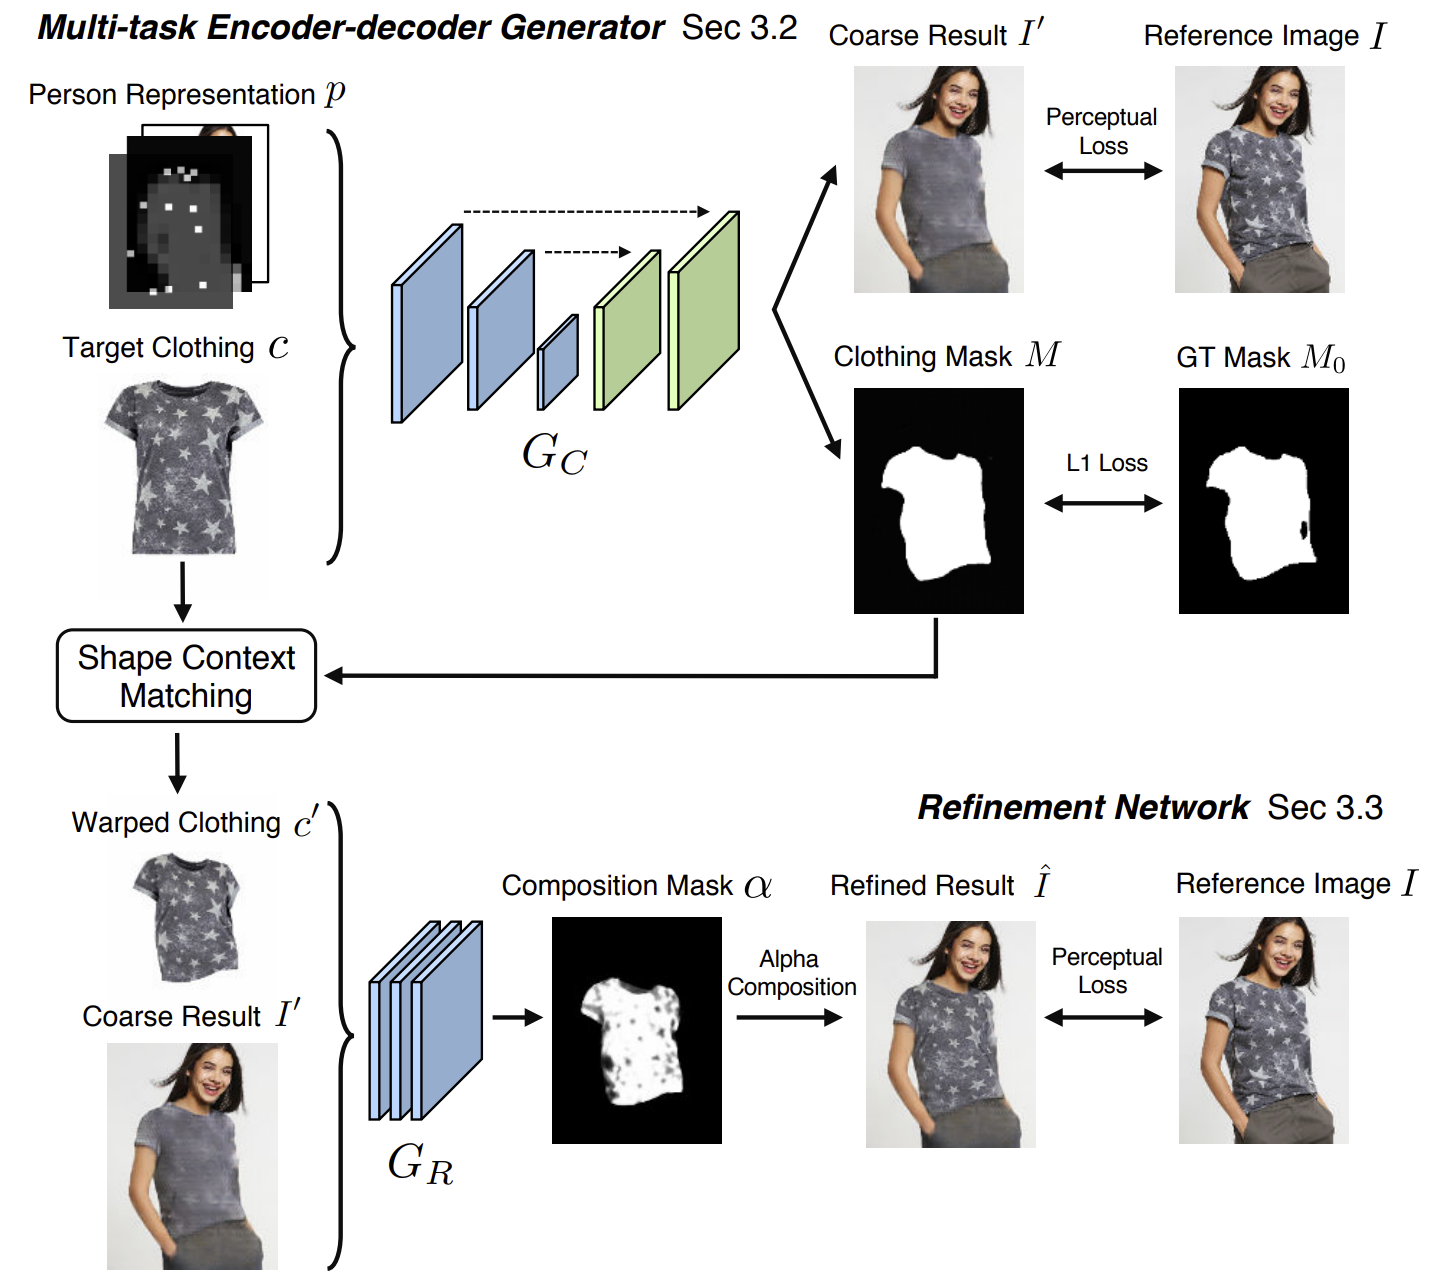
| 항목 | 설정 |
|---|---|
| 입력 | $c$ (3채널)와 $p$ (22채널)의 채널 연결 |
| 출력 | 4채널: 앞 3채널 = 거친 이미지 $I’$, 마지막 1채널 = 옷 마스크 $M$ |
| 인코더 | $4\times4$ 합성곱 6개, stride 2, 필터 64, 128, 256, 512, 512, 512 |
| 디코더 | $4\times4$ 합성곱 6개, stride 1/2, 채널 512, 512, 256, 128, 64, 4 |
| 기타 | 인코더-디코더 간 skip connection, 활성화·배치 정규화는 pix2pix와 동일 |
📐 2. 손실 함수 (Eq. 1)
\[L_{G_C} = \sum_{i=0}^{5}\lambda_i\,\|\phi_i(I') - \phi_i(I)\|_1 + \|M - M_0\|_1 \tag{1}\]- $I$ 는 정답(원본 사람 이미지), $M_0$ 는 사람 파서가 $I$ 에서 예측한 의사 정답(pseudo ground truth) 옷 마스크입니다.
- $\phi_i$ 는 ImageNet 사전학습 VGG19의 특징 맵입니다. $i\geq1$ 에서는 conv1_2, conv2_2, conv3_2, conv4_2, conv5_2 를, $i=0$ 에서는 RGB 픽셀 자체를 씁니다.
- 픽셀 L1만 쓰면 흐려지므로 지각 손실로 “내용”을 맞추고, 마스크는 이진이므로 L1로 충분합니다.
🔁 3. 거친 결과의 한계가 설계를 결정한다
1단계 결과 $I’$ 은 자세·체형·얼굴은 잘 보존하지만 옷의 텍스트·로고·패턴이 사라집니다(Fig. 5 세 번째 열). 논문은 이를 당시 생성기의 한계, 즉 “전역적으로 비슷하게 만들 줄은 알지만 어디에 어떤 세부를 그릴지 제어할 방법이 없다“는 데서 찾습니다. 그래서 세부를 생성하지 않고 복사해 오는 2단계를 둡니다.
💡 Key Takeaway 1단계는 “옷이 어디에 어떤 모양으로 놓여야 하는가”를 결정하는 레이아웃 단계입니다. 함께 예측되는 옷 마스크 $M$ 이 2단계 왜곡의 목표가 되므로, 다중 과제 설계는 단순한 보조 손실이 아니라 파이프라인의 연결 고리입니다.
형상 문맥 매칭과 TPS 왜곡
옷 왜곡(warping) 은 상점 옷 이미지 $c$ 를 사람 몸에 맞게 변형해 $c’$ 을 만드는 단계입니다. VITON은 학습 없이 형상 문맥(shape context) 기술자 + 박판 스플라인(TPS) 이라는 고전 기법(Belongie et al., 2002)을 그대로 씁니다.
🧮 1. 절차 (Sec. 3.3, Fig. 4)
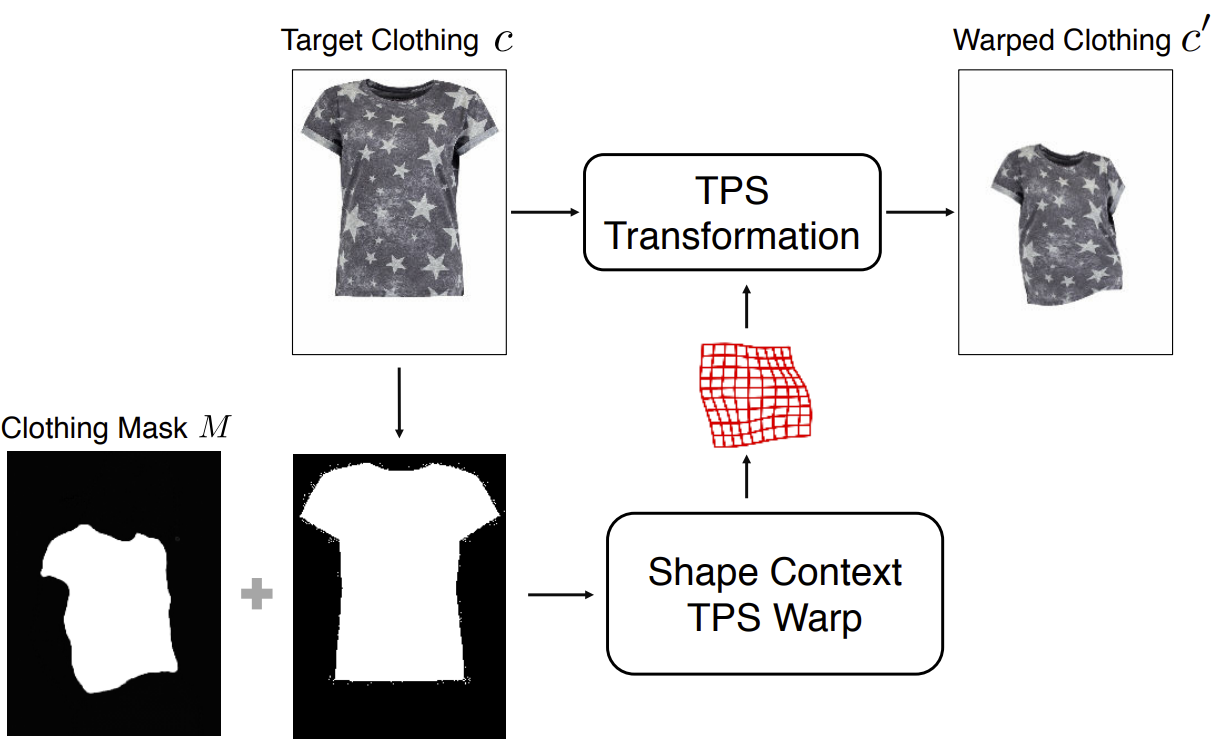
- 옷 이미지 $c$ 의 전경 마스크를 추출합니다.
- 1단계가 예측한 사람 위의 옷 마스크 $M$ 과 전경 마스크의 윤곽에서 점을 샘플링합니다.
- 각 점에 로그-극좌표 히스토그램(형상 문맥)을 붙이고, $\chi^2$ 거리로 비용 행렬을 만들어 이분 매칭으로 대응을 찾습니다.
- 대응점으로부터 TPS 변형을 추정하고, 그 변형을 옷 이미지 $c$ 전체에 적용해 $c’$ 을 얻습니다.
TPS는 굽힘 에너지를 최소화하는 매끄러운 비강체 변형이므로, 마스크 윤곽만 맞추면 내부 텍스처도 함께 자연스럽게 따라갑니다.
⚖️ 2. 왜 학습 기반 왜곡을 쓰지 않았나
논문은 Siamese 네트워크로 TPS 파라미터를 학습하는 대안(Rocco et al.)을 언급하지만, 비강체인 옷에서는 특히 어렵고 경험적으로 형상 문맥 매칭이 더 나은 왜곡을 주었다고 보고합니다. 얼굴 합성에서 쓰이는 2D/3D 키포인트 기반 텍스처 왜곡과 아이디어는 같지만, 옷에는 정확한 키포인트 주석이 없기 때문에 윤곽 기반 매칭을 택한 것입니다. 바로 이 선택이 후속 연구 CP-VTON에서 “느리고(쌍당 약 2초) end-to-end가 아니다”라는 이유로 학습 가능한 GMM으로 대체됩니다.
⏱️ 3. 실행 시간 (Sec. 4.2)
| 구성 요소 | 시간 |
|---|---|
| 사람 파싱 | 159 ms |
| 자세 추정 | 220 ms |
| encoder-decoder | 27 ms |
| TPS(형상 문맥 매칭) | 180 ms (CPU) |
| 정제 네트워크 | 20 ms |
TPS를 제외한 항목은 K40 GPU 기준입니다. 왜곡 단계가 GPU 구현이 없는 유일한 병목입니다.
💡 Key Takeaway VITON의 왜곡은 학습하지 않는 고전 기하 매칭입니다. 주석 없이 바로 쓸 수 있다는 장점과, 느리고 네트워크와 함께 최적화되지 않는다는 단점이 공존하며, 후자가 다음 세대 연구의 출발점이 됩니다.
정제 네트워크와 합성 마스크
정제 네트워크 $G_R$ 은 거친 결과 $I’$ 과 왜곡된 옷 $c’$ 을 받아 어느 픽셀을 어느 소스에서 가져올지를 결정하는 1채널 합성 마스크 $\alpha$ 를 출력합니다. “그리기”가 아니라 “고르기”를 학습한다는 점이 핵심입니다.
🎨 1. 합성 식 (Eq. 2)
\[\hat{I} = \alpha\odot c' + (1-\alpha)\odot I' \tag{2}\]$\alpha\in(0,1)^{m\times n}$ 는 4층 완전 합성곱 네트워크의 출력입니다. 앞 세 층은 $3\times3\times64$ 필터 + Leaky ReLU, 마지막 층은 $1\times1$ 필터 + sigmoid 입니다. 팔이나 머리카락이 옷 앞에 있는 영역에서는 $\alpha\to0$ 으로 거친 결과를, 옷 영역에서는 $\alpha\to1$ 로 왜곡된 옷을 선택해야 합니다.
📐 2. 손실 함수 (Eq. 3–4)
\[L_{perc}(\hat{I}, I) = \sum_{i=3}^{5}\lambda_i\,\|\phi_i(\hat{I}) - \phi_i(I)\|_1 \tag{3}\] \[L_{G_R} = L_{perc}(\hat{I}, I) - \lambda_{warp}\|\alpha\|_1 + \lambda_{TV}\|\nabla\alpha\|_1 \tag{4}\]| 항 | 의미 | 설정 |
|---|---|---|
| $L_{perc}$ | 상위 층(conv3_2, conv4_2, conv5_2)만 쓰는 지각 손실 | 하위 층은 픽셀 수준 정렬에 민감해, 불완전한 왜곡으로 생긴 작은 어긋남에 큰 벌점을 줌. 상위 층만 쓰면 어긋남을 무시하고 옷을 선택하도록 유도 |
| $-\lambda_{warp}|\alpha|_1$ | 음의 L1: $\alpha$ 를 크게 만들어 왜곡된 옷을 더 많이 쓰게 함 | $\lambda_{warp}=0.1$ |
| $\lambda_{TV}|\nabla\alpha|_1$ | 총변동(TV) 정규화: 마스크를 공간적으로 매끄럽게 해 경계 전환을 자연스럽게 | $\lambda_{TV}=5\times10^{-6}$ |
🖼️ 3. 단계별 출력 (Fig. 5)
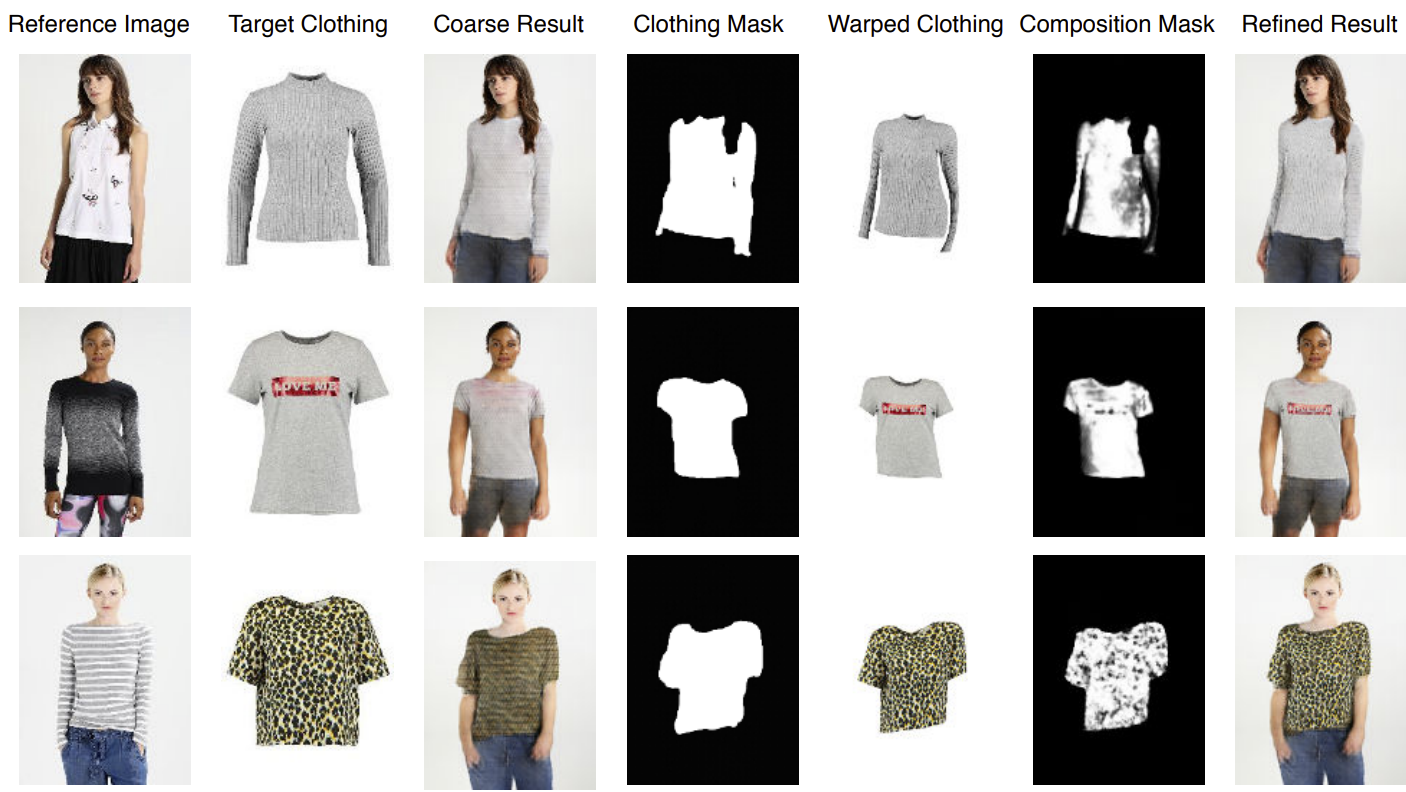
거친 결과에는 자세·체형·얼굴이 보존되지만 그래픽과 텍스처가 없습니다. 옷 마스크로 왜곡한 $c’$ 과 합성 마스크를 거치면 첫 예시의 소재, 둘째의 텍스트, 셋째의 패턴이 옷 이미지에서 사람 위로 그대로 옮겨집니다.
💡 Key Takeaway 정제 단계의 두 설계, 즉 상위 VGG 층만 쓰는 지각 손실과 마스크를 1 쪽으로 미는 음의 L1은 모두 같은 목적을 향합니다. “왜곡이 조금 틀려도 옷을 복사하라.” 이것이 세부 보존의 실질적 메커니즘입니다.
데이터셋, 학습 설정, 비교 기준선
실험 설정은 이후 가상 피팅 연구의 사실상 표준이 되었으므로 세부를 정확히 알아 둘 가치가 있습니다.
📦 1. Zalando 데이터셋 (Sec. 4.1)
| 항목 | 값 |
|---|---|
| 수집 | 정면 여성 모델과 상의 쌍 약 19,000개 크롤링 |
| 정제 | 파싱 결과가 없는 잡음 이미지 제거 → 16,253쌍 |
| 분할 | 학습 14,221 / 테스트 2,032 |
| 테스트 구성 | 2,032 테스트 쌍의 옷을 무작위로 뒤섞어 비쌍(unpaired)으로 평가 |
| 범주 | 상의만. 시각적 그래픽이 다양하고 변형이 크기 때문. 방법 자체는 하의·아우터에도 적용 가능 |
⚙️ 2. 학습 설정 (Sec. 4.2)
| 항목 | 값 |
|---|---|
| 최적화 | Adam, $\beta_1=0.5,\ \beta_2=0.999$, 고정 학습률 0.0002 |
| 학습 길이 | encoder-decoder 15K 스텝, 정제 네트워크 6K 스텝 |
| 배치 | 16 |
| 해상도 | $256\times192$ |
| $\lambda_i$ | 각 항의 크기가 비슷해지도록 스케일 조정(CRN 방식), Eq. 1과 Eq. 4에서 동일 |
🆚 3. 비교 기준선 (Sec. 4.3)
| 기준선 | 설명 |
|---|---|
| PRGAN | 사람 표현을 조건으로 쓰는 GAN(Ma et al., Lassner et al. 계열) |
| CAGAN | 조건부 유사 GAN: 원본 사람 이미지를 직접 입력받아 옷을 교체 |
| CRN | Cascaded Refinement Network, 지각 손실 기반 비적대적 생성 |
| Encoder-Decoder | VITON 1단계만 사용(정제 없음) |
| Non-parametric | 1단계 없이 왜곡된 옷을 사람 이미지에 직접 붙여넣기 |
💡 Key Takeaway “테스트는 비쌍으로, 정답 없이”라는 프로토콜이 여기서 정해졌습니다. 이 때문에 가상 피팅 평가는 참조 기반 지표를 쓸 수 없고, 사용자 평가와 분포 기반 지표에 의존하게 됩니다.
정량·정성 평가 결과
평가는 Inception Score(IS)와 Amazon Mechanical Turk(AMT) 사용자 평가로 이루어지며, 두 지표가 정반대의 순위를 내는 것이 이 논문의 중요한 관찰입니다.
📊 1. Table 1: IS와 사용자 평가

| 방법 | IS | 사용자 선호 |
|---|---|---|
| PRGAN | 2.688 ± 0.098 | 27.3% |
| CAGAN | 2.981 ± 0.087 | 21.8% |
| CRN | 2.449 ± 0.070 | 69.1% |
| Encoder-Decoder | 2.455 ± 0.110 | 58.4% |
| Non-parametric | 3.373 ± 0.142 | 46.4% |
| VITON | 2.514 ± 0.130 | 77.2% |
| 실제 데이터 | 3.312 ± 0.098 | — |
사용자 평가 절차: 작업자에게 사람 이미지, 대상 옷, 그리고 서로 다른 두 방법의 결과($256\times192$)를 보여 주고 더 사실적이고 정확한 쪽을 고르게 합니다. 한 작업은 5회 시행, 제한 시간 200초이며, 수치는 해당 방법이 다른 방법보다 낫다고 선택된 비율입니다(우연 50%).
🔍 2. 세 가지 관찰 (Sec. 4.5)
- IS는 이 과제에 부적합합니다. IS는 적대적 학습이나 직접 붙여넣기로 만든 날카로운 내용을 보상하기 때문에 비모수 기준선이 실제 데이터보다 높은 IS를 받습니다. 또 과제를 모르므로 “옷이 제대로 옮겨졌는가”를 측정하지 못합니다. CRN은 IS가 가장 낮지만 사용자 평가 2위입니다.
- 사람 표현을 쓰는 방법이 선호됩니다. CAGAN과 비모수 기준선은 원본 사람 이미지를 직접 입력받으므로, 긴소매를 입은 사람에게 반소매를 입히는 식의 불일치를 처리하지 못합니다.
- 합성이 각 구성요소보다 낫습니다. VITON(77.2%)은 encoder-decoder 단독(58.4%)과 비모수 붙여넣기(46.4%) 모두를 앞섭니다. 거친 생성과 왜곡된 옷의 결합이 핵심입니다.
🧪 3. 잡음 수준과 실패 사례
- 0.25초 제한 실제/가짜 판별 테스트에서 생성 이미지의 17.18%가 실제로, 실제 이미지의 11.46%가 생성으로 판정되었습니다. 생성 결과가 짧은 시간에는 상당 부분 구분되지 않는다는 뜻입니다.
- 실패 사례(Fig. 8): 드물게 보이는 자세, 그리고 현재 옷과 대상 옷의 형태가 크게 다른 경우(오른팔 영역)에서 결과가 무너집니다.
- 야외 이미지(Fig. 9): COCO에서 사람 영역을 잘라 적용해도 그럴듯한 결과를 내, 제약 없는 환경으로의 확장 가능성을 보였습니다.
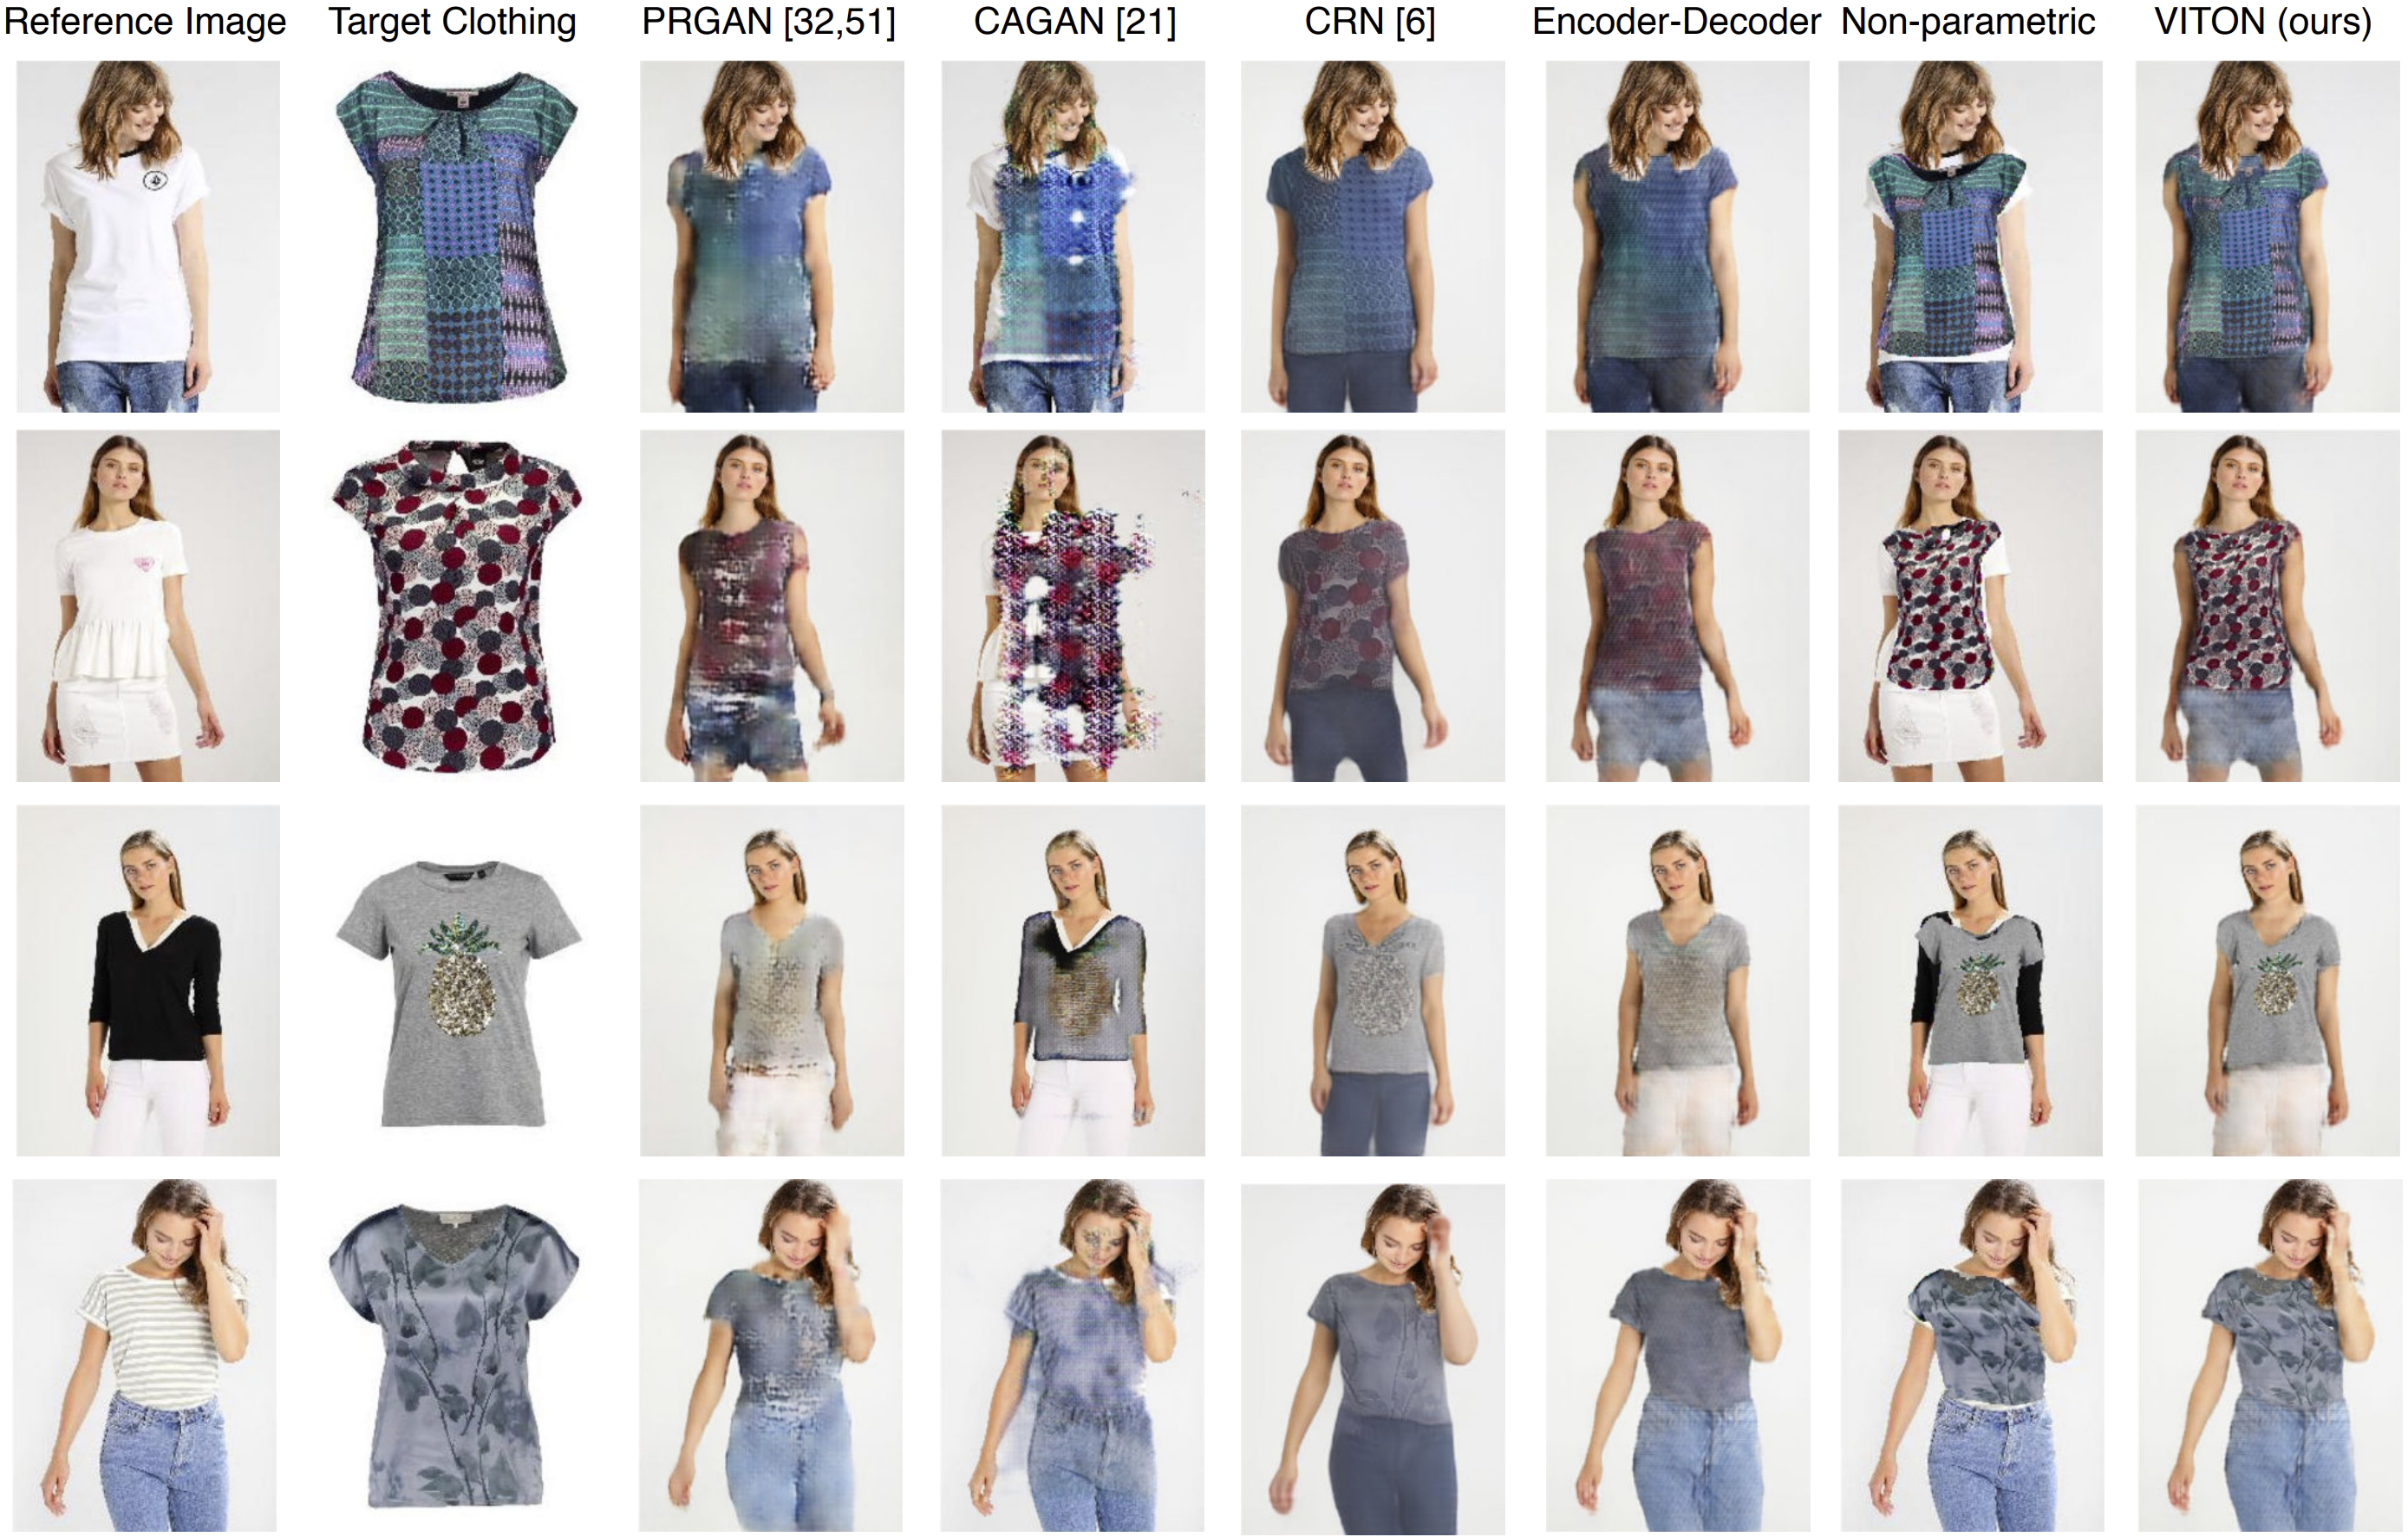
💡 Key Takeaway 이 논문의 가장 오래 남은 메시지 중 하나는 “IS로 가상 피팅을 평가하지 말라” 입니다. 복사-붙여넣기가 실제 사진보다 높은 점수를 받는 지표는 과제의 목표와 무관하며, 이후 연구는 FID·LPIPS·SSIM과 사용자 평가의 조합으로 이동했습니다.
한계와 후속 연구로의 연결
VITON의 한계는 3단계 파이프라인의 각 연결부에서 나옵니다. 이후 연구들은 각 연결부를 학습 가능하게 만들거나 아예 제거하는 방향으로 발전했습니다.
⚠️ 1. 구조적 한계
- 왜곡이 학습되지 않음 : 형상 문맥 매칭은 이진 마스크 윤곽만 보므로 옷 내부 구조(소매선, 목선)를 활용하지 못하고, 1단계 마스크 $M$ 이 틀리면 왜곡도 틀립니다. CPU에서 쌍당 180 ms로 파이프라인의 병목입니다.
- 정제가 정렬 오차에 취약 : 정제 네트워크는 $\alpha$ 만 예측하므로 왜곡 자체를 고치지 못합니다. CP-VTON은 인위적 이동 실험으로 VITON 2단계가 작은 오차에도 빠르게 흐려짐을 보였습니다.
- 원래 옷의 잔상 : 체형을 흐려도 큰 형태 차이(긴소매 ↔ 민소매)는 지워지지 않습니다.
- 범주·해상도 제한 : 상의, $256\times192$, 정면 자세로 한정됩니다.
- 평가의 주관성 : 사용자 선호 비율만으로는 옷 보존 정도를 수치화할 수 없습니다.
🚀 2. 후속 연구 계보
| 연결부 | 후속 접근 |
|---|---|
| 형상 문맥 TPS → 학습 가능한 왜곡 | CP-VTON의 GMM(TPS 파라미터 회귀), 이후 ClothFlow·PF-AFN의 외형 흐름 |
| 마스크 합성의 흐려짐 | CP-VTON의 마스크 L1 정규화, VITON-GAN의 적대적 손실 |
| 레이아웃 충돌·잔상 | ACGPN, VITON-HD: 대상 옷에 맞는 분할 맵을 먼저 생성 |
| 쌍 데이터 필요 | PASTA-GAN 계열의 비쌍 사람-사람 전이 |
| 생성 품질 자체 | 확산 모델 기반 피팅(LaDI-VTON, TryOnDiffusion 등) |
🧭 3. 남는 질문
- 자기 지도 재구성 학습은 “같은 옷을 다시 입히는” 과제이므로, 실제 추론(다른 옷)과 학습 사이에 분포 차이가 있습니다. 논문은 이를 사람 표현으로 완화하지만 근본적으로 해결하지는 않습니다.
- 지각 손실의 층 선택($i\geq3$)은 경험적입니다. 어느 정도의 어긋남까지 허용할지가 층 선택 하나에 달려 있어 데이터셋이 바뀌면 재조정이 필요합니다.
💡 Key Takeaway VITON은 “옷을 지우고(표현), 거칠게 그리고(생성), 세부는 복사한다(왜곡+마스크)”는 가상 피팅의 기본 문법을 세웠습니다. 이후 연구의 대부분은 이 문법의 각 단계를 더 강력한 학습 모듈로 바꾸는 과정으로 읽을 수 있습니다.