 You know maize mean?
Toward Characteristic-Preserving Image-based Virtual Try-On Network
0. Summary
기본 정보 : ArXiv,2018.07.20 (ECCV 2018), Toward Characteristic-Preserving Image-based Virtual Try-On Network
연구 배경
이미지 기반 가상 피팅(image-based virtual try-on)은 3D 정보 없이 사람 사진과 상점 의류 사진만으로 “그 옷을 입은 사람”을 합성하는 문제다. 좋은 시스템은 두 가지를 동시에 만족해야 한다. 옷이 사람의 자세와 체형에 맞게 자연스럽게 변형되어야 하고, 동시에 옷의 텍스처·로고·자수 같은 고유 특성(characteristic)이 보존되어야 한다. 그런데 사람과 옷 사이에는 큰 공간적 불일치(spatial misalignment)가 있어서, 단순한 이미지 조건부 생성 모델(encoder-decoder, cGAN 등)은 옷의 세부를 뭉개 버린다. 선행 연구 VITON은 형상 문맥(shape context) 매칭으로 추정한 TPS 변형으로 옷을 먼저 왜곡한 뒤 합성하는 coarse-to-fine 전략을 썼지만, 손으로 설계한 매칭은 느리고 부정확하며 특히 정제 단계에서 옷의 세부가 손실되는 문제가 남아 있었다.
제안 방법
논문은 완전히 학습 가능한(fully learnable) 2단계 네트워크 CP-VTON(Characteristic-Preserving Virtual Try-On Network)을 제안한다. 첫 번째 모듈인 기하 정합 모듈(Geometric Matching Module, GMM) 은 사람 표현 $p$ 와 상점 의류 $c$ 를 각각 인코딩하고 상관(correlation) 층으로 결합한 뒤, 회귀 네트워크로 TPS 변형 파라미터 $\theta$ 를 직접 예측해 옷을 사람 몸에 맞게 왜곡한다. 관심점 매칭 대신 픽셀 단위 L1 손실만으로 끝까지 학습된다. 두 번째 모듈인 트라이온 모듈(Try-On Module, TOM) 은 왜곡된 옷 $\hat{c}$ 와 $p$ 를 받아 렌더링된 사람 $I_r$ 과 합성 마스크(composition mask) $M$ 을 함께 출력하고, $I_o = M\odot\hat{c} + (1-M)\odot I_r$ 로 두 소스를 융합한다. 마스크에 $|1-M|_1$ 정규화를 두어 가능한 한 왜곡된 옷의 픽셀을 그대로 쓰도록 유도하는 것이 세부 보존의 핵심이다.
발견 사실
VITON과 같은 데이터셋(16,253쌍, 학습 14,221 / 테스트 2,032)에서 수행한 쌍별 사용자 평가에서, 변형이 큰 LARGE 그룹에서는 CP-VTON이 VITON보다 67.5%의 비율로 선호되었고, 합성 마스크를 제거한 변형과 비교하면 72.5%, 마스크 L1 정규화를 제거한 변형과 비교하면 84.5%로 선호되어 두 구성요소가 모두 필요함을 보였다. 변형이 작은 SMALL 그룹에서는 차이가 작거나 역전되어(55.0%, 42%, 38.5%), 제안 방법의 이득이 큰 변형·정렬 오차 상황에서 집중적으로 나타남을 확인했다. GMM은 형상 문맥 매칭(SCMM)과 비슷한 왜곡 품질을 내면서 GPU에서 쌍당 0.06초로 CPU 기반 SCMM(2.01초)보다 훨씬 빠르다. 인위적으로 옷을 $N\in{0,5,10,15,20}$ 픽셀 이동시키는 실험에서 VITON 2단계와 마스크 없는 변형은 급격히 흐려지는 반면 CP-VTON은 완만하게만 열화되었다. 또한 저자들은 Inception Score가 이 과제에 부적합하다고 판단해 보고하지 않았다.
핵심 기여
- 학습 가능한 기하 정합 모듈(GMM) : 손으로 설계한 형상 문맥 매칭 대신 TPS 파라미터를 직접 회귀하는 네트워크를 도입해, 옷을 대상 체형에 맞추는 왜곡을 end-to-end로 학습하면서 속도를 수십 배 높였다(Sec. 3.2, Table 1).
- 합성 마스크 기반 트라이온 모듈(TOM) : 렌더링 결과와 왜곡된 옷을 학습된 마스크로 융합하고 마스크에 L1 정규화를 걸어, 경계 아티팩트를 줄이면서 로고·텍스처 같은 옷의 고유 특성을 최대한 보존한다(Sec. 3.3, Eq. 2–3).
- 정렬 오차에 대한 강건성 분석 : 마스크 유무, L1 정규화 유무, 인위적 이동량에 따른 ablation으로 “U-Net 단독으로는 작은 정렬 오차조차 처리하지 못한다”는 사실을 실증하고, 특성 보존형 설계가 필요한 이유를 명확히 했다(Sec. 4.6).
관련 개념
의류 무관 사람 표현(Clothing-agnostic Person Representation)
사람 표현(person representation) $p$ 는 원래 입고 있던 옷의 정보는 지우되, 자세·체형·정체성처럼 피팅 결과에 그대로 유지되어야 할 정보만 남긴 입력 텐서입니다. VITON에서 처음 제안된 구성을 CP-VTON도 그대로 따릅니다. 이 표현이 “옷에 무관(clothing-agnostic)”해야 하는 이유는, 학습 시 정답이 “같은 사람이 같은 옷을 입은 사진” 하나뿐이어서 원래 옷 정보가 새어 들어가면 네트워크가 그냥 입력을 복사하는 지름길을 배우기 때문입니다.
🧍 1. 구성 요소와 채널 수 (Sec. 3.1)
| 구성 요소 | 채널 | 내용 |
|---|---|---|
| 자세 히트맵(pose heatmap) | 18 | 관절 키포인트마다 1채널, 각 키포인트 주변 $11\times 11$ 흰 사각형으로 표시 |
| 체형(body shape) | 1 | 사람 영역의 이진 마스크를 흐리게(blurred) 처리한 1채널 |
| 보존 영역(reserved regions) | 3 | 얼굴과 머리카락 영역의 RGB |
총 $k=22$ 채널, 해상도 $256\times 192$ 입니다. 체형 마스크를 일부러 흐리게 만드는 이유는 원래 옷의 윤곽(예: 긴소매)이 그대로 드러나 새 옷(예: 반소매)과 충돌하는 것을 막기 위해서입니다.
🔍 2. VITON과의 차이점
CP-VTON은 사람 표현 자체를 바꾸지 않고, 그 표현을 어떻게 쓰는지를 바꿉니다. VITON은 $p$ 와 $c$ 를 단순히 채널 방향으로 이어 붙여 U-Net에 넣었는데, 둘 사이의 공간적 불일치가 크면 합성곱 네트워크는 대응 관계를 잘 잡지 못합니다. CP-VTON은 $p$ 와 $c$ 를 별도의 인코더로 추출한 뒤 상관 연산으로 결합함으로써 공간 불일치를 명시적으로 모델링합니다.
💡 Key Takeaway 사람 표현은 “무엇을 바꾸고 무엇을 지킬 것인가”를 입력 단계에서 못 박는 장치입니다. CP-VTON은 이 표현을 그대로 쓰되, 옷과의 공간적 대응을 네트워크가 직접 추론하도록 구조를 바꿨습니다.
기하 정합 모듈(Geometric Matching Module, GMM)
GMM 은 상점 의류 $c$ 를 사람 표현 $p$ 가 암시하는 체형과 자세에 맞게 왜곡하는 모듈입니다. Rocco 등의 CNN 기반 기하 매칭(CNNGeometric) 구조에서 영감을 받았지만, 두 입력이 서로 다른 모달리티(사람 표현 vs 옷 이미지)라는 점, 그리고 지도 신호가 “사람이 실제로 입고 있는 옷 영역” $c_t$ 라는 점이 다릅니다.
🧩 1. 네 단계 구조 (Fig. 2, Sec. 3.2)
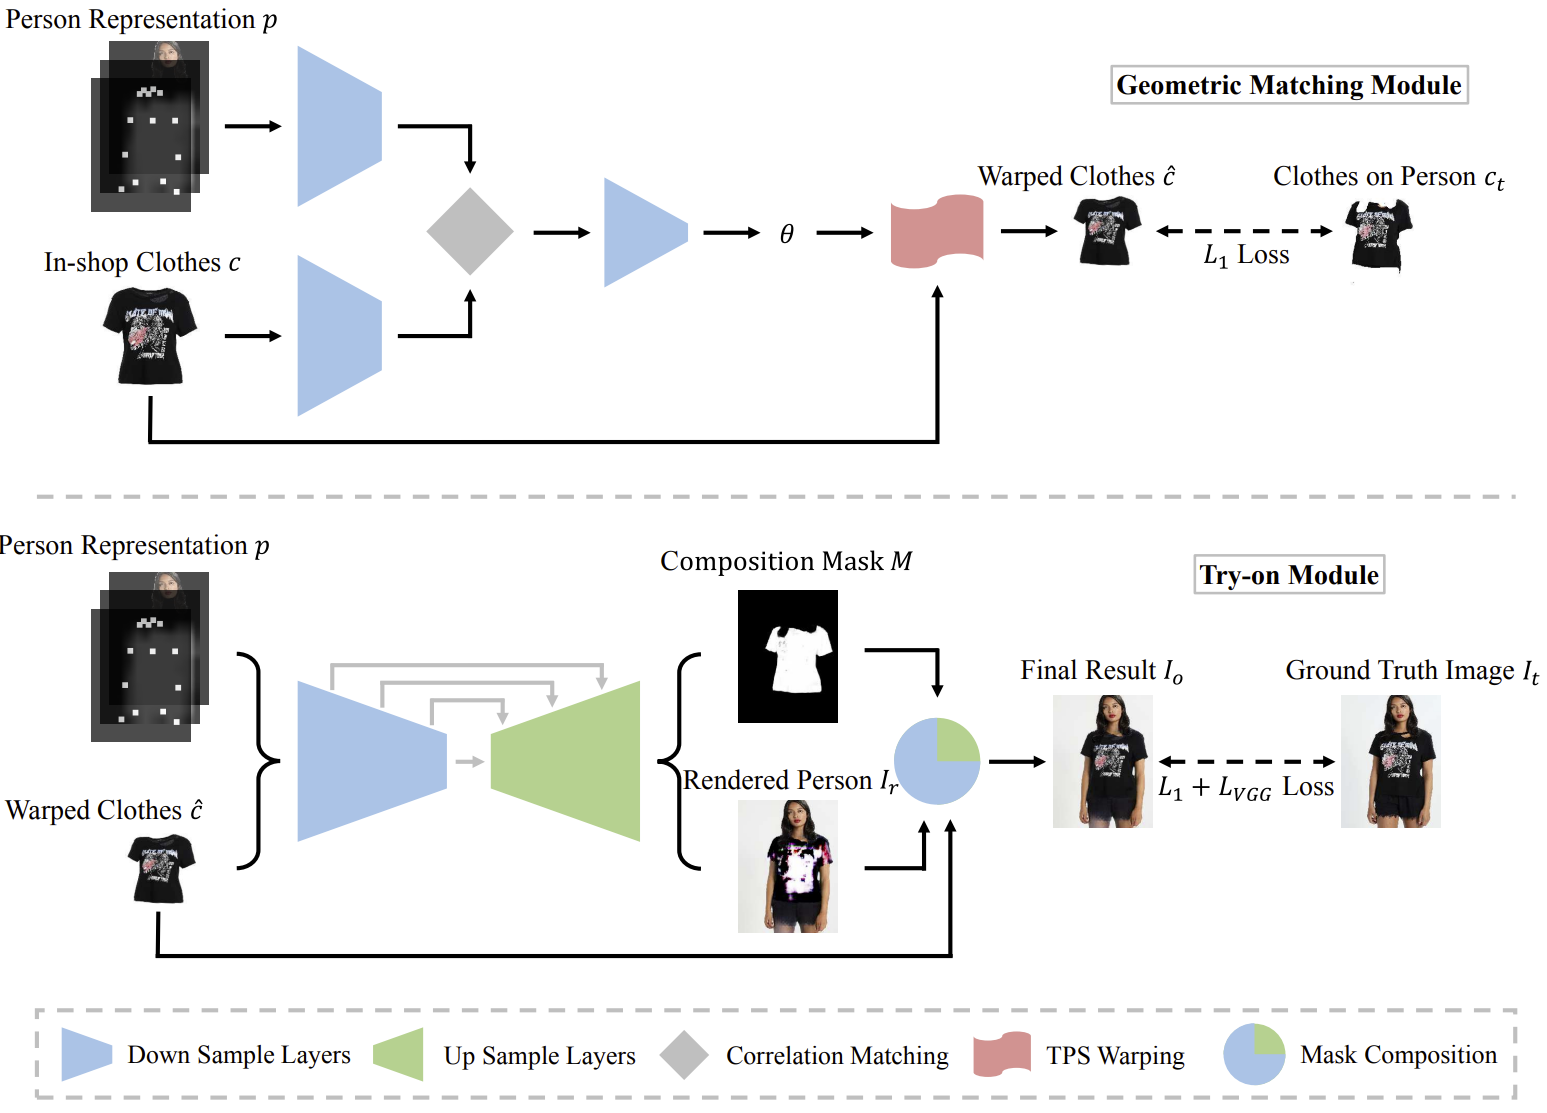
| 단계 | 내용 |
|---|---|
| 특징 추출 | $p$ 와 $c$ 를 각각 별도 네트워크로 인코딩. 두 네트워크는 입력 채널만 다르고 구조는 같음: stride-2 합성곱 4개 + stride-1 합성곱 2개, 필터 수 64, 128, 256, 512, 512 |
| 상관 층(correlation layer) | 두 특징 맵을 하나의 텐서로 결합해 모든 위치 쌍의 유사도를 계산 |
| 회귀 네트워크 | stride-2 합성곱 2개, stride-1 합성곱 2개(512, 256, 128, 64 필터) + 완전연결층. 출력은 TPS 앵커 점의 $x,y$ 오프셋 $2\times 5\times 5 = 50$ 개 |
| TPS 변형 | 예측된 $\theta$ 로 $\hat{c} = T_\theta(c)$ 계산 |
여기서 $5\times 5$ 격자의 제어점 25개가 TPS 변형의 자유도를 결정합니다. 격자를 더 촘촘히 하면 더 복잡한 비강체 변형이 가능하지만 학습이 불안정해지고, 너무 성기면 소매 같은 국소 변형을 놓칩니다.
📐 2. 손실 함수와 지도 신호
GMM의 학습 목표는 왜곡된 옷 $\hat{c}$ 가 사람 이미지 $I_t$ 에서 파싱으로 잘라낸 실제 착용 옷 영역 $c_t$ 와 픽셀 단위로 일치하는 것입니다.
\[L_{GMM}(\theta) = \|\hat{c} - c_t\|_1 = \|T_\theta(c) - c_t\|_1 \tag{1}\]- 관심점 대응이나 TPS 파라미터 정답이 전혀 필요 없습니다. 쌍 데이터(상점 옷, 그 옷을 입은 사람)만 있으면 되고, 그라디언트는 TPS 샘플링 격자를 통과해 회귀 네트워크까지 역전파됩니다.
- 특징 추출기는 ImageNet 사전학습 VGG가 아니라 처음부터(from scratch) 학습됩니다. 사람 표현은 자연 이미지가 아니기 때문입니다.
⚡ 3. 형상 문맥 매칭(SCMM)과의 비교 (Sec. 4.4, Fig. 5)
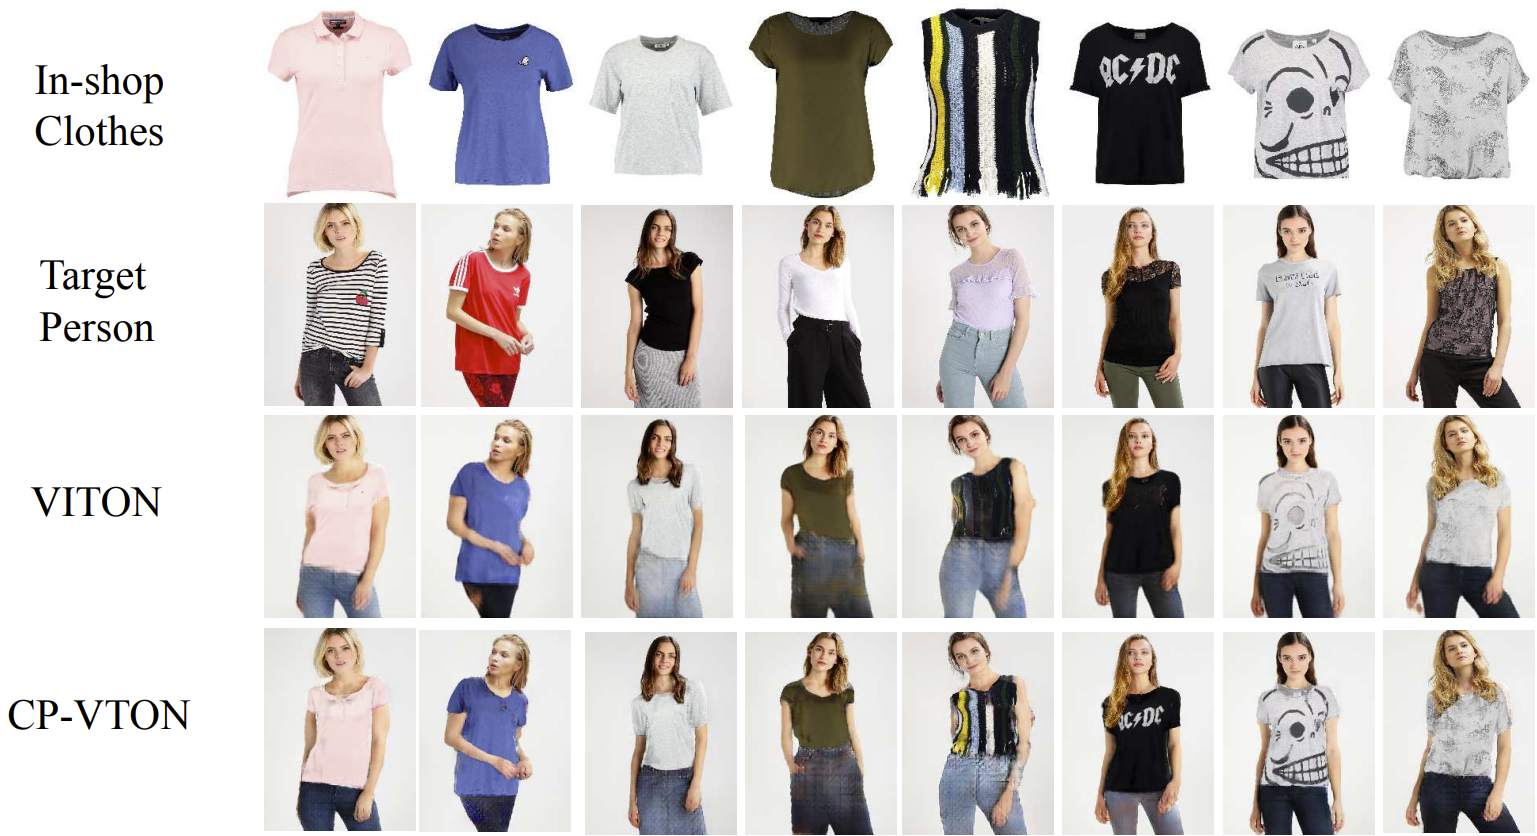
| 항목 | SCMM (VITON) | GMM (CP-VTON) |
|---|---|---|
| 대응 추정 | 형상 문맥 기술자 + 이분 매칭(손 설계) | 학습된 특징 + 상관 층 |
| 입력 | 옷 마스크와 예측된 옷 마스크(이진) | 사람 표현과 옷 이미지(RGB 포함) |
| 속도 | CPU 2.01 s / 쌍 | GPU 0.06 s, CPU 0.52 s / 쌍 |
| 사용자 평가(더 사실적) | — | LARGE 49.5%, SMALL 42.0% |
사용자 평가에서 GMM은 SCMM과 대등한 수준(50% 근처)이며, 왜곡 품질은 비슷하되 수십 배 빠르고 end-to-end로 학습 가능하다는 것이 핵심 이득입니다. 특히 이진 마스크만 보는 SCMM은 옷 내부 구조를 모르지만, GMM은 RGB 옷 이미지를 보기 때문에 소매·목선 같은 내부 구조를 활용할 수 있습니다.
💡 Key Takeaway GMM은 “옷을 어떻게 구부릴 것인가”를 픽셀 L1 손실 하나로 학습합니다. 대응점 정답 없이도 TPS 파라미터를 회귀할 수 있다는 점이 이후 가상 피팅 연구(CP-VTON+, ACGPN, PF-AFN 등)의 왜곡 모듈 설계에 기본 틀이 되었습니다.
박판 스플라인 변형(Thin-Plate Spline, TPS)
TPS 는 2차원 평면에서 제어점 집합을 목표 위치로 옮기면서 그 사이를 가장 “덜 구부러지게” 보간하는 비강체 변형입니다. 3차 스플라인의 2차원 일반화이며, 가상 피팅에서는 옷 이미지를 체형에 맞게 부드럽게 늘리고 휘는 데 쓰입니다.
🧮 1. 수학적 형태
TPS 사상 $f:\mathbb{R}^2\to\mathbb{R}$ 는 굽힘 에너지(bending energy)
\[I_f = \iint_{\mathbb{R}^2}\left[\left(\frac{\partial^2 f}{\partial x^2}\right)^2 + 2\left(\frac{\partial^2 f}{\partial x\partial y}\right)^2 + \left(\frac{\partial^2 f}{\partial y^2}\right)^2\right]dx\,dy\]를 최소화하며, 그 해는 아핀 항과 방사 기저 항의 합으로 닫힌 형태를 가집니다.
\[f(x,y) = a_1 + a_x x + a_y y + \sum_{i=1}^{n} w_i\,U\big(\|(x_i,y_i)-(x,y)\|\big),\qquad U(r)=r^2\log r^2\]$x$ 좌표와 $y$ 좌표 각각에 대해 하나씩, 총 두 개의 $f$ 가 2D 변형을 이룹니다. CP-VTON에서는 $n=25$ 개 제어점이 $5\times 5$ 정규 격자에 놓여 있고, 회귀 네트워크가 각 제어점의 이동량 50개를 출력하면 위 선형계를 풀어 변형 격자를 얻은 뒤 미분 가능한 샘플링으로 $\hat{c}$ 를 만듭니다.
🔁 2. 왜 아핀이 아니라 TPS인가
| 변형 모델 | 자유도 | 표현 가능한 변형 |
|---|---|---|
| 아핀(affine) | 6 | 평행이동·회전·스케일·전단. 전역 변형만 가능 |
| TPS (5×5) | 50 (+ 아핀 6) | 국소적 늘림·휨 포함 비강체 변형 |
옷은 팔을 들거나 몸을 비트는 자세에 따라 국소적으로 다르게 변형되므로 아핀으로는 부족합니다. 반면 TPS는 제어점 사이를 최소 굽힘으로 보간하므로 격자가 찢어지거나 접히는 극단적 변형은 억제됩니다. 다만 바로 이 매끄러움 때문에 위상(topology)이 바뀌는 변형(예: 반소매 → 긴소매, 팔이 옷 앞을 가리는 폐색)은 표현할 수 없습니다. 이는 논문이 밝힌 실패 사례의 근본 원인이기도 합니다.
💡 Key Takeaway TPS는 “적은 파라미터로 부드러운 비강체 변형”을 주는 이상적 선택이지만, 매끄러움이 곧 한계입니다. 가려짐이나 위상 변화가 있는 경우는 변형이 아니라 생성으로 채워야 하며, 그 역할을 TOM이 맡습니다.
트라이온 모듈(Try-On Module, TOM)과 합성 마스크
TOM 은 왜곡된 옷 $\hat{c}$ 와 사람 표현 $p$ 를 받아 최종 결과를 만드는 모듈입니다. 핵심 설계는 네트워크가 사람 전체를 직접 그리게 하지 않고, “어디는 옷 픽셀을 그대로 쓰고 어디는 새로 그릴지”를 마스크로 결정하게 하는 것입니다.
🎨 1. 두 출력과 합성 식 (Sec. 3.3, Fig. 2 하단)
12층 U-Net이 $p$ 와 $\hat{c}$ 의 연결을 입력으로 받아 4채널을 출력합니다. 앞 3채널은 렌더링된 사람 $I_r$, 마지막 1채널은 합성 마스크 $M\in[0,1]$ 입니다.
\[I_o = M\odot\hat{c} + (1-M)\odot I_r \tag{2}\]| 영역 | 마스크가 하는 일 |
|---|---|
| 옷이 잘 정렬된 몸통·소매 | $M\to 1$: 왜곡된 옷 픽셀을 그대로 복사해 텍스처·로고 보존 |
| 팔·머리카락이 옷을 가리는 영역 | $M\to 0$: 렌더링 결과로 채워 폐색 처리 |
| 경계 | 중간값으로 부드럽게 블렌딩해 이음새 아티팩트 완화 |
⚖️ 2. 손실 함수
\[L_{TOM} = \lambda_{L1}\|I_o - I_t\|_1 + \lambda_{vgg}\,L_{VGG}(I_o, I_t) + \lambda_{mask}\|1-M\|_1 \tag{3}\] \[L_{VGG}(I_o,I_t) = \sum_{i=1}^{5}\lambda_i\,\|\phi_i(I_o) - \phi_i(I_t)\|_1\]- $\phi_i$ 는 ImageNet 사전학습 VGG19의 conv1_2, conv2_2, conv3_2, conv4_2, conv5_2 특징 맵입니다. 픽셀 L1만 쓰면 흐려지므로 지각 손실(perceptual loss)을 함께 씁니다.
- $\lambda_{L1}=\lambda_{vgg}=\lambda_{mask}=1$ 입니다.
- 마스크 정규화 $|1-M|_1$ 이 특성 보존의 핵심입니다. 이 항은 마스크를 1 쪽으로, 즉 “가능하면 왜곡된 옷을 그대로 써라”로 편향시킵니다. 이것이 없으면 네트워크는 두 소스를 평균 내는 쉬운 해(흐릿한 결과)로 수렴합니다.
🏗️ 3. 네트워크 세부와 학습 설정 (Sec. 4.3)
| 항목 | 설정 |
|---|---|
| TOM U-Net | 다운샘플 stride-2 합성곱 6개(64, 128, 256, 512, 512, 512) + 업샘플 6개(512, 512, 256, 128, 64, 4) |
| 업샘플 방식 | 전치 합성곱 대신 최근접 보간 + stride-1 합성곱 (체커보드 아티팩트 억제) |
| 정규화·활성화 | 각 합성곱 뒤 Instance Normalization + Leaky ReLU(기울기 0.2) |
| 최적화 | Adam, $\beta_1=0.5,\ \beta_2=0.999$, 학습률 $10^{-4}$ (100K 스텝 고정 후 선형 감소), 배치 4 |
| 학습 길이 | GMM, TOM 각각 200K 스텝 |
GMM을 먼저 학습한 뒤 그 출력 $\hat{c}$ 를 고정해 TOM을 학습하는 2단계 방식입니다.
💡 Key Takeaway TOM의 본질은 “그리기”가 아니라 “고르기“입니다. 네트워크가 잘 못 그리는 고주파 텍스처는 왜곡된 옷에서 복사하고, 변형으로는 불가능한 폐색만 생성으로 메웁니다. 마스크 정규화 항이 이 분업을 강제합니다.
데이터셋과 평가 프로토콜
평가는 VITON이 수집한 Zalando 계열 데이터셋을 그대로 사용하며, 자동 지표 대신 쌍별 사용자 평가(pairwise user study) 를 주 지표로 삼습니다.
📦 1. 데이터셋 (Sec. 4.1)
| 항목 | 값 |
|---|---|
| 원천 | 정면 여성 모델 + 상의 쌍 약 19,000개 (Han et al., VITON) |
| 정제 후 | 16,253쌍 (파싱 결과 없는 잡음 이미지 제거) |
| 분할 | 학습 14,221 / 검증 2,032 |
| 테스트 | 검증 쌍의 옷을 뒤섞어 비쌍(unpaired) 조합으로 재구성 |
| 해상도 | $256\times 192$ |
테스트를 비쌍으로 만드는 이유는 실제 사용 시나리오(지금 입은 옷과 다른 옷을 입혀 보기)를 반영하기 위해서이며, 이 때문에 정답 이미지가 없어 SSIM 같은 참조 기반 지표를 쓸 수 없습니다.
📊 2. 왜 Inception Score를 쓰지 않았나 (Sec. 4.2)
VITON 논문은 IS를 보고하면서도 “비모수적(non-parametric) 복사-붙여넣기 기준선이 실제 데이터보다 높은 IS를 받는다”는 모순을 지적했습니다. CP-VTON은 한 발 더 나아가 IS를 아예 보고하지 않고, 대신 두 종류의 사용자 평가를 설계했습니다.
| 평가 | 질문 |
|---|---|
| 왜곡 비교 | 두 왜곡된 옷 중 어느 것이 더 사실적인가 (GMM vs SCMM) |
| 피팅 비교 | 두 피팅 결과 중 어느 것이 더 사실적이고 정확한가 (CP-VTON vs 기준선) |
테스트 쌍은 원래 옷과 대상 옷 사이의 형태 차이에 따라 LARGE(큰 변형 필요)와 SMALL(작은 변형)로 나누어 별도로 집계합니다. 이 분할 덕분에 제안 방법의 이득이 어떤 상황에서 나오는지 읽을 수 있습니다.
💡 Key Takeaway 비쌍 테스트와 사용자 평가는 가상 피팅 평가의 어려움을 그대로 드러냅니다. 정답이 없으므로 사람이 보기에 그럴듯하고 옷이 보존되었는가가 유일한 기준이며, 변형 크기별 분할이 분석의 해상도를 높입니다.
실험 결과와 ablation
실험은 (1) VITON과의 직접 비교, (2) 합성 마스크·L1 정규화를 제거한 ablation, (3) 인위적 정렬 오차에 대한 강건성 테스트, (4) 실패 사례 분석으로 구성됩니다.
🏆 1. 쌍별 사용자 평가 (Table 1)
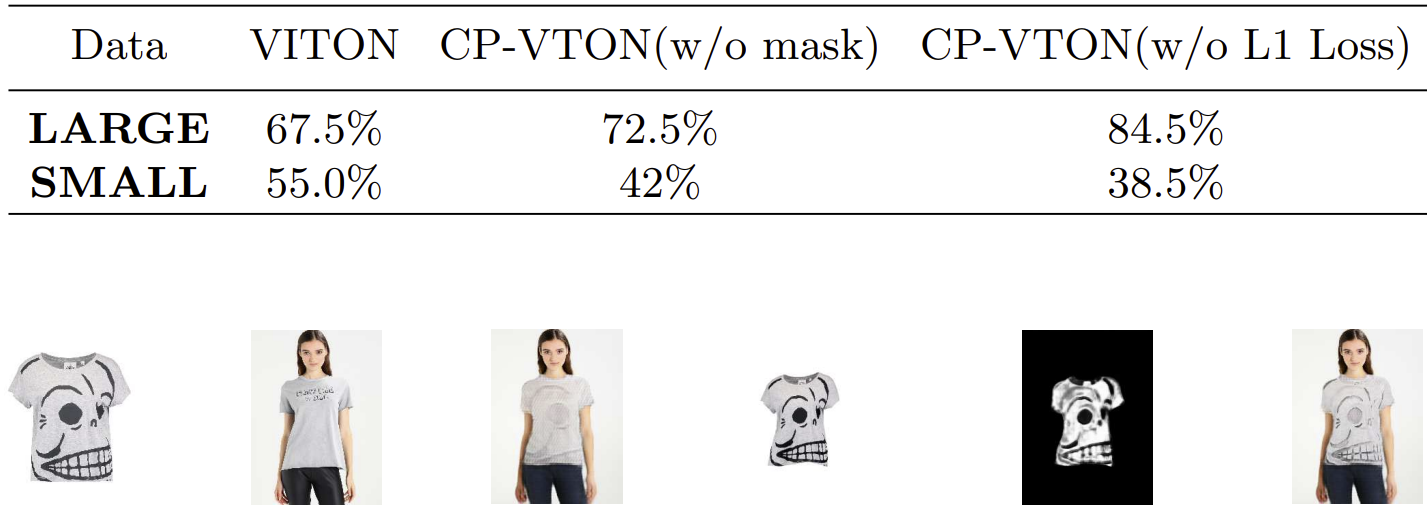
표의 각 칸은 “CP-VTON이 해당 기준선보다 더 낫다고 선택된 비율”이며, 우연 수준은 50%입니다.
| 테스트 그룹 | vs VITON | vs CP-VTON (w/o mask) | vs CP-VTON (w/o L1 Loss) |
|---|---|---|---|
| LARGE | 67.5% | 72.5% | 84.5% |
| SMALL | 55.0% | 42% | 38.5% |
읽는 법은 다음과 같습니다.
- LARGE 에서 CP-VTON은 VITON과 두 ablation 모두를 크게 앞섭니다. 특히 마스크 L1 정규화를 뺀 변형 대비 84.5%는, 변형이 클수록 “옷을 그대로 복사하라”는 편향이 결정적임을 뜻합니다.
- SMALL 에서는 ablation 변형이 오히려 선호됩니다(42%, 38.5%). 변형이 거의 없으면 U-Net 렌더링만으로도 충분히 선명하고, 마스크 합성은 경계 이음새를 만들 위험만 더하기 때문입니다. 저자들은 이를 솔직히 보고하며, 제안 방법의 이득이 어려운 사례에 집중된다고 해석합니다.
🧪 2. Ablation: 마스크와 정규화의 역할 (Sec. 4.6, Fig. 7–8)
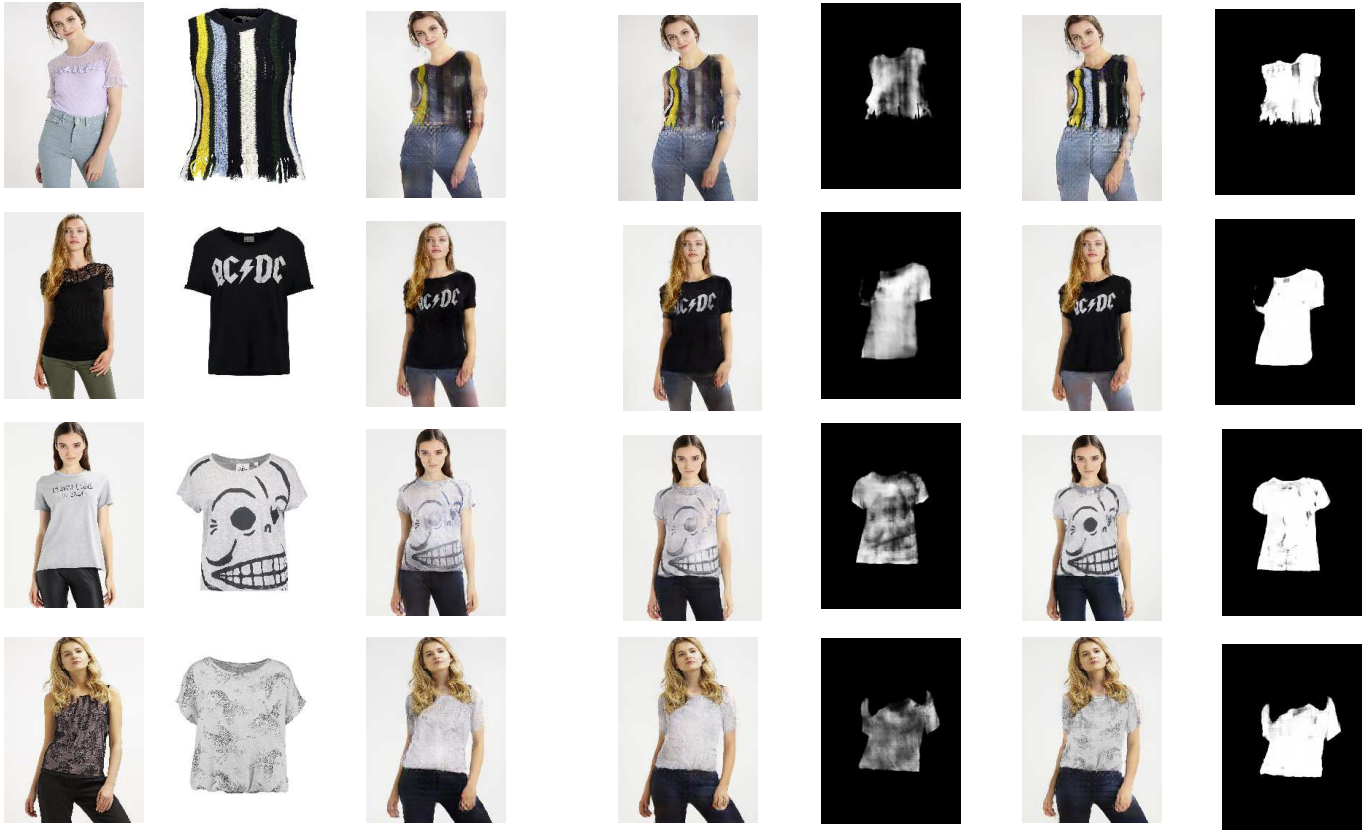
| 변형 | 관찰 |
|---|---|
| w/o mask (U-Net이 직접 전체를 렌더링) | 결과가 흐릿하고 옷의 세부가 사라짐. U-Net 단독으로는 사소한 정렬 오차도 흡수하지 못함 |
| w/o L1 mask regularization | 마스크가 렌더링 쪽($M\to 0$)으로 치우쳐 역시 흐릿해짐 |
| full CP-VTON | 텍스처·로고가 왜곡된 옷에서 그대로 전달됨 |
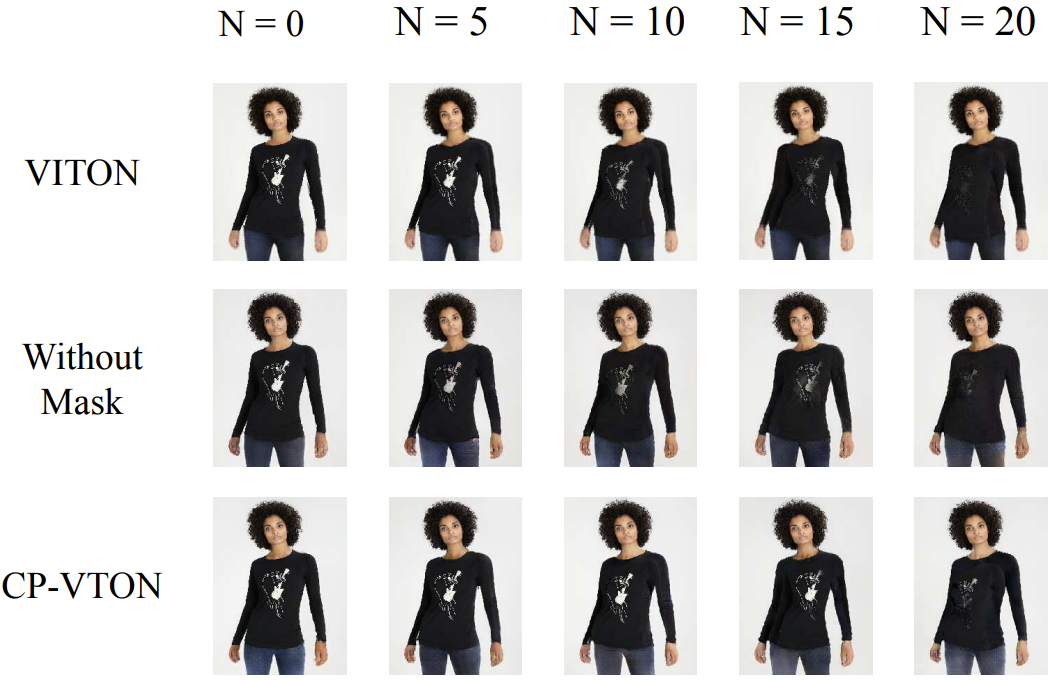
정렬 오차 강건성 실험에서는 왜곡된 옷을 $N=0,5,10,15,20$ 픽셀만큼 무작위로 이동시킨 뒤 결과를 비교합니다. VITON의 2단계와 CP-VTON(w/o mask)은 이동량이 커질수록 빠르게 흐려지지만, CP-VTON은 완만하게만 열화되며 세부를 유지합니다. 즉 합성 마스크는 GMM의 왜곡이 완벽하지 않아도 결과를 지켜 주는 안전장치 역할을 합니다.
⚠️ 3. 실패 사례 (Fig. 9)
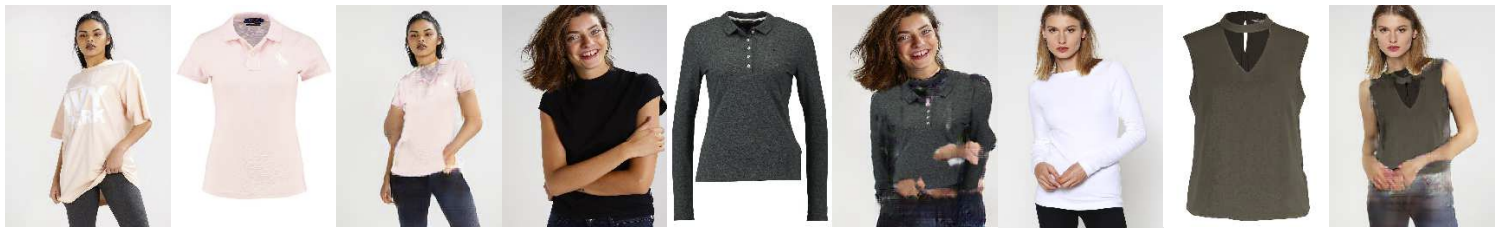
- 원래 옷의 형태가 완전히 지워지지 않음 : 체형 마스크를 흐리게 해도 긴소매의 흔적이 남아 새 옷과 충돌합니다.
- 드문 자세 : 학습 데이터에 거의 없는 자세에서는 GMM의 TPS 추정이 실패합니다.
- 옷의 안팎 구분 : 뒤집힌 옷깃처럼 안감과 겉감을 구분해야 하는 경우를 처리하지 못합니다.
💡 Key Takeaway 수치로 드러난 교훈은 명확합니다. 정렬 오차가 큰 상황일수록 “복사”가 “생성”을 이긴다. 그러나 작은 변형에서는 오히려 단순 렌더링이 낫고, 위상 변화와 원래 옷의 잔상은 TPS + 마스크 설계로는 풀리지 않습니다.
한계와 후속 연구로의 연결
CP-VTON의 한계는 대부분 “2단계 파이프라인의 각 단계가 독립적으로 완벽하다고 가정한다”는 데서 나옵니다. 이후 연구는 이 가정을 하나씩 허물며 발전했습니다.
🔗 1. 설계상 한계
- TPS의 표현력 : 25개 제어점의 매끄러운 변형은 팔꿈치 접힘이나 옷의 주름 같은 국소 변형을 놓치고, 위상 변화는 원리적으로 불가능합니다.
- 파싱·자세 추정 의존 : 사람 표현이 외부 파서와 자세 추정기에 의존하므로 그 오류가 그대로 전파됩니다. 체형 마스크에 남은 원래 옷의 흔적이 대표적입니다.
- 폐색 처리 : 팔이 몸 앞을 가리는 경우 마스크가 렌더링을 선택해야 하는데, U-Net의 생성 품질이 낮으면 팔이 뭉개집니다.
- 2단계 학습 : GMM과 TOM이 따로 학습되므로 TOM은 GMM의 오류를 교정할 수 없고, 반대로 GMM은 TOM이 무엇을 필요로 하는지 모릅니다.
🚀 2. 후속 연구가 바꾼 것
| 한계 | 후속 접근 |
|---|---|
| 폐색·팔 생성 품질 | VITON-GAN: TOM에 적대적 손실을 추가해 팔·손 생성 개선 |
| 원래 옷 잔상, 레이아웃 충돌 | ACGPN 등: 대상 의복에 맞는 의미 분할 맵을 먼저 생성한 뒤 그에 맞춰 합성 |
| TPS의 제한된 자유도 | ClothFlow, PF-AFN: 픽셀 단위 외형 흐름(appearance flow) 으로 TPS 대체 |
| 쌍 데이터 필요 | PASTA-GAN 계열: 사람-사람 간 비쌍 전이로 상점 옷 이미지 없이 학습 |
| 해상도·사실성 | VITON-HD, HR-VITON: $1024\times 768$ 고해상도와 정렬 오차 인지 정규화 |
🧭 3. 남는 질문
- 사용자 평가는 쌍별 선호만 보고하므로 절대적 품질이나 옷 보존 정도를 수치로 비교하기 어렵습니다. 이후 연구는 FID, LPIPS, SSIM(쌍 설정)을 함께 보고하는 방향으로 갔습니다.
- SMALL 그룹에서 ablation 변형이 더 선호된 현상은, 변형 크기에 따라 합성 전략을 적응적으로 바꾸는 설계가 필요함을 시사하지만 논문은 이를 다루지 않습니다.
- $256\times 192$ 해상도와 상의 한 범주에 한정된 실험이어서 하의·원피스·고해상도로의 일반화는 검증되지 않았습니다.
💡 Key Takeaway CP-VTON은 “왜곡은 학습하고, 세부는 복사하고, 폐색만 생성한다”는 분업을 처음으로 완전히 학습 가능한 형태로 구현했습니다. 이후 가상 피팅 연구는 이 분업의 각 요소를 더 강력한 도구(흐름, 분할, 적대적 학습, 확산 모델)로 교체하며 발전해 왔습니다.