 You know maize mean?
3D Neural Field Generation using Triplane Diffusion
0. Summary
기본 정보 : ArXiv,2022.11.30 (CVPR 2023), 3D Neural Field Generation using Triplane Diffusion
연구 배경
확산 모델은 2D 이미지 생성에서 최고 성능을 보이고 있었지만, 3D 형상 생성에서는 여전히 GAN이 다른 생성 접근을 앞서고 있었다. 당시의 3D 확산 모델은 두 부류였다. 단일 전역 잠재 벡터를 denoising한 뒤 3D 디코더로 신경장(neural field)을 조건화하는 1D→3D 접근(GAUDI, functa 등)은 확산이 실제로 3D에서 일어나지 않아 중요한 귀납적 편향을 잃고 흐릿한 결과를 냈고, 포인트 클라우드 확산(PVD, Luo & Hu)은 확산 모델에 명시적 3D 제어를 주지만 거친 이산 표현 때문에 해상도와 확장성이 제한되었다. 두 접근 모두 특수한 구조가 필요해 2D 확산 모델의 최신 발전을 쉽게 활용할 수 없었다. 한편 3D-aware GAN(EG3D)은 StyleGAN2 같은 표현력 있는 2D 생성기 백본으로 triplane 표현을 합성하고 작은 MLP로 디코딩해 인상적인 3D 형상 결과를 보여 주고 있었다. 2D 확산의 “이미지가 곧 확산 목표”라는 단순함을 3D에서 어떻게 재현할 것인가가 비어 있었다.
제안 방법
ShapeNet 메시 같은 학습 데이터를 연속 occupancy field로 변환하고 축 정렬된 세 장의 2D 특징 평면(triplane)과 하나의 공유 MLP 디코더로 인수분해한 뒤, 그 triplane을 다중 채널 2D 이미지로 취급해 기존 2D 확산 모델(ADM)을 거의 그대로 학습하는 Neural Field Diffusion(NFD) 를 제안한다. 1단계에서는 많은 형상의 triplane과 공유 디코더를 함께 최적화하는데, 단순한 $L_2$ occupancy 손실만 쓰면 triplane에 고주파 artifact가 생겨 확산 모델이 그 매니폴드를 배우지 못하므로, Total Variation(TV) 정규화, $L_2$ 정규화, 명시적 밀도 정규화(EDR) 를 추가해 triplane의 기울기 분포가 자연 이미지와 비슷해지도록 만든다. 2단계에서는 세 평면을 채널 방향으로 쌓은 $128\times128\times96$ 특징 이미지를 정규화해 DDPM의 단순화된 목적으로 학습하고, 추론 시 1000 스텝 샘플링 후 공유 MLP로 occupancy를 질의해 marching cubes로 메시를 추출한다.
발견 사실
ShapeNet의 cars·chairs·planes에서 20개 시점의 shading 렌더링에 대한 FID와 precision·recall로 평가했을 때, NFD는 세 범주 모두에서 포인트 클라우드 확산 PVD와 SDF 기반 GAN인 SDF-StyleGAN을 넘었다. 특히 chairs FID 36.5 → 26.4, planes 65.8 → 32.4, cars 98.0 → 83.6이며, precision과 recall이 모두 높아 충실도와 다양성이 함께 개선되었다(Table 1). 정성적으로는 자동차의 서스펜션, 의자의 살, 비행기의 무장 같은 얇고 섬세한 구조를 재현하고, SDF-StyleGAN이 뭉개는 타이어와 휠 웰 사이 간격을 그대로 살린다(Fig. 4). 정규화 없이 학습한 triplane으로는 ground truth 디코딩은 멀쩡해도 확산 모델이 생성한 샘플에 심한 artifact가 생기며(Fig. 7), EDR이 없으면 단일 triplane 적합에서도 “floater” artifact가 남는다(Fig. 6). 정규화된 triplane의 기울기 분포는 자연 이미지의 hyper-Laplacian 분포와 매우 비슷하다(Supp. Fig. 1). DDIM과 구면 보간으로 위상이 다른 형상 사이의 의미 있는 보간도 가능하다(Fig. 5).
핵심 기여
- 2D 확산 백본으로 3D 신경장을 생성하는 틀 : triplane을 다중 채널 2D 이미지로 해석해 생성과 렌더링을 분리함으로써, 현재(그리고 미래의) 최고 2D 확산 모델을 거의 수정 없이 3D 생성에 쓸 수 있게 했다. 1D 잠재 접근과 달리 확산이 공간적으로 국소화된 3D 표현 위에서 직접 일어나 3D 귀납적 편향을 유지한다.
- 확산 친화적 triplane을 위한 정규화 : 기존 triplane 인수분해 파이프라인에 TV·$L_2$·EDR 정규화라는 “필수적 수정”을 가해, 생성 모델이 배우기 쉬운 매끄럽고 자연 이미지 같은 특징 매니폴드를 만들었다. 이것이 방법이 동작하게 하는 실질적 기여다.
- 3D GAN을 넘는 품질과 다양성 : ShapeNet 세 범주에서 FID·precision·recall 모두 SOTA를 달성해, 2D에서 확산 모델이 GAN을 앞선 것처럼 3D에서도 모드 커버리지와 세부 묘사에서 확산 모델이 우위를 가질 수 있음을 처음 보였다.
관련 개념
신경장과 Triplane 표현
신경장(neural field) 은 3차원 좌표 $x$를 입력받아 $M$차원 벡터를 출력하는 신경망 매개변수화 사상 $NF:\mathbb R^3\to\mathbb R^M$입니다. Occupancy field, signed distance function, radiance field 등 다양한 신호에 쓰이며, 장면을 연속 함수로 표현하므로 이산 표현보다 장면 복잡도에 잘 확장됩니다(Sec. 2, 3.1). 이 논문은 좌표가 물체 안인지 밖인지를 나타내는 이진값을 출력하는 occupancy field($M=1$)에 집중합니다.
🧭 1. 신경장 표현의 흐름
| 세대 | 표현 | 특징 |
|---|---|---|
| 초기 | 장면 전체를 하나의 큰 MLP로 표현 (DeepSDF, Occupancy Networks, NeRF) | 장면마다 큰 모델을 수천 번 forward해야 해 재구성이 비효율적 |
| 최근 | 국소 조건화 표현: 국소 함수 학습, 또는 명시적-암시적 하이브리드로 공유 함수를 국소 변조 | 작은 MLP를 써서 추론이 효율적이고 국소 세부 포착이 훨씬 좋음 |
논문은 Chan 등(EG3D)의 표현력 있는 하이브리드 triplane 표현을 채택합니다. Triplane은 부피가 아니라 표면적에 비례해 확장되어 효율적이고, 표현력 있고 잘 다듬어진 2D 생성기 구조와 자연스럽게 통합됩니다.
📐 2. Triplane 구조 (Eq. 1)
Triplane은 평가가 특히 효율적인 명시적-암시적 하이브리드 구조입니다. 공간 해상도 $N\times N$, 특징 채널 $C$인 세 장의 2D 특징 평면 $f_{xy},f_{xz},f_{yz}\in\mathbb R^{N\times N\times C}$와, 평면에서 샘플링한 특징을 해석하는 MLP 디코더로 이루어집니다. 3D 좌표를 질의하려면 축 정렬된 세 평면($x$-$y$, $x$-$z$, $y$-$z$)에 각각 투영해 특징을 뽑아 집계하고 파라미터 $\phi$의 경량 $\mathrm{MLP}_\phi$로 디코딩합니다. Chan 등과 마찬가지로 합이 효율적인 집계 함수임을 확인했습니다.
\[NF(x)=\mathrm{MLP}_\phi\big(f_{xy}(x)+f_{yz}(x)+f_{xz}(x)\big)\]특징 평면과 MLP를 함께 최적화해 한 형상의 occupancy field를 표현할 수 있습니다.
| 항목 | 이 논문의 설정 (Supp. 1.1) |
|---|---|
| Triplane 크기 | $128\times128\times32\times3$ (평면당 32채널, 세 평면) |
| 초기화 | 표준편차 0.1의 정규분포 |
| MLP | 스케일 1의 Fourier feature 사상 층 + 128차원 fully connected 3층(ReLU) |
더 높은 triplane 해상도는 ground truth 메시의 디코딩 열화를 줄이지만 시간·메모리 부담이 커집니다.
🆚 3. 왜 triplane인가: 다른 3D 확산 접근과의 비교
| 접근 | 확산이 일어나는 곳 | 문제 |
|---|---|---|
| 단일 잠재 (GAUDI, functa) | 1D 전역 잠재 벡터 | 3D 디코더가 1D→3D 변환을 떠맡아 확산이 3D에서 동작하지 않음. 귀납적 편향 상실, 흐릿한 결과 |
| 포인트 클라우드 (PVD, Luo & Hu) | 이산 점 집합 | 명시적 3D 제어는 있지만 거친 표현으로 해상도·확장성 제한. PVD는 2048점 고정 |
| Triplane (NFD) | 공간적으로 국소화된 2D 특징 평면 | 확산 모델이 생성된 신경장을 거의 완전히 제어. 2D 백본을 그대로 사용 |
핵심은 공유 잠재 공간에 잘 맞춰진 triplane을 확산 모델의 ground truth 데이터로 취급하는 것입니다. 이 triplane들의 잠재 공간은 국소 세부에 공간적으로 접지되어 있어 3D 생성에 결정적인 귀납적 편향을 줍니다.
💡 Key Takeaway Triplane은 “3D를 2D 이미지 세 장으로 쓰는 법”입니다. 메모리는 $O(3N^2)$, 모양은 이미지, 평가는 작은 MLP 한 번이므로 2D 생성 모델의 모든 도구가 그대로 적용됩니다.
Stage 1: 형상 클래스를 Triplane 데이터셋으로 인수분해
목표는 형상 데이터셋을 triplane 데이터셋으로 변환해 그 위에 확산 모델을 학습하는 것입니다. 그러나 MLP와 특징 평면은 보통 함께 학습되므로, 데이터셋의 각 물체에 대해 triplane을 따로 학습할 수는 없습니다. 그렇게 하면 물체마다 다른 MLP가 생겨 확산 모델이 생성한 triplane에 일반화되지 않기 때문입니다(Sec. 3.2).
🔗 1. 공유 디코더와 결합 최적화 (Eq. 2–3)
물체들을 고립시켜 학습하는 대신, 많은 물체의 특징 평면을 모든 물체가 공유하는 디코더와 함께 동시에 최적화합니다. 그 결과 최적화된 특징 평면 데이터셋과, 데이터셋 분포의 어떤 triplane도 해석할 수 있는 MLP를 얻습니다. 추론 시에는 이 MLP로 모델이 생성한 특징 평면을 디코딩합니다.
$I$개 물체의 데이터셋에서 물체당 $J$개 점의 좌표와 ground truth occupancy를 전처리합니다. 보통 $J=10M$으로, 500만 점은 부피 전체에서 균일하게, 500만 점은 표면 근처(0.01 거리 이내)에서 샘플링합니다. 단순한 학습 목적은 예측 occupancy $NF^{(i)}(x^{(i)}_j)$와 ground truth $O^{(i)}_j$ 사이의 $L_2$ 손실입니다.
\[L_{NAIVE}=\sum_{i}^{I}\sum_{j}^{J}\Big\lVert NF^{(i)}\big(x^{(i)}_j\big)-O^{(i)}_j\Big\rVert^2,\qquad\Big\{\phi,f^{(i)}_{xy},f^{(i)}_{xz},f^{(i)}_{yz}\Big\}=\arg\min L_{NAIVE}\]🧱 2. 두 단계 절차 (Sec. 4, Supp. 1.1)
| 단계 | 내용 | 비용 |
|---|---|---|
| 1-a. 결합 최적화 | 단일 A6000 GPU 메모리에 들어가는 만큼의 triplane과 MLP를 함께 학습. 무작위로 고른 500개 형상, 반복당 물체 1개 배치, 물체당 50만 occupancy 점, 200 epoch, lr $10^{-3}$ | RTX 2080Ti 한 장으로 약 1일 |
| 1-b. 개별 최적화 | 공유 MLP를 고정하고 나머지 모든 물체의 triplane을 각각 최적화. 물체당 20만 occupancy 점 배치, 30 epoch, lr $10^{-3}$ | 형상당 RTX 2080Ti로 10분, 임의 수의 GPU로 병렬화 가능 |
500개를 넘는 모든 triplane은 같은 공유 MLP로 개별 최적화되므로 효과적으로 병렬화됩니다. 결과 triplane 특징이 확산 모델 학습을 위한 의사 ground truth 이미지가 됩니다.
🗂️ 3. 데이터 전처리 (Supp. 1.1)
- 데이터셋 : ShapeNet V1의 Cars(7,496개), Chairs(4,971개), Planes(4,045개). 범주별로 별도 모델을 학습합니다.
- 정규화와 watertighting : 각 메시를 $[-1,1]^3$에 맞춘 뒤 Mescheder 등(Occupancy Networks)의 구현으로 watertight 메시로 변환합니다. 십이면체의 20개 시점에서 깊이 이미지를 렌더링하고 marching cubes로 watertight 메시를 추출합니다.
- Ground truth occupancy : 임의의 3D 점에 대해 $z$축 방향으로 광선을 쏘아 watertight 메시와의 교차 횟수를 세고, 홀수면 내부로 판정합니다. 질의점의 절반은 부피에서 균일하게, 나머지는 표면 근처에서 중요도 샘플링합니다.
💡 Key Takeaway “디코더 하나를 모든 형상이 공유한다”는 조건이 핵심입니다. 그래야 triplane들이 같은 언어로 쓰여 하나의 분포를 이루고, 확산 모델이 그 분포에서 뽑은 새 triplane을 같은 디코더가 읽을 수 있습니다.
Triplane 정규화: 확산이 배울 수 있는 매니폴드 만들기
단순한 절차의 실패가 이 논문의 실질적 출발점입니다. 앞 절의 절차로 triplane 데이터셋과 공유 디코더를 얻고 확산 모델을 학습해 새 형상을 샘플링할 수 있지만, 그 결과는 심한 artifact가 있는 형상을 만드는 생성 모델입니다. 확산 모델이 배워야 할 데이터 매니폴드를 단순화하기 위해 최적화 중 triplane 특징을 정규화하는 것이 필요합니다(Sec. 3.3).
📉 1. 세 가지 정규화 항 (Eq. 4)
\[L=\sum_{i}\sum_{j}\Big\lVert NF^{(i)}\big(x^{(i)}_j\big)-O^{(i)}_j\Big\rVert^2+\lambda_1\Big(TV\big(f^{(i)}_{xy}\big)+TV\big(f^{(i)}_{xz}\big)+TV\big(f^{(i)}_{yz}\big)\Big)+\lambda_2\Big(\lVert f^{(i)}_{xy}\rVert^2+\lVert f^{(i)}_{yz}\rVert^2+\lVert f^{(i)}_{xz}\rVert^2\Big)+EDR\big(NF(x^{(i)}_j),\omega\big)\]| 항 | 목적 | 메커니즘 |
|---|---|---|
| TV 정규화 ($\lambda_1$) | 각 학습 장면의 특징 평면에 가짜 고주파 정보가 담기지 않게 함 | 인접 픽셀 간 특징 차이에 벌점. Triplane 특징 분포를 자연 이미지 매니폴드와 비슷하게 만들어 확산 모델을 강건하게 학습시키는 데 필수 |
| $L_2$ 정규화 ($\lambda_2$) | 이상치 값 억제 | 학습된 특징 값은 유계가 아닌데 DDPM 백본은 $[-1,1]$ 입력이 필요하므로 정규화가 필요하고, 그 정규화는 이상치에 민감함. 큰 값을 벌점해 이를 완화 |
| 명시적 밀도 정규화 (EDR) | 표면 밖 부피를 매끄럽게 | Ground truth occupancy가 표면에 집중되어 있어 형상 밖 부피를 매끄럽게 배울 데이터가 부족. 부피에서 무작위 점을 뽑아 무작위 벡터 $\omega$만큼 오프셋한 뒤 두 집합을 MLP에 통과시켜 MSE를 계산: $EDR(NF(x),\omega)=\lVert NF(x)-NF(x+\omega)\rVert_2^2$. 부피의 floating artifact 제거에 필수 |
🔬 2. 효과: Fig. 6, Fig. 7, Supp. Fig. 1
- EDR 유무(Fig. 6) : 생성 모델 없이 단일 triplane을 단일 형상에 적합해도, 유한한 점 표본으로 결정 경계를 학습하는 한계(DeepSDF의 논의) 때문에 과적합이 “floater” artifact로 나타납니다. EDR 없이는 occupancy field에 상당한 artifact가 있고, EDR을 넣으면 깨끗한 물체가 됩니다.
- TV·$L_2$·EDR 전체 유무(Fig. 7) : Eq. 2만으로 학습하면 최적화된 형상의 표면 자체는 진짜처럼 보이지만 triplane 특징에 고주파 artifact가 많습니다. 이 뒤엉킨 특징 이미지는 강력한 확산 모델에게도 배우기 어려운 매니폴드라서, 학습된 확산 모델이 생성한 triplane은 심한 artifact가 있는 형상으로 디코딩됩니다. 이 artifact는 생성 샘플에만 나타나고 ground truth에서 직접 인수분해한 형상은 정규화 없이도 깨끗합니다. Eq. 4로 학습하면 triplane이 눈에 띄게 매끄럽고 주파수 분포가 자연 이미지와 더 가까워져, 확산 모델이 매니폴드를 더 쉽게 배우고 샘플이 설득력 있는 artifact 없는 형상으로 디코딩됩니다.
- 기울기 분포(Supp. Fig. 1) : Krishnan 등은 자연 이미지 기울기가 $0.5\le\alpha\le0.8$의 hyper-Laplacian으로 잘 모델링됨을 보였습니다. $\alpha=0.5$ hyper-Laplacian과 정규화 유무별 triplane 기울기 분포를 비교하면, 정규화된 triplane의 기울기는 자연 이미지의 기울기와 매우 비슷합니다.
🎚️ 3. 정규화 후의 값 범위 규격화 (Sec. 3.4, Supp. 1.2)
정규화되어도 triplane 특징은 이론적으로 유계가 아니고 이상치가 분포를 왜곡합니다. 그래서 특징 채널을 평균 0으로 정규화하고, 각 채널을 평균에서 $S=16$ 표준편차 이내로 클리핑한 뒤 $[-1,1]$ 범위로 스케일합니다. 본문 표현으로는 데이터셋 전체의 평균과 분산으로 정규화해 각 채널이 평균 0, 표준편차 0.5가 되게 합니다.
💡 Key Takeaway 확산 모델이 잘 배우는 것은 “자연 이미지처럼 생긴” 데이터입니다. 이 논문의 진짜 기여는 확산 모델이 아니라, 표현을 생성 모델 친화적으로 규격화해 triplane을 자연 이미지처럼 만든 데 있습니다.
Stage 2: Triplane 특징에 대한 확산 모델 학습과 샘플링
무조건 생성에서 확산 모델은 가우시안 노이즈를 입력받아 $T$ 스텝에 걸쳐 점진적으로 denoising합니다. 이 틀에서 확산 모델은 세 triplane 축의 특징 채널을 하나의 이미지로 쌓은 triplane 특징 $f_{0\dots T}\in\mathbb R^{N\times N\times3C}$ 위에서 동작합니다(Sec. 3.4, 3.5).
🔁 1. 순방향·역방향 과정 (Eq. 5–7)
$f_T\sim\mathcal N(f_T;0,I)$는 순수 가우시안 노이즈인 triplane 특징 이미지이고, $f_0\sim q(f_0)$는 데이터 분포(사전 인수분해되고 정규화된 학습셋 triplane)에서 뽑은 샘플입니다. 순방향 과정은 분산 스케줄 $\beta_1,\dots,\beta_T$에 따라 가우시안 노이즈를 점진적으로 더하는 Markov 체인입니다.
\[q(f_t\mid f_{t-1})=\mathcal N\!\big(f_t;\sqrt{1-\beta_t}\,f_{t-1},\beta_tI\big),\qquad q(f_t\mid f_0)=\mathcal N\!\big(f_t;\sqrt{\bar\alpha_t}f_0,(1-\bar\alpha_t)I\big)\]$\bar\alpha_t=\prod_{s=1}^{t}\alpha_s$, $\alpha_t=1-\beta_t$입니다. 역방향 과정을 배우려면 노이즈 입력에서 $\epsilon\sim\mathcal N(0,I)$를 예측하는 함수 근사기 $\epsilon_\theta$가 필요하며, DDPM을 따라 음의 로그 우도 변분 하한의 단순화된 변형으로 학습합니다.
\[L_{DDPM}=\mathbb E_{t,f_0,\epsilon}\Big[\big\lVert\epsilon-\epsilon_\theta\big(\sqrt{\bar\alpha_t}f_0+\sqrt{1-\bar\alpha_t}\epsilon,\ t\big)\big\rVert^2\Big],\qquad t\sim\mathrm{Uniform}(1,\dots,T)\]샘플링은 $f_T\sim\mathcal N(0,I)$에서 시작해 $T$ 스텝 반복합니다.
\[f_{t-1}=\frac{1}{\sqrt{\alpha_t}}\Big(f_t-\frac{1-\alpha_t}{\sqrt{1-\bar\alpha_t}}\epsilon_\theta(f_t,t)\Big)+\sigma_t\epsilon\]마지막 스텝($t=1$)을 제외하고 $\epsilon\sim\mathcal N(0,I)$이며, $\sigma_t^2=\beta_t$입니다.
🏗️ 2. 백본과 학습 설정 (Supp. 1.2)
틀은 확산 백본에 거의 무관하지만, 2D 최고 성능 확산 모델인 ADM(Dhariwal & Nichol)을 선택했습니다. 구현은 guided-diffusion 공식 코드베이스에 기반하며, 별도 언급이 없으면 DDPM 하이퍼파라미터는 클래스별 LSUN 모델과 동일합니다.
| 항목 | 값 |
|---|---|
| 입력 | $128\times128\times96$ 특징 이미지 (triplane 3장 × 32채널) |
| 배치 / GPU | 128 / A6000 8장 |
| 학습률 | cars $10^{-4}$, chairs·planes $3\times10^{-5}$ (학습 불안정 방지) |
| 학습 스텝 | cars 400k (부분 데이터 160k 사전학습 + 전체 240k), chairs 200k, planes 200k |
| 학습 시간 | cars 약 6일, chairs·planes 각 약 3일 |
🎲 3. 새로운 3D 형상 샘플링 (Sec. 3.5, Fig. 3)
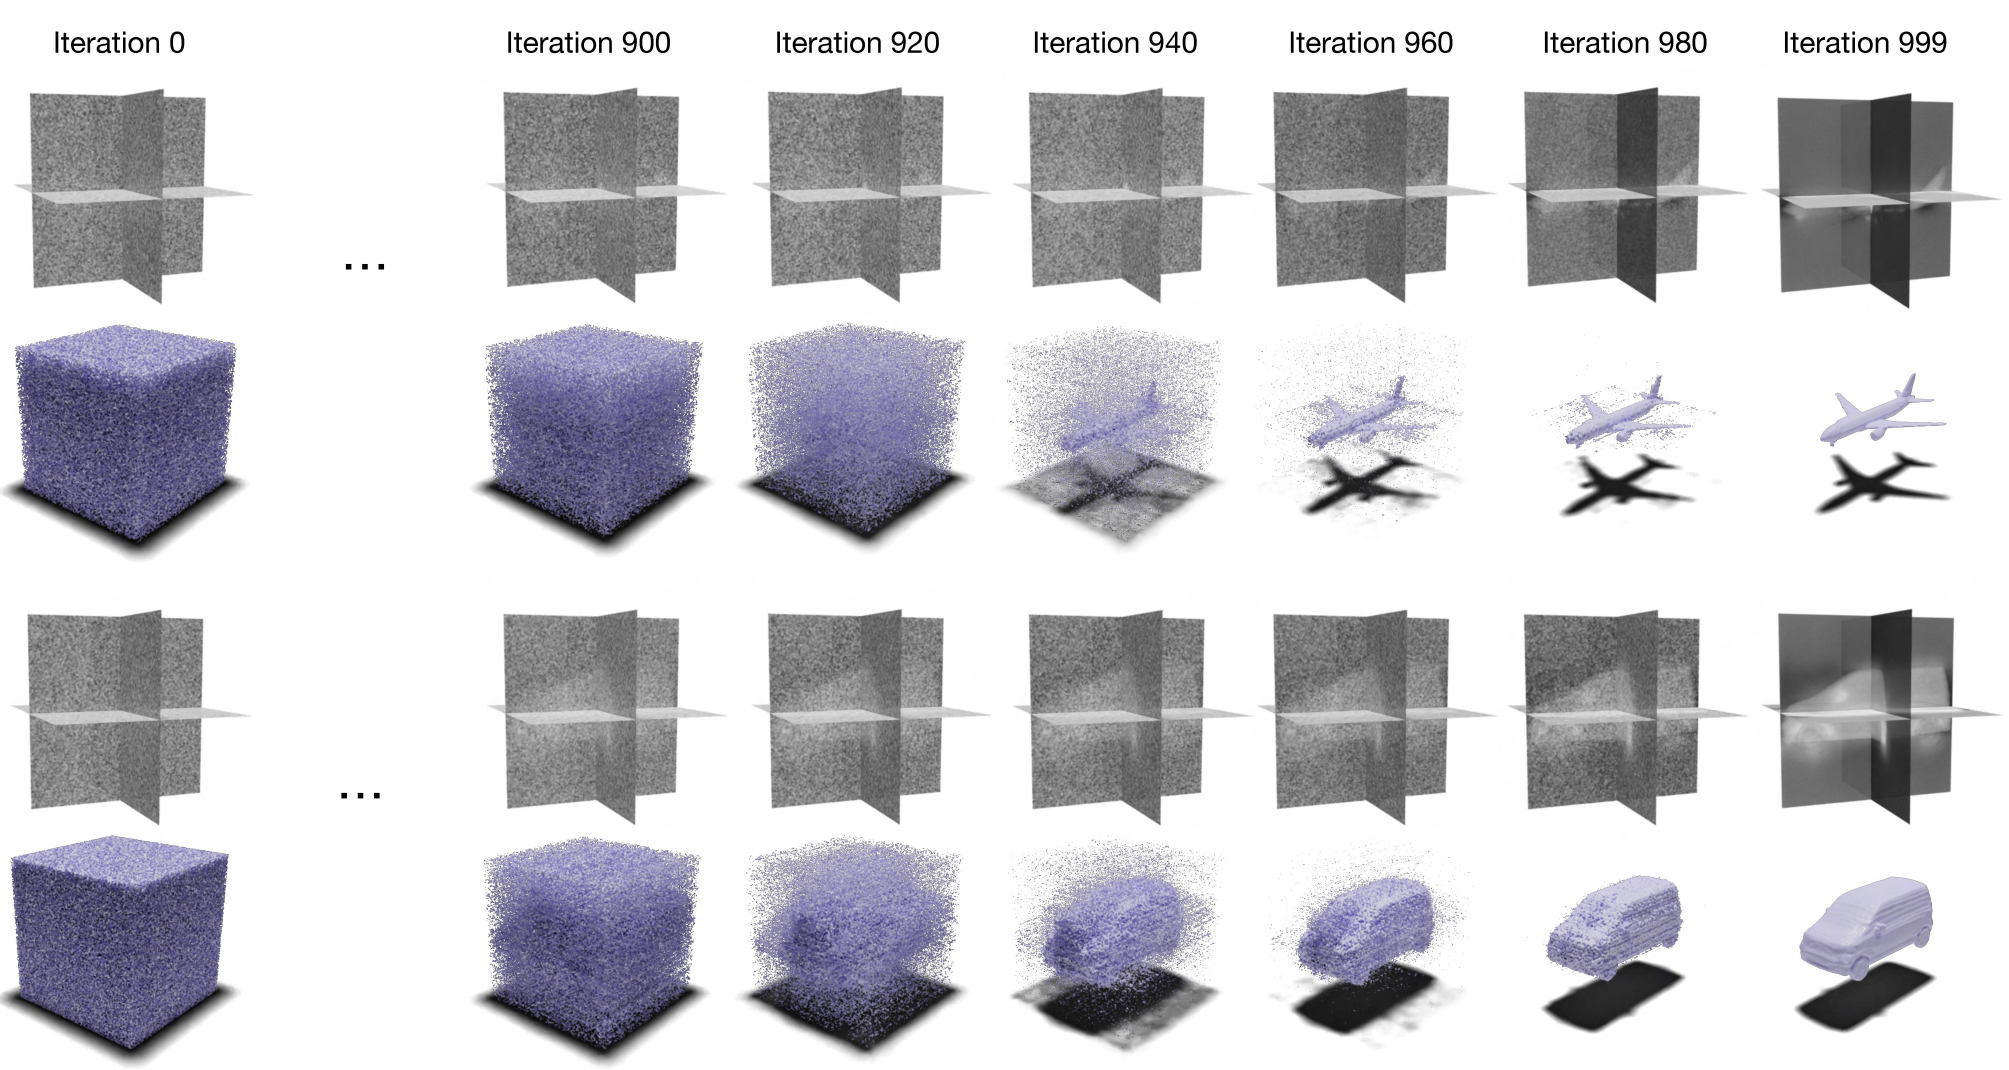
추론 시 무조건 형상 생성은 분리된 두 과정입니다. (1) 학습된 DDPM으로 잠재 노이즈를 특징 맵으로 반복 denoising하고, (2) 국소 조건화된 occupancy network로 결과 triplane을 최종 신경장으로 디코딩합니다. 이 구조 덕분에 DDPM은 2D 백본과 연속 출력 표현을 쓰면서도 3D 귀납적 편향을 가진 샘플을 생성합니다.
- 확산 모델에서 triplane 샘플링. 이미지 샘플링과 동일하며 기본 1000 스텝 DDPM. A6000 한 장에서 예시당 약 20초. 250 스텝으로 줄이면 더 빠르고 (시각적으로 판단한) 작은 충실도 손실
- 데이터셋 정규화 통계로 역정규화하고 생성 특징을 축 정렬 평면 $f_{xy},f_{yz},f_{xz}$로 분리
- 사전학습된 MLP와 결합해 신경장 질의
- Marching cubes로 메시 추출. $128^3$ 해상도에서 MLP 평가와 marching cubes를 포함해 메시당 약 5초
💡 Key Takeaway 2단계의 확산 모델은 LSUN 이미지용 ADM 설정을 그대로 가져온 것입니다. 바뀐 것은 입력 채널 수(96)뿐이며, 이것이 “2D 확산 모델을 거의 그대로 쓴다”는 주장의 실체입니다.
실험: ShapeNet에서의 비교와 보간
실험은 ShapeNet의 세 범주에서 포인트 기반·신경장 기반 3D 생성 모델과 비교하고, 렌더링 기반 FID와 precision·recall로 품질과 다양성을 분리해 평가합니다(Sec. 4).
📏 1. 평가 지표 (Eq. 8)
SDF-StyleGAN을 따라 생성 메시의 shading 렌더링 이미지에 대한 FID를 씁니다. Light-field descriptor 같은 다른 메시 기반 지표의 한계를 사람의 지각을 고려해 극복한 지표입니다. 각 형상의 shading 이미지를 20개 시점에서 렌더링하고 시점별로 FID를 계산해 평균합니다.
\[FID=\frac{1}{20}\left[\sum_{i=1}^{20}\lVert\mu^i_g-\mu^i_r\rVert^2+\mathrm{Tr}\Big(\Sigma^i_g+\Sigma^i_r-2\big(\Sigma^i_r\Sigma^i_g\big)^{\frac12}\Big)\right]\]$g,r$은 생성·학습 데이터셋, $\mu^i,\Sigma^i$는 $i$번째 시점 shading 이미지의 평균과 공분산입니다. FID는 지각 품질과 잘 상관하지만 1차원이라 서로 다른 실패 양상을 구분하지 못하므로, Sajjadi 등의 precision(생성 이미지의 품질)과 recall(생성 모델의 다양성)도 함께 보고합니다.
🆚 2. Baseline과 Table 1
| 데이터 | 방법 | FID ↓ | Precision ↑ | Recall ↑ |
|---|---|---|---|---|
| Cars | PVD* | 335.8 | 0.1 | 0.2 |
| Implicit-Grid | 209.3 | 25.9 | 21.5 | |
| SDF-StyleGAN | 98.0 | 35.9 | 36.2 | |
| NFD (Ours) | 83.6 | 49.5 | 50.5 | |
| Chairs | PVD* | 305.8 | 0.2 | 1.7 |
| Implicit-Grid | 119.5 | 74.8 | 77.2 | |
| SDF-StyleGAN | 36.5 | 90.9 | 87.4 | |
| NFD (Ours) | 26.4 | 92.4 | 94.8 | |
| Planes | PVD* | 244.4 | 2.7 | 3.8 |
| Implicit-Grid | 145.4 | 67.1 | 66.2 | |
| SDF-StyleGAN | 65.8 | 64.5 | 72.8 | |
| NFD (Ours) | 32.4 | 70.5 | 81.1 |
- PVD(포인트 클라우드 확산)와 SDF-StyleGAN(SDF 기반 GAN)은 세 범주의 사전학습 모델을 썼습니다. PVD는 본질적으로 포인트 기반이라 shading 렌더링에 필요한 삼각 메시를 내지 않으므로, ball-pivoting 알고리즘으로 포인트 클라우드를 메시로 변환했습니다(*). 이 변환이 PVD의 낮은 수치에 영향을 줍니다.
- Implicit-Grid(Ibing 등)는 부록에서 추가된 격자 기반 암시 함수 baseline입니다.
- NFD는 모든 범주에서 FID·precision·recall 모두 baseline을 넘습니다. Precision과 recall이 함께 높다는 것은 더 높은 충실도의 형상과 더 다양한 형상 분포를 동시에 만든다는 뜻이며, 정성 결과와 일치합니다.
👁️ 3. 정성 비교 (Fig. 4)
- NFD : 다양하고 섬세한 물체 모음. 자동차의 서스펜션, 의자의 살(slats), 비행기의 무장처럼 정확히 재구성하기 어려울 것으로 예상되는 섬세한 특징을 충실히 생성합니다. 더 중요하게는 학습 데이터에서 드물 것으로 보이는 여러 변종을 포함해 매우 다양한 자동차·의자·비행기를 합성합니다.
- PVD : 다양한 형상을 내지만 본질적으로 거친 물체 형상만 생성합니다. 2048점 고정 포인트 클라우드라 세밀한 요소를 합성할 수 없습니다.
- SDF-StyleGAN : 비행기 엔진, 의자 다리 등 많은 세부를 정확히 재현하는 고충실도 형상을 만들지만, 매우 세밀한 특징에서는 NFD가 앞섭니다. SDF-StyleGAN은 자동차의 타이어와 휠 웰 사이 경계를 뭉개는 반면 NFD는 그 간격을 충실히 묘사하고, 비행기 꼬리·엔진, 의자 다리·판자를 더 뚜렷하게 합성합니다. 다양성도 NFD가 더 큰데, 이는 확산 모델이 GAN보다 모드 커버리지가 좋다는 알려진 이점과 일치합니다.
🔀 4. 의미 있는 보간 (Fig. 1, 5, Supp. 1.2)
DDIM 류 선행 연구가 보인 것처럼, 반복 denoising 전에 노이즈 텐서 사이를 보간하면 확산 모델 잠재 공간에서 매끄러운 보간이 가능합니다. 결정론적 DDIM으로 샘플링하고, 중간 잠재 노이즈가 같은 분포를 유지하도록 구면 보간을 씁니다. NFD는 생성된 triplane과 그 신경장 사이에서 매끄럽고 의미 있는 보간을 하며, 위상이 다른 두 물체 사이에서도 가능합니다(Fig. 1 아래). 부록에 따르면 DDIM 설정은 DDPM보다 시각적으로 다소 낮은 품질의 메시를 내고, cars·chairs·planes는 각각 25·250·25 스텝으로 샘플링했으며 스텝 수를 바꿔도 차이는 작았습니다.
💡 Key Takeaway 세 범주 모두에서 FID와 recall이 함께 오른 것은 “더 선명하면서 더 다양하다”는 뜻입니다. 2D에서 확산 모델이 GAN에 대해 가졌던 바로 그 이점이 3D에서도 재현되었습니다.
한계와 열린 방향
논문의 결론은 2D 확산 백본으로 triplane 특징 맵을 생성해 3D 신경장으로 조립하는 3D-aware 확산 모델이 기존 3D-aware 생성 모델보다 생성 물체의 품질과 다양성을 큰 폭으로 개선했다는 것이며, 강력한 2D 확산 모델과 3D 물체 합성을 연결한 최초의 연구 중 하나로 자리매김합니다(Sec. 5). 그러나 논문 자체와 설계에서 드러나는 한계가 있습니다.
⚠️ 1. 논문이 밝힌 한계
- 학습 비용 : 다른 생성 방법처럼 확산 모델 학습은 느리고 계산 집약적입니다. Cars 모델은 A6000 8장으로 약 6일이 걸렸고, 그 전에 triplane 인수분해(결합 최적화 1일 + 형상당 10분)가 필요합니다.
- 느린 추론 : GAN은 학습 후 실시간 평가가 가능하지만 확산 모델은 평가도 느립니다. 1000 스텝 샘플링에 예시당 약 20초이고, 메시 추출에 5초가 더 듭니다. 논문은 더 효율적인 샘플러(EDM 등)가 실시간 합성을 가능하게 할 수 있으며, 2D 확산 모델의 발전이 그대로 이 방법에 도움이 될 것이라고 봅니다.
- 실패 사례(Fig. 8) : 논문은 실패 사례를 제시하며 생성이 항상 완벽하지는 않음을 인정합니다.
🔍 2. 설계에서 읽히는 한계
- 범주별 단일 모델, 기하만 생성 : ShapeNet의 세 범주를 각각 별도 모델로 학습했고, occupancy만 다루므로 색·재질은 생성하지 않습니다. 다중 범주나 대규모 데이터셋으로의 확장은 검증되지 않았습니다.
- 전처리 의존성 : 형상마다 triplane을 최적화해야 하므로 데이터셋 전처리 비용이 크고, 공유 디코더는 처음 500개 형상으로만 결합 학습됩니다. 이 500개가 분포를 충분히 대표하지 못하면 나머지 형상의 triplane 품질이 제한될 수 있습니다.
- 정규화 하이퍼파라미터 : $\lambda_1,\lambda_2$와 EDR의 오프셋 분포는 경험적으로 정해지며, 본문에 그 값이 명시되지 않습니다. 정규화 세기와 표현력 사이의 trade-off는 분석되지 않았습니다.
- Baseline 비교의 공정성 : PVD는 포인트 클라우드를 ball-pivoting으로 메시화해 평가했으므로 렌더링 기반 FID에서 구조적으로 불리합니다. PVD의 극단적으로 낮은 수치는 변환 절차의 영향을 포함합니다.
- 보간 품질 : DDIM 샘플링이 DDPM보다 메시 품질이 낮다고 부록이 인정합니다.
🔭 3. 열린 방향과 이후 연구
| 방향 | 내용 |
|---|---|
| Radiance field 생성 | Triplane은 이미 radiance field의 뛰어난 표현이므로 NeRF 생성으로 확장하는 것이 자연스럽습니다. 논문이 명시한 첫 번째 향후 과제입니다 |
| 조건부 생성 | 텍스트·이미지 등으로 조건화하는 것이 흥미로운 방향으로 제시됩니다 |
| 빠른 샘플러 | EDM 류 효율적 샘플러로 실시간 합성 가능성 |
| 이후 연구 | Rodin, 3DGen 등 triplane 확산 기반 3D 생성과, large reconstruction model 계열이 같은 표현을 씁니다. 표현 학습과 생성 학습을 분리하는 2단계 구조는 Latent Diffusion과 같은 철학입니다 |
논문은 생성 모델이 DeepFake로 확장될 수 있는 사회적 위협을 언급하며, 허위 정보 유포나 명예 훼손 목적의 사용을 용인하지 않는다고 명시합니다.
💡 Key Takeaway NFD가 남긴 질문은 “triplane을 자연 이미지처럼 만들면 2D 확산이 통한다”가 확인된 뒤, 그 표현을 색·재질·장면·조건으로 어떻게 넓힐 것인가입니다. 2D 확산 모델의 발전이 그대로 3D로 전이된다는 구조적 이점이 이 질문에 답할 토대입니다.