 You know maize mean?
Deep Unsupervised Learning using Nonequilibrium Thermodynamics
0. Summary
기본 정보 : ArXiv,2015.03.12 (ICML 2015), Deep Unsupervised Learning using Nonequilibrium Thermodynamics
연구 배경
확률 모델은 역사적으로 처리 가능성(tractability)과 유연성(flexibility) 사이의 trade-off를 겪어 왔다. 가우시안이나 라플라스처럼 해석적으로 평가하고 데이터에 쉽게 맞출 수 있는 모델은 풍부한 데이터셋의 구조를 설명하지 못하고, 임의의 음이 아닌 함수 $\phi(x)$로 $p(x)=\phi(x)/Z$를 정의하는 유연한 모델은 정규화 상수 $Z$의 계산이 일반적으로 불가능해 평가·학습·샘플링에 매우 비싼 Monte Carlo 과정이 필요하다. 평균장 이론, 변분 베이즈, contrastive divergence, score matching, pseudolikelihood 등 다양한 해석적 근사가 이 trade-off를 완화하지만 제거하지는 못했다. 생성 모델과 추론 모델을 서로 맞대어 학습하는 wake-sleep 류 접근과 변분 오토인코더가 막 재조명되던 시점이었지만, 수천 층 깊이의 생성 과정을 안정적으로 학습하면서 샘플링·확률 평가·사후분포 계산이 모두 가능한 틀은 없었다.
제안 방법
비평형 통계물리학에서 영감을 받아, 반복적인 순방향 확산 과정으로 데이터 분포의 구조를 체계적이고 천천히 파괴한 뒤, 그 구조를 복원하는 역방향 확산 과정을 학습해 유연하면서도 처리 가능한 생성 모델을 얻는 확산 확률 모델(diffusion probabilistic model) 을 제안한다. 순방향 과정은 가우시안 또는 이항 Markov 확산 커널 $T_\pi(y\mid y’;\beta)$를 $T$번 적용해 데이터 분포 $q(x^{(0)})$를 잘 알려진 분포 $\pi(y)$로 바꾸고, $\beta_t$가 작으면 역방향 전이가 순방향과 같은 함수 형태(가우시안이면 가우시안)를 갖는다는 사실(Feller 1949)을 이용해, 각 스텝의 역방향 평균·공분산 $f_\mu(x^{(t)},t), f_\Sigma(x^{(t)},t)$(이항이면 비트 반전 확률 $f_b$)를 신경망으로 회귀한다. 학습은 annealed importance sampling과 Jarzynski 등식 구조로 얻은 로그 우도 하한 $K$를 최대화하는 것이며, $K$는 해석적으로 계산 가능한 KL 발산과 엔트로피의 합으로 환원된다. 학습된 분포에 다른 분포 $r(x^{(0)})$를 곱해 사후분포를 구하는 방법과 역방향 엔트로피의 상·하한도 함께 유도한다.
발견 사실
2차원 swiss roll(40 스텝), 길이 20의 이진 heartbeat 열(2000 스텝 이항 확산), MNIST, CIFAR-10, dead leaves, bark 질감(500 스텝) 데이터에서 같은 기본 알고리즘으로 높은 로그 우도의 모델을 학습했다. Heartbeat 데이터의 하한은 시퀀스당 $-2.414$ bits로 참 분포의 $\log_2(1/5)=-2.322$ bits에 거의 도달했고, dead leaves에서는 $1.489$ bits/pixel로 당시 최고 자연 이미지 모델 MCGSM($1.244$)을 넘었으며, MNIST의 Parzen window 추정 로그 우도 $317\pm2.7$ bits는 Deep GSN($309$)과 adversarial net($325$) 사이였다(Table 1, 2). CIFAR-10 하한은 균일 노이즈로 양자화를 제거한 데이터에서 $5.4\pm0.2$ bits/pixel이었다. 역방향 각 스텝은 순방향 커널 주위의 섭동으로 매개변수화되고, 학습된 drift $f_\mu-x^{(t)}$는 데이터 매니폴드를 향한다(Fig. 1). 사후분포 샘플링으로 CIFAR-10 denoising(SNR=1)과 bark 이미지 중앙 100×100 영역 inpainting이 장거리 구조를 살려 동작함을 보였다(Fig. 3, 5).
핵심 기여
- 확산 과정에 기반한 생성 모델 틀 : 물리학의 준정적(quasi-static) 과정, 확산, annealed importance sampling 아이디어로 모델을 Markov 체인의 종점으로 명시적으로 정의하고, 각 스텝이 해석적으로 평가되므로 전체 체인도 평가 가능하게 했다. 순방향을 단순한 함수 형태로 제한해 역방향도 같은 형태를 갖게 함으로써 변분 추론의 비대칭 문제를 피했다.
- 수천 스텝 깊이의 학습 가능한 목적 함수 : 로그 우도 하한 $K$를 닫힌 형태의 KL·엔트로피 합으로 유도해, 전체 분포를 하나의 정규화 불가능한 포텐셜로 기술하는 대신 작은 섭동을 추정하는 회귀 문제로 바꿨다. 역방향 과정의 엔트로피 생성에 대한 상·하한도 제공했다.
- 분포 곱셈과 사후분포 계산 : 학습된 모델에 임의의 두 번째 분포를 곱하는 것이 각 확산 스텝에 대한 작은 섭동(가우시안이면 평균 이동)으로 처리됨을 보여, denoising·inpainting 같은 조건부 생성을 자연스럽게 지원했다. 이후 DDPM의 틀과 guidance 계열 기법의 원형이 된다.
관련 개념
처리 가능성과 유연성의 Trade-off
확률 모델의 두 목표는 서로 충돌해 왔습니다. 논문은 이 긴장을 출발점으로 삼아, 두 성질을 동시에 얻는 모델을 설계합니다(Sec. 1).
⚖️ 1. 두 종류의 모델
| 구분 | Tractable 모델 | Flexible 모델 |
|---|---|---|
| 예 | 가우시안, 라플라스 | $p(x)=\phi(x)/Z$, $\phi$는 임의의 음이 아닌 함수 |
| 장점 | 해석적 평가, 데이터에 쉽게 적합 | 임의의 데이터 구조에 맞출 수 있음 |
| 단점 | 풍부한 데이터셋의 구조를 설명 못 함 | 정규화 상수 $Z$ 계산이 일반적으로 불가능. 평가·학습·샘플링에 비싼 Monte Carlo 필요 |
이 trade-off를 완화하는 해석적 근사로 평균장 이론과 그 전개, 변분 베이즈, contrastive divergence, minimum probability flow, minimum KL contraction, proper scoring rule, score matching, pseudolikelihood, loopy belief propagation 등이 있지만 어느 것도 trade-off를 제거하지는 못합니다. 비모수 방법은 데이터가 적으면 가우시안 하나로, 무한히 많으면 무한 혼합으로 표현하므로 두 극단 사이를 매끄럽게 오가는 방법으로 볼 수 있습니다.
✨ 2. 확산 확률 모델이 약속하는 네 가지 (Sec. 1.1)
- 모델 구조의 극도의 유연성 : 각 스텝의 평균·공분산 함수를 어떤 회귀기(MLP, RBF 네트워크, 비모수 방법)로도 정의할 수 있습니다.
- 정확한 샘플링 : 근사 MCMC가 아니라 학습된 역방향 체인을 끝까지 돌리면 모델 분포의 정확한 샘플이 나옵니다.
- 다른 분포와의 쉬운 곱셈 : 사후분포 계산(denoising, inpainting)에 필요한 분포 곱이 간단합니다.
- 로그 우도와 개별 상태 확률의 저렴한 평가 : 각 스텝의 확률이 해석적이므로 전체 체인도 평가 가능합니다.
🧲 3. 물리학과의 연결
핵심 아이디어는 Markov 체인으로 한 분포를 다른 분포로 점진적으로 변환하는 것으로, 비평형 통계물리학의 Jarzynski 등식(기계학습에서는 annealed importance sampling, AIS)과 순차 Monte Carlo에서 쓰이던 것입니다. 다른 방식으로 정의된 모델을 Markov 체인으로 근사 평가하는 대신, 모델 자체를 Markov 체인의 종점으로 정의하는 것이 이 논문의 전환입니다. 관련 물리학 개념으로는 Fokker-Planck 방정식의 확률적 실현인 Langevin 동역학(임의의 목표 분포를 평형으로 갖는 가우시안 확산을 정의), 그리고 많은 순방향 확산의 역과정이 같은 함수 형태로 기술됨을 보이는 Kolmogorov 순방향·역방향 방정식이 있습니다.
💡 Key Takeaway “작은 섭동을 추정하는 것이 전체 분포를 하나의 포텐셜로 기술하는 것보다 쉽다.” 이 한 문장이 확산 모델이 trade-off를 피하는 방식입니다. 임의의 매끄러운 목표 분포에 대해 확산 과정이 존재하므로 표현력도 잃지 않습니다.
순방향·역방향 궤적
알고리즘의 목표는 임의의 복잡한 데이터 분포를 단순하고 처리 가능한 분포로 바꾸는 순방향(추론) 확산 과정을 정의하고, 그 유한 시간 역과정을 학습해 생성 모델로 삼는 것입니다(Sec. 2, Fig. 1).
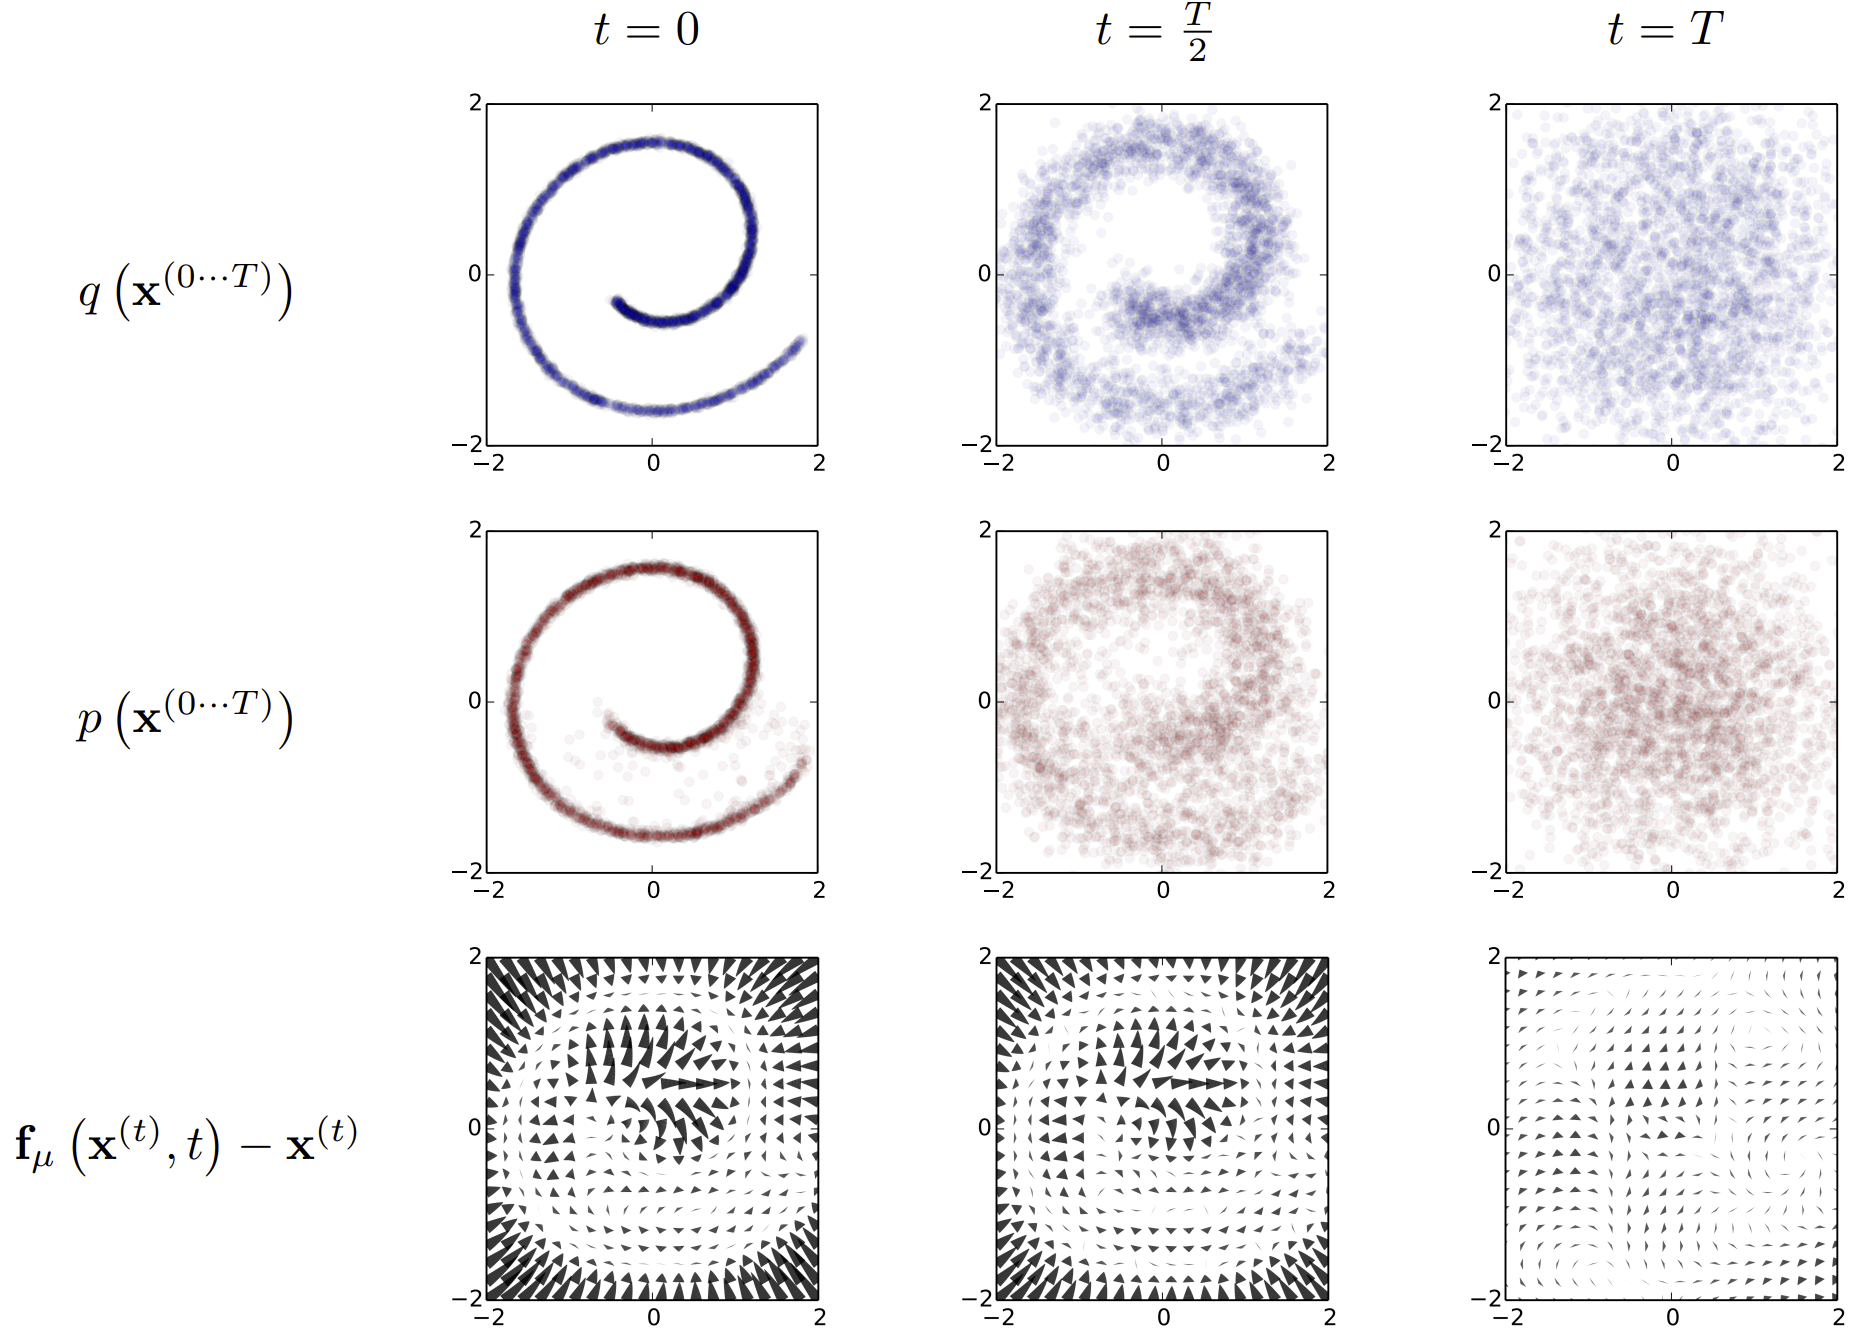
➡️ 1. 순방향 궤적 (Eq. 1–3)
데이터 분포를 $q(x^{(0)})$라 합니다. 확산 속도 $\beta$를 가진 Markov 확산 커널 $T_\pi(y\mid y’;\beta)$를 반복 적용해 $q(x^{(0)})$를 잘 알려진 분포 $\pi(y)$로 점진적으로 변환합니다. $\pi$는 이 커널의 정상 분포입니다.
\[\pi(y)=\int dy'\,T_\pi(y\mid y';\beta)\,\pi(y'),\qquad q\big(x^{(t)}\mid x^{(t-1)}\big)=T_\pi\big(x^{(t)}\mid x^{(t-1)};\beta_t\big)\]데이터 분포에서 출발해 $T$ 스텝 확산한 순방향 궤적은
\[q\big(x^{(0\cdots T)}\big)=q\big(x^{(0)}\big)\prod_{t=1}^{T}q\big(x^{(t)}\mid x^{(t-1)}\big)\]실험에서는 단위 공분산 가우시안으로 가는 가우시안 확산과 독립 이항분포로 가는 이항 확산 두 가지를 씁니다(Table App.1).
| 가우시안 | 이항 | |
|---|---|---|
| 목표 분포 $\pi(x^{(T)})$ | $\mathcal N(x^{(T)};0,I)$ | $\mathcal B(x^{(T)};0.5)$ |
| 순방향 커널 $q(x^{(t)}\mid x^{(t-1)})$ | $\mathcal N\big(x^{(t)};x^{(t-1)}\sqrt{1-\beta_t},\ I\beta_t\big)$ | $\mathcal B\big(x^{(t)};x^{(t-1)}(1-\beta_t)+0.5\beta_t\big)$ |
| 역방향 커널 $p(x^{(t-1)}\mid x^{(t)})$ | $\mathcal N\big(x^{(t-1)};f_\mu(x^{(t)},t),f_\Sigma(x^{(t)},t)\big)$ | $\mathcal B\big(x^{(t-1)};f_b(x^{(t)},t)\big)$ |
| 학습 대상 | $f_\mu,f_\Sigma,\beta_{1\cdots T}$ | $f_b$ |
⬅️ 2. 역방향 궤적 (Eq. 4–5)
생성 분포는 같은 궤적을 거꾸로 기술하도록 학습됩니다.
\[p\big(x^{(T)}\big)=\pi\big(x^{(T)}\big),\qquad p\big(x^{(0\cdots T)}\big)=p\big(x^{(T)}\big)\prod_{t=1}^{T}p\big(x^{(t-1)}\mid x^{(t)}\big)\]결정적인 사실은 가우시안·이항 확산 모두에서, 연속 확산(스텝 크기 $\beta$가 작은 극한)의 역과정이 순방향과 동일한 함수 형태를 갖는다는 것입니다(Feller 1949). $q(x^{(t)}\mid x^{(t-1)})$가 가우시안이고 $\beta_t$가 작으면 $q(x^{(t-1)}\mid x^{(t)})$도 가우시안입니다. 궤적이 길수록 $\beta$를 더 작게 할 수 있습니다. 따라서 학습 시 추정할 것은 가우시안 커널의 평균과 공분산, 이항 커널의 비트 반전 확률뿐입니다. 계산 비용은 이 함수들의 비용 × 타임스텝 수이며, 논문은 모든 결과에 다층 퍼셉트론을 쓰지만 어떤 회귀 기법이든 적용 가능합니다.
📏 3. 모델 확률과 Jarzynski 구조 (Eq. 6–9)
모델이 데이터에 부여하는 확률은 모든 중간 상태에 대한 적분입니다.
\[p\big(x^{(0)}\big)=\int dx^{(1\cdots T)}\,p\big(x^{(0\cdots T)}\big)\]이 적분은 그대로는 처리 불가능하지만, AIS와 Jarzynski 등식에서 단서를 얻어 순방향 궤적 $q(x^{(1\cdots T)}\mid x^{(0)})$을 곱하고 나누면 순방향 궤적에 대한 평균 형태가 됩니다.
\[p\big(x^{(0)}\big)=\int dx^{(1\cdots T)}\,q\big(x^{(1\cdots T)}\mid x^{(0)}\big)\cdot p\big(x^{(T)}\big)\prod_{t=1}^{T}\frac{p\big(x^{(t-1)}\mid x^{(t)}\big)}{q\big(x^{(t)}\mid x^{(t-1)}\big)}\]순방향 궤적에서 뽑은 표본으로 평균을 내면 빠르게 평가할 수 있습니다. $\beta$가 무한소이면 순방향과 역방향의 궤적 분포를 동일하게 만들 수 있고, 그 경우 단 하나의 표본으로 적분을 정확히 평가할 수 있습니다. 이는 통계물리학의 준정적 과정에 해당합니다.
💡 Key Takeaway 순방향은 설계하고 역방향만 학습합니다. 역방향이 순방향과 같은 형태의 분포라는 사실 덕분에, 학습은 “다음 스텝의 가우시안 평균·분산을 맞추는 회귀”로 줄어듭니다.
학습 목적: 로그 우도 하한 $K$
학습은 모델 로그 우도 $L$을 최대화하는 것이며, 실제로는 Jensen 부등식으로 얻은 하한 $K$를 최대화합니다. $K$가 해석적으로 계산 가능한 항들로 환원된다는 것이 이 틀의 실용성을 결정합니다(Sec. 2.4, Appendix B).
📐 1. 하한의 유도 (Eq. 10–14)
\[L=\int dx^{(0)}\,q\big(x^{(0)}\big)\log p\big(x^{(0)}\big)\ \ge\ \int dx^{(0\cdots T)}\,q\big(x^{(0\cdots T)}\big)\log\!\left[p\big(x^{(T)}\big)\prod_{t=1}^{T}\frac{p\big(x^{(t-1)}\mid x^{(t)}\big)}{q\big(x^{(t)}\mid x^{(t-1)}\big)}\right]\]Appendix B의 단계를 따르면 이 하한은 다음으로 환원됩니다.
\[L\ge K,\qquad K=-\sum_{t=2}^{T}\int dx^{(0)}dx^{(t)}\,q\big(x^{(0)},x^{(t)}\big)\,D_{KL}\Big(q\big(x^{(t-1)}\mid x^{(t)},x^{(0)}\big)\,\Big\|\,p\big(x^{(t-1)}\mid x^{(t)}\big)\Big)+H_q\big(X^{(T)}\mid X^{(0)}\big)-H_q\big(X^{(1)}\mid X^{(0)}\big)-H_p\big(X^{(T)}\big)\]유도의 핵심 단계는 다음과 같습니다.
| 단계 (Appendix B) | 내용 |
|---|---|
| B.1 | $p(x^{(T)})=\pi$의 기여를 엔트로피 $-H_p(X^{(T)})$로 분리. 확산 커널 설계상 $\pi$에 대한 교차 엔트로피가 모든 $t$에서 상수 |
| B.2 | 경계 효과 제거를 위해 역방향 마지막 스텝을 순방향 스텝과 동일하게 둠: $p(x^{(0)}\mid x^{(1)})=q(x^{(1)}\mid x^{(0)})\pi(x^{(0)})/\pi(x^{(1)})$. 이로써 $t=1$ 항이 합에서 사라짐 |
| B.3 | 순방향이 Markov이므로 $q(x^{(t)}\mid x^{(t-1)})=q(x^{(t)}\mid x^{(t-1)},x^{(0)})$로 쓰고 Bayes 규칙으로 사후분포 $q(x^{(t-1)}\mid x^{(t)},x^{(0)})$ 와 주변분포로 재표현 |
| B.4 | 주변분포 비율의 합이 조건부 엔트로피 차의 망원합으로 정리되고, 로그 비율이 KL 발산이 됨 |
모든 엔트로피는 해석적으로 계산되며, KL 발산은 $x^{(0)}$와 $x^{(t)}$가 주어지면 해석적으로 계산됩니다. 이 유도는 변분 베이즈 방법의 로그 우도 하한 유도와 평행합니다. 순방향과 역방향 궤적이 동일한 준정적 과정이면 부등식은 등식이 됩니다.
🎯 2. 학습 = 회귀 (Eq. 15)
학습은 $K$를 최대화하는 역방향 Markov 전이를 찾는 것입니다.
\[\hat p\big(x^{(t-1)}\mid x^{(t)}\big)=\arg\max_{p(x^{(t-1)}\mid x^{(t)})}K\]따라서 확률 분포 추정이라는 과제는 가우시안 열의 평균과 공분산(또는 Bernoulli 시행 열의 반전 확률)을 설정하는 함수에 대한 회귀로 환원됩니다. $x^{(0)}$가 주어지면 순방향의 “거꾸로 가는” 조건부 $q(x^{(t-1)}\mid x^{(t)},x^{(0)})$가 닫힌 형태이므로, 각 스텝의 KL은 두 가우시안(또는 두 Bernoulli) 사이의 KL이 되어 Monte Carlo 없이 계산됩니다. 이것이 서론의 “작은 섭동 하나를 추정하는 것이 더 쉽다”의 구체적 형태입니다.
🌡️ 3. 확산 속도 $\beta_t$의 설정 (Sec. 2.4.1)
순방향 궤적의 $\beta_t$ 선택은 모델 성능에 중요합니다. AIS에서 중간 분포의 올바른 스케줄이 로그 분배 함수 추정 정확도를 크게 높이고, 열역학에서 평형 분포 사이를 이동할 때 택하는 스케줄이 손실되는 자유 에너지를 결정하는 것과 같은 이유입니다.
| 확산 | $\beta_t$ 설정 |
|---|---|
| 가우시안 | $\beta_{2\cdots T}$를 $K$에 대한 경사 상승으로 학습. 첫 스텝의 분산 $\beta_1$은 과적합 방지를 위해 작은 상수로 고정. $q(x^{(1\cdots T)}\mid x^{(0)})$ 표본의 $\beta$ 의존성은 frozen noise(노이즈를 보조 변수로 두고 편미분 시 고정, VAE의 재매개변수화와 같은 방식)로 명시화 |
| 이항 | 이산 상태 공간이라 frozen noise 경사 상승이 불가능. 스텝마다 원 신호의 일정 비율 $1/T$을 지우도록 $\beta_t=(T-t+1)^{-1}$ |
각주에서 저자들은 최근 실험상 가우시안에서도 이항과 같은 고정 스케줄을 쓰는 것이 학습하는 것만큼 효과적이라고 덧붙입니다. 이는 DDPM이 $\beta_t$를 고정하는 선택과 맞닿아 있습니다.
💡 Key Takeaway $K$의 각 항이 닫힌 형태라는 점이 수천 스텝 깊이의 생성 과정을 안정적으로 학습할 수 있게 하는 이유입니다. 변분 추론과 수학적으로는 평행하지만, 추론 모델(순방향)을 학습하지 않고 설계한다는 점에서 비대칭 문제를 피합니다.
분포의 곱셈과 사후분포 계산
신호 denoising이나 결측값 추론을 위해 사후분포를 계산하려면 모델 분포 $p(x^{(0)})$에 두 번째 분포 또는 유계 양함수 $r(x^{(0)})$를 곱한 $\tilde p(x^{(0)})\propto p(x^{(0)})\,r(x^{(0)})$가 필요합니다. 분포 곱셈은 VAE, GSN, NADE, 대부분의 그래프 모델에서 비싸고 어렵지만, 확산 모델에서는 두 번째 분포를 각 확산 스텝에 대한 작은 섭동으로 다루거나 정확히 곱해 넣을 수 있어 간단합니다(Sec. 2.5).
🔀 1. 수정된 주변분포와 수정된 확산 스텝 (Eq. 16–22)
각 중간 분포에 대응하는 함수 $r(x^{(t)})$를 곱합니다. 수정된 역방향 궤적은 $\tilde p(x^{(T)})=\tfrac{1}{\tilde Z_T}p(x^{(T)})r(x^{(T)})$에서 시작해
\[\tilde p\big(x^{(t)}\big)=\frac{1}{\tilde Z_t}\,p\big(x^{(t)}\big)\,r\big(x^{(t)}\big)\]를 지납니다. 원래 역방향 커널은 평형 조건 $p(x^{(t)})=\int dx^{(t+1)}p(x^{(t)}\mid x^{(t+1)})p(x^{(t+1)})$을 만족하는데, 섭동된 커널 $\tilde p(x^{(t)}\mid x^{(t+1)})$가 섭동된 분포에 대해 같은 평형 조건을 만족하려면
\[\tilde p\big(x^{(t)}\mid x^{(t+1)}\big)=p\big(x^{(t)}\mid x^{(t+1)}\big)\frac{\tilde Z_{t+1}\,r\big(x^{(t)}\big)}{\tilde Z_t\,r\big(x^{(t+1)}\big)}\]이면 충분합니다(Eq. 21). 이것이 정규화된 분포가 아닐 수 있으므로 실제로는 대응하는 정규화 분포를 택합니다.
\[\tilde p\big(x^{(t)}\mid x^{(t+1)}\big)=\frac{1}{\tilde Z_t(x^{(t+1)})}\,p\big(x^{(t)}\mid x^{(t+1)}\big)\,r\big(x^{(t)}\big)\]가우시안의 경우 각 확산 스텝은 작은 분산 때문에 $r(x^{(t)})$에 비해 매우 날카롭게 뾰족하므로 $r(x^{(t)})/r(x^{(t+1)})$를 작은 섭동으로 다룰 수 있고, 가우시안에 대한 작은 섭동은 평균만 바꾸고 정규화 상수는 바꾸지 않으므로 Eq. 21과 22는 동치가 됩니다.
🧮 2. 섭동된 가우시안 전이 (Appendix C, Table App.1)
$r$이 충분히 매끄러우면(에너지 $E_r=-\log r$의 Hessian 고유값이 $\Sigma^{-1}$의 고유값보다 훨씬 작으면) $E_r$을 평균 $\mu=f_\mu$ 주위에서 1차 Taylor 전개할 수 있고, 결과는 평균이 이동한 가우시안입니다.
\[\tilde p\big(x^{(t-1)}\mid x^{(t)}\big)\approx\mathcal N\!\left(x^{(t-1)};\ f_\mu\big(x^{(t)},t\big)+f_\Sigma\big(x^{(t)},t\big)\,\frac{\partial\log r\big(x^{(t-1)\prime}\big)}{\partial x^{(t-1)\prime}}\bigg|_{x^{(t-1)\prime}=f_\mu(x^{(t)},t)},\ f_\Sigma\big(x^{(t)},t\big)\right)\]즉 역방향 평균을 $\log r$의 기울기 방향으로 공분산만큼 옮깁니다. $r$이 가우시안(또는 이항)과 닫힌 형태로 곱해질 수 있으면 섭동 근사 없이 정확히 곱할 수도 있으며, 일부 좌표에 대한 델타 함수(inpainting의 알려진 픽셀)가 그 경우입니다. 이항 커널에 대한 섭동식도 Table App.1에 주어집니다.
🧭 3. $r(x^{(t)})$의 선택과 응용
- 보통 $r$은 궤적을 따라 천천히 변해야 하며, 논문 실험에서는 상수 $r(x^{(t)})=r(x^{(0)})$로 둡니다(Eq. 23). 다른 편리한 선택은 $r(x^{(t)})=r(x^{(0)})^{(T-t)/T}$로, 역방향 시작 분포에 기여하지 않아 $\tilde p(x^{(T)})$에서의 초기 샘플링이 그대로 간단합니다.
- Denoising(Fig. 3) : CIFAR-10 held-out 이미지에 분산 1의 가우시안 노이즈(SNR=1)를 더한 뒤 사후분포에서 샘플링해 복원합니다.
- Inpainting(Fig. 5) : bark 이미지 중앙 100×100 영역을 등방 가우시안 노이즈로 바꾸고, $r(x^{(0)})$을 알려진 데이터에 대해서는 델타 함수, 결측 영역에서는 상수로 두어 사후분포에서 샘플링합니다. 왼쪽에서 들어오는 균열이 inpainting 영역 안으로 이어지는 등 장거리 공간 구조가 재현됩니다.
💡 Key Takeaway “역방향 평균을 $\nabla\log r$ 방향으로 살짝 민다”는 Eq. 61은 이후 classifier guidance가 하는 일과 정확히 같은 형태입니다. 조건부 확산 생성의 원형이 2015년에 이미 유도되어 있었습니다.
역방향 과정의 엔트로피 경계
순방향 과정이 알려져 있다는 사실은 또 다른 보너스를 줍니다. 역방향 궤적 각 스텝의 조건부 엔트로피에 대한 상한과 하한, 따라서 로그 우도에 대한 경계를 해석적으로 유도할 수 있습니다(Sec. 2.6, Appendix A).
📊 1. 경계식 (Eq. 24, 36)
\[H_q\big(X^{(t)}\mid X^{(t-1)}\big)+H_q\big(X^{(t-1)}\mid X^{(0)}\big)-H_q\big(X^{(t)}\mid X^{(0)}\big)\ \le\ H_q\big(X^{(t-1)}\mid X^{(t)}\big)\ \le\ H_q\big(X^{(t)}\mid X^{(t-1)}\big)\]상한과 하한 모두 $q(x^{(1\cdots T)}\mid x^{(0)})$에만 의존하므로 해석적으로 계산됩니다.
🧩 2. 유도의 논리
| 경계 | 근거 |
|---|---|
| 상한 $H_q(X^{(t-1)}\mid X^{(t)})\le H_q(X^{(t)}\mid X^{(t-1)})$ | $\pi(y)$가 최대 엔트로피 분포이므로 확산이 진행될수록 엔트로피가 증가: $H_q(X^{(t)})\ge H_q(X^{(t-1)})$. 이항에서는 무조건 성립하고, 가우시안에서는 분산 1로 스케일된 학습 데이터에 대해 성립(백색화는 불필요) |
| 하한 | Markov 체인의 추가 스텝은 초기 상태에 대한 정보를 늘리지 않으므로 $H_q(X^{(0)}\mid X^{(t)})\ge H_q(X^{(0)}\mid X^{(t-1)})$. 이를 결합 엔트로피 항등식으로 정리 |
출발점은 결합 엔트로피의 대칭성 $H_q(X^{(t-1)},X^{(t)})=H_q(X^{(t)},X^{(t-1)})$에서 얻는 $H_q(X^{(t-1)}\mid X^{(t)})=H_q(X^{(t)}\mid X^{(t-1)})+H_q(X^{(t-1)})-H_q(X^{(t)})$입니다.
🔍 3. 의미
이 경계는 각 층(타임스텝)에서의 엔트로피 생성에 대한 상·하한이며, 논문이 변분 방법 대비 차별점으로 꼽는 다섯 가지 중 하나입니다. 역방향 각 스텝이 얼마나 많은 불확실성을 가져야 하는지를 학습 전에 알 수 있으므로, 학습된 $f_\Sigma$가 합리적 범위에 있는지 점검하는 용도로 쓸 수 있습니다.
💡 Key Takeaway 순방향을 설계했기 때문에 역방향에 대해 “얼마나 랜덤해야 하는가”를 데이터 없이도 말할 수 있습니다. 이 종류의 해석적 통제는 순방향도 학습하는 VAE 류에서는 얻기 어렵습니다.
실험: 네트워크 구조와 결과
실험은 여러 연속 데이터셋과 하나의 이진 데이터셋에서 수행되었으며, 학습된 모델의 샘플링, 결측 데이터 inpainting, 다른 기법과의 성능 비교를 보입니다. 목적 함수와 기울기는 Theano로 계산했고, 최적화는 CIFAR-10(공개 구현, RMSprop)을 제외하고 SFO를 썼습니다(Sec. 3, Appendix D).
🧸 1. 장난감 문제
| 데이터 | 설정 | 결과 |
|---|---|---|
| 2D swiss roll | 단위 공분산 가우시안에서 시작하는 40 스텝 가우시안 확산. 은닉 유닛 16개의 (정규화된) RBF 네트워크가 $f_\mu$와 대각 $f_\Sigma$ 생성. 각 함수의 최상위 readout 층은 타임스텝별로 독립 학습, 나머지 층은 모든 타임스텝과 두 함수가 공유. $f_\Sigma$ 출력은 sigmoid로 $(0,1)$ 제한 | Fig. 1처럼 나선 구조가 정확히 복원. 하단의 drift $f_\mu(x^{(t)},t)-x^{(t)}$는 데이터 매니폴드를 향함 |
| Binary heartbeat | 길이 20, 5번째 bin마다 1이 나오는 이진 열. 데이터와 같은 평균 활성($p=0.2$)의 독립 이항분포에서 시작하는 2000 스텝 이항 확산. 입력 20, 은닉 50×3층의 sigmoid MLP가 $f_b$ 생성 | 생성 샘플이 학습 데이터와 동일(Fig. 2). 참 분포 로그 우도 $\log_2(1/5)=-2.322$ bits/seq 대비 하한 $-2.414$ bits/seq로 거의 완벽 |
🖼️ 2. 이미지용 네트워크 구조 (Appendix D.2.1, Fig. D.1)
- Readout : 합성곱 네트워크가 각 픽셀 $i$에 대해 $y_i\in\mathbb R^{2J}$를 출력하고, 이를 $y^\mu$와 $y^\Sigma$로 나눕니다.
- 시간 의존성 : $y^\mu$를 시간 의존 “bump” 함수에 대한 픽셀별 가중치로 씁니다.
$\tau_j\in(0,T)$는 bump 중심, $w$는 중심 간격입니다. 즉 시간 $t$는 softmax 가중된 bump 기저의 계수로 들어가며, 매 스텝의 함수는 time-dependent이지만 파라미터는 공유됩니다. 모든 이미지 실험에서 $T=1000$, bark만 $T=500$입니다.
- 평균과 분산 : 순방향 커널 주위의 섭동으로 매개변수화합니다.
$z^\mu_i$는 $p(x^{(t-1)}\mid x^{(t)})$를 여러 번 적용했을 때 생기는 평형 분포의 평균이고, $\Sigma$는 대각 행렬로 제한됩니다.
- 다중 스케일 합성곱 : pooling 없이 장거리·다중 스케일 의존성을 잡기 위해, (1) 2의 거듭제곱으로 평균 pooling 다운샘플, (2) 각 스케일에서 합성곱, (3) 모두 전체 해상도로 업샘플해 합산, (4) soft ReLU $\log(1+\exp(\cdot))$ 적용. 앞의 세 선형 연산은 다중 스케일 합성곱 커널과 유사합니다.
- Dense 층 : 전체 이미지에 작용하는 dense 층과 픽셀별로 작용하는 1×1 합성곱은 같은 형태(선형 변환 + tanh)입니다. CIFAR-10에서는 다중 스케일 합성곱 경로와 병렬로 dense 경로를 두었고, MNIST는 dense 경로만 썼습니다.
📊 3. 결과 (Table 1, 2)
| 데이터셋 | $K$ (하한) | $K-L_{null}$ |
|---|---|---|
| Swiss Roll | 2.35 bits | 6.45 bits |
| Binary Heartbeat | $-2.414$ bits/seq | 12.024 bits/seq |
| Bark | $-0.55$ bits/pixel | 1.5 bits/pixel |
| Dead Leaves | 1.489 bits/pixel | 3.536 bits/pixel |
| CIFAR-10 | $5.4\pm0.2$ bits/pixel | $11.5\pm0.2$ bits/pixel |
$L_{null}$은 등방 가우시안 또는 독립 이항분포 $\pi(x^{(0)})$의 로그 우도이며, heartbeat를 제외한 모든 데이터는 분산 1로 스케일한 뒤 계산했습니다. CIFAR-10의 경우 이전 버전의 더 높은 수치는 모델이 8비트 픽셀 양자화를 학습한 결과였고, 보고된 값은 균일 노이즈를 더해 양자화를 제거한 데이터(Theis 등 2015 권고)에 대한 것입니다.
| 모델 (Dead Leaves) | 로그 우도 |
|---|---|
| MCGSM | 1.244 bits/pixel |
| Diffusion | 1.489 bits/pixel |
| 모델 (MNIST, Parzen window) | 로그 우도 |
|---|---|
| Stacked CAE | $174\pm2.3$ bits |
| DBN | $199\pm2.9$ bits |
| Deep GSN | $309\pm1.6$ bits |
| Diffusion | $317\pm2.7$ bits |
| Adversarial net | $325\pm2.9$ bits |
| Perfect model (학습 데이터 표본) | $349\pm3.3$ bits |
- Dead leaves : 거듭제곱 분포의 크기를 가진 겹치는 원들로 이루어진, 해석적으로 다루기 쉬우면서 자연 이미지의 통계적 복잡성을 포착하는 데이터입니다. 당시 최고 자연 이미지 모델 MCGSM과 동일한 학습·테스트 데이터에서 더 높은 로그 우도를 얻었고, 샘플은 일관된 가림 관계, 다중 스케일 크기 분포, 작은 스케일의 원형 객체를 보입니다(Fig. 4).
- MNIST : 학습 알고리즘은 점근적으로 일관된 로그 우도 하한을 주지만, 연속 MNIST의 기존 결과는 대부분 샘플 기반 Parzen window 추정이므로 Goodfellow 등의 코드로 같은 방식으로 비교했습니다. 샘플(Fig. App.1)은 평균이 아닌 실제 샘플입니다.
- CIFAR-10 : 학습 이미지에 모델을 적합했고, 샘플과 denoising 결과를 Fig. 3에 보입니다.
💡 Key Takeaway 모든 실험이 비슷한 기본 알고리즘으로 수행되어 다양한 분포를 정확히 모델링할 수 있음을 보였습니다. 수치상 GAN보다 조금 낮은 MNIST 우도, 거친 CIFAR-10 샘플은 이 논문의 기여가 틀의 제시에 있고 샘플 품질 경쟁은 다음 세대의 몫이었음을 말해 줍니다.
한계와 열린 방향
논문의 결론은 정확한 샘플링과 확률 평가가 가능한 새로운 분포 모델링 알고리즘을 소개하고, 장난감 데이터부터 어려운 자연 이미지까지 효과를 보였다는 것입니다. 스텝 수를 크게 하면 각 확산 스텝의 역분포가 단순해져 추정하기 쉬워진다는 것이 알고리즘의 핵심이며, 그 결과 임의의 데이터 분포에 맞출 수 있으면서 학습·정확한 샘플링·평가가 처리 가능하고 조건부·사후분포 조작이 쉬운 모델을 얻습니다. 그러나 이 논문 시점의 한계와 이후 연구가 바꾼 지점은 분명합니다.
⚠️ 1. 이 논문이 남긴 한계
- 샘플 품질 : CIFAR-10 샘플은 자연 이미지 통계를 따르지만 거칠고, MNIST Parzen 우도는 adversarial net보다 낮습니다. 네트워크도 작았습니다(RBF 16 유닛, MLP 50×3, 소규모 다중 스케일 합성곱).
- 샘플링 비용 : 이미지에서 $T=1000$, heartbeat에서 2000 스텝의 네트워크 호출이 필요합니다. 체인이 길수록 $\beta$를 작게 해 하한을 타이트하게 할 수 있지만 그만큼 느려집니다.
- 공분산 학습의 제약 : $f_\Sigma$는 대각으로 제한되고 순방향 커널 주위의 섭동으로 매개변수화됩니다. 분산을 학습하는 것이 실제로 얼마나 이득인지는 이 논문에서 분리 평가되지 않았습니다.
- $\beta_t$ 학습의 효용 불명확 : 본문은 $\beta_{2\cdots T}$를 학습한다고 하지만 각주에서 고정 스케줄도 동등하게 효과적이라고 인정합니다.
- CIFAR-10 우도의 수정 이력 : 초기 버전의 높은 수치가 픽셀 양자화 학습의 산물이었다는 각주 3은, 연속 모델의 이산 데이터 우도 평가가 미묘하다는 교훈을 남깁니다.
🔭 2. 이후 연구가 이어 간 방향
| 이 논문의 요소 | 후속 연구에서의 변화 |
|---|---|
| 역방향 평균 $f_\mu$를 직접 회귀 | DDPM: $x_t$에 섞인 노이즈 $\epsilon$을 예측하도록 재매개변수화, 가중치를 뗀 단순 손실 $L_{simple}$ |
| $f_\Sigma$ 학습, $\beta_t$ 학습 | DDPM: 분산을 $\beta_t$ 또는 $\tilde\beta_t$로 고정, $\beta_t$ 선형 스케줄 고정. Improved DDPM: 분산 보간 학습, cosine 스케줄 |
| 가우시안 순방향 커널 | 노이즈 조건 score matching(NCSN), 연속시간 SDE로의 통합(Score SDE) |
| 분포 곱셈 Eq. 61 | Classifier guidance, 조건부 확산, inpainting·복원 응용 |
| 수천 스텝 샘플링 | DDIM, 증류, ODE 솔버 기반의 가속 |
| 소규모 다중 스케일 합성곱 + dense | U-Net 백본, self-attention, sinusoidal time embedding |
🧭 3. 읽을 때 유의할 점
- 이 논문의 표기 $x^{(t)}$, $f_\mu, f_\Sigma$, $K$는 DDPM의 $x_t$, $\mu_\theta,\Sigma_\theta$, 음의 변분 하한과 대응합니다. DDPM의 $L_T, L_{t-1}, L_0$ 분해는 Eq. 14의 세 부분과 같은 구조입니다.
- 하한 $K$는 bits 단위로 보고되며, 데이터를 분산 1로 스케일한 뒤의 값이므로 다른 논문의 bits/dim과 직접 비교할 때 주의가 필요합니다.
- 분포 곱셈의 섭동 근사(Eq. 61)는 $r$이 각 스텝의 가우시안보다 매끄러울 때만 성립합니다. 날카로운 $r$(델타 함수)은 근사 없이 정확히 곱하는 경로를 씁니다.
💡 Key Takeaway 5년 뒤 DDPM은 이 틀을 거의 그대로 가져와 매개변수화와 손실만 바꿔 GAN급 샘플을 얻었습니다. 확산 모델의 수학, 즉 순방향 설계·역방향 회귀·KL 합 하한·사후분포 섭동은 모두 이 논문에서 완성되어 있었습니다.