 You know maize mean?
Towards Scalable Unpaired Virtual Try-On via Patch-Routed Spatially-Adaptive GAN
0. Summary
기본 정보 : ArXiv,2021.11.20 (NeurIPS 2021), Towards Scalable Unpaired Virtual Try-On via Patch-Routed Spatially-Adaptive GAN
이 글은 PASTA-GAN의 수식·손실·학습 절차·실험 세부에 초점을 둔다. 전체 개요와 세 모듈의 설계 동기는 앞선 글을 참고하라.
연구 배경
비쌍(unpaired) 가상 피팅은 상점 옷 이미지 없이 사람 사진끼리 옷을 옮기는 과제로, 쌍 데이터 수집의 병목을 없애 확장성이 크다. 그러나 학습에 쓸 수 있는 신호는 “같은 사람 이미지를 재구성하라”는 자기 지도뿐이어서, 네트워크가 옷의 스타일과 공간 정보를 함께 외워 과적합되고 실제 전이 시 형태·텍스처가 무너진다. 쌍 피팅이 지도 왜곡 네트워크로 옷 특성을 보존하는 것과 달리, 비쌍에서는 왜곡 정답이 없어 같은 전략을 쓸 수 없다. 기존 비쌍 방법은 같은 사람의 다중 자세 이미지나 추론 시 온라인 최적화를 요구해 확장성을 다시 잃었다.
제안 방법
PASTA-GAN은 (1) 관절 기반 사변형 패치와 호모그래피 정규화로 옷의 공간 정보를 제거하는 패치 라우팅 분리 모듈, (2) 스타일 코드 $w$ 와 정체성 특징 $f_{id}$ 를 분리 주입하고 $128\times128$ 이후 스타일 합성 분기(SSB)·텍스처 합성 분기(TSB)로 갈라지는 조건부 StyleGAN2, (3) 왜곡 옷 특징을 인페인팅한 뒤 SPADE식으로 변조하는 공간 적응 잔차 모듈로 구성된다. 학습은 같은 이미지 재구성으로 이루어지며, 거친 결과 $\tilde{I}’$ 과 최종 결과 $I’$ 양쪽에 L1 재구성 손실, VGG-19 지각 손실, StyleGAN2 적대적 손실을 걸고, SSB의 옷 마스크에는 파싱 정답과의 L1 손실을 둔다($\lambda_{rec}=\lambda_{perc}=40,\ \lambda_{mask}=100$). 학습 시 원본과 대상 자세가 같아 왜곡 옷이 거의 완벽해지는 학습-추론 간극을 줄이기 위해, 팔 패치 하나를 확률 $\alpha_1=0.2$ 로 제거하고 무작위 마스크로 확률 $\alpha_2=0.9$ 로 일부를 지우는 무작위 지우기를 도입한다. 8대 V100, 배치 96, 400만 반복, 학습률 0.002, Adam($\beta_1=0,\ \beta_2=0.99$)으로 학습한다.
발견 사실
비쌍 설정에서 PASTA-GAN은 DeepFashion FID 21.58, UPT FID 7.852로 2위 방법(각각 ADGAN 37.36, Liquid Warping GAN 33.18)과 큰 격차를 보였고, 사용자 선호도 54.27% / 74.22%를 얻었다. 쌍 설정 MPV에서도 비지도 모델로서 FID 16.48, 선호 50.57%를 기록해 지도 학습 PF-AFN(17.40 / 28.71%)을 넘었다. Ablation(Fig. 8)에서는 TSB 없이 온전한 옷을 스타일 인코더에 넣은 PASTA-GAN⋆이 옷 형태를 틀리게 만들고, 패치를 넣은 PASTA-GAN∗은 형태는 맞추지만 텍스처를 잃으며, SSB를 제거하거나(PASTA-GAN†) 공간 적응 잔차 블록을 일반 잔차 블록으로 바꾸면(PASTA-GAN‡) 정렬 오차 아티팩트와 흐린 텍스처가 남았다. 무작위 지우기의 필요성은 보충 자료의 ablation으로 확인되었다.
핵심 기여
- 비지도 재구성 학습의 손실 설계 : 거친·최종 결과 모두에 재구성·지각·적대적 손실을 적용하고 마스크 손실로 SSB를 레이아웃 예측기로 고정해, 왜곡 정답 없이도 분기별 역할이 안정되게 했다(Sec. 3.4, Eq. 7–9).
- 학습-추론 간극 완화 기법 : 패치 크롭의 이음새와 자기 폐색을 흉내 내는 두 가지 무작위 지우기로, 학습 시 “너무 좋은” 왜곡 옷에 의존하는 지름길을 차단했다(Sec. 3.4, Fig. 5).
- 체계적 실험 : 비쌍·쌍 벤치마크, 30명 사용자 평가, 네 가지 ablation 구성으로 각 모듈의 기여를 분리해 보였다(Sec. 4, Table 1–2, Fig. 6–8).
관련 개념
문제 정식화와 추론 파이프라인
비쌍 피팅의 정식화는 간단합니다. 옷 $G_s$ 를 입은 원본 사람 $I_s$ 와 대상 사람 $I_t$ 가 주어지면, $I_t$ 의 정체성을 유지한 채 $G_s$ 를 입은 결과 $I’_t$ 를 합성합니다. 추론 파이프라인은 세 모듈을 순서대로 통과합니다.
🔄 1. 추론 흐름 (Fig. 2)
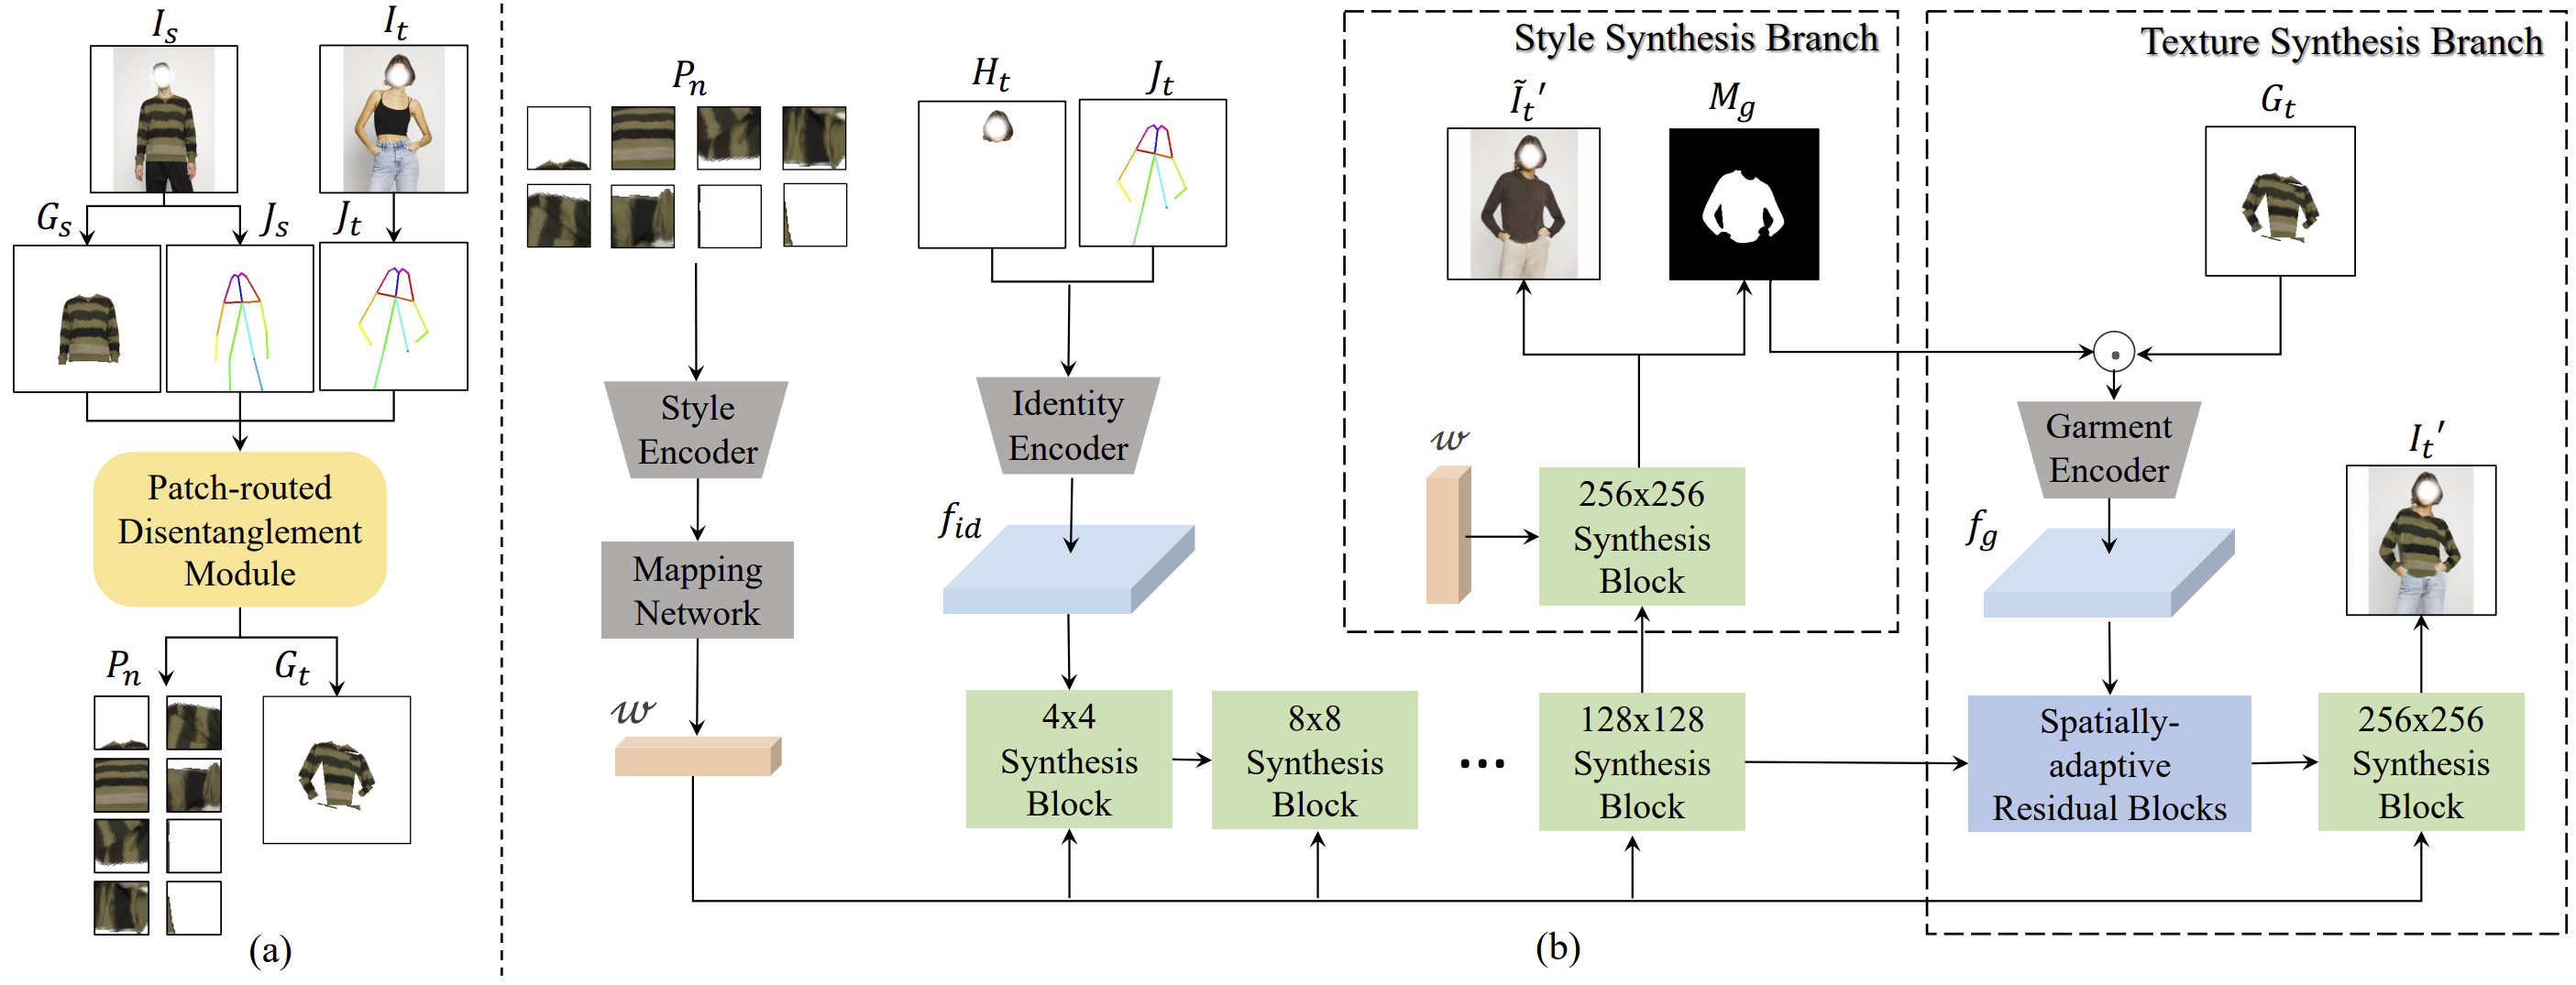
| 단계 | 입력 | 출력 |
|---|---|---|
| 전처리 | $I_s, I_t$ | 원본 옷 $G_s$ (Graphonomy), 원본 자세 $J_s$, 대상 자세 $J_t$ (OpenPose), 대상 머리 $H_t$ |
| 패치 라우팅 분리 | $G_s, J_s, J_t$ | 정규화 패치 $P_n$, 왜곡 옷 $G_t$ 와 마스크 $M_t$ |
| 조건부 StyleGAN2 (SSB) | $w(P_n)$, $f_{id}(H_t, J_t)$ | 거친 결과 $\tilde{I}’_t$, 옷 마스크 $M_g$ |
| 공간 적응 잔차 모듈 + TSB | $G_t, M_g, M_t$, 중간 특징 | 최종 결과 $I’_t$ |
🧮 2. 패치 정규화의 기하 (Eq. 1)
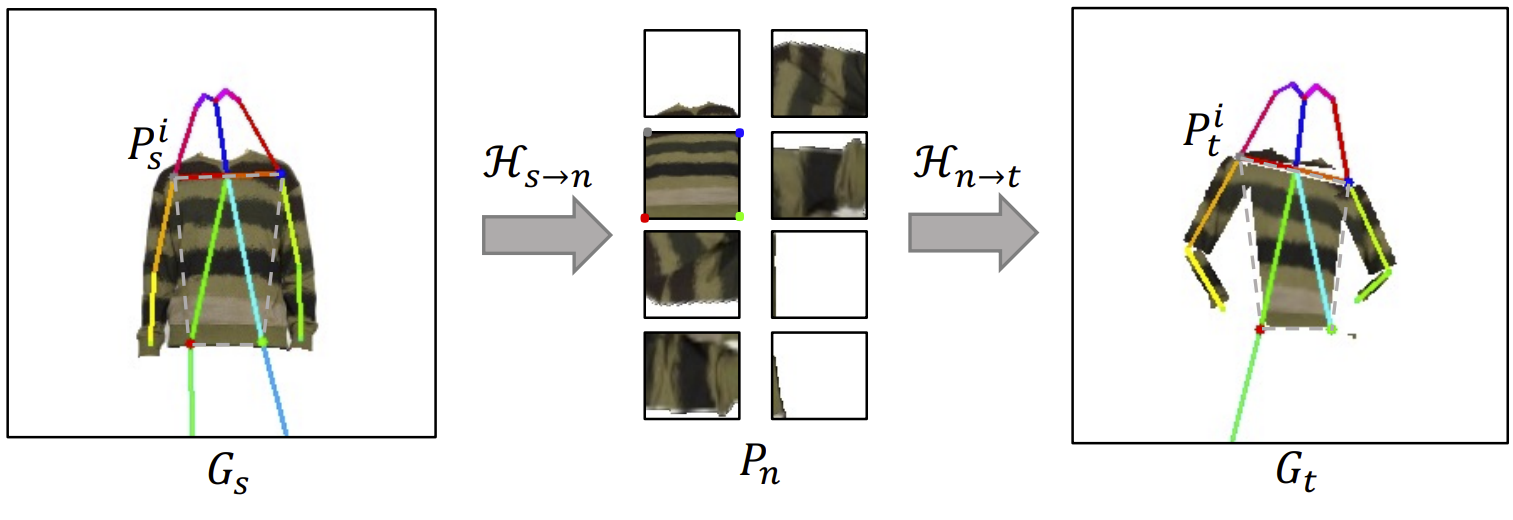
원본 패치 $P_i^s$ 의 네 꼭짓점과 $64\times64$ 템플릿 $P_i^n$ 의 네 꼭짓점 사이의 호모그래피 $H_i^{s\to n}$ 는 8자유도 사영 변환이며, 네 점 대응으로 유일하게 결정됩니다.
\[\begin{bmatrix}x_n\\ y_n\\ 1\end{bmatrix} = H_i^{s\to n}\begin{bmatrix}x_s\\ y_s\\ 1\end{bmatrix},\qquad H_i^{s\to t} = H_i^{n\to t}\,H_i^{s\to n} \tag{1}\]대상 패치의 꼭짓점은 $J_t$ 에서 같은 규칙으로 정의되므로, 원본과 대상 사이의 직접 변환은 두 호모그래피의 곱입니다. 상의 패치는 좌/우 상완·하완, 좌/우 엉덩이, 몸통, 목의 8개입니다.
🎛️ 3. 조건부 StyleGAN2의 조건 주입 정리 (Sec. 3.2)
생성기에 들어가는 조건은 네 가지이며, 각각 다른 지점에서 주입됩니다.
| 조건 | 출처 | 변환 | 주입 지점 | 담당 정보 |
|---|---|---|---|---|
| 정규화 패치 $P_n$ | 분리 모듈 | 스타일 인코더 → 매핑 네트워크 → $w$ | 모든 합성 블록의 가중치 변조 | 옷의 색·무늬(전역 스타일) |
| 대상 머리 $H_t$, 자세 $J_t$ | 파서, OpenPose | 정체성 인코더 → $f_{id}$ | 합성 네트워크의 시작 텐서 | 얼굴·머리·자세(공간 레이아웃) |
| 왜곡 옷 $G_t$, 마스크 $M_t$ | 분리 모듈 | 옷 인코더 $E_g$ → 인페인팅 → $f_g$ | TSB 마지막 두 블록 사이의 공간 적응 잔차 블록 | 옷의 고주파 텍스처 |
| 옷 마스크 $M_g$ | SSB 출력 | 정렬/불일치 영역 계산 | 공간 적응 잔차 모듈의 마스크 | 텍스처를 넣을 영역 |
StyleGAN2 원형과 비교하면 (1) 학습된 상수 입력이 $f_{id}$ 로 바뀌고, (2) 잠재 벡터 $z$ 대신 인코더 출력이 매핑 네트워크에 들어가며, (3) $128\times128$ 이후 두 분기로 갈라지고, (4) TSB에만 외부 특징 주입 모듈이 붙습니다. 스타일 코드가 모든 블록에 들어가므로 SSB와 TSB 모두 같은 옷 스타일을 공유하고, 텍스처 특징은 TSB에만 들어가므로 두 분기의 출력 차이가 곧 텍스처 모듈의 기여입니다.
💡 Key Takeaway 추론 시 학습 가능한 모듈은 생성기뿐이고, 왜곡은 전부 닫힌 형태의 기하입니다. 네 조건이 서로 다른 지점으로 들어가는 구조가 “속성 분리”의 실체입니다. 따라서 추론 속도가 빠르고 온라인 최적화가 필요 없습니다.
손실 함수와 학습 목표
학습 목표는 쌍 데이터가 없으므로 원본과 대상을 같은 사람으로 두는 이미지 재구성입니다. 핵심 질문은 “어떤 출력에 어떤 손실을 걸어야 SSB와 TSB가 각자의 역할을 배우는가”입니다.
📐 1. 재구성 손실과 지각 손실 (Eq. 7)
거친 결과 $\tilde{I}’$ 과 최종 결과 $I’$ 모두에 같은 두 손실을 적용합니다.
\[L_{rec} = \sum_{I\in\{\tilde{I}', I'\}}\|I - I_s\|_1,\qquad L_{perc} = \sum_{I\in\{\tilde{I}', I'\}}\sum_{k=1}^{5}\lambda_k\,\|\phi_k(I) - \phi_k(I_s)\|_1 \tag{7}\]$\phi_k$ 는 ImageNet 사전학습 VGG-19의 $k$ 번째 층 특징이며, 층별 가중치 $\lambda_k$ 는 논문에 명시되지 않았습니다. 거친 결과에도 손실을 거는 이유는 SSB가 TSB에 기대지 않고 스스로 정확한 형태와 평균 색을 내도록 강제하기 위해서입니다. 그렇지 않으면 SSB가 대충 출력하고 TSB가 모든 것을 떠안아, 마스크 $M_g$ 의 품질이 떨어집니다.
🎭 2. 마스크 손실과 적대적 손실 (Eq. 8–9)
\[L_{mask} = \|M_g - M_{gt}\|_1 \tag{8}\]$M_{gt}$ 는 사람 파싱에서 얻은 옷 마스크입니다. 이 손실이 SSB를 “레이아웃 예측기”로 고정하고, 그 결과 $M_g$ 가 공간 적응 잔차 모듈의 정렬/불일치 영역 계산에 쓰일 만큼 정확해집니다.
적대적 손실 $L_{GAN}$ 은 StyleGAN2와 동일한 형태로 $\tilde{I}’$ 과 $I’$ 양쪽에 적용됩니다. 전체 손실은
\[L = L_{GAN} + \lambda_{rec}L_{rec} + \lambda_{perc}L_{perc} + \lambda_{mask}L_{mask},\qquad \lambda_{rec}=40,\ \lambda_{perc}=40,\ \lambda_{mask}=100 \tag{9}\]⚖️ 3. 가중치가 말해 주는 것
| 항 | 가중치 | 해석 |
|---|---|---|
| $L_{GAN}$ | 1 | 사실성의 기준선 |
| $L_{rec}, L_{perc}$ | 40 | 재구성 학습이므로 정답과의 일치가 지배적. 적대적 항은 보조 |
| $L_{mask}$ | 100 | 마스크 정확도가 TSB 전체의 전제이므로 가장 강하게 |
재구성 가중치가 매우 크다는 것은, 이 모델이 “GAN”이라는 이름에도 불구하고 실질적으로 지각 손실 기반 재구성 네트워크에 적대적 정규화를 더한 것임을 뜻합니다.
💡 Key Takeaway 손실 설계의 요점은 분기별 책임 분리입니다. 거친 결과에도 재구성 손실을, 마스크에는 가장 큰 가중치를 두어 SSB가 레이아웃을, TSB가 텍스처를 맡도록 학습 신호로 못 박습니다.
특징 인페인팅과 공간 적응 변조의 수식
공간 적응 잔차 모듈의 두 수식은 “왜곡 옷의 어느 부분을 믿을 것인가”와 “믿는 부분을 어떻게 주입할 것인가”에 각각 답합니다.
🩹 1. 정렬/불일치 영역과 인페인팅 (Eq. 2–5)
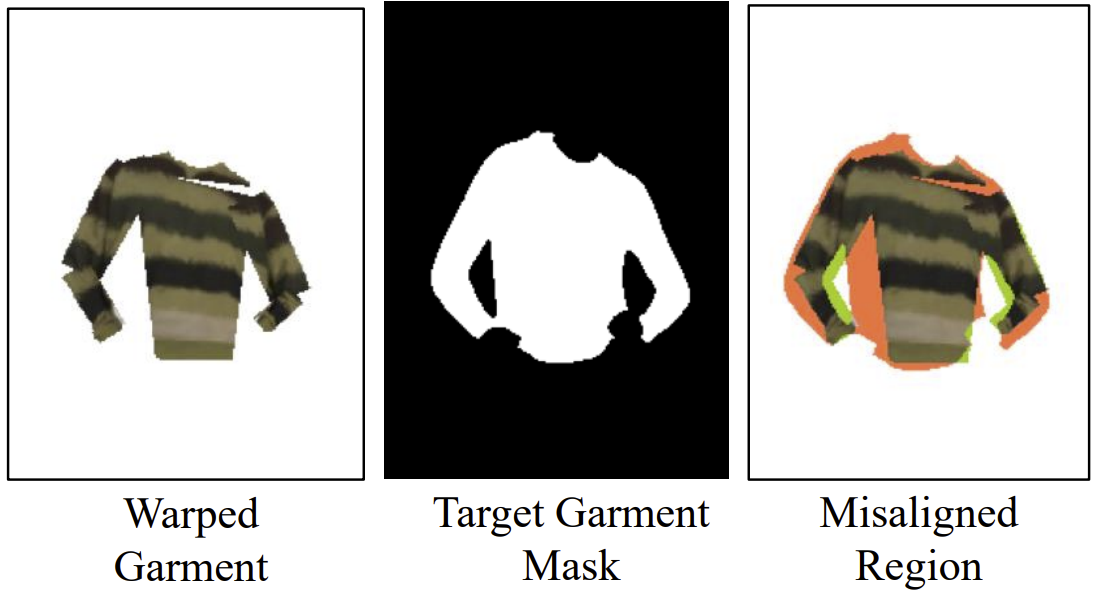
\(M_{align} = M_g\cap M_t \tag{2}\) \(M_{misalign} = M_g - M_{align} \tag{3}\) \(f'_g = E_g(G_t\odot M_g) \tag{4}\) \(f_g = f'_g\odot(1-M_{misalign}) + A(f'_g\odot M_{align})\odot M_{misalign} \tag{5}\)
| 영역 | Fig. 4 색 | 처리 |
|---|---|---|
| $M_t\setminus M_g$ (옷이 마스크 밖으로 삐져나옴) | 초록 | Eq. 4에서 $M_g$ 로 곱해 제거 |
| $M_{misalign} = M_g\setminus M_t$ (마스크 안인데 옷이 없음) | 주황 | Eq. 5에서 평균 특징 $A(\cdot)$ 로 채움 |
| $M_{align}$ | — | 원래 특징 유지 |
$A(\cdot)$ 는 정렬 영역 특징의 공간 평균이므로 “이 옷의 대표 질감”입니다. 마지막 합성 블록은 이 평균을 단서로 불일치 영역에 그럴듯한 텍스처를 생성합니다.
🎚️ 2. 공간 적응 정규화 (Eq. 6)
\[\gamma_{z,y,x}(f_g)\cdot\frac{h_{z,y,x}-\mu_z}{\sigma_z} + \beta_{z,y,x}(f_g),\qquad \mu_z = \frac{1}{HW}\sum_{y,x}h_{z,y,x},\quad \sigma_z = \sqrt{\frac{1}{HW}\sum_{y,x}(h_{z,y,x}-\mu_z)^2} \tag{6}\]- 정규화는 채널별(인스턴스 정규화와 동일)이고, 변조 파라미터는 위치별입니다.
- $\gamma(\cdot),\beta(\cdot)$ 는 $f_g$ 를 입력받는 합성곱이므로, 왜곡 옷의 텍스처가 있는 자리에 그 텍스처에 맞는 스케일·시프트가 적용됩니다.
- SPADE에서 의미 분할 맵이 하던 역할을 여기서는 인페인팅된 옷 특징이 합니다.
🧱 3. 모듈 배치
옷 인코더 $E_g$ 하나와 공간 적응 잔차 블록 세 개가 TSB의 마지막 두 합성 블록 사이에 놓입니다. 최종 해상도 직전에 두는 이유는 텍스처가 고주파 정보이므로 가장 높은 해상도의 특징에 주입해야 손실이 적기 때문입니다.
💡 Key Takeaway Eq. 2–5는 “믿을 수 없는 픽셀을 걸러 내는” 전처리이고, Eq. 6은 “걸러진 특징을 위치별로 주입하는” 변조입니다. 둘이 합쳐져 거친 호모그래피 왜곡의 오차가 최종 결과에 전사되지 않습니다.
학습-추론 간극과 무작위 지우기
학습-추론 간극은 비지도 재구성 학습 고유의 문제입니다. 학습 시에는 원본과 대상이 같은 사람이므로 $J_s = J_t$ 이고, 왜곡 옷 $G_t$ 가 원본 옷 $G_s$ 와 거의 같아집니다. 반면 추론 시에는 자세가 달라 $G_t$ 에 이음새·결손·자기 폐색이 생깁니다.
🧩 1. 왜 간극이 생기는가 (Fig. 5)
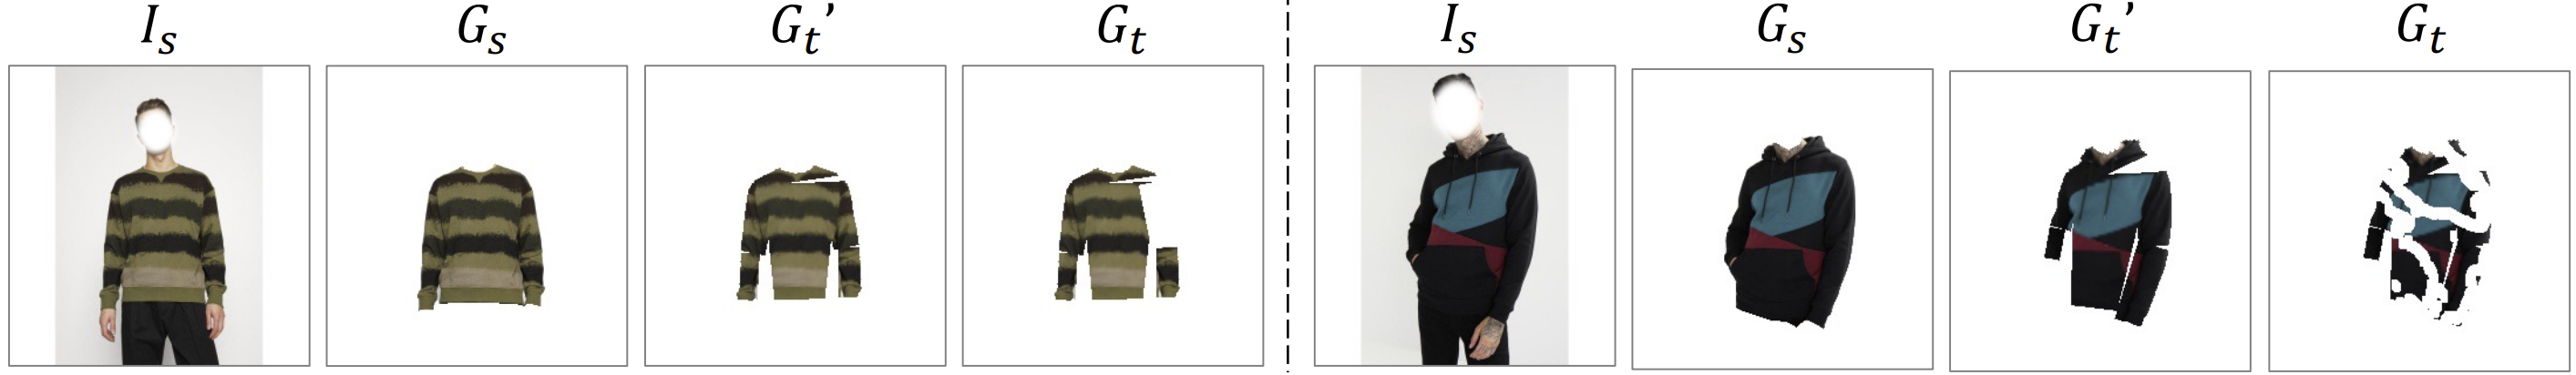
사변형 크롭은 설계상 완벽히 맞물리지 않으므로 학습 시에도 패치 사이 작은 이음새와 몸통 경계의 결손은 있습니다($G’_t$). 그러나 추론 시의 $G_t$ 는 훨씬 더 손상됩니다. 원본에서 팔이 몸 앞에 있어 소매 패치 일부가 가려졌거나, 대상 자세에서 패치가 겹치는 등 학습 때 보지 못한 패턴이 나타납니다. 학습 시 깨끗한 $G_t$ 에 익숙해진 TSB는 이런 입력에서 아티팩트를 냅니다.
✂️ 2. 두 가지 무작위 지우기
| 연산 | 확률 | 흉내 내는 현상 |
|---|---|---|
| 네 팔 패치 중 하나를 통째로 제거 | $\alpha_1 = 0.2$ | 원본에서 팔 전체가 가려진 경우 |
| 무작위 마스크(부분 합성곱 인페인팅 연구의 마스크)로 일부 지우기 | $\alpha_2 = 0.9$ | 불규칙한 자기 폐색, 패치 결손 |
Fig. 5는 원본 옷 $G_s$, 패치를 단순 재조립한 $G’_t$, 지우기를 거쳐 실제로 네트워크에 들어가는 $G_t$ 를 나란히 보여 주며, $G_t$ 와 $G_s$ 의 차이가 상당함을 확인할 수 있습니다. $\alpha_2$ 가 0.9로 매우 높다는 것은 거의 모든 학습 표본이 손상된 왜곡 옷을 보도록 설계되었다는 뜻입니다.
🔬 3. 효과
무작위 지우기 없이 학습하면 TSB가 $G_t$ 를 거의 그대로 복사하는 지름길을 배우고, 추론 시 결손 영역이 그대로 구멍으로 남습니다. 지우기를 넣으면 TSB는 “$G_t$ 가 없는 곳은 주변 텍스처와 스타일 코드로 채운다”를 배우며, 이것이 특징 인페인팅(Eq. 5)과 결합해 폐색에 강한 결과를 냅니다. 보충 자료의 ablation이 이 필요성을 확인합니다.
💡 Key Takeaway 비지도 재구성 학습은 “학습이 너무 쉬운” 함정이 있습니다. 무작위 지우기는 학습 입력을 일부러 추론 입력만큼 나쁘게 만들어, 네트워크가 복사 대신 복원을 배우도록 강제합니다.
실험 설정과 정량 결과
실험은 UPT, DeepFashion, MPV 세 데이터셋에서 FID와 사용자 평가로 수행됩니다.
⚙️ 1. 구현 세부 (Sec. 4)
| 항목 | 값 |
|---|---|
| 프레임워크·하드웨어 | PyTorch, Tesla V100 8대 |
| 배치 / 반복 | 96 / 400만 |
| 최적화 | Adam, $\beta_1=0,\ \beta_2=0.99$, 학습률 0.002 |
| 손실 가중치 | $\lambda_{rec}=40,\ \lambda_{perc}=40,\ \lambda_{mask}=100$ |
| 지우기 확률 | $\alpha_1=0.2,\ \alpha_2=0.9$ |
| 패치 템플릿 | $64\times64$, 상의 8패치 |
$\beta_1=0$ 과 학습률 0.002는 StyleGAN2의 기본 레시피를 그대로 따른 것입니다.
📦 2. 데이터셋
| 데이터셋 | 역할 | 규모 |
|---|---|---|
| UPT (신규) | 비쌍 학습·평가 | 33,254장(학습 27,139 / 테스트 6,115). MPV·DeepFashion 정면 이미지를 더해 54,714 / 10,493 |
| DeepFashion | 비쌍 평가 | 기존 벤치마크 |
| MPV | 쌍 평가 | 상점 옷 → 사람 설정 |
얼굴 등 개인 식별 정보는 마스킹되었습니다.
📊 3. 비쌍 설정 결과 (Table 1, Fig. 6)

| 방법 | 유형 | DeepFashion FID ↓ | 선호 ↑ | UPT FID ↓ | 선호 ↑ |
|---|---|---|---|---|---|
| CP-VTON | 쌍 | 69.46 | 2.177% | 70.76 | 1.551% |
| ACGPN | 쌍 | 44.41 | 4.597% | 37.99 | 3.448% |
| PF-AFN | 쌍 | 46.19 | 4.677% | 36.69 | 4.224% |
| ADGAN | 비쌍 | 37.36 | 21.29% | 39.60 | 7.241% |
| Liquid Warping GAN | 비쌍 | 42.18 | 12.98% | 33.18 | 9.310% |
| PASTA-GAN | 비쌍 | 21.58 | 54.27% | 7.852 | 74.22% |
사용자 평가는 자원자 30명이 데이터셋별 설문(각 40개 과제)에서 가장 사실적인 결과를 고른 비율입니다. 쌍 방법은 사람에서 잘라낸 옷을 왜곡하지 못해 크게 어긋나고, ADGAN은 DeepFashion 과적합으로 텍스처와 정체성을 잃으며, Liquid Warping GAN은 SMPL에 의존해 옷 형태가 부정확합니다.
🥇 4. 쌍 설정 결과 (Table 2, Fig. 7)
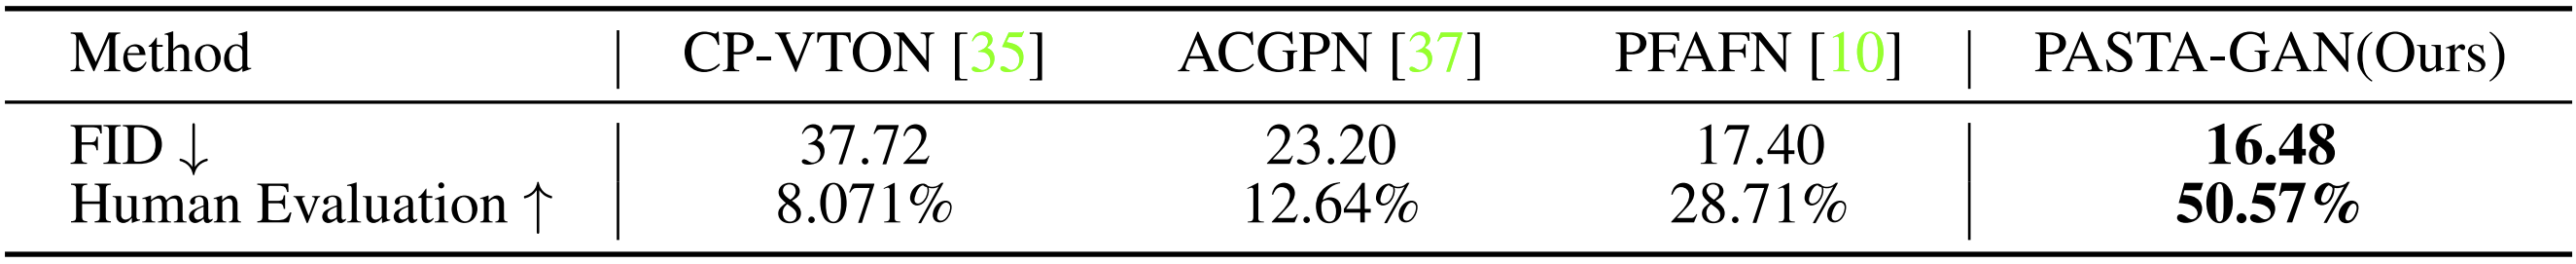
| 방법 | FID ↓ | 선호 ↑ |
|---|---|---|
| CP-VTON | 37.72 | 8.071% |
| ACGPN | 23.20 | 12.64% |
| PF-AFN | 17.40 | 28.71% |
| PASTA-GAN | 16.48 | 50.57% |

쌍 설정에서 쌍 방법들의 품질은 크게 좋아지지만, 전역 TPS·흐름 왜곡은 큰 자세 변화에서 텍스처와 형태를 왜곡합니다. 패치 단위 왜곡은 변형을 국소화해 텍스처를 더 보존하고, 슬링처럼 드문 옷과 전신 이미지에서도 안정적입니다.
💡 Key Takeaway FID 격차(UPT 7.85 vs 33.18)는 단순한 개선이 아니라 패러다임 차이를 반영합니다. 그리고 쌍 벤치마크에서의 역전은 패치 기반 왜곡이 전역 왜곡보다 텍스처 보존에 유리하다는 독립적 증거입니다.
Ablation과 실패 분석
Ablation은 네 가지 변형 모델로 패치 분리와 공간 적응 잔차 모듈의 기여를 분리합니다(Fig. 8). 수치는 그림에 포함되어 있어 본문 텍스트에는 없으므로 여기서는 정성적 결론을 정리합니다.
🧪 1. 네 가지 구성 (Fig. 8)
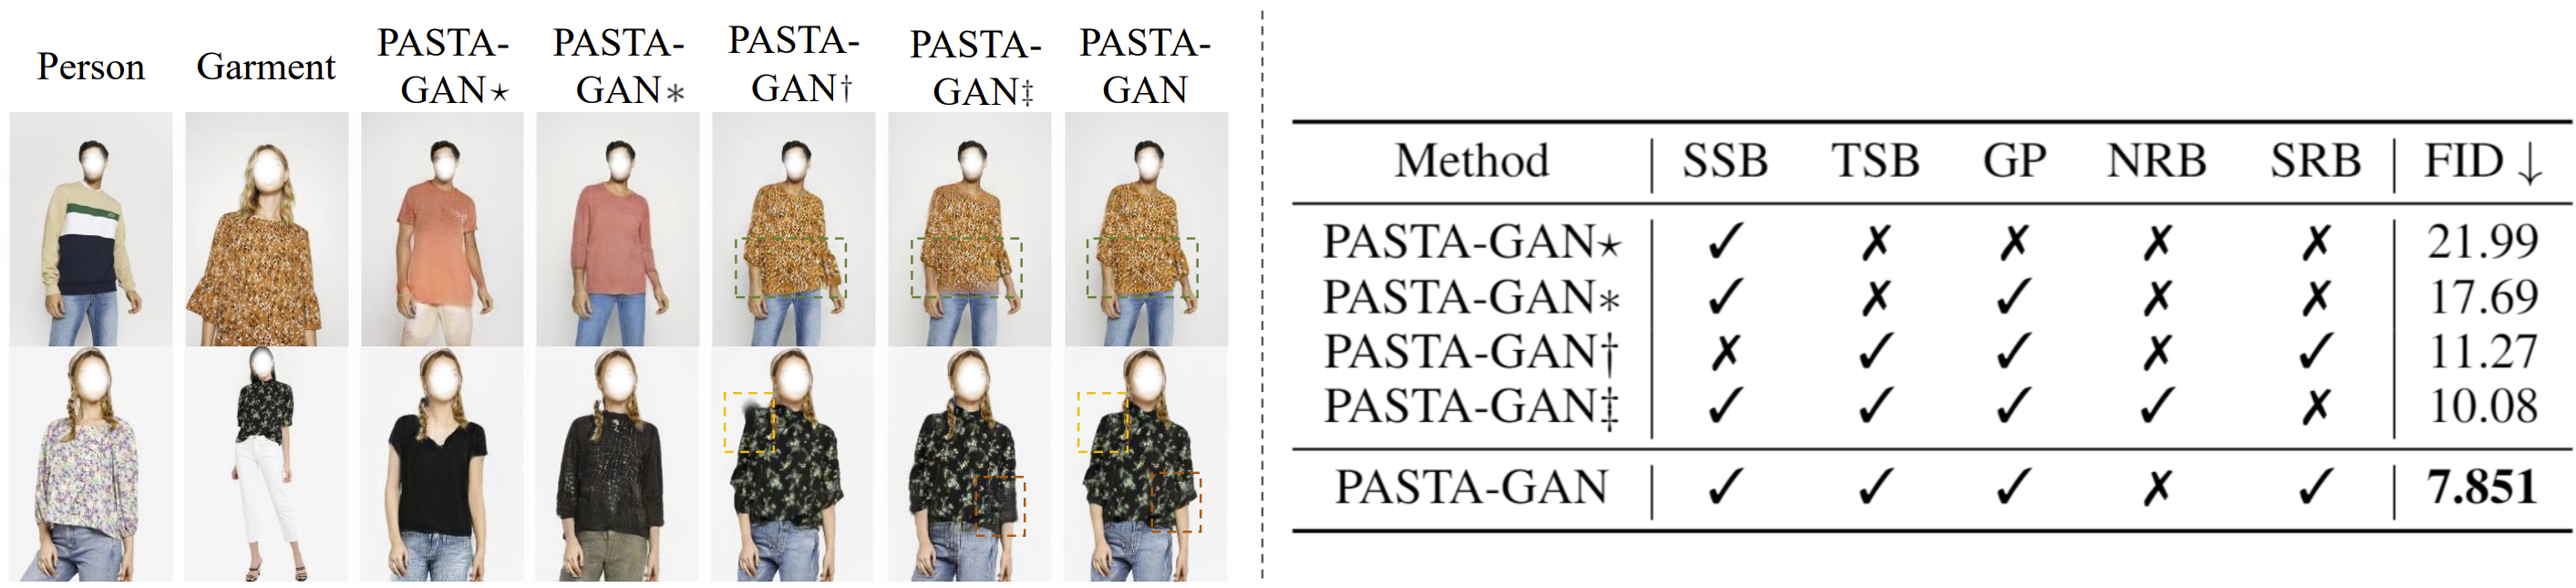
| 모델 | 스타일 인코더 입력 | SSB | TSB | 잔차 블록 | 관찰 |
|---|---|---|---|---|---|
| PASTA-GAN⋆ | 온전한 옷 | ○ | × | — | 옷 형태가 부정확 |
| PASTA-GAN∗ | 옷 패치 | ○ | × | — | 형태는 정확하나 텍스처 없음 |
| PASTA-GAN† | 옷 패치 | × | ○ | 공간 적응 | 정렬 오차 아티팩트, 흐린 텍스처 |
| PASTA-GAN‡ | 옷 패치 | ○ | ○ | 일반 잔차 | 정렬 오차 아티팩트, 흐린 텍스처 |
| PASTA-GAN | 옷 패치 | ○ | ○ | 공간 적응 | 형태·텍스처 모두 보존 |
🔍 2. 읽어 낼 수 있는 인과
- ⋆ vs ∗ : 입력만 바꿨을 뿐인데 형태 정확도가 달라집니다. 온전한 옷에는 원본 자세의 공간 정보가 남아 스타일 코드를 오염시키고, 패치는 이를 제거합니다. 패치 라우팅의 분리 효과를 직접 보여 줍니다.
- ∗ vs full : TSB가 없으면 1차원 스타일 코드만으로 텍스처를 복원할 수 없습니다. 왜곡 옷을 직접 보는 경로가 필수입니다.
- † vs full : SSB가 없으면 정확한 $M_g$ 가 없어 정렬/불일치 영역 계산이 무너지고, 결과적으로 TSB가 잘못된 영역의 특징을 주입받습니다.
- ‡ vs full : 같은 특징을 주입해도 일반 잔차 블록(덧셈)은 정렬 오차를 그대로 통과시키고, 공간 적응 변조는 정규화된 특징 위에서 작동해 오차를 흡수합니다.
⚠️ 3. 실패 사례와 한계
- 파서 미지원 액세서리 : 벨트는 사람 파서가 레이블하지 않아 배경으로 처리되고, 결과에서 매끈하게 지워집니다.
- 이음새 : 사변형 크롭의 이음새와 몸통 경계 결손은 무작위 지우기와 인페인팅으로 완화되지만 완전히 사라지지는 않습니다.
- 평면 가정 : 호모그래피는 각 패치를 평면으로 가정하므로 팔이 크게 굽거나 옷이 몸을 감싸는 경우 실제 변형과 어긋납니다.
- 해상도와 범주 : $256\times192$ 수준의 상의 중심 설계입니다. 후속작 PASTA-GAN++는 $512\times320$, 상·하의·원피스 통합, 통합 파싱 예측으로 이를 확장합니다.
- 사회적 영향 : 저자들은 원치 않는 옷을 입힌 위조 이미지 같은 오용 가능성을 결론에서 언급합니다.
💡 Key Takeaway Ablation의 네 쌍 비교는 각각 하나의 설계 결정에 대응합니다. 패치 입력 → 형태, TSB → 텍스처, SSB → 마스크, 공간 적응 변조 → 정렬 오차 흡수. 어느 하나를 빼도 특정 종류의 실패가 재현됩니다.