 You know maize mean?
VITON-GAN: Virtual Try-on Image Generator Trained with Adversarial Loss
0. Summary
기본 정보 : ArXiv,2019.11.12 (Eurographics 2019 Posters), VITON-GAN: Virtual Try-on Image Generator Trained with Adversarial Loss
연구 배경
상점 의류 이미지와 다른 옷을 입은 모델 사진으로부터 가상 피팅 이미지를 만드는 문제는 신체와 옷의 형태가 매우 다양해 어렵다. VITON과 CP-VTON은 “의류 무관 사람 표현 → 옷 왜곡 → 합성”이라는 2D 파이프라인을 세웠고, 특히 CP-VTON은 기하 정합 모듈(GMM)과 트라이온 모듈(TOM)을 모두 학습 가능하게 만들어 옷의 세부를 잘 보존했다. 그러나 이들은 픽셀 L1 손실과 VGG 지각 손실만으로 학습되기 때문에, 정답에 없는 영역을 그럴듯하게 만들어 내야 하는 상황에서 약하다. 대표적인 경우가 폐색(occlusion) 이다. 모델이 팔짱을 끼거나 손이 옷 앞에 있으면 왜곡된 옷을 그대로 붙일 수 없고 네트워크가 팔과 손을 직접 그려야 하는데, 재구성 손실만으로는 흐릿하고 뭉개진 팔이 나온다.
제안 방법
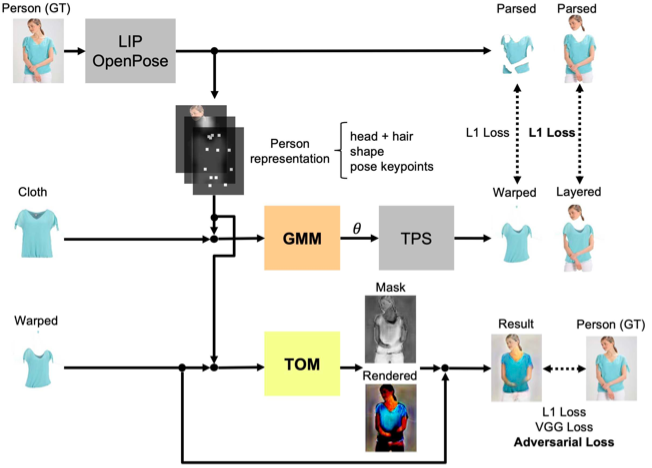
VITON-GAN은 CP-VTON의 GMM + TOM 2단계 구조를 그대로 두고 학습 신호만 바꾼다. 첫째, TOM을 판별기(discriminator)와 적대적으로 학습시킨다. 판별기는 TOM의 출력 이미지, 상점 옷 이미지, 사람 표현을 함께 입력받아 결과가 실제인지 생성인지 판정하는 조건부 판별기다. 둘째, GMM의 손실에 왜곡된 옷과 “몸 위에 실제로 입혀진 옷” 사이의 L1 거리를 포함해 왜곡이 신체 위의 최종 모습에 맞도록 한다. 셋째, 무작위 좌우 반전(horizontal flip) 데이터 증강을 추가한다. 사람 표현은 CP-VTON과 같은 사람 파서와 자세 추정기로 만든다.
발견 사실
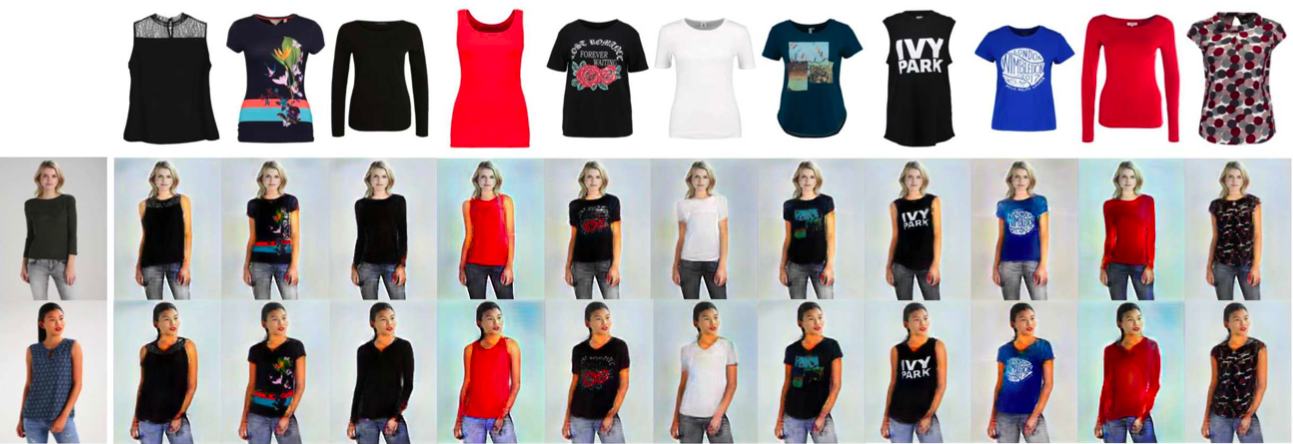
CP-VTON과 동일한 데이터셋(16,253쌍, 학습 13,221 / 검증 1,000 / 테스트 2,032)에서 정성적으로 비교한 결과, VITON-GAN은 팔짱을 끼는 등 옷이 가려진 경우에 손과 팔을 CP-VTON보다 선명하게 생성했다. 반면 두 종류의 실패가 남았다. 모델이 원래 반소매를 입고 있고 대상 옷이 긴소매인 경우 팔 생성이 실패하는데, 저자는 이를 TPS 변형이 위상(topology) 변화를 다루지 못하는 한계로 설명한다. 또한 일부 결과는 여전히 흐릿하게 나왔다. 논문은 2쪽 포스터로서 정량 지표나 사용자 평가는 보고하지 않는다.
핵심 기여
- TOM의 적대적 학습 : 재구성 손실만 쓰던 CP-VTON의 합성 단계에 조건부 판별기를 붙여, 폐색으로 인해 생성이 필요한 팔·손 영역의 선명도를 높였다(Sec. 2, Fig. 1–2).
- GMM 손실 보강과 증강 : 왜곡된 옷과 실제 착용 옷 사이의 L1 항, 좌우 반전 증강이라는 작은 변경으로 기존 파이프라인의 학습 신호를 강화했다(Sec. 2).
- TPS의 위상 한계 명시 : 반소매 → 긴소매처럼 위상이 바뀌는 피팅에서 실패가 체계적으로 발생함을 보이고, 변형 기반 접근의 근본 한계를 후속 과제로 제시했다(Sec. 3–4, Fig. 3).
관련 개념
토대: CP-VTON의 2단계 파이프라인
CP-VTON(Characteristic-Preserving VTON) 은 VITON-GAN이 그대로 물려받는 기반 구조입니다. VITON-GAN을 이해하려면 “무엇을 바꾸지 않았는지”를 먼저 알아야 합니다.
🧱 1. 두 모듈의 역할
| 모듈 | 입력 | 출력 | 학습 신호(CP-VTON) |
|---|---|---|---|
| GMM (Geometric Matching Module) | 사람 표현 $p$, 상점 옷 $c$ | TPS 파라미터 $\theta$, 왜곡된 옷 $\hat{c}=T_\theta(c)$ | $|\hat{c}-c_t|_1$ ($c_t$ 는 사람 위 실제 옷 영역) |
| TOM (Try-On Module) | $p$, $\hat{c}$ | 렌더링된 사람 $I_r$, 합성 마스크 $M$ | $\lambda_{L1}|I_o-I_t|1+\lambda{vgg}L_{VGG}+\lambda_{mask}|1-M|_1$ |
최종 출력은 $I_o = M\odot\hat{c} + (1-M)\odot I_r$ 입니다. 마스크가 1인 곳은 왜곡된 옷을 복사하고, 0인 곳은 네트워크가 그린 $I_r$ 을 씁니다.
🧍 2. 사람 표현
VITON-GAN은 CP-VTON과 같은 사람 파서와 자세 추정기를 써서 사람 표현을 만듭니다. 자세 히트맵, 흐린 체형 마스크, 얼굴·머리 RGB로 구성되며 원래 입고 있던 옷의 정보는 제거됩니다. 이 표현 덕분에 “같은 사람이 같은 옷을 입은 사진” 한 장만으로 자기 지도 재구성 학습이 가능합니다.
🔍 3. 어디가 약한가
CP-VTON의 두 손실은 모두 정답 이미지와의 거리입니다. 옷 영역은 $\hat{c}$ 를 복사하면 되므로 거리 손실로 충분하지만, 팔이 옷 앞을 가리는 영역은 $M\to0$ 이 되어 $I_r$ 이 그대로 노출됩니다. 이때 $I_r$ 은 U-Net이 L1 + VGG 손실로 그린 것이라 평균적이고 흐릿합니다. 즉 폐색 영역의 품질은 전적으로 생성기의 “그리기” 능력에 달려 있는데, CP-VTON은 그 능력을 키울 손실을 갖고 있지 않습니다.
💡 Key Takeaway CP-VTON은 “복사”는 잘하지만 “그리기”는 약합니다. VITON-GAN은 복사 메커니즘(GMM, 마스크)은 유지한 채, 그리기가 필요한 영역의 품질을 올리는 손실을 추가하는 최소 변경을 택합니다.
적대적 손실과 조건부 판별기
적대적 손실(adversarial loss) 은 생성 결과가 실제 데이터 분포에서 왔는지 판별하는 네트워크를 함께 학습시켜, 생성기가 “평균적으로 맞는” 결과가 아니라 “실제처럼 보이는” 결과를 내도록 밀어붙이는 학습 신호입니다.
⚔️ 1. 왜 재구성 손실만으로는 흐려지는가
| 손실 | 최적해의 성격 | 결과 |
|---|---|---|
| 픽셀 L1/L2 | 가능한 정답들의 중앙값/평균 | 불확실한 영역(가려진 팔의 정확한 위치·질감)에서 평균화 → 흐림 |
| VGG 지각 손실 | 특징 공간에서의 평균 | 구조는 유지되지만 고주파 세부는 여전히 평균화 |
| 적대적 손실 | 실제 분포 위의 한 표본 | 날카롭고 그럴듯한 세부. 단, 정답과 픽셀 단위로 같을 필요는 없음 |
팔의 정확한 윤곽과 손가락 모양은 사람 표현(자세 히트맵)만으로는 결정되지 않는 불확실한 정보입니다. 거리 손실은 이 불확실성을 평균으로 해소해 뭉개진 팔을 만들고, 적대적 손실은 “어떤 팔이든 진짜 같은 팔”을 요구해 선명하게 만듭니다.
🎯 2. VITON-GAN의 조건부 판별기 (Fig. 1)
판별기 $D$ 는 세 가지를 함께 입력받습니다.
- TOM의 결과 이미지(또는 실제 사람 이미지)
- 상점 옷 이미지
- 사람 표현
옷과 사람 표현을 조건으로 넣는 이유는 “그럴듯한 사람 사진”이 아니라 “이 사람이 이 옷을 입은 그럴듯한 사진”인지를 판정하게 하기 위해서입니다. 조건이 없으면 생성기는 입력과 무관하게 진짜 같은 이미지를 만드는 쪽으로 빠질 수 있습니다. 이는 pix2pix 류 조건부 GAN의 표준 설계이며, 논문은 판별기의 구체적 구조와 손실 형태, 가중치는 명시하지 않습니다.
⚖️ 3. 재구성 손실과의 공존
적대적 손실만 쓰면 옷의 텍스처·로고가 변질될 위험이 있습니다. VITON-GAN은 CP-VTON의 L1 + VGG + 마스크 손실을 유지한 채 적대적 항을 추가합니다. 역할 분담은 다음과 같습니다.
- 옷 영역: 마스크가 $\hat{c}$ 를 복사하므로 재구성 손실이 지배. 적대적 손실은 경계의 이음새를 자연스럽게 만드는 데 기여.
- 폐색 영역(팔·손): $I_r$ 이 노출되므로 적대적 손실이 선명도를 결정.
🧮 4. 적대적 손실의 일반적 형태와 재현 시 선택지
논문은 손실의 구체적 형태를 쓰지 않으므로, 재현하려면 조건부 GAN 문헌의 표준 선택지 중 하나를 골라야 합니다. 조건 $x=(c,p)$, TOM 출력 $I_o$, 실제 이미지 $I_t$ 에 대해 대표적 형태는 다음과 같습니다.
| 형태 | 판별기 목적 | 생성기 목적 | 특징 |
|---|---|---|---|
| 표준(BCE) | $\max_D\ \mathbb{E}[\log D(I_t,x)] + \mathbb{E}[\log(1-D(I_o,x))]$ | $\min_G -\mathbb{E}[\log D(I_o,x)]$ | pix2pix 기본. 포화 시 그라디언트 소실 |
| LSGAN | $\min_D\ \mathbb{E}[(D(I_t,x)-1)^2] + \mathbb{E}[D(I_o,x)^2]$ | $\min_G\ \mathbb{E}[(D(I_o,x)-1)^2]$ | 안정적, 이미지 변환에서 흔함 |
| Hinge | $\min_D\ \mathbb{E}[\max(0,1-D(I_t,x))] + \mathbb{E}[\max(0,1+D(I_o,x))]$ | $\min_G -\mathbb{E}[D(I_o,x)]$ | SAGAN·BigGAN 계열 |
전체 TOM 손실은 CP-VTON 항에 적대적 항을 가중합한 형태가 됩니다.
\[L_{TOM}^{GAN} = \lambda_{L1}\|I_o-I_t\|_1 + \lambda_{vgg}L_{VGG}(I_o,I_t) + \lambda_{mask}\|1-M\|_1 + \lambda_{adv}L_{adv}(G,D)\]재현 시 실무적으로 고려할 점은 다음과 같습니다.
- $\lambda_{adv}$ 의 크기 : 너무 크면 옷의 텍스처가 판별기를 속이기 위한 방향으로 변질되고, 너무 작으면 흐림 개선이 없습니다. pix2pix 류에서는 재구성 항 대비 1/10에서 1/100 수준이 흔합니다.
- 판별기의 수용 영역 : 전체 이미지를 한 번에 판정하는 전역 판별기보다 패치 단위(PatchGAN) 판별기가 국소 선명도를 높이는 데 유리하며, 폐색된 팔·손은 국소 영역이므로 PatchGAN이 자연스러운 선택입니다.
- 조건 입력의 정렬 : 판별기에 들어가는 사람 표현 $p$ 와 옷 $c$ 는 출력과 같은 해상도로 채널 결합됩니다. 사람 표현은 22채널이므로 판별기 입력은 $3+3+22=28$ 채널이 됩니다.
- GMM 고정 여부 : CP-VTON처럼 GMM을 먼저 학습해 고정하고 TOM만 적대적으로 학습하는 것이 안정적입니다. 둘을 동시에 적대적으로 학습하면 왜곡이 판별기 신호에 끌려 불안정해질 수 있습니다.
이 선택들은 논문에 없는 구현 세부이므로, 결과를 재현하지 못했을 때 어느 선택이 원인인지 분리하기 어렵다는 점을 염두에 두어야 합니다.
💡 Key Takeaway 조건부 판별기는 “이 옷을 입은 이 사람”이라는 맥락 안에서 사실성을 요구합니다. 그 덕분에 옷은 복사로 보존하고, 가려진 신체는 적대적으로 생성하는 분업이 성립합니다. 손실의 구체적 형태와 가중치는 논문에 없으므로 재현 시 표준 선택지 중에서 골라야 합니다.
GMM 손실 보강과 데이터 증강
두 번째·세 번째 변경은 왜곡 모듈과 데이터 쪽의 작은 개선입니다. 적대적 손실만큼 눈에 띄지는 않지만, 2단계 파이프라인에서 1단계의 품질이 2단계를 제한한다는 점에서 의미가 있습니다.
📐 1. GMM 손실: 몸 위의 옷과 맞추기
CP-VTON의 GMM은 왜곡된 옷 $\hat{c}$ 와 사람 이미지에서 파싱한 옷 영역 $c_t$ 사이의 L1로 학습됩니다. VITON-GAN은 여기에 “생성된 옷을 몸 위에 겹친(layered) 이미지”와 “실제 옷이 몸 위에 있는 이미지” 사이의 L1 거리를 포함한다고 기술합니다. 즉 옷 조각 단독이 아니라 신체 맥락 위에서의 일치를 추가로 요구해, 왜곡이 최종 합성 결과에 더 적합하도록 유도합니다.
🔄 2. 좌우 반전 증강
| 항목 | 내용 |
|---|---|
| 방법 | 학습 쌍을 무작위로 좌우 반전 |
| 전제 | 정면 사진과 상의는 대체로 좌우 대칭이므로 반전해도 유효한 표본 |
| 기대 효과 | 14K 수준의 학습 데이터에서 자세·팔 위치의 다양성 확대, 특정 방향 자세 과적합 완화 |
반전 시 자세 히트맵의 좌/우 관절 채널도 함께 바꿔야 한다는 점에 주의해야 합니다. 그렇지 않으면 “오른팔 채널에 왼팔 위치”가 들어가 표현이 손상됩니다. 논문은 이 세부를 다루지 않지만 구현 시 필수입니다.
📦 3. 데이터셋 분할
| 분할 | 쌍 수 |
|---|---|
| 학습 | 13,221 |
| 검증 | 1,000 |
| 테스트 | 2,032 |
| 합계 | 16,253 |
CP-VTON과 같은 데이터이지만 학습 14,221에서 1,000쌍을 검증용으로 떼어 낸 점이 다릅니다. 모든 결과 이미지는 테스트 셋에서 나온 것입니다.
💡 Key Takeaway 적대적 손실은 폐색 영역을, GMM 손실 보강은 왜곡 품질을, 반전 증강은 데이터 다양성을 각각 겨냥합니다. 세 변경은 모두 CP-VTON 구조를 전혀 바꾸지 않고 적용할 수 있습니다.
폐색(Occlusion) 문제와 생성 결과
폐색은 팔·손·머리카락이 옷 앞에 놓여 왜곡된 옷을 그대로 붙일 수 없는 상황입니다. 가상 피팅에서 가장 흔한 실패 원인 중 하나이며, VITON-GAN이 개선을 주장하는 핵심 시나리오입니다.
🖼️ 1. 성공 사례 (Fig. 2)
왼쪽 열의 모델이 맨 윗줄의 옷을 입은 결과입니다. 팔짱을 끼거나 손이 몸 앞에 있는 자세에서 VITON-GAN은 손과 팔을 CP-VTON보다 선명하게 그립니다. 폐색 영역에서는 합성 마스크가 0에 가까워 렌더링 결과가 그대로 보이므로, 이 영역의 품질 차이는 곧 TOM 생성기의 품질 차이이고 그것이 적대적 손실의 효과입니다.
🧩 2. 왜 폐색이 유독 어려운가
| 영역 | 정보원 | 난이도 |
|---|---|---|
| 몸통 위 옷 | 왜곡된 옷 $\hat{c}$ 복사 | 낮음 (왜곡만 맞으면 됨) |
| 얼굴·머리 | 사람 표현의 RGB 채널 복사 | 낮음 |
| 옷에 가려지지 않은 팔 | 자세 히트맵 + 피부색 추론 | 중간 |
| 옷 앞의 팔·손 | 자세 히트맵만. 옷과의 전후 관계, 손가락 모양을 생성해야 함 | 높음 |
마지막 경우에는 “옷이 팔 뒤로 가려진다”는 깊이 순서까지 추론해야 합니다. 사람 표현에는 깊이 정보가 없으므로 네트워크는 학습 데이터의 통계로 이를 배워야 하고, 적대적 손실은 그 통계에서 벗어난 비현실적 조합(옷이 팔을 뚫고 나오는 등)을 벌합니다.
🔧 3. 후속 연구의 폐색 처리
- ACGPN은 대상 옷에 맞는 분할 맵을 먼저 생성해 팔·옷의 영역을 명시적으로 정한 뒤 합성합니다.
- VITON-HD, HR-VITON은 분할 맵과 왜곡된 옷 사이의 정렬 오차 영역을 정규화 단계에서 명시적으로 처리합니다.
- 비쌍 설정의 PASTA-GAN은 왜곡된 옷에서 가려진 부분을 무작위로 지우는 증강으로 폐색을 흉내 냅니다.
🧭 4. 결과를 읽을 때의 주의
정성 비교만 있는 논문을 읽을 때는 세 가지를 구분해야 합니다.
- 선별 편향 : Fig. 2는 성공 사례, Fig. 3은 실패 사례로 저자가 고른 것입니다. 테스트 셋 2,032쌍 전체에서 개선 비율이 얼마인지는 알 수 없습니다.
- 원인 귀속 : 세 변경(적대적 손실, GMM 손실 보강, 반전 증강)이 동시에 적용되었으므로, 팔·손 개선이 적대적 손실 때문인지 데이터 증강 때문인지 분리되지 않습니다. 제목과 서술은 적대적 손실을 전면에 두지만 이는 저자의 해석입니다.
- 지표의 부재 : 같은 시기 가상 피팅 논문들은 IS의 부적합성을 인정하면서도 사용자 평가나 SSIM(쌍 설정)을 보고했습니다. 이 논문은 둘 다 없으므로, 이후 연구에서 VITON-GAN이 정량 비교의 기준선으로 거의 인용되지 않는 이유이기도 합니다.
이런 한계에도 “폐색 영역에 적대적 손실이 효과적”이라는 관찰 자체는 이후 ACGPN, VITON-HD 등 대부분의 가상 피팅 모델이 적대적 손실을 기본으로 채택하면서 간접적으로 확인되었습니다.
💡 Key Takeaway 폐색 영역은 가상 피팅에서 “복사”가 불가능한 유일한 큰 영역이며, 따라서 생성기의 진짜 실력이 드러나는 곳입니다. 적대적 손실은 이 영역에서 가장 효과적이고, 후속 연구는 분할 맵으로 이 영역을 사전에 정의하는 방향으로 발전했습니다.
실패 사례와 TPS의 위상 한계
실패 사례는 이 짧은 논문에서 가장 정보량이 큰 부분입니다. 저자는 두 종류의 실패를 보고하고 그중 하나의 원인을 변형 모델의 구조적 한계로 지목합니다.
❌ 1. 두 가지 실패 (Fig. 3)
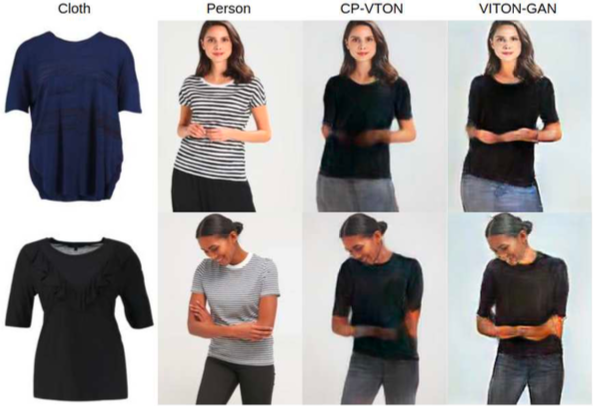
| 실패 | 상황 | 원인(저자 해석) |
|---|---|---|
| 팔 생성 실패 (윗줄) | 모델은 반소매, 대상 옷은 긴소매 | TPS 변형이 위상 변화를 다루지 못함 |
| 흐릿한 출력 (아랫줄) | 특정 입력에서 전반적으로 흐림 | 명시적 원인 없음. 적대적 학습이 모든 경우를 해소하지는 못함 |
📐 2. 위상(topology) 변화란 무엇인가
TPS는 제어점 사이를 굽힘 에너지가 최소가 되도록 매끄럽게 보간하는 연속 변형입니다. 연속 변형은 평면을 늘리고 휠 수는 있지만 찢거나 구멍을 내거나 새 영역을 만들 수는 없습니다.
- 반소매 → 긴소매: 원래 노출된 팔 영역이 옷으로 덮여야 하므로, 옷 이미지에 “팔을 덮는 소매”가 있더라도 사람 표현의 체형 마스크에는 긴소매 영역이 없습니다. GMM은 대상 형태를 알 수 없어 소매를 팔 길이만큼 늘리지 못하고, TOM은 소매가 있어야 할 자리에 맨팔을 그릴지 소매를 그릴지 혼란을 겪습니다.
- 긴소매 → 반소매: 반대로 원래 옷의 소매 윤곽이 체형 마스크에 남아 잔상이 생깁니다(CP-VTON이 보고한 실패와 같은 종류).
두 경우 모두 “옷이 덮는 영역의 위상“이 바뀌는 상황이고, 연속 변형 + 복사 패러다임으로는 원리적으로 풀리지 않습니다.
🧭 3. 후속 연구의 해법
| 접근 | 아이디어 |
|---|---|
| 분할 맵 생성 (ACGPN, VITON-HD) | 대상 옷을 입었을 때의 의미 분할 맵을 먼저 예측해 소매가 어디까지 덮을지 명시적으로 결정 |
| 외형 흐름 (ClothFlow, PF-AFN) | TPS 대신 픽셀 단위 흐름으로 더 자유로운 변형. 여전히 연속이지만 국소 자유도가 큼 |
| 패치 기반 비쌍 전이 (PASTA-GAN) | 옷을 신체 부위별 패치로 나눠 각각 정규화·재배치해 전신 위상 변화에 대응 |
| 확산 모델 (TryOnDiffusion 등) | 변형을 명시하지 않고 조건부 생성으로 옷과 신체를 함께 합성 |
💡 Key Takeaway “TPS는 위상 변화를 다루지 못한다”는 한 문장이 이 논문의 가장 큰 유산입니다. 변형 기반 가상 피팅의 천장을 명확히 짚었고, 이후 연구는 변형 전에 레이아웃을 생성하거나 변형 자체를 생성으로 대체하는 길로 갔습니다.
한계와 열린 방향
이 논문의 한계는 포스터 형식에서 오는 것과 방법 자체에서 오는 것으로 나뉩니다.
📉 1. 평가의 부재
- FID, SSIM, LPIPS 같은 정량 지표가 없고 사용자 평가도 없습니다. 개선 주장은 선별된 정성 예시(Fig. 2–3)에 의존합니다.
- 판별기 구조, 적대적 손실의 형태(vanilla, LSGAN, hinge 등), 손실 가중치, 학습 스텝 수가 명시되지 않아 재현이 어렵습니다.
- GMM 손실 보강과 반전 증강 각각의 기여를 분리한 ablation이 없습니다.
🧩 2. 방법의 한계
- 적대적 학습은 흐림을 줄이지만 없애지는 못합니다(Fig. 3 아랫줄). 재구성 손실과의 가중치 균형, 판별기 용량에 따라 결과가 크게 달라질 수 있습니다.
- 위상 변화 실패는 그대로 남습니다. 적대적 손실은 “무엇을 그릴지”의 모호함을 해결하지 못하기 때문입니다.
- $256\times192$ 해상도, 정면 여성 상의라는 데이터 제약을 그대로 물려받습니다.
🚀 3. 저자가 제시한 향후 과제
- 생성된 신체 부위(팔·손)의 품질을 더 높이는 것.
- 옷의 위상 변화를 다루는 것.
둘 다 이후 수년간 가상 피팅 연구의 중심 주제가 되었습니다. 전자는 고해상도 모델과 확산 모델로, 후자는 분할 맵 생성과 패치 기반 표현으로 진전이 있었습니다.
💡 Key Takeaway VITON-GAN은 “CP-VTON에 적대적 손실을 더하면 폐색 영역이 좋아진다”는 작지만 명확한 관찰과, “TPS로는 위상 변화를 못 푼다”는 한계 진단을 남겼습니다. 정량 근거가 없다는 점을 감안하고 읽되, 두 메시지는 이후 연구 흐름과 정확히 맞아떨어집니다.