 You know maize mean?
Controllable Person Image Synthesis with Attribute-Decomposed GAN
0. Summary
기본 정보 : ArXiv,2020.03.27 (CVPR 2020 Oral), Controllable Person Image Synthesis with Attribute-Decomposed GAN
연구 배경
인물 이미지 합성(person image synthesis)은 주어진 사람을 다른 포즈로 그리는 포즈 전이(pose transfer)를 중심으로 발전해 왔다. PG2, DPIG, Def-GAN, PATN 같은 방법은 소스 이미지와 목표 포즈를 U-Net 류 생성기에 직접 넣어 목표 이미지를 감독으로 학습하는데, 이렇게 하면 소스 사람의 외형이 하나의 뒤엉킨 표현으로 들어가 머리, 윗옷, 바지 같은 구성요소 속성(component attribute)을 개별적으로 제어할 수 없다. 한편 속성 편집 연구는 각 속성에 대한 이진 레이블이 달린 데이터를 요구해, 레이블 비용이 크고 레이블이 없는 속성은 다루지 못한다. 즉 레이블 없이 사람의 속성을 독립적인 잠재 코드로 분해하고, 이를 섞거나 보간해 포즈와 구성요소 속성을 동시에 제어하는 생성기가 비어 있었다.
제안 방법
Attribute-Decomposed GAN(ADGAN) 은 사람의 속성을 잠재 공간의 독립적인 코드로 임베딩해, 명시적 스타일 표현의 혼합·보간으로 속성을 유연하고 연속적으로 제어한다. 생성기는 두 개의 인코딩 경로와 이를 잇는 스타일 블록으로 구성된다. 포즈 경로는 18채널 키포인트 히트맵을 포즈 코드 $C_{pose}$ 로 인코딩하고, 소스 경로는 기성 인간 파서(human parser)로 얻은 의미 맵을 $K=8$ 개 구성요소 마스크로 바꿔 소스 이미지를 구성요소별로 분해한 뒤, 공유 전역 텍스처 인코더 $T_{enc}$ (학습 가능 인코더 + 고정 VGG 인코더)로 각 구성요소의 스타일 코드 $C_{sty}^{i}$ 를 얻어 정해진 순서로 이어 붙여 전체 스타일 코드 $C_{sty}$ 를 만든다. 8개의 캐스케이드 스타일 블록은 융합 모듈(FM)이 $C_{sty}$ 에서 뽑은 AdaIN 파라미터로 포즈 특징에 텍스처 스타일을 주입하고, 디코더가 목표 이미지를 복원한다. 포즈 정렬용 $D_p$ 와 텍스처 유사성용 $D_t$ 두 PatchGAN 판별기와 함께 적대 손실, L1 재구성 손실, VGG 지각 손실, 문맥 손실(contextual loss)로 학습한다.
발견 사실
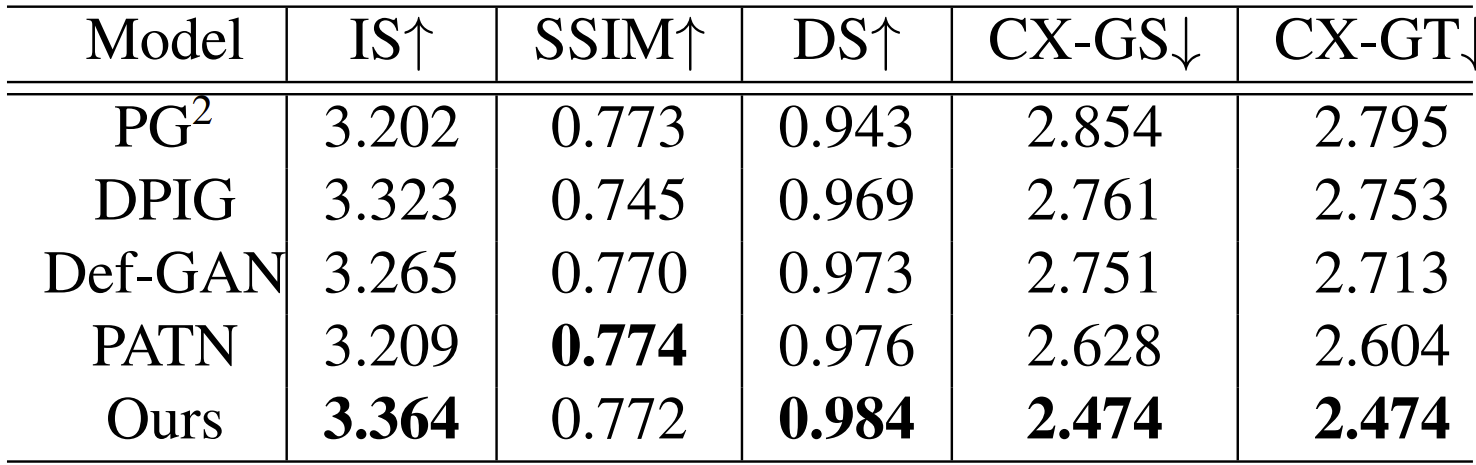
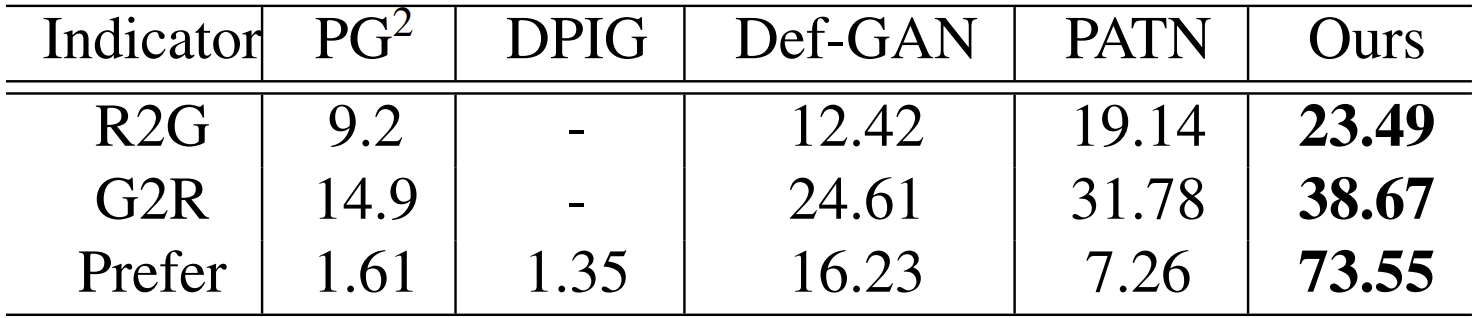
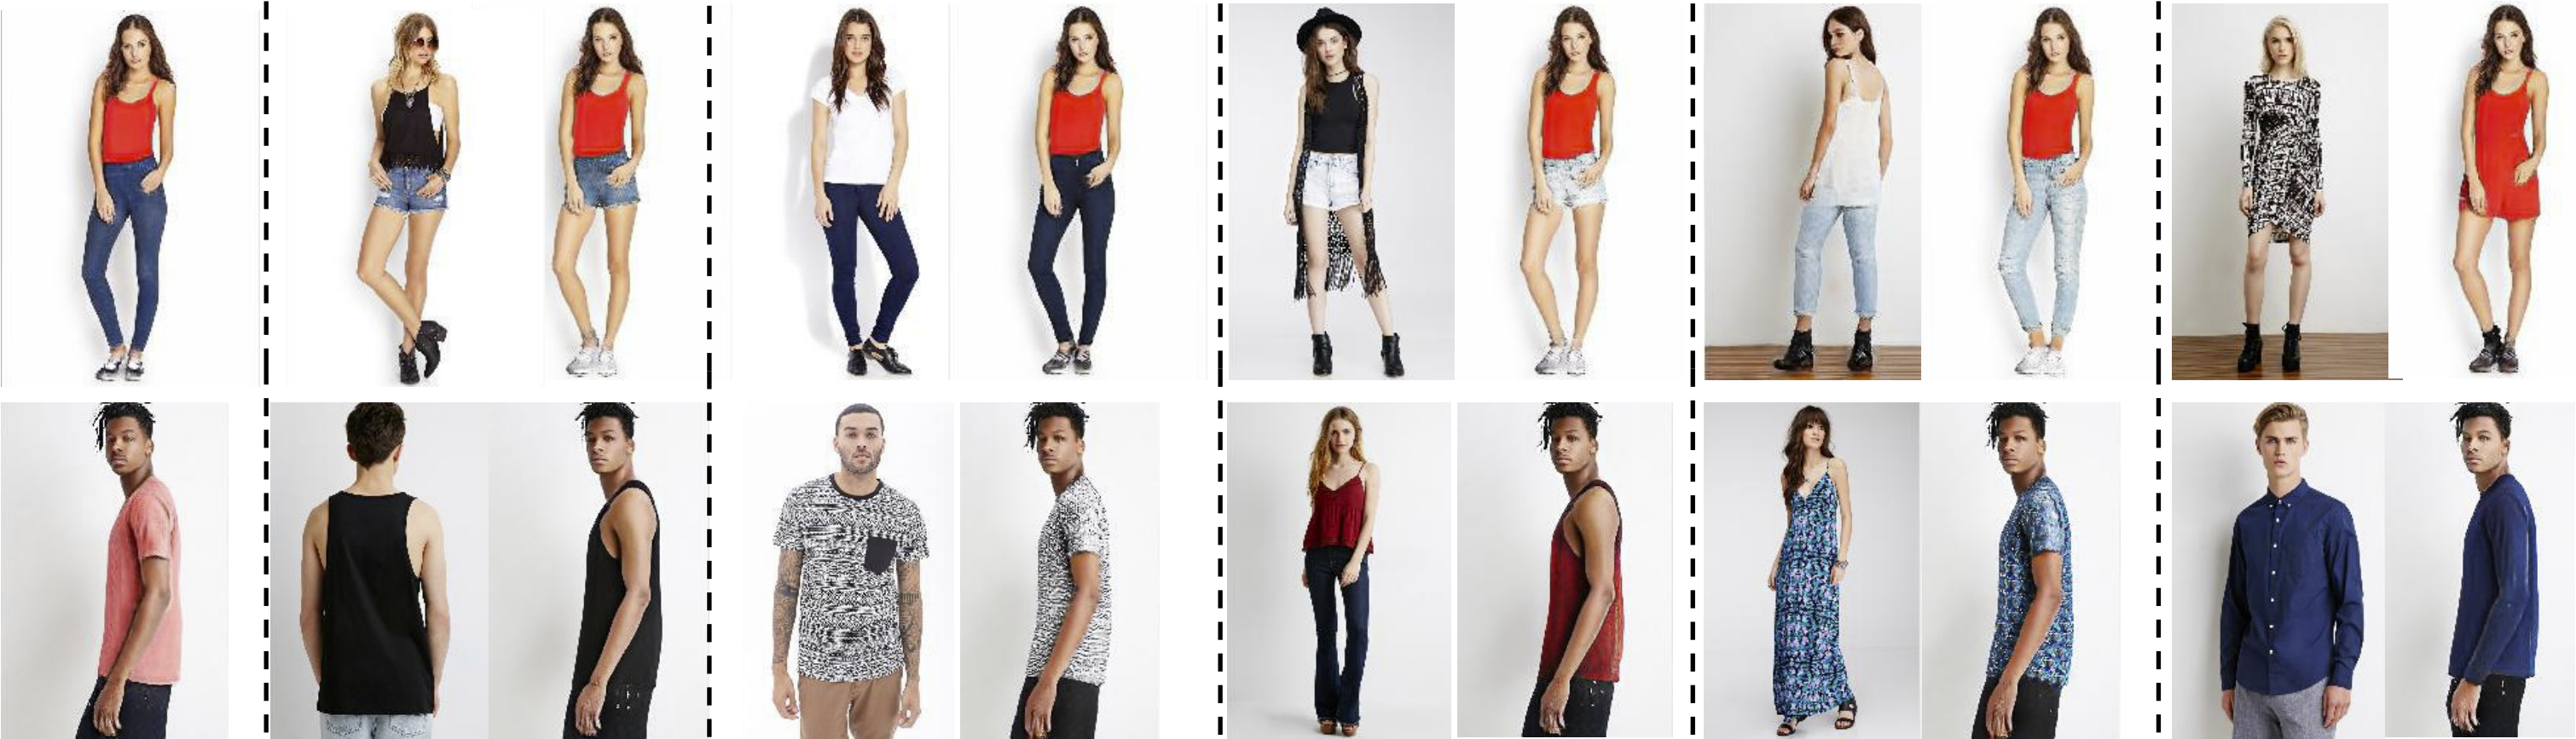
DeepFashion In-shop 벤치마크(학습 101,966쌍, 테스트 8,750쌍, $256\times256$)에서 ADGAN은 IS 3.364, DS 0.984, CX-GS 2.474, CX-GT 2.474 로 비교 대상 네 방법 중 가장 높은 IS·DS 와 가장 낮은 문맥 거리를 기록했고, SSIM 은 0.772 로 PATN(0.774)과 거의 같았다(Table 1). 사용자 연구에서는 생성 이미지가 실제로 판정된 비율 G2R 38.67%, 가장 사실적인 결과로 선택된 비율 73.55% 로 다른 방법(최대 16.23%)을 크게 앞섰다(Table 2). 분해 구성요소 인코딩(DCE)은 수렴을 빠르게 하고(Fig. 5) 레이블 없이 속성을 자동 분리하며, 전역 텍스처 인코딩(GTE)은 야생 텍스처에 대한 일반화를 높였다(Fig. 4). 융합 모듈 없이 DCE만 쓰면 오히려 DCE 없는 모델보다 나빠지는 반면 FM을 더하면 제대로 작동했다(Fig. 6). 구성요소 속성 전이(윗옷·바지 교체, Fig. 10)와 스타일 보간이 가능했으나, 학습 다양체에서 크게 벗어난 희귀 패턴·포즈는 실패했다(Fig. 11).
핵심 기여
- 속성 분해 생성기 구조 : 포즈 경로와 소스 경로를 분리하고 스타일 블록으로 연결해, 원래의 어려운 단일 사상을 여러 접근 가능한 부분 과제로 분해했다. 그 결과 포즈 전이에서 당시 최고 성능을 달성했다.
- 분해 구성요소 인코딩(DCE)과 전역 텍스처 인코딩(GTE) : 기성 인간 파서로 공간 분해를 수행하고 공유 텍스처 인코더로 각 구성요소를 인코딩해, 속성 레이블 없이 스타일 코드의 고정 위치에 속성이 자동 분리되도록 했다. 고정 VGG 특징을 결합해 야생 텍스처 일반화도 확보했다.
- 구성요소 속성 전이라는 새 과제 : 서로 다른 사람에게서 뽑은 구성요소 코드를 섞어 윗옷·바지 등을 교체하고, 코드 선형 보간으로 속성 간 연속 애니메이션을 만드는 component attribute transfer 를 제시하고 그 효과를 보였다.
관련 개념
문제 설정: 제어 가능한 인물 이미지 합성
제어 가능한 인물 이미지 합성은 포즈, 머리, 윗옷, 바지 같은 사용자 지정 속성을 가진 고품질 인물 이미지를 만드는 과제입니다. 이 논문은 속성별 이진 레이블 없이, 여러 포즈의 인물 이미지 데이터셋만으로 구성요소 속성의 자동·비지도 분리를 달성하고자 합니다.
🎯 1. 입력과 출력 (Section 3)
| 기호 | 의미 |
|---|---|
| $I\in\mathbb{R}^{3\times H\times W}$ | 인물 이미지 |
| $P\in\mathbb{R}^{18\times H\times W}$ | 18개 관절 위치를 인코딩한 키포인트 히트맵. 기성 포즈 추정기로 자동 추출 |
| $I_s,\ P_t,\ I_t$ | 소스 인물 이미지, 목표 포즈, 목표 포즈의 실제 이미지(학습 감독) |
| $I_g=G(I_s,P_t)$ | 생성 이미지. $I_s$ 의 외형을 가지면서 $P_t$ 포즈 |
학습 시 생성기는 $(I_s,P_t)$ 를 받아 $I_g$ 를 만들고, 판별기는 $I_g$ 가 $P_t$ 포즈에서 사실적인지 도전합니다.
🧩 2. 기존 접근과의 차이
| 접근 | 방식 | 한계 |
|---|---|---|
| PG2, PATN 등 포즈 전이 | 소스 이미지와 목표 조건을 연결해 U-Net 류에 입력, 목표 이미지로 감독 | 외형이 뒤엉켜 구성요소별 제어 불가 |
| 속성 편집(StarGAN 류) | 속성별 이진 레이블로 조건화 | 레이블 비용, 레이블 없는 속성 불가 |
| ADGAN | 사람을 구성요소로 분해해 독립 코드로 임베딩 | 레이블 불필요, 포즈·구성요소 동시 제어 |
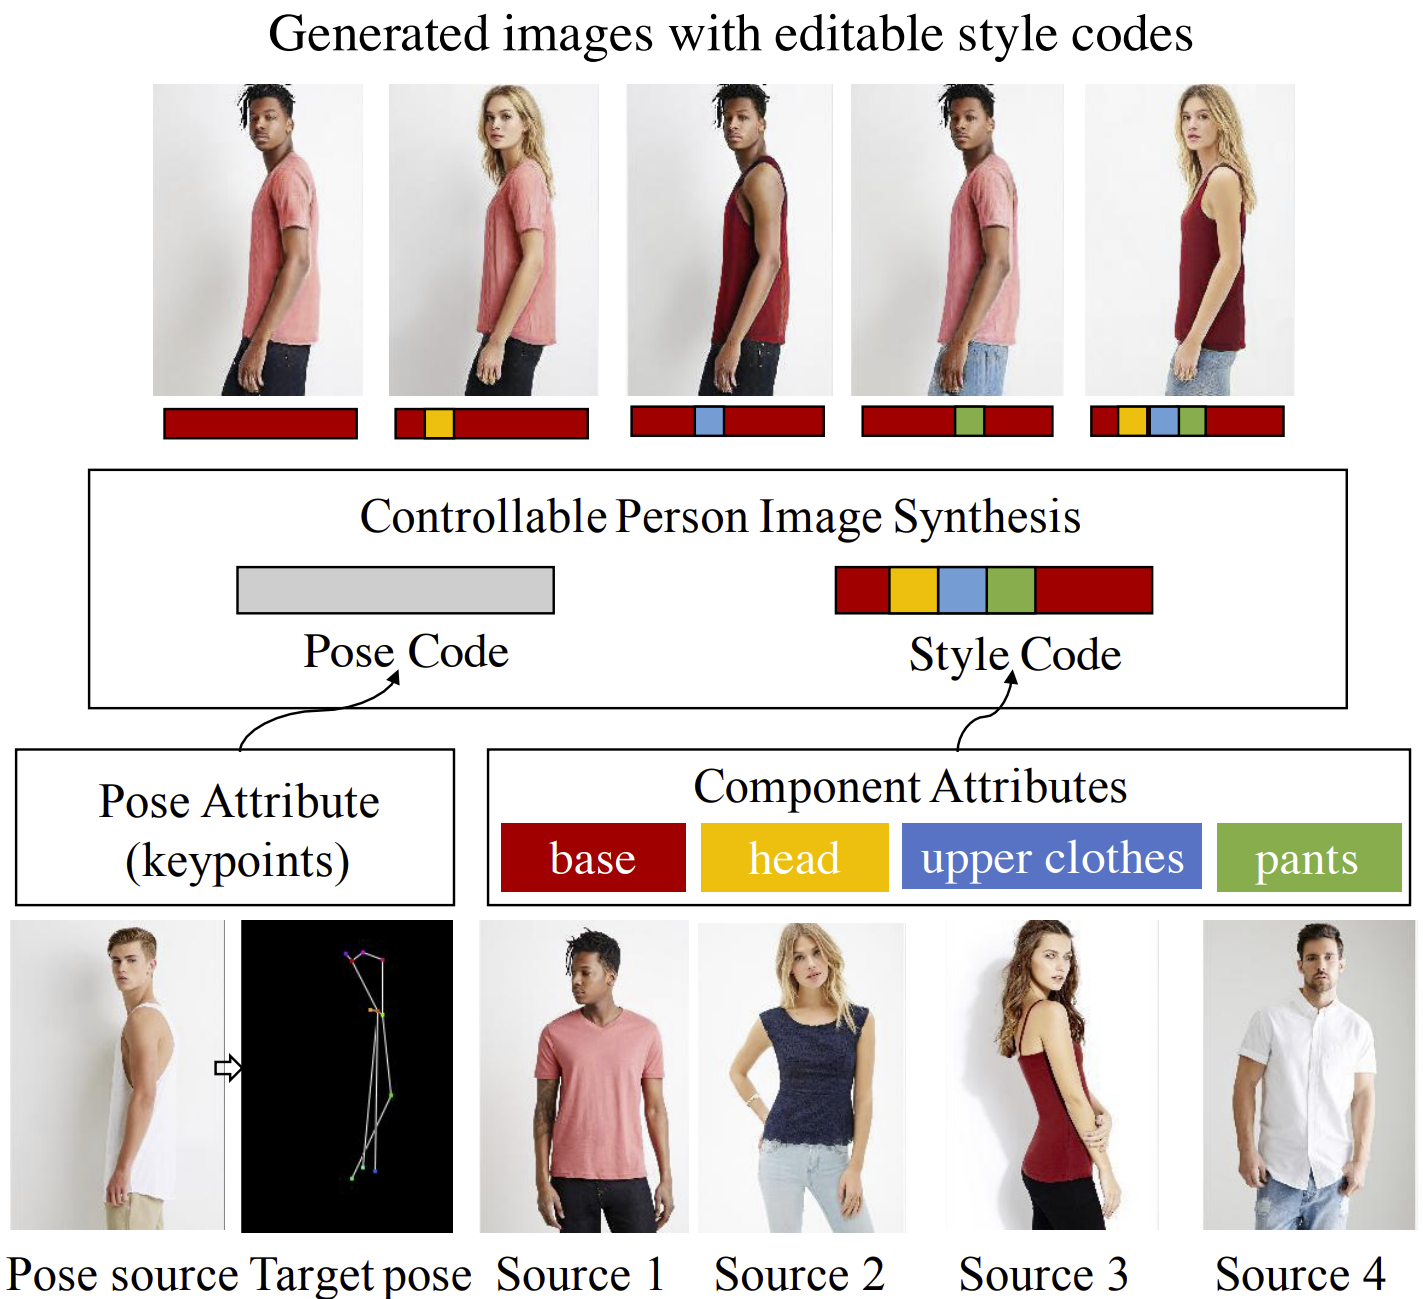
💡 Key Takeaway ADGAN의 목표는 “포즈 전이”가 아니라 포즈와 구성요소 속성을 각각 독립적으로 제어하는 것이며, 그 열쇠는 레이블 대신 공간 분해를 쓰는 것입니다.
생성기 구조: 두 경로와 스타일 블록
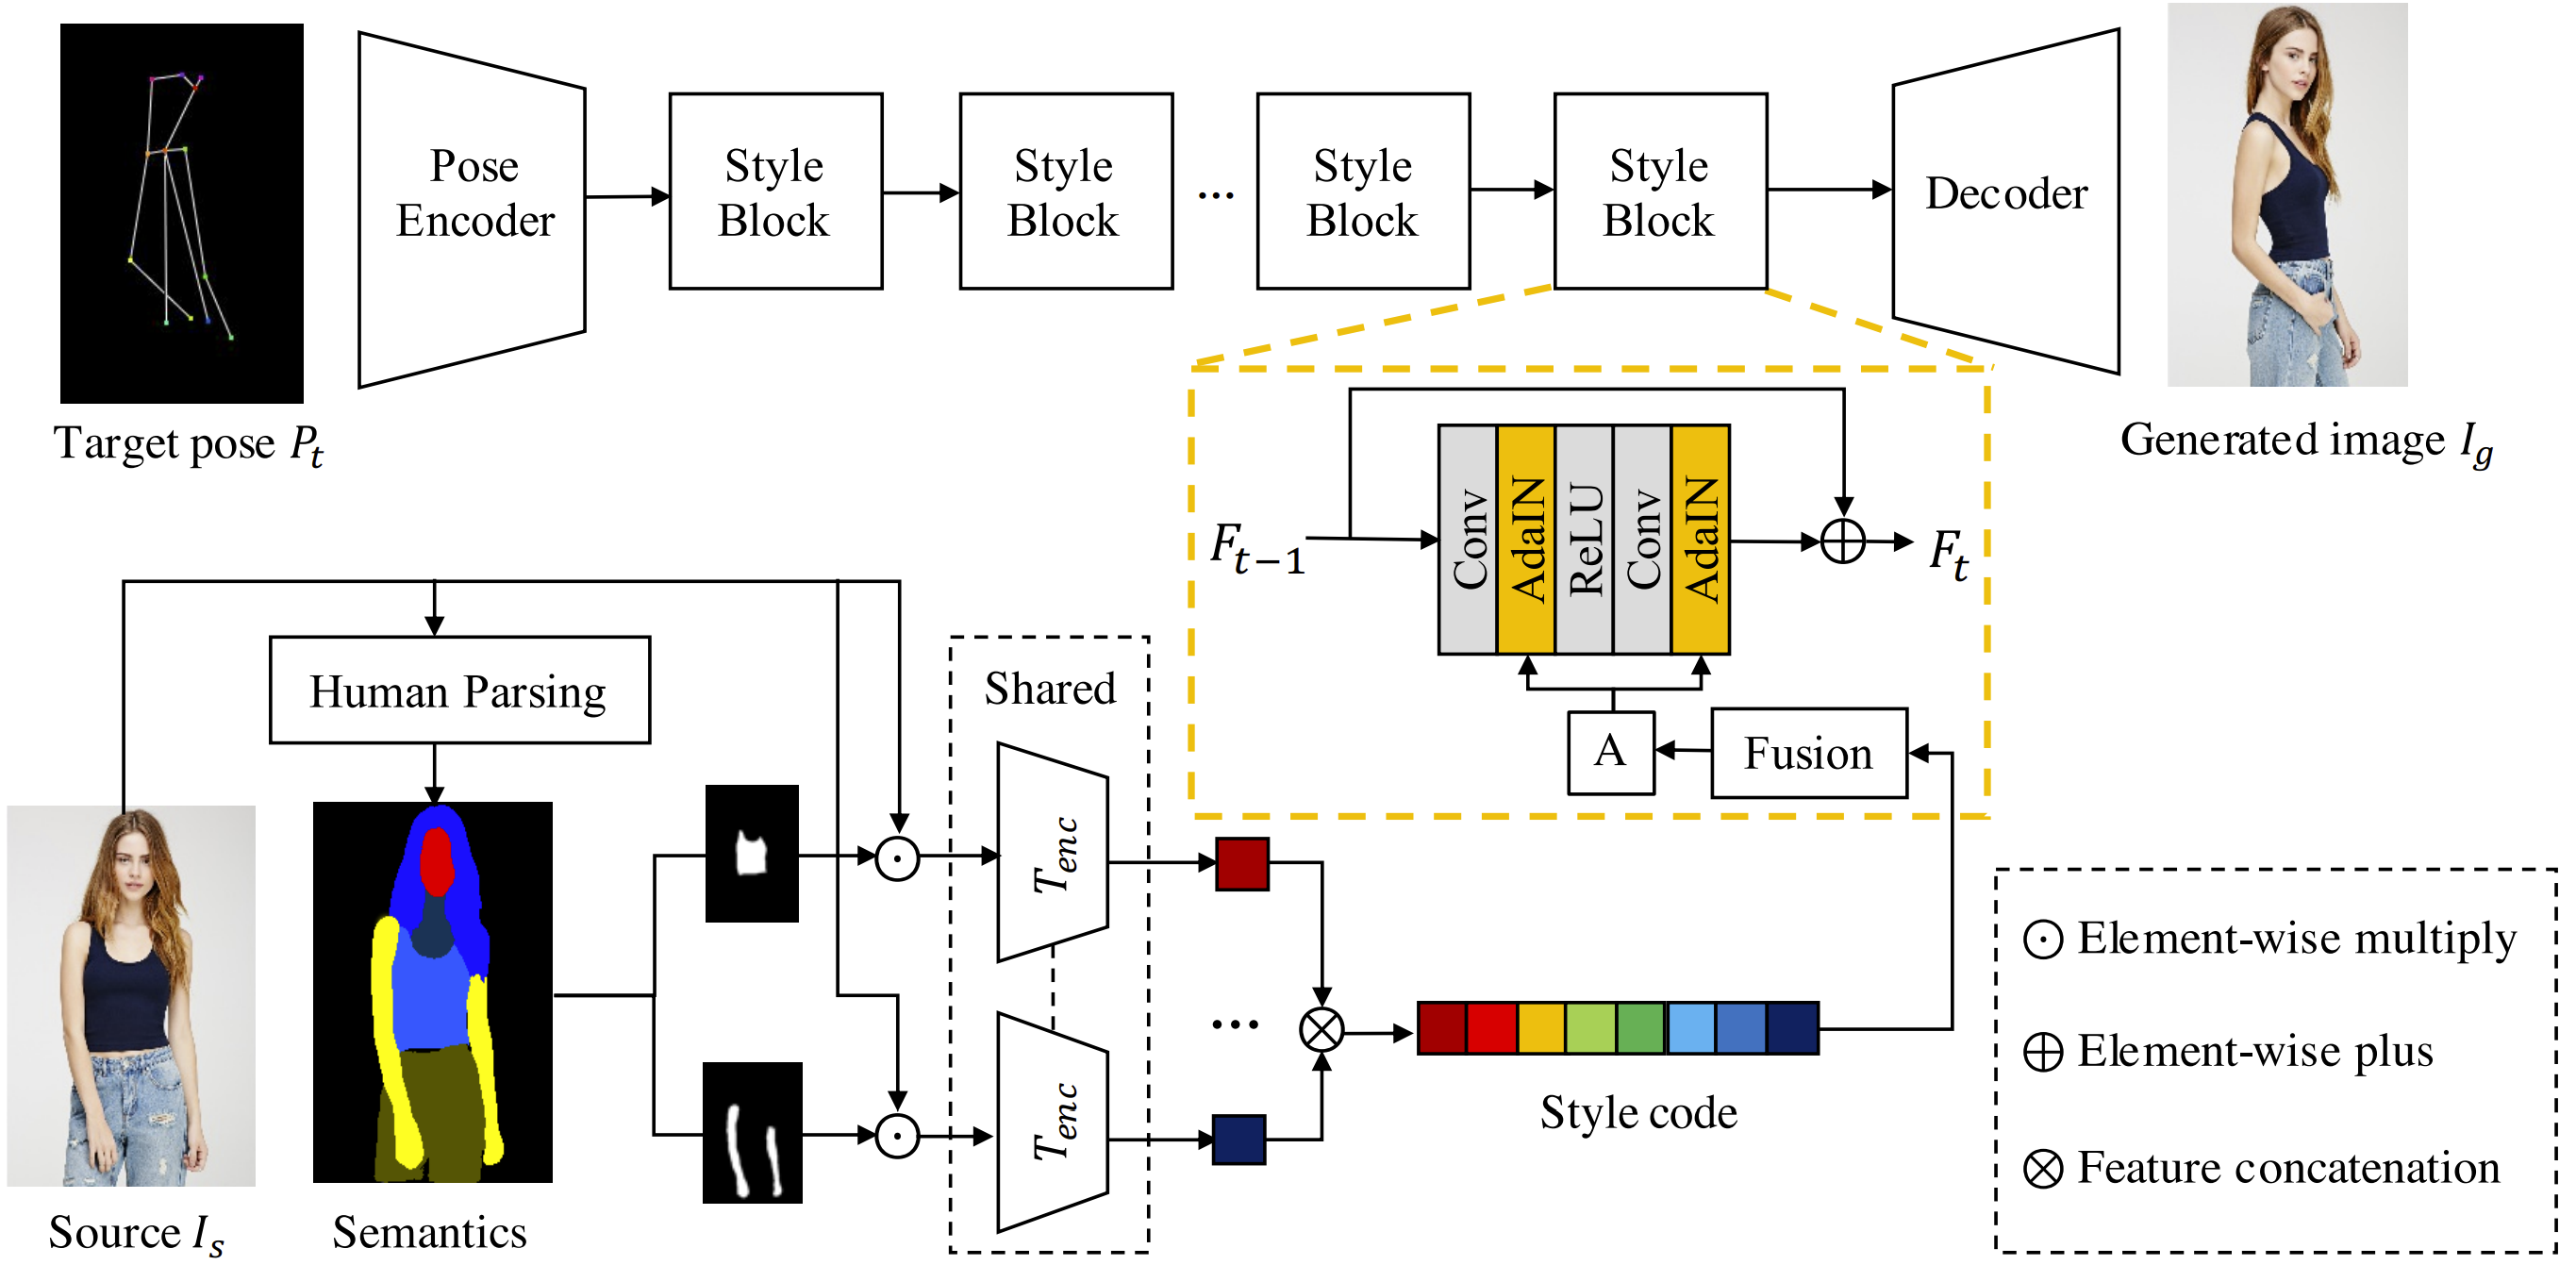
생성기는 목표 포즈 $P_t$ 와 소스 인물 $I_s$ 를 두 개의 독립 경로로 각각 잠재 코드에 임베딩하고, 일련의 스타일 블록으로 두 코드를 결합한 뒤 디코더로 이미지를 복원합니다(Fig. 2).
🦴 1. 포즈 인코딩 (Section 3.1.1)
포즈 경로에서 $P_t$ 는 일반적인 인코더 구성, 즉 $N$ 개의 다운샘플링 합성곱 층($N=2$)으로 이루어진 포즈 인코더를 거쳐 포즈 코드 $C_{pose}$ 가 됩니다. 이 코드는 첫 스타일 블록의 입력 특징 $F_0=C_{pose}$ 로 쓰입니다.
🔀 2. 텍스처 스타일 전이: 스타일 블록 (Section 3.1.3)
전이 네트워크는 8개의 캐스케이드 스타일 블록으로 구성되며, 각 블록은 융합 모듈(FM)과 AdaIN 을 갖춘 잔차 합성곱 블록입니다. $t$ 번째 블록은 이전 블록의 심층 특징 $F_{t-1}$ 과 스타일 코드 $C_{sty}$ 를 받아
\[F_t=\phi_t(F_{t-1},A)+F_{t-1}\]를 출력합니다. 여기서 $\phi_t$ 는 합성곱 블록, $A$ 는 AdaIN 층에 필요한 학습된 아핀 변환 파라미터(스케일과 시프트)로, 특징을 원하는 스타일로 정규화합니다. $A$ 는 FM 을 통해 $C_{sty}$ 에서 추출됩니다.
| 구성 | 역할 |
|---|---|
| 잔차 연결 $+F_{t-1}$ | 포즈 특징의 구조를 유지하며 점진적으로 텍스처 주입 |
| AdaIN | 스타일 코드가 결정한 채널별 평균·분산으로 특징을 재정규화 |
| 융합 모듈(FM) | 처음 두 완전연결 층이 구성요소 코드를 선형 재조합하고, 마지막 층이 필요한 차원의 AdaIN 파라미터 출력 |
🧱 3. 융합 모듈이 필요한 이유 (Fig. 6)
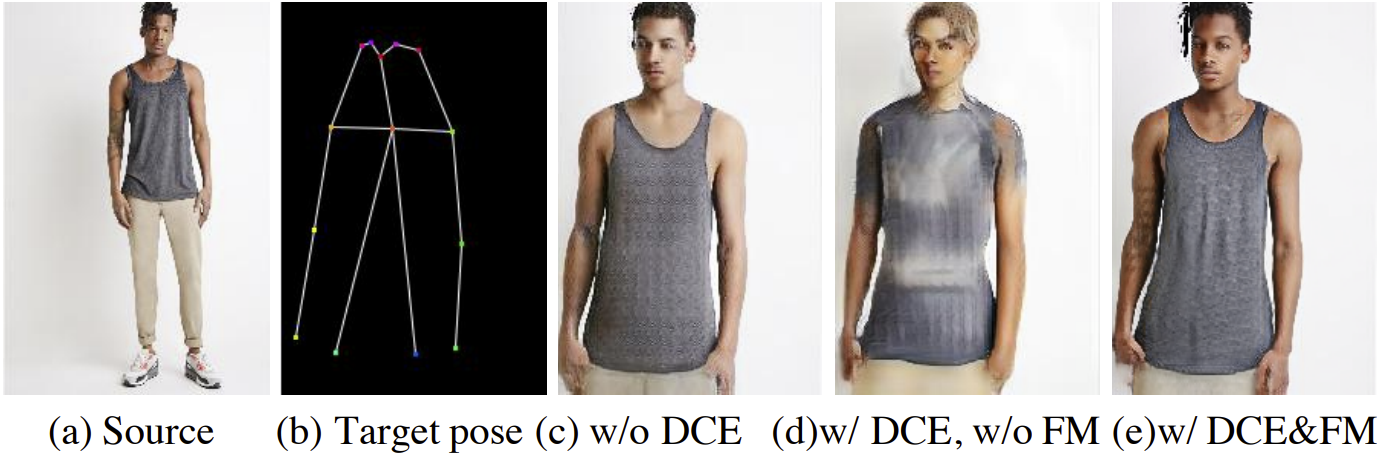
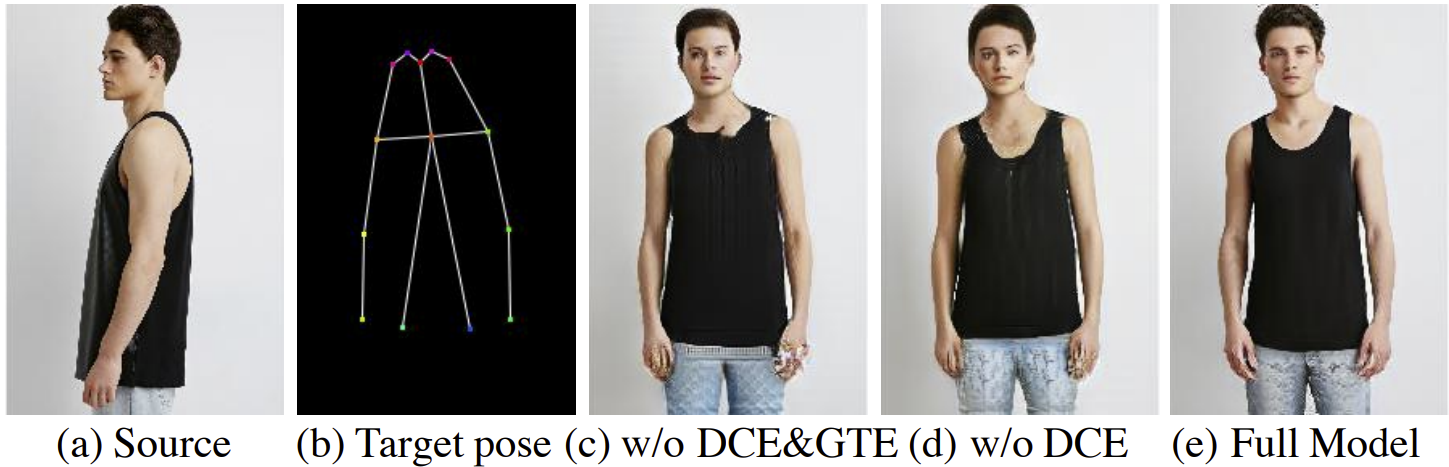
구성요소 코드는 정해진 순서로 이어 붙여 스타일 코드를 구성하므로, 코드의 위치와 구성요소 특징 사이에 강한 상관이 생깁니다. 이는 사람이 부과한 강한 개입이어서 네트워크 자체의 학습 경향과 충돌할 수 있습니다. FM 은 네트워크가 선형 재조합으로 원하는 특징을 유연하게 고르게 해 순전파와 역전파 사이의 충돌을 막습니다. 실제로 FM 없이 DCE 만 적용하면 DCE 가 없는 모델보다 결과가 더 나빠지고(Fig. 6(d) 대 6(c)), FM 을 함께 쓰면 DCE 가 제 성능을 냅니다(Fig. 6(e)).
🖼️ 4. 이미지 복원 (Section 3.1.4)
마지막 스타일 블록의 출력 $F_{T-1}$ 을 일반적인 디코더 구성, 즉 $N$ 개의 디컨볼루션 층으로 업샘플링해 최종 이미지 $I_g$ 를 만듭니다.
💡 Key Takeaway 포즈는 공간 특징으로, 외형은 스타일 코드로 분리해 들고 가다가 AdaIN 으로 합치는 것이 ADGAN 생성기의 골격입니다. 융합 모듈은 수작업으로 고정한 코드 순서와 학습의 충돌을 푸는 완충 장치입니다.
분해 구성요소 인코딩(DCE)과 전역 텍스처 인코딩(GTE)
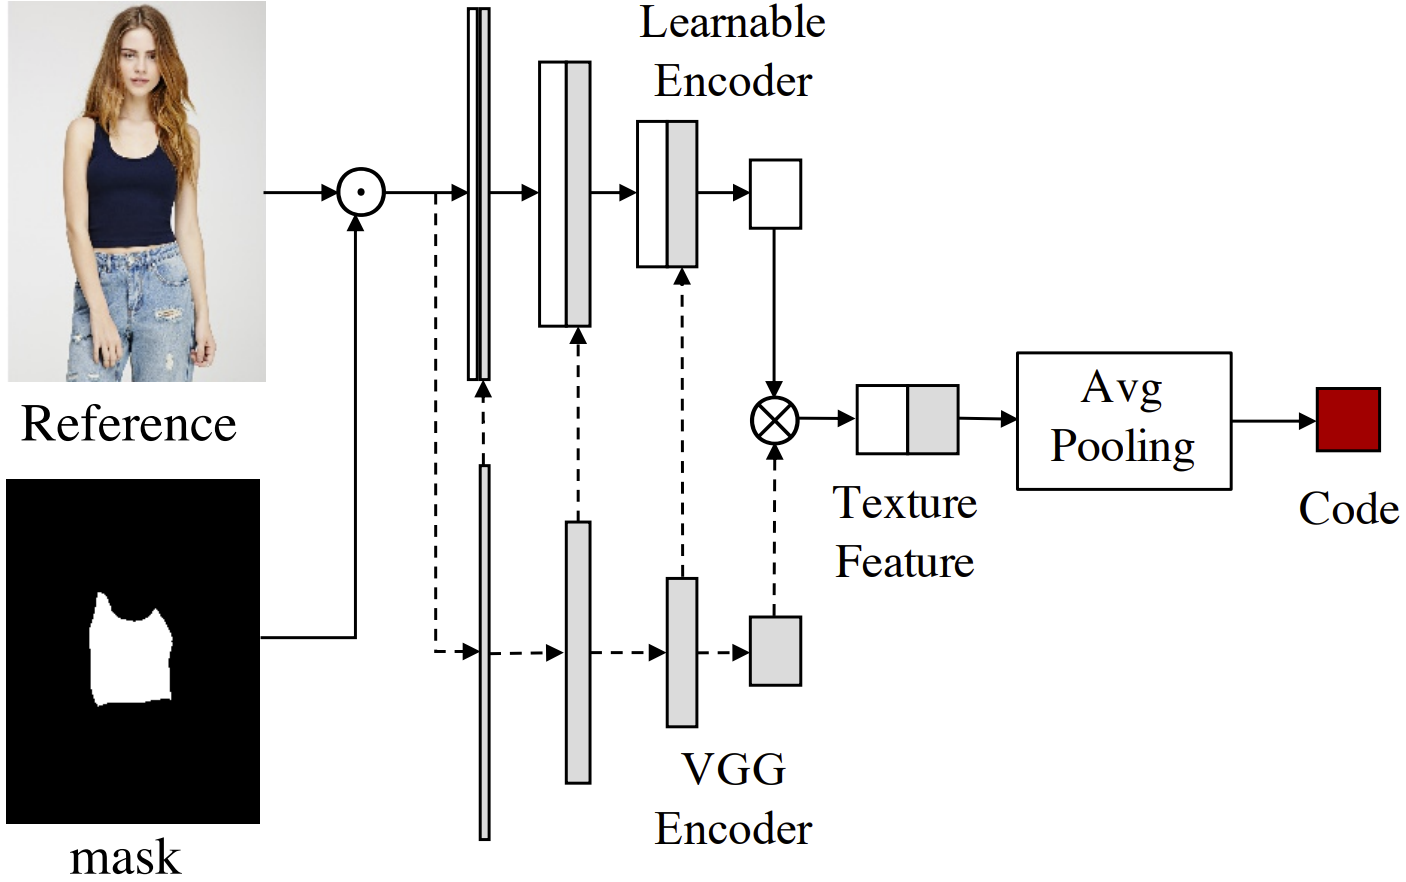
분해 구성요소 인코딩(Decomposed Component Encoding, DCE) 은 소스 인물을 구성요소별로 잘라 각각 인코딩한 뒤 코드를 재조합하는 모듈이고, 전역 텍스처 인코딩(Global Texture Encoding, GTE) 은 그 인코더에 고정 VGG 특징을 결합해 일반화를 높이는 설계입니다. 두 모듈이 ADGAN 의 속성 분리를 담당합니다.
✂️ 1. 공간 분해와 공유 인코더 (Section 3.1.2)
- 기성 인간 파서로 $I_s$ 의 의미 맵 $S$ 를 얻고, 이를 $K$ 채널 히트맵 $M\in\mathbb{R}^{K\times H\times W}$ 로 바꿉니다. 채널 $i$ 는 해당 구성요소의 이진 마스크 $M_i$ 입니다.
- 구성요소 $i$ 만 남긴 분해 이미지와 그 스타일 코드를 계산합니다.
- 텍스처 인코더 $T_{enc}$ 는 모든 분기에서 공유되며, 모든 $C_{sty}^{i}$ ($i=1,\dots,K$)를 위에서 아래로 이어 붙여 전체 스타일 코드 $C_{sty}$ 를 만듭니다.
구현에서는 파서의 원래 레이블을 $K=8$ 범주, 즉 배경, 머리카락, 얼굴, 윗옷, 바지, 스커트, 팔, 다리 로 병합합니다.
🎁 2. 분해의 두 가지 이점
| 이점 | 설명 | 근거 |
|---|---|---|
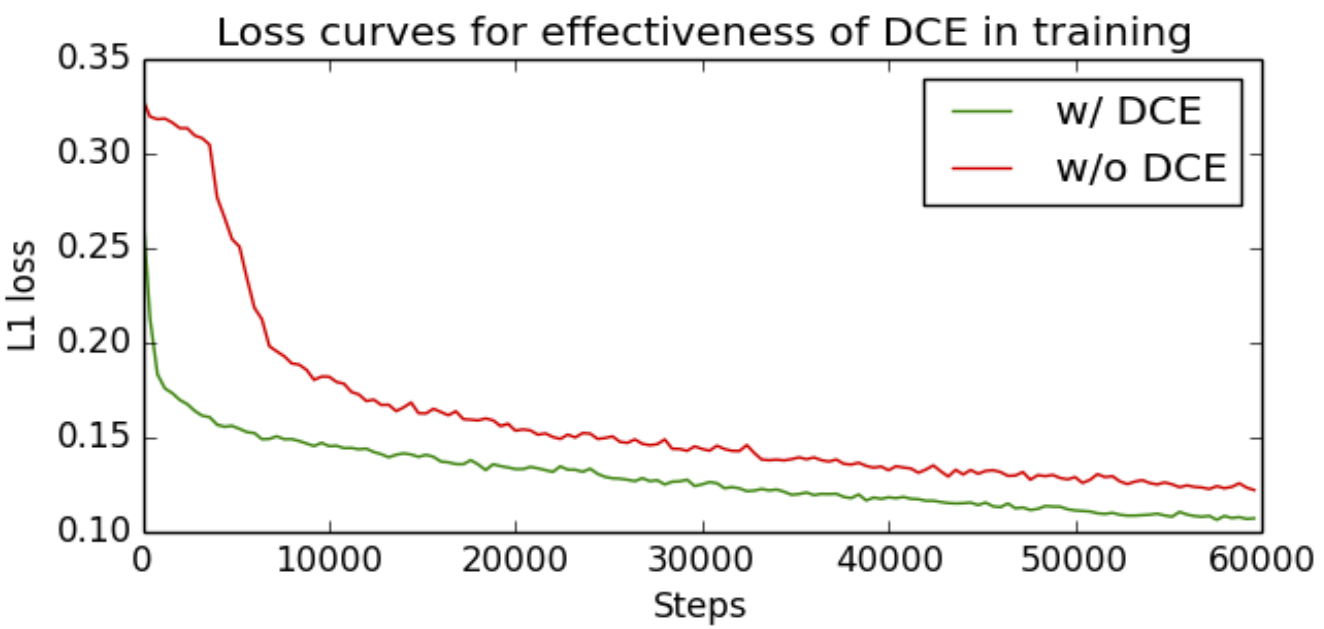
| 수렴 가속·품질 향상 | 옷·포즈가 다양한 인물 전체를 상세 텍스처와 함께 인코딩하는 것은 복잡한 다양체 때문에 어렵지만, 구성요소 하나의 특징만 배우는 것은 훨씬 쉬움. 구성요소들이 색 인코딩 파라미터를 공유하므로 텍스처 학습의 암묵적 데이터 증강 효과 | 손실 곡선 Fig. 5, 시각화 Fig. 4(d)(e) |
| 비지도 속성 분리 | 특정 속성이 스타일 코드의 고정 위치에 학습되므로, 다른 사람에게서 뽑은 구성요소 코드를 섞는 것만으로 속성 제어 가능 | Fig. 10 |
🌐 3. 전역 텍스처 인코딩 (Fig. 3)
스타일 전이 연구가 사전 학습 VGG 로 직접 이미지 코드를 뽑는 데서 영감을 받아, 텍스처 인코더는 학습 가능 인코더와 고정 VGG 인코더의 대응 층 출력을 이어 붙입니다. 고정 VGG 는 COCO 로 사전 학습되어 다양한 텍스처를 보았으므로 전역 특징과 야생 텍스처에 대한 일반화 능력이 강합니다. 다만 느슨한 제약으로 그럴듯한 결과만 내면 되는 스타일 전이와 달리, 이 모델은 지정된 사람을 지정된 포즈로 정확히 출력해야 하므로 고정 인코더만으로는 적합이 어렵습니다. 그래서 학습 가능 인코더를 결합합니다. GTE 의 효과는 Fig. 4(c)(d) 에 있습니다.
💡 Key Takeaway DCE 는 “어려운 하나의 인코딩”을 “쉬운 여러 개의 인코딩”으로 쪼개고, 그 부산물로 레이블 없는 속성 분리를 얻습니다. GTE 는 고정 VGG 로 일반화를, 학습 인코더로 정확한 적합을 각각 맡깁니다.
판별기와 학습 손실
학습은 두 개의 PatchGAN 판별기와 네 가지 손실 항의 가중합으로 이루어집니다. 각 항은 포즈 정렬, 색 충실도, 텍스처 일치, 공간 변형 허용이라는 서로 다른 역할을 맡습니다.
👁️ 1. 두 판별기 (Section 3.2)
Zhu et al. (PATN)을 따라 두 판별기를 둡니다.
| 판별기 | 입력 쌍 (가짜 / 진짜) | 역할 |
|---|---|---|
| $D_p$ | $(P_t, I_g)$ / $(P_t, I_t)$ | 생성 이미지의 포즈가 목표 포즈와 정렬되었는지 |
| $D_t$ | $(I_s, I_g)$ / $(I_s, I_t)$ | 소스 인물의 외형 텍스처와 유사한지 |
둘 다 PatchGAN 으로 구현합니다.
🧮 2. 전체 손실 (Section 3.3)
\[L_{total}=L_{adv}+\lambda_{rec}L_{rec}+\lambda_{per}L_{per}+\lambda_{CX}L_{CX}\]적대 손실은 두 판별기의 곱 형태로 진짜 쌍과 가짜 쌍의 분포 차이를 벌합니다.
\[L_{adv}=\mathbb{E}_{I_s,P_t,I_t}\big[\log\big(D_t(I_s,I_t)\cdot D_p(P_t,I_t)\big)\big]+\mathbb{E}_{I_s,P_t}\big[\log\big((1-D_t(I_s,G(I_s,P_t)))\cdot(1-D_p(P_t,G(I_s,P_t)))\big)\big]\]재구성 손실은 생성 이미지와 목표 이미지의 L1 거리로, 색 왜곡을 막고 수렴을 가속합니다.
\[L_{rec}=\big\|G(I_s,P_t)-I_t\big\|_1\]지각 손실은 VGG19 의 $l$ 층 특징 $\phi_l$ 로 텍스처를 맞춥니다.
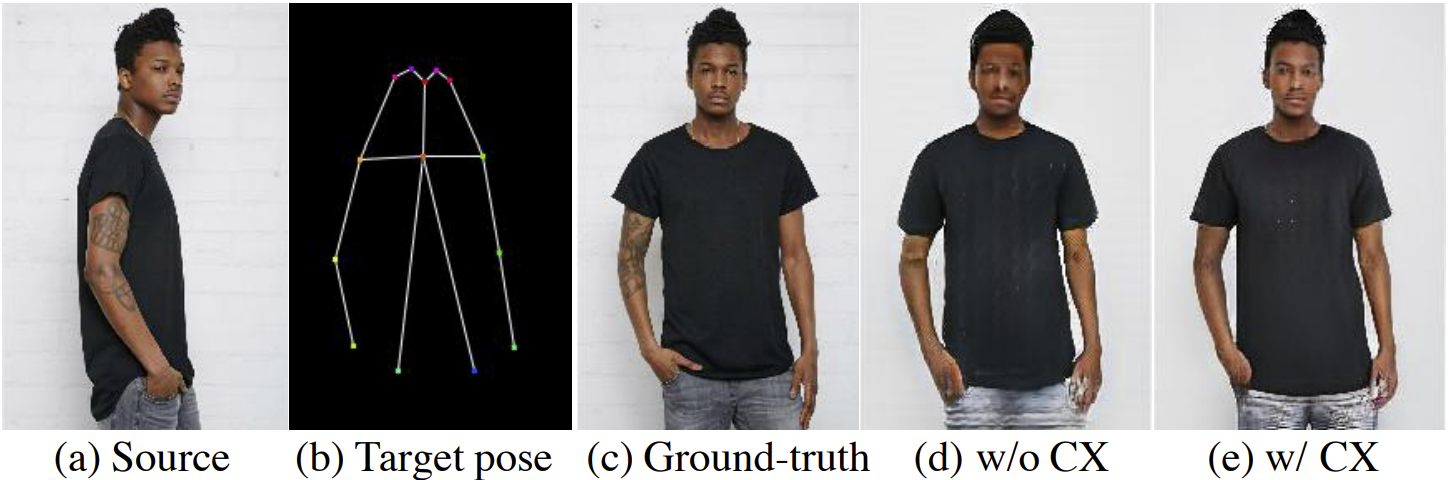
\[L_{per}=\frac{1}{W_lH_lC_l}\sum_{x=1}^{W_l}\sum_{y=1}^{H_l}\sum_{z=1}^{C_l}\big\|\phi_l(I_g)_{x,y,z}-\phi_l(I_t)_{x,y,z}\big\|_1\]문맥 손실(contextual loss) 은 정렬되지 않은 두 이미지의 유사도를 재는 Mechrez et al. 의 손실로, 픽셀 수준 정렬이 필요한 손실과 달리 목표에 대한 공간 변형을 허용해 텍스처 왜곡을 줄입니다.
\[L_{CX}=-\log\Big(\mathrm{CX}\big(F^{l}(I_g),F^{l}(I_t)\big)\Big),\qquad l=\{relu3\_2,\ relu4\_2\}\]$F^{l}$ 은 VGG19 의 해당 층 특징 맵, $\mathrm{CX}$ 는 픽셀의 의미와 전체 이미지 문맥을 함께 고려한 유사도입니다. 효과는 Fig. 8 에서 볼 수 있으며, 왜곡을 줄이고 세부를 더 잘 보존합니다.
⚙️ 3. 구현 세부
| 항목 | 값 |
|---|---|
| 프레임워크·하드웨어 | PyTorch, NVIDIA Tesla V100 16GB × 2 |
| 손실 가중치 | $\lambda_{rec}=2,\ \lambda_{per}=2,\ \lambda_{CX}=0.02$ |
| 최적화기 | Adam, 모멘텀 0.5 |
| 학습률 | 초기 0.001, 60k 반복 이후 0 까지 선형 감소 |
| 총 반복 | 약 120k |
| 학습 방식 | 생성기와 두 판별기를 번갈아 학습 |
| 파싱 범주 | $K=8$ (배경, 머리카락, 얼굴, 윗옷, 바지, 스커트, 팔, 다리) |
💡 Key Takeaway L1 은 색, VGG 지각 손실은 텍스처, 문맥 손실은 정렬 없는 텍스처 일치를 맡습니다. 포즈가 바뀌면 픽셀 정렬이 깨지므로 문맥 손실의 공간 변형 허용이 인물 합성에서 특히 중요합니다.
실험: 포즈 전이 정량·정성 비교
포즈 전이 실험은 DeepFashion 에서 네 가지 최신 방법과 비교하며, 자동 지표와 사용자 연구를 함께 사용합니다.
📦 1. 데이터셋과 지표 (Section 4)
| 항목 | 내용 |
|---|---|
| 데이터셋 | DeepFashion In-shop Clothes Retrieval Benchmark, 52,712장, $256\times256$ |
| 분할 | PATN 과 동일 구성. 학습 101,966 쌍, 테스트 8,750 쌍 |
| IS, SSIM | PG2 이후 인물 합성의 표준 지표 |
| DS (Detection Score) | Siarohin et al. 이 도입. 이미지에서 사람이 검출되는지 |
| CX-GS, CX-GT | 이 논문이 도입한 문맥 점수. 깊은 특징의 코사인 거리로 공간 위치를 무시하고 비정렬 이미지 간 유사도 측정. 소스(GS)·목표(GT) 와의 텍스처 일관성을 명시적으로 평가 |
IS 와 DS 는 출력 이미지만 보고 품질을 판단해 조건 이미지와의 일관성을 무시하므로, 저자들은 CX 점수를 보완 지표로 제안합니다.
📊 2. 정량 비교 (Table 1)
| 모델 | SSIM ↑ | IS ↑ | DS ↑ | CX-GS ↓ | CX-GT ↓ |
|---|---|---|---|---|---|
| PG2 | 0.773 | 3.202 | 0.943 | 2.854 | 2.795 |
| DPIG | 0.745 | 3.323 | 0.969 | 2.761 | 2.753 |
| Def-GAN | 0.770 | 3.265 | 0.973 | 2.751 | 2.713 |
| PATN | 0.774 | 3.209 | 0.976 | 2.628 | 2.604 |
| ADGAN | 0.772 | 3.364 | 0.984 | 2.474 | 2.474 |
- PG2, DPIG, Def-GAN 은 데이터 분할 정보가 없어 공개 사전 학습 모델을 받아 테스트 집합에서 평가했습니다. 테스트 이미지가 그들의 학습 샘플에 포함되었을 가능성이 있음에도 ADGAN 이 대부분의 지표에서 앞섭니다.
- SSIM 은 IS 가 오를 때 약간 내려가는 경향이 있으며, 선명한 이미지가 더 낮은 SSIM 을 받을 수 있다는 점은 PG2, DPIG 에서도 관찰된 현상입니다.
🧑⚖️ 3. 사용자 연구 (Table 2)
| 지표 | PG2 | DPIG | Def-GAN | PATN | ADGAN |
|---|---|---|---|---|---|
| R2G (%) | 9.2 | - | 12.42 | 19.14 | 23.49 |
| G2R (%) | 14.9 | - | 24.61 | 31.78 | 38.67 |
| 선호도 (%) | 1.61 | 1.35 | 16.23 | 7.26 | 73.55 |
- 진위 판정: 참가자는 이미지가 진짜인지 가짜인지 1초 안에 판단합니다. 실제 55장·생성 55장을 무작위 선택해 처음 10장은 워밍업, 나머지 100장을 평가합니다. R2G 는 실제 이미지가 생성으로 판정된 비율, G2R 은 생성 이미지가 실제로 판정된 비율입니다.
- 충실도: 소스 이미지와 다섯 방법의 출력을 보여 주고 소스 인물에 대해 가장 자연스럽고 합리적인 이미지를 고르게 합니다. 참가자당 30회 비교, 실험당 40명의 응답을 수집했습니다.
- ADGAN 의 결과가 70% 이상 가장 사실적인 것으로 선택되어, 다른 방법 대비 상당한 품질 향상이 확인됩니다.
🖼️ 4. 정성 비교 (Fig. 7, 9)
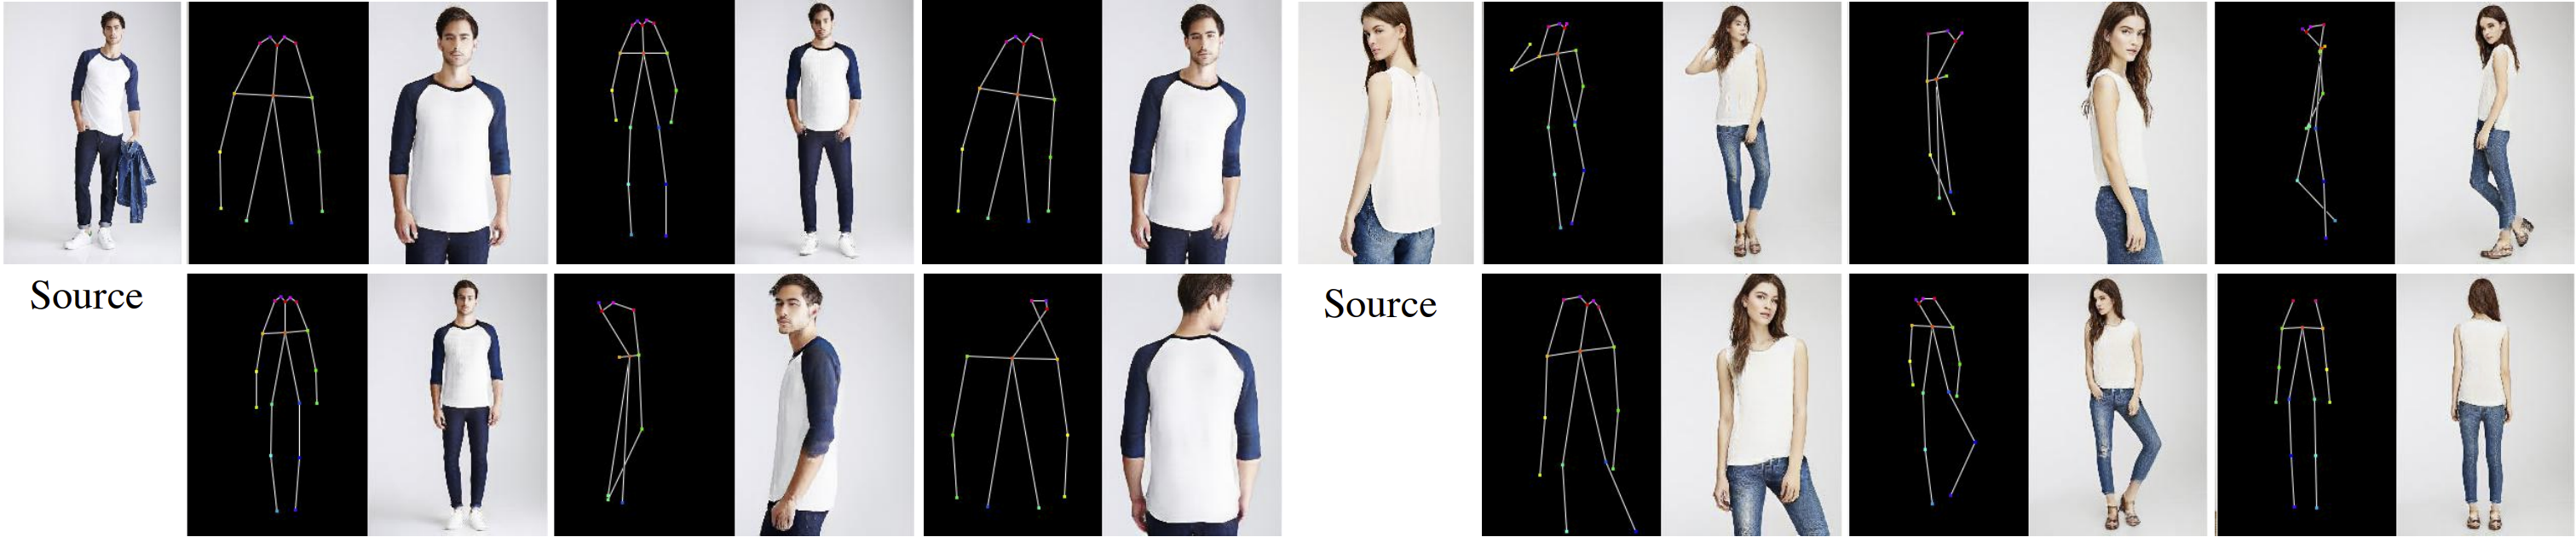
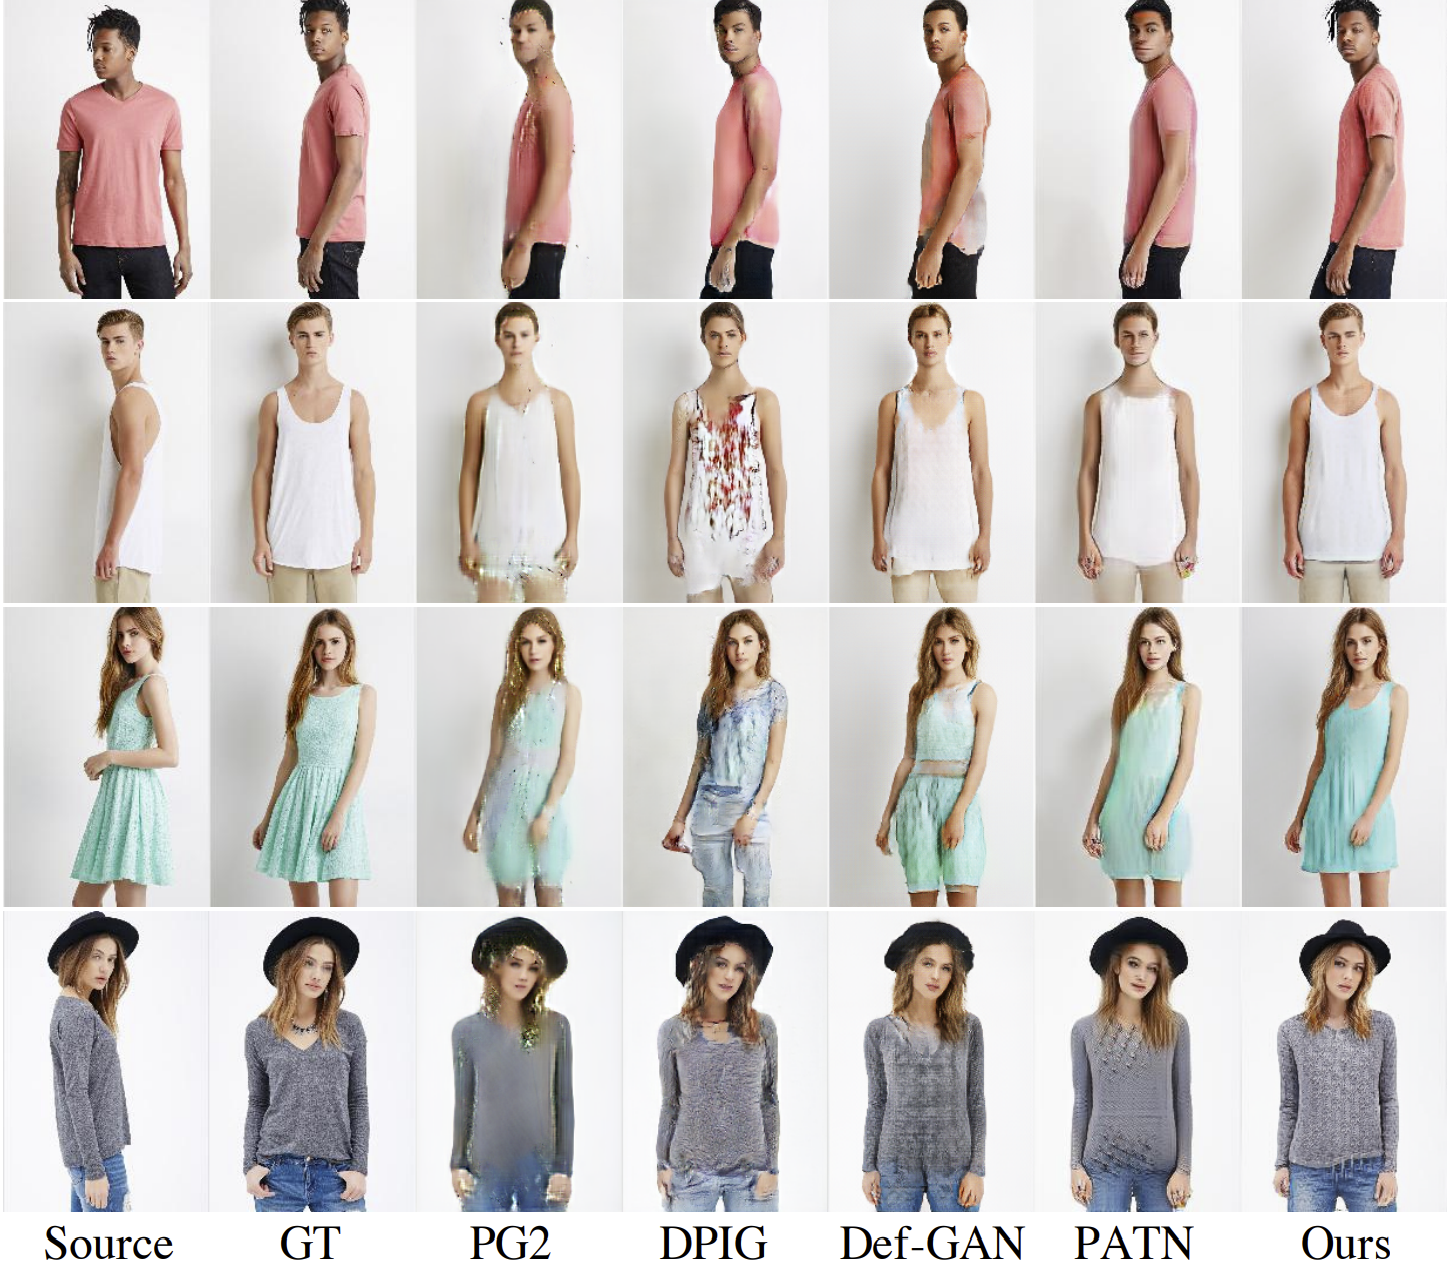
같은 소스 인물에 테스트 집합의 여러 포즈를 적용하면, 목표 포즈가 소스와 스케일·시점에서 크게 달라도 자연스러운 결과를 냅니다(Fig. 7). 네 방법과의 비교(Fig. 9)에서 ADGAN 은 전역 구조와 세부 텍스처 모두 더 사실적이며, 얼굴 정체성이 더 잘 보존되고 미세한 근육과 옷 주름까지 합성됩니다.
💡 Key Takeaway 자동 지표에서는 IS·DS·CX 모두 1위이고 SSIM 은 동률 수준이며, 사용자 선호도 73.55% 는 다른 방법을 압도합니다. 문맥 점수 CX 는 포즈가 바뀌는 과제에서 텍스처 일관성을 재는 지표로 이 논문이 새로 도입한 것입니다.
구성요소 속성 전이와 스타일 보간
구성요소 속성 전이(component attribute transfer) 는 ADGAN 이 새로 제시한 과제로, 여러 소스 인물에게서 뽑은 구성요소 코드를 재조합해 원하는 속성을 가진 이미지를 합성합니다.
👕 1. 코드 혼합에 의한 속성 편집 (Section 4.2, Fig. 10)
소스 인물을 분해 구성요소 코드로 인코딩하고 코드를 재조합해 스타일 코드를 만들기 때문에, 예를 들어 인물 1 의 기본 외형에 인물 2 의 윗옷, 인물 3 의 바지를 합친 이미지를 자동으로 만들 수 있습니다. 나머지 구성요소의 텍스처는 유지되면서 새 속성이 조화롭게 들어갑니다. 바지 → 드레스, 티셔츠 → 조끼, 남성 → 여성 같은 구성요소 수준의 속성 편집 도구로 쓸 수 있습니다.
🎚️ 2. 스타일 보간
두 인물의 윗옷 코드 $C_{uc1},C_{uc2}$ 를 선형 보간하면 한 속성에서 다른 속성으로의 연속 애니메이션을 얻습니다.
\[C_{mix}=\beta\,C_{uc1}+(1-\beta)\,C_{uc2},\qquad \beta\in(0,1)\]$\beta$ 를 1 에서 0 으로 단계적으로 줄이면 학습 데이터가 이루는 다양체 위를 따라 이동하게 됩니다. 이 성질은 속성이 독립적이고 연속적인 코드로 임베딩되어 있다는 주장의 직접적 증거입니다.
🧠 3. 왜 가능한가
| 요소 | 기여 |
|---|---|
| DCE 의 고정 순서 연결 | 각 속성이 스타일 코드의 정해진 위치에 학습됨 |
| 공유 텍스처 인코더 | 서로 다른 사람의 같은 구성요소 코드가 같은 공간에 놓여 교체 가능 |
| AdaIN + FM | 코드가 바뀌면 해당 구성요소의 텍스처 통계만 바뀌고 포즈 특징은 유지 |
💡 Key Takeaway 속성 전이는 별도 학습 없이 추론 시 코드를 바꿔 끼우는 것만으로 이루어집니다. 이는 ADGAN 의 분해 구조가 실제로 분리 가능한 표현을 학습했음을 보여 줍니다.
한계와 열린 방향
한계는 생성이 본질적으로 학습 데이터 다양체 위의 보간이라는 점과, 기성 파서·포즈 추정기에 대한 의존에서 나옵니다.
⚠️ 1. 실패 사례 (Section 4.3, Fig. 11)
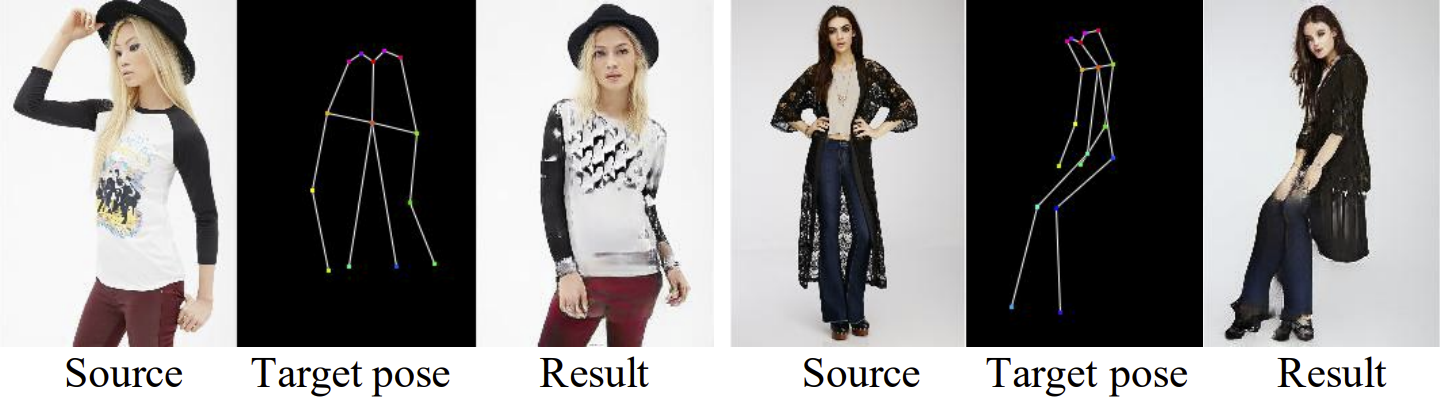
모델은 다양한 포즈와 구성요소 속성으로 이루어진 복잡한 다양체를 구성하고 그 위를 이동할 수 있으므로, 유효한 합성 결과는 사실상 본 것들의 보간 혼합입니다. 따라서 학습 데이터 다양체에서 크게 벗어난 입력은 실패합니다.
| 실패 유형 | 예 |
|---|---|
| 희귀한 구성요소 패턴 | 여성 티셔츠의 특정 만화 패턴은 본 것들로 보간되지 않아 재현 실패 |
| 희귀한 포즈 | 드문 포즈의 사람은 매끄럽게 합성되지 않음 |
🔗 2. 구조적 의존성
- 인간 파서 의존: 속성 분리의 품질은 기성 파서의 분할 품질에 묶여 있습니다. 파싱 오류(팔과 소매의 혼동 등)는 그대로 스타일 코드 오염으로 이어집니다.
- 고정된 $K=8$ 범주: 범주 병합 방식이 분리 가능한 속성의 단위를 정합니다. 액세서리, 신발, 패턴 같은 더 세밀한 속성은 별도 범주 없이는 독립 제어가 어렵습니다.
- 전역 통계 기반 스타일: AdaIN 은 채널별 평균·분산으로 스타일을 주입하므로 로고나 프린트 같은 공간적으로 구조화된 텍스처의 정확한 위치 보존에는 한계가 있습니다. 문맥 손실이 이를 일부 완화하지만 근본 해결은 아닙니다.
- 평가: 사용자 연구 규모(실험당 40명)가 크지 않고, 비교 모델 일부는 데이터 분할이 다를 수 있습니다.
🚀 3. 후속 방향
- 저자들은 기성 파서로 전체 인물 이미지에서 속성을 자동 분리하는 방식이 주석이 부족한 상황의 후속 연구에 영감을 줄 수 있다고 보며, 인물 외의 다른 이미지 합성 과제에도 적응 가능하다고 제안합니다.
- 이후 연구는 흐름 기반 변형(warping)으로 공간 텍스처를 보존하거나, 파싱 맵 자체를 생성해 파서 의존을 줄이거나, 확산 모델로 희귀 패턴의 생성 품질을 높이는 방향으로 전개되었습니다. 가상 피팅(virtual try-on) 연구에서 “구성요소별 인코딩 + 스타일 주입” 패러다임은 ADGAN 이 확립한 틀 위에 서 있습니다.
💡 Key Takeaway ADGAN 은 보간으로 도달 가능한 것만 만들 수 있고, 그 분리 단위는 파서가 정합니다. 레이블 없는 속성 분리라는 아이디어는 강력하지만, 공간 구조가 중요한 텍스처와 분포 밖 입력은 후속 연구의 과제로 남았습니다.