 You know maize mean?
InfoGAN: Interpretable Representation Learning by Information Maximizing Generative Adversarial Nets
0. Summary
기본 정보 : ArXiv,2016.06.12 (NeurIPS 2016), InfoGAN: Interpretable Representation Learning by Information Maximizing Generative Adversarial Nets
연구 배경
비지도 학습은 라벨 없는 데이터에서 가치를 끌어내는 문제이며, 그 유력한 틀이 표현 학습(representation learning) 이다. 다운스트림 과제를 모르는 상태에서도 데이터의 두드러진 속성을 명시적으로 표현하는 분리된 표현(disentangled representation) 은 유용할 가능성이 높다. 생성 모델링은 “만들 수 있으면 이해한 것”이라는 믿음 아래 좋은 생성 모델이 자동으로 분리된 표현을 학습하기를 기대하지만, 임의로 나쁜 표현을 가진 완벽한 생성 모델을 만드는 것도 쉽다. 표준 GAN 은 단순한 인수분해된 연속 잡음 $z$ 를 쓰면서 생성기가 이를 어떻게 쓰는지 아무 제약도 두지 않으므로, 잡음이 매우 얽힌(entangled) 방식으로 사용되어 개별 차원이 데이터의 의미적 특징에 대응하지 않을 수 있다. 기존의 분리 표현 학습은 bilinear model, DC-IGN 등 지도·약지도 정보에 의존했고, 유일한 비지도 방법 hossRBM 은 이산 인자만 다루며 계산량이 인자 수에 지수적으로 늘었다.
제안 방법
입력 잡음을 압축 불가능한 잡음 $z$ 와 잠재 코드(latent code) $c$ 로 나누고, 생성기 $G(z,c)$ 가 $c$ 를 무시하지 못하도록 상호정보(mutual information) $I(c;G(z,c))$ 가 높아야 한다는 정보이론적 정규화를 건다. 상호정보는 사후분포 $P(c\mid x)$ 가 필요해 직접 최대화하기 어렵지만, 보조 분포 $Q(c\mid x)$ 를 도입한 변분 하한 $L_{I}(G,Q)$ 로 대체할 수 있고(Variational Information Maximization), 간단한 보조정리(Lemma 5.1)로 사후분포 샘플링 없이 Monte Carlo 추정이 가능해진다. 최종 목적함수는 $\min_{G,Q}\max_{D}V(D,G)-\lambda L_{I}(G,Q)$ 이며, $Q$ 는 $D$ 와 모든 합성곱 층을 공유하고 마지막 완전연결층만 추가하므로 계산 비용이 거의 늘지 않는다.
발견 사실
MNIST 에서 범주형 코드 $c_{1}\sim\mathrm{Cat}(K=10,p=0.1)$ 로 학습하면 하한 $L_{I}$ 가 $H(c)\approx2.30$ 으로 빠르게 최대화되어 경계가 타이트해지고 최대 상호정보가 달성되었다(Figure 1). 라벨 없이 학습했음에도 $c_{1}$ 의 각 범주를 숫자 종류에 대응시키면 5% 오류율의 분류기가 되었고, 연속 코드 $c_{2}$, $c_{3}$ 는 각각 회전과 두께를 제어했으며 학습 범위 $[-1,1]$ 을 넘어 $[-2,2]$ 로 조작해도 의미 있는 일반화를 보였다(Figure 2). 3D 얼굴에서는 다섯 개의 연속 코드가 방위각, 고도, 조명과 함께 지도 방법에서는 라벨링된 적 없는 얼굴 너비까지 발견했고(Figure 3), 의자에서는 회전과 너비를(Figure 4), SVHN 에서는 조명과 중앙 숫자의 맥락을(Figure 5), CelebA 에서는 방위각, 안경 유무, 헤어스타일, 감정을(Figure 6) 비지도로 분리했다.
핵심 기여
- 상호정보 기반 정규화로 해석 가능한 표현 유도 : GAN 목적함수에 $-\lambda I(c;G(z,c))$ 항을 더하는 간단한 수정으로, 어떤 종류의 지도 없이도 이산·연속 잠재 인자를 동시에 분리하는 표현을 학습했다.
- 효율적인 변분 하한 : 보조 분포 $Q(c\mid x)$ 와 Lemma 5.1 을 이용해 사후분포 접근 없이 최적화 가능한 하한 $L_{I}(G,Q)$ 를 유도했고, $Q$ 가 $D$ 와 네트워크를 공유해 GAN 대비 무시할 만한 추가 비용만 든다. $L_{I}$ 는 보통 GAN 목적보다 빨리 수렴한다.
- 복잡한 데이터셋에서의 비지도 분리 : MNIST, 3D 얼굴·의자, SVHN, CelebA 에서 지도 방법(DC-IGN 등)과 비교할 만한 품질의 분리 표현을 얻었고, 지도 방법이 발견할 수 없는 라벨 없는 변이(얼굴 너비, 의자 너비)까지 스스로 찾아냈다.
관련 개념
잠재 코드와 상호정보 정규화 (Section 4)
잠재 코드(latent code) 는 InfoGAN 이 표준 GAN 의 비구조적 잡음 벡터에 도입한 구조입니다. 많은 도메인은 의미 있는 변이 인자들로 자연스럽게 분해되며, MNIST 라면 숫자 정체성을 나타내는 이산 변수 하나와 기울기·두께를 나타내는 연속 변수 둘이 이상적일 것입니다. InfoGAN 은 “MNIST 숫자는 독립적인 1-of-10 변수와 두 독립 연속 변수로 생성된다”고 명시만 하면 이 개념들을 지도 없이 복원하려 합니다.
🧩 1. 입력의 분해
| 성분 | 기호 | 역할 |
|---|---|---|
| 압축 불가능한 잡음 | $z$ | 구조화되지 않은 변이의 원천 |
| 잠재 코드 | $c=(c_{1},\dots,c_{L})$ | 데이터 분포의 두드러진 구조적 의미 특징을 겨냥 |
가장 단순한 형태로 인수분해된 분포 $P(c_{1},\dots,c_{L})=\prod_{i=1}^{L}P(c_{i})$ 를 가정하고, 생성기는 $G(z,c)$ 가 됩니다.
⚠️ 2. 사소한 코드(trivial code) 문제
표준 GAN 에서 생성기는 $P_{G}(x\mid c)=P_{G}(x)$ 를 만족하는 해를 찾아 추가 코드 $c$ 를 자유롭게 무시할 수 있습니다. 이를 막기 위해 논문은 잠재 코드와 생성 분포 사이의 상호정보 $I(c;G(z,c))$ 가 높아야 한다는 정보이론적 정규화를 제안합니다.
상호정보는 두 엔트로피 항의 차이로 표현됩니다.
\[I(X;Y)=H(X)-H(X\mid Y)=H(Y)-H(Y\mid X)\]| 상황 | $I(X;Y)$ |
|---|---|
| $X$, $Y$ 독립 | 0 (하나를 알아도 다른 것에 대해 아무것도 알 수 없음) |
| 결정론적 가역 함수로 연결 | 최대 |
직관적으로 $I(X;Y)$ 는 $Y$ 를 관측했을 때 $X$ 의 불확실성 감소량입니다. 따라서 임의의 $x\sim P_{G}(x)$ 에 대해 $P_{G}(c\mid x)$ 의 엔트로피가 작기를, 즉 생성 과정에서 잠재 코드의 정보가 손실되지 않기를 원합니다.
🎯 3. 정보 정규화 미니맥스 게임 (Eq. 2)
\[\min_{G}\max_{D}V_{I}(D,G)=V(D,G)-\lambda I(c;G(z,c))\]여기서 $V(D,G)$ 는 표준 GAN 가치 함수 $\mathbb{E}{x\sim P{data}}[\log D(x)]+\mathbb{E}_{z\sim noise}[\log(1-D(G(z)))]$ 입니다 (Eq. 1). 비슷한 상호정보 기반 목적은 이전에 클러스터링 맥락에서 고려된 바 있습니다.
💡 Key Takeaway InfoGAN 의 출발점은 “생성기가 코드를 무시하지 못하게 하라”는 한 문장입니다. 그 수단이 상호정보 최대화이고, 결과가 지도 없는 분리 표현입니다.
변분 상호정보 최대화 (Section 5)
변분 상호정보 최대화(Variational Mutual Information Maximization) 는 사후분포 $P(c\mid x)$ 에 접근할 수 없을 때 보조 분포 $Q(c\mid x)$ 로 상호정보의 하한을 얻는 기법입니다. 이 절은 InfoGAN 의 수학적 핵심입니다.
📐 1. 하한 유도 (Eq. 4)
\(I(c;G(z,c))=H(c)-H(c\mid G(z,c))\) \(=\mathbb{E}_{x\sim G(z,c)}\big[\mathbb{E}_{c'\sim P(c\mid x)}[\log P(c'\mid x)]\big]+H(c)\) \(=\mathbb{E}_{x\sim G(z,c)}\Big[\underbrace{D_{KL}\big(P(\cdot\mid x)\,\|\,Q(\cdot\mid x)\big)}_{\geq0}+\mathbb{E}_{c'\sim P(c\mid x)}[\log Q(c'\mid x)]\Big]+H(c)\) \(\geq\mathbb{E}_{x\sim G(z,c)}\big[\mathbb{E}_{c'\sim P(c\mid x)}[\log Q(c'\mid x)]\big]+H(c)\)
- 셋째 줄에서 $\log P(c’\mid x)=\log Q(c’\mid x)+\log\frac{P(c’\mid x)}{Q(c’\mid x)}$ 로 쪼개면 KL 발산이 나타나고, 이것이 비음수이므로 버리면 하한이 됩니다.
- 잠재 코드의 엔트로피 $H(c)$ 는 흔한 분포에서 해석적 형식을 가지므로 최적화할 수도 있지만, 논문은 단순성을 위해 코드 분포를 고정하고 $H(c)$ 를 상수로 취급합니다.
🔁 2. 사후분포 샘플링 제거: Lemma 5.1
위 하한은 사후분포를 명시적으로 계산할 필요는 없애지만, 내부 기댓값에서 여전히 $P(c\mid x)$ 로부터 샘플링해야 합니다. 다음 보조정리가 이를 제거합니다.
Lemma 5.1 확률변수 $X$, $Y$ 와 적절한 정칙 조건 아래의 함수 $f(x,y)$ 에 대해
\[\mathbb{E}_{x\sim X,\,y\sim Y\mid x}[f(x,y)]=\mathbb{E}_{x\sim X,\,y\sim Y\mid x,\,x'\sim X\mid y}[f(x',y)]\]증명은 Appendix A 에 있으며, 결합분포 $P(x,y)$ 로 적분을 쓴 뒤 $\int_{x’}P(x’\mid y)dx’=1$ 을 끼워 넣고 순서를 바꾸는 것이 전부입니다. 이 보조정리를 적용하면 변분 하한 $L_{I}(G,Q)$ 는 다음과 같이 사전분포 $P(c)$ 에서 $c$ 를 뽑고 생성기로 $x$ 를 만든 뒤 $\log Q(c\mid x)$ 를 평가하는 형태가 됩니다 (Eq. 5).
\[L_{I}(G,Q)=\mathbb{E}_{c\sim P(c),\,x\sim G(z,c)}[\log Q(c\mid x)]+H(c)=\mathbb{E}_{x\sim G(z,c)}\big[\mathbb{E}_{c'\sim P(c\mid x)}[\log Q(c'\mid x)]\big]+H(c)\leq I(c;G(z,c))\]✅ 3. 하한의 성질과 최종 목적함수 (Eq. 6)
| 성질 | 내용 |
|---|---|
| Monte Carlo 근사 | $L_{I}$ 는 샘플로 쉽게 추정 가능 |
| 최적화 | $Q$ 에 대해서는 직접, $G$ 에 대해서는 재매개변수화 트릭(reparametrization trick)으로 최대화 |
| 타이트함 | $Q$ 가 참 사후분포에 가까워져 $\mathbb{E}{x}[D{KL}(P(\cdot\mid x)|Q(\cdot\mid x))]\to0$ 이면 경계가 타이트해짐 |
| 이산 코드의 최대값 | 하한이 최대 $L_{I}(G,Q)=H(c)$ 에 도달하면 경계가 타이트하고 최대 상호정보 달성 |
GAN 의 학습 절차를 바꾸지 않고 $L_{I}$ 를 목적에 더할 수 있으며, 그 결과가 InfoGAN 입니다.
\[\min_{G,Q}\max_{D}V_{InfoGAN}(D,G,Q)=V(D,G)-\lambda L_{I}(G,Q)\]💡 Key Takeaway 상호정보 → KL 을 버린 변분 하한 → Lemma 5.1 로 사후 샘플링 제거, 이 세 단계가 InfoGAN 을 GAN 에 손실 항 하나 더한 것으로 만듭니다.
구현: 보조 네트워크 $Q$ 와 하이퍼파라미터 (Section 6, Appendix C)
구현에서 보조 분포 $Q$ 는 신경망으로 매개변수화됩니다. 설계의 핵심은 $Q$ 가 판별기 $D$ 와 네트워크 대부분을 공유한다는 점과, 코드 유형에 따라 출력 분포를 다르게 둔다는 점입니다.
🔗 1. $Q$ 와 $D$ 의 공유 구조
| 항목 | 내용 |
|---|---|
| 공유 범위 | 대부분의 실험에서 $Q$ 와 $D$ 는 모든 합성곱 층을 공유 |
| 추가 부분 | 조건부 분포 $Q(c\mid x)$ 의 파라미터를 출력하는 마지막 완전연결층 하나 |
| 비용 | GAN 에 무시할 만한 계산 비용만 추가 |
| 수렴 | $L_{I}(G,Q)$ 는 항상 보통의 GAN 목적보다 빨리 수렴하므로 InfoGAN 은 사실상 GAN 에 공짜로 딸려옴 |
📊 2. 코드 유형별 $Q$ 의 출력
| 코드 유형 | $Q(c_{i}\mid x)$ 의 형태 | 비고 |
|---|---|---|
| 범주형 $c_{i}$ | softmax | 자연스러운 선택 |
| 연속 $c_{j}$ | 인수분해된 가우시안 | 참 사후분포에 따라 더 많은 선택지가 있지만 실험에서는 이것으로 충분. 표준편차는 양수성을 위해 네트워크 출력의 지수 변환으로 매개변수화 |
⚙️ 3. $\lambda$ 와 학습 설정
| 항목 | 설정 |
|---|---|
| $\lambda$ (이산 코드) | 1 로 두면 충분 |
| $\lambda$ (연속 코드) | 미분 엔트로피가 포함되어 스케일이 달라지므로 $\lambda L_{I}$ 가 GAN 목적과 같은 스케일이 되도록 더 작은 값 사용. 의자 실험에서는 연속·이산 코드에 다른 계수를 쓰는 것이 필요했음 |
| 최적화기 | Adam |
| 학습률 | 별도 언급이 없으면 $D$ 는 $2\times10^{-4}$, $G$ 는 $1\times10^{-3}$ |
| 활성화 | 판별기 은닉층 LeakyReLU(기울기 0.1), 생성기 ReLU |
| 정규화 | 대부분의 층 뒤에 배치 정규화 |
| 생성기 구조 | up-convolutional 구조 |
| 안정화 기법 | DCGAN 의 기존 기법만으로 충분했고 새로운 트릭은 도입하지 않음 |
데이터셋별 잠재 코드 구성은 다음과 같습니다 (Appendix C, Table 1–7).
| 데이터셋 | 범주형 코드 | 연속 코드 | 잡음 차원 | 생성기 입력 차원 |
|---|---|---|---|---|
| MNIST | 10 차원 1 개 | 2 개 | 62 | 74 |
| SVHN | 10 차원 4 개 | 4 개 | 124 | 168 |
| CelebA | 10 차원 10 개 | 없음 | 128 | 228 |
| Faces | 없음 | 5 개 | 128 | 133 |
| Chairs | 20 차원 3 개 | 1 개 | 128 | 189 |
Faces 와 Chairs 에서는 $Q$ 와 $D$ 가 같은 네트워크를 공유하고 마지막 층의 출력 유닛만 분리했으며, 학습된 변이마다 별도 설정을 사용했습니다(Table 5, 7).
💡 Key Takeaway $Q$ 는 $D$ 의 머리 하나를 더 단 것입니다. 이산 코드는 softmax 에 $\lambda=1$, 연속 코드는 가우시안에 작은 $\lambda$ 라는 규칙만 기억하면 InfoGAN 을 구현할 수 있습니다.
상호정보 최대화 검증과 MNIST 분리 (Section 7.1, 7.2)
실험의 첫 목표는 상호정보가 제안한 방법으로 효율적으로 최대화되는지 확인하는 것이고, 둘째 목표는 생성기로 한 번에 하나의 잠재 인자만 바꾸어 그 변화가 하나의 의미적 변이만 일으키는지 평가하는 것입니다. 후자는 DC-IGN 이 3D 이미지에서 쓴 평가법과 같습니다.
📈 1. 하한 $L_{I}$ 의 수렴 (Figure 1)
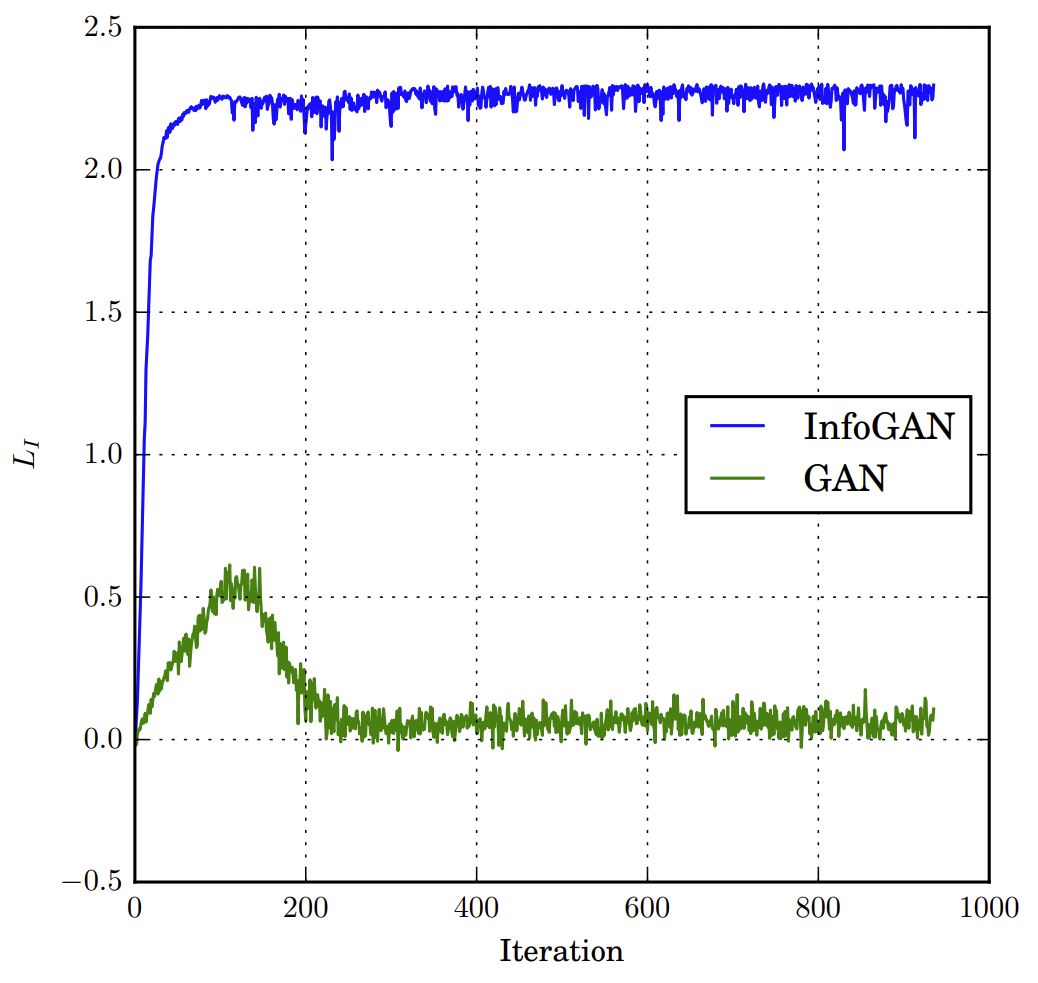
MNIST 에서 균등 범주형 코드 $c\sim\mathrm{Cat}(K=10,p=0.1)$ 로 학습하면 $L_{I}(G,Q)$ 가 $H(c)\approx2.30$ 으로 빠르게 최대화됩니다. 이는 경계 (4) 가 타이트하고 최대 상호정보가 달성되었다는 뜻입니다.
베이스라인으로 생성기에 상호정보 최대화를 명시적으로 장려하지 않은 채 보조 분포 $Q$ 만 붙인 일반 GAN 도 학습했습니다. 표현력 있는 신경망으로 $Q$ 를 매개변수화했으므로 $Q$ 가 참 사후분포를 합리적으로 근사한다고 가정할 수 있고, 따라서 일반 GAN 에서는 잠재 코드와 생성 이미지 사이에 상호정보가 거의 없음을 보여줍니다. 다른 구조에서는 더 높은 상호정보가 나올 수도 있지만 실험에서는 관찰되지 않았고, 이 비교의 요지는 일반 GAN 에는 생성기가 코드를 쓴다는 보장이 없다는 것입니다.
🔢 2. MNIST: 숫자 모양과 스타일의 분리 (Figure 2)
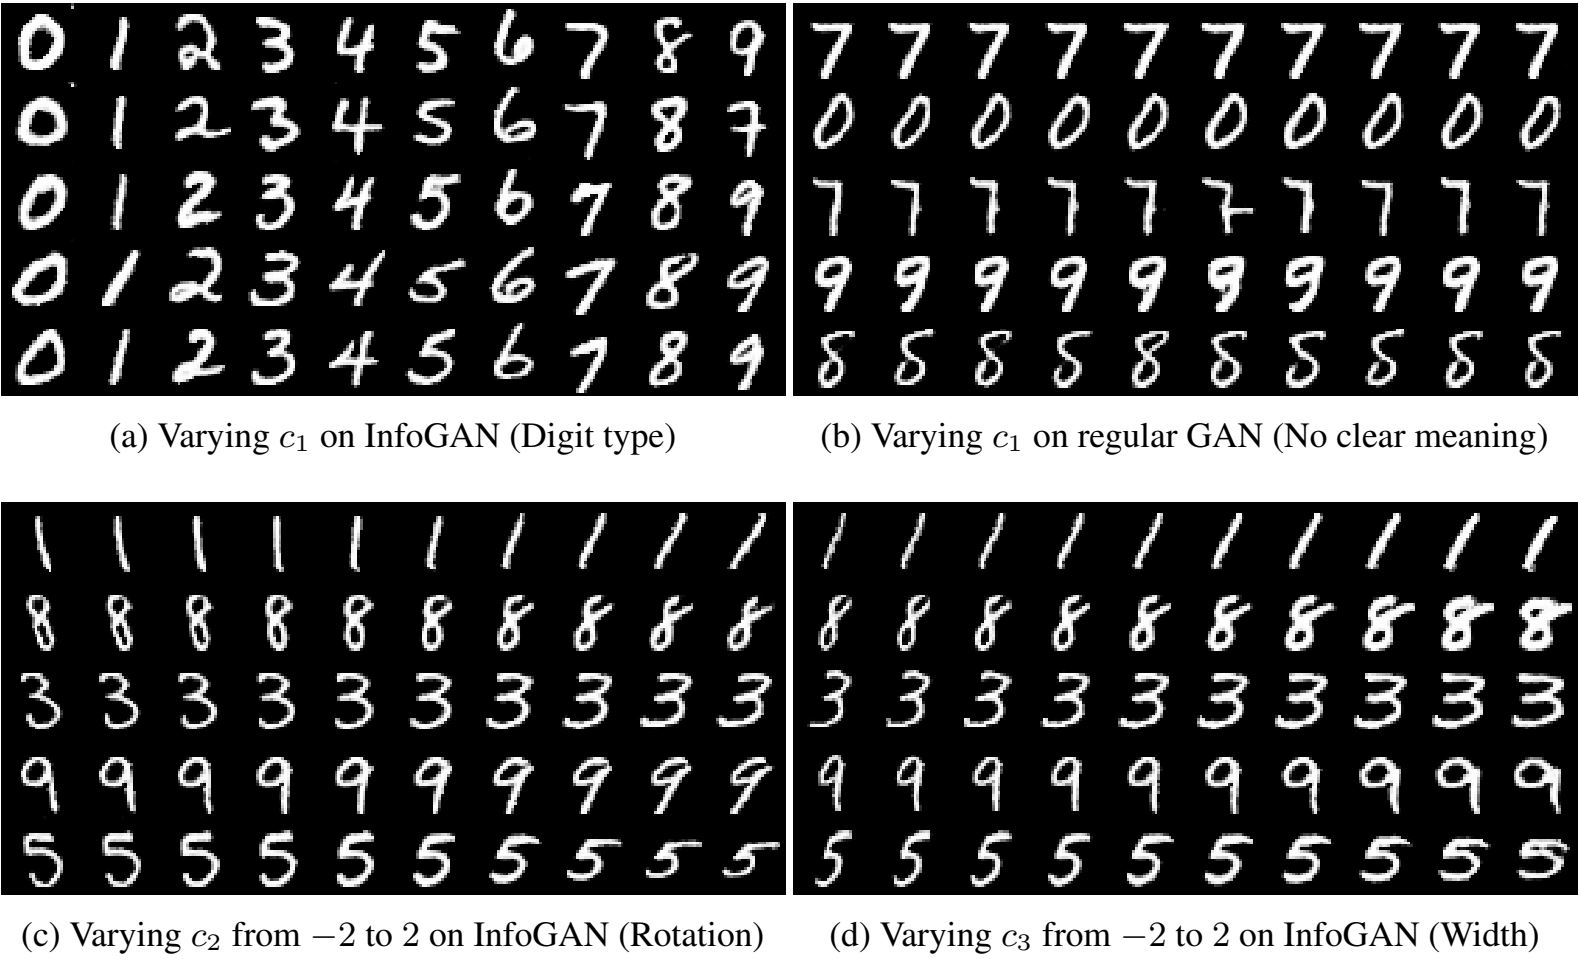
잠재 코드는 불연속 변이를 모델링하는 범주형 코드 $c_{1}\sim\mathrm{Cat}(K=10,p=0.1)$ 하나와 연속 변이를 포착하는 $c_{2},c_{3}\sim\mathrm{Unif}(-1,1)$ 둘입니다.
| 패널 | 코드 | 관찰 |
|---|---|---|
| (a) | $c_{1}$ | 각 범주가 대체로 하나의 숫자 종류에 대응. 범주를 바꾸면 대부분 숫자가 바뀜 |
| (b) | $c_{1}$ (정보 정규화 없는 GAN) | 해석 불가능한 변이 |
| (c) | $c_{2}$ | 작은 값은 왼쪽으로 기운 숫자, 큰 값은 오른쪽으로 기운 숫자 (회전) |
| (d) | $c_{3}$ | 너비를 부드럽게 제어 |
- 라벨 없이 학습했음에도 $c_{1}$ 의 각 범주를 숫자 종류에 대응시키면 5% 오류율의 MNIST 분류기가 됩니다. Figure 2a 둘째 행에서 7 이 9 로 분류된 사례가 보입니다.
- 생성기는 숫자를 단순히 늘리거나 돌리지 않고 두께나 획 스타일 같은 세부를 함께 조정해 자연스러운 이미지를 만듭니다.
- 일반화 검사로 코드를 학습 범위 $[-1,1]$ 대신 $[-2,2]$ 까지 과장해 조작해도 의미 있는 결과가 나왔습니다.
- 범주형 코드는 본질적으로 순서가 없으므로 (a) 는 시각화를 위해 재정렬했습니다.
💡 Key Takeaway Figure 1 은 “하한이 $H(c)$ 에 닿는다”는 정량적 증거, Figure 2 는 “코드 하나가 속성 하나”라는 정성적 증거입니다. 둘이 합쳐져 상호정보 정규화가 실제로 작동함을 보입니다.
3D 데이터와 실제 이미지에서의 분리 표현 (Section 7.2)
더 어려운 데이터셋에서의 실험은 InfoGAN 이 지도 방법과 직접 비교될 수 있는지, 그리고 이전 비지도 방법으로는 비교할 만한 품질의 표현을 얻을 수 없었던 복잡한 데이터에서도 작동하는지를 검증합니다.
🗿 1. 3D 얼굴과 의자: DC-IGN 과의 비교 (Figure 3, 4)
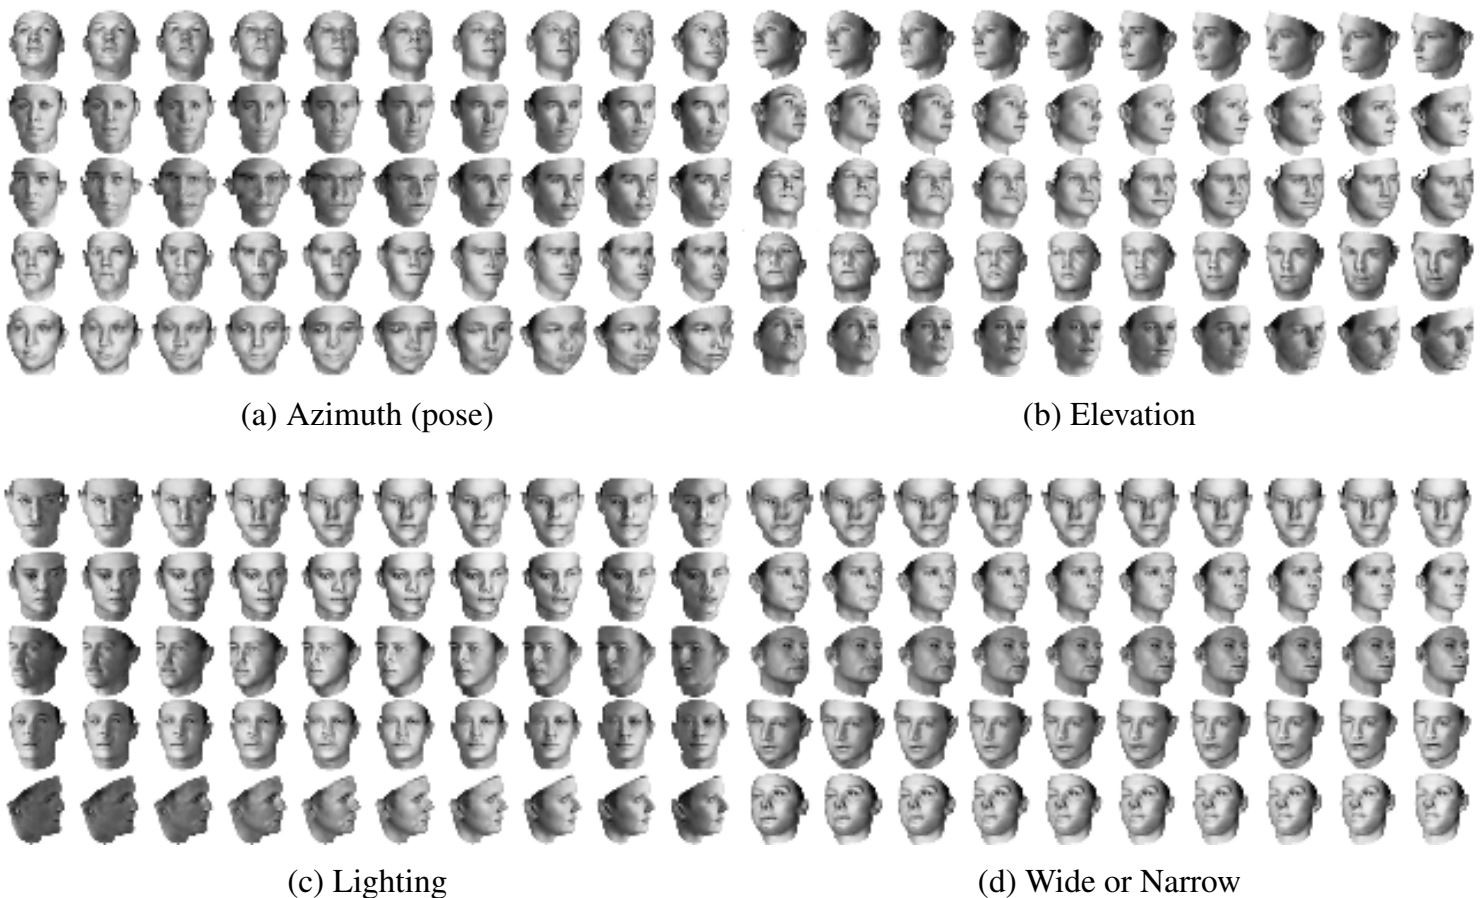
DC-IGN 은 지도를 써서 얼굴의 방위각(포즈), 고도, 조명을 연속 잠재변수로 표현하도록 학습합니다. InfoGAN 은 같은 데이터셋에서 다섯 개의 연속 코드 $c_{i}\sim\mathrm{Unif}(-1,1)$, $1\leq i\leq5$ 만으로 다음을 복원했습니다.
| 패널 | 발견된 인자 | 비고 |
|---|---|---|
| (a) | 방위각 | 서로 다른 얼굴 형태에 걸쳐 일관되게 포착 |
| (b) | 고도 | |
| (c) | 조명 방향 | |
| (d) | 얼굴 너비 | 이전 지도 연구에서 명시적으로 생성되거나 라벨링된 적 없는 변이. 다른 시각 특징을 보존하면서 넓은 얼굴과 좁은 얼굴 사이를 보간 |
DC-IGN 은 지도가 필요하므로 라벨 없는 변이에 대한 잠재 코드를 학습할 수 없고, 따라서 데이터에서 두드러진 변이 인자를 자동으로 발견할 수 없습니다. (d) 는 InfoGAN 이 이를 스스로 해낸 사례입니다. 각 인자에 대해 5 회 랜덤 실행 중 이전 지도 결과와 가장 닮은 표현을 제시해 직접 비교했습니다.
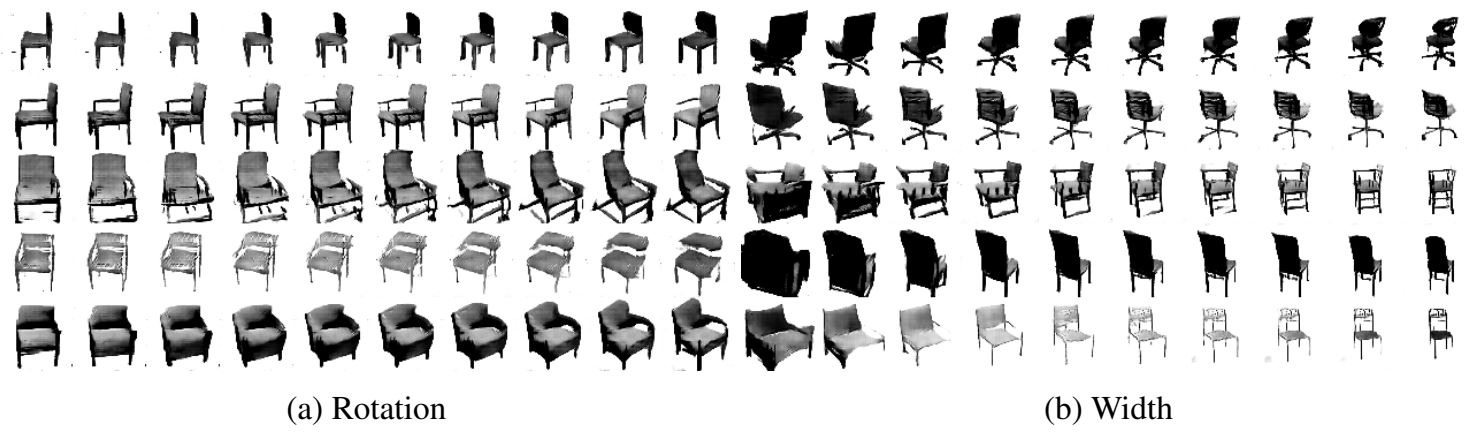
의자 데이터셋에서는 네 개의 범주형 코드 $c_{1},\dots,c_{4}\sim\mathrm{Cat}(K=20,p=0.05)$ 와 연속 코드 $c_{5}\sim\mathrm{Unif}(-1,1)$ 하나를 썼습니다. DC-IGN 이 학습하는 회전을 연속 코드로 똑같이 학습했고(Figure 4a), 추가로 하나의 연속 코드로 너비가 다른 유사 의자 유형 사이를 연속 보간할 수 있음을 보였습니다(Figure 4b). 학습된 포즈 사상은 의자 유형에 따라 달라집니다.
🏠 2. SVHN: 잡음 많은 실제 데이터 (Figure 5)
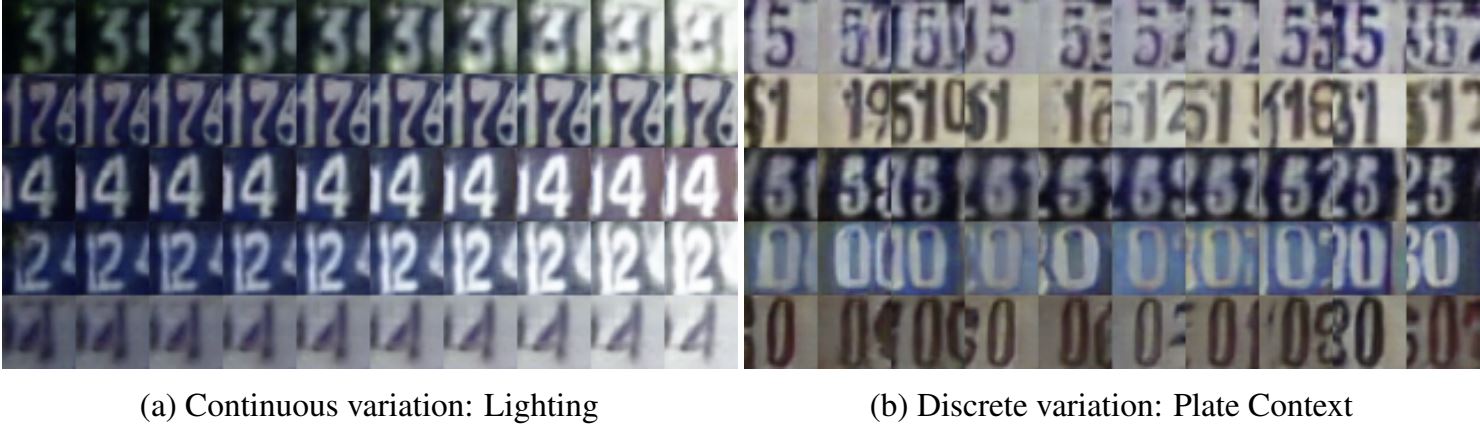
SVHN 은 잡음이 많고 해상도가 가변적이며 방해 숫자가 있고 같은 객체의 여러 변이가 없어 해석 가능한 표현을 학습하기 훨씬 어렵습니다. 네 개의 10 차원 범주형 변수와 두 개의 균등 연속 변수를 코드로 썼습니다.
| 패널 | 발견 |
|---|---|
| (a) | 연속 코드 하나가 조명 변이를 포착. 데이터셋에서 각 숫자는 하나의 조명 조건으로만 존재함에도 |
| (b) | 범주형 코드 하나가 중앙 숫자의 맥락을 제어. 2 열에서는 오른쪽에 9 가, 3 열에서는 0 이 부분적으로 나타나, 중앙 숫자와 맥락을 분리했음을 시사 |
👩 3. CelebA: 포즈, 안경, 헤어스타일, 감정 (Figure 6)
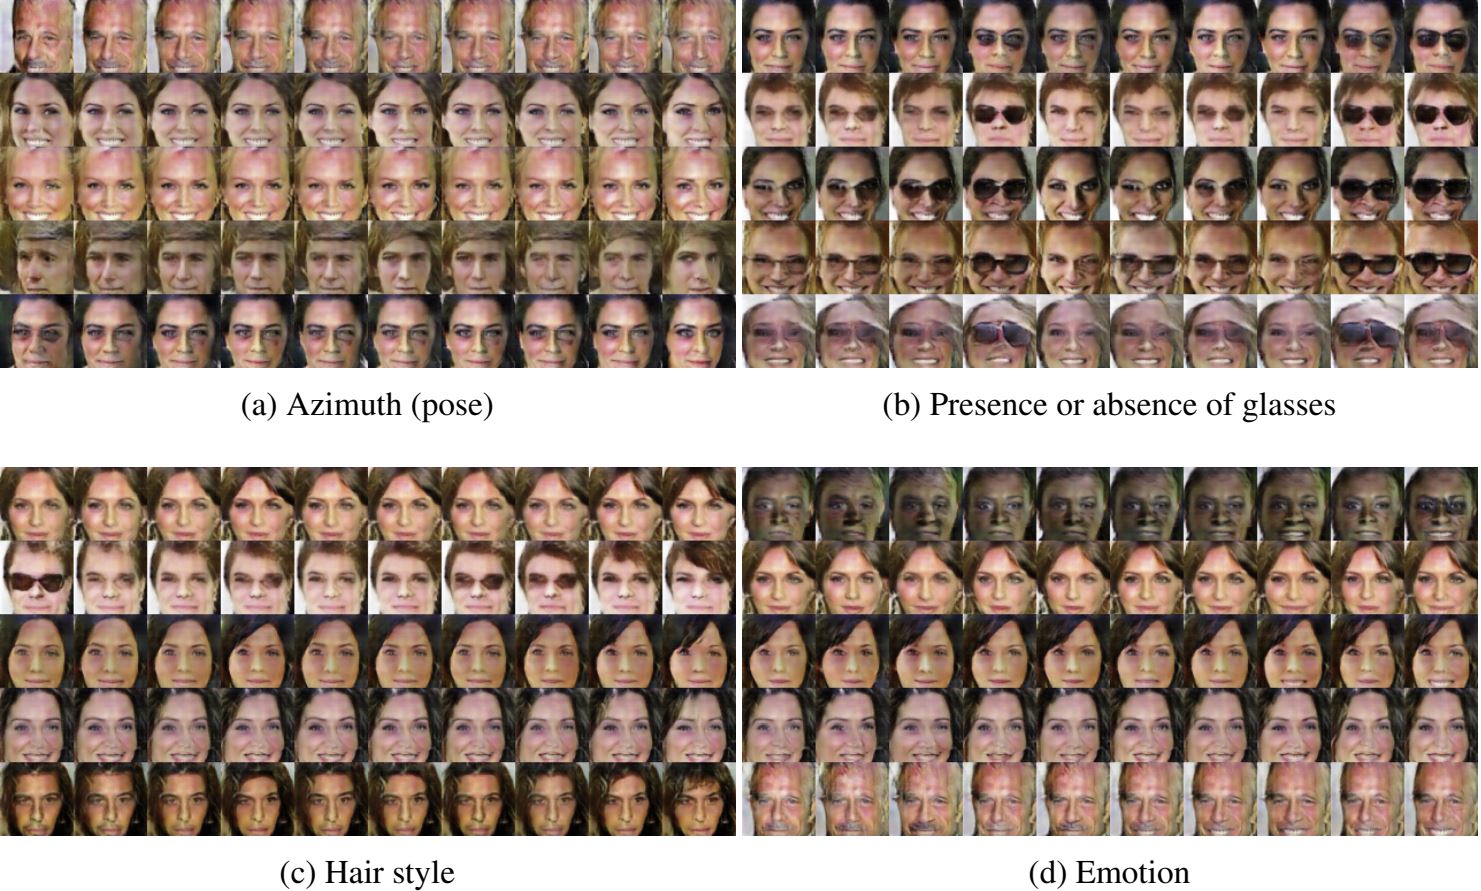
CelebA 는 큰 포즈 변이와 배경 잡동사니가 있는 20 만 장의 유명인 이미지입니다. 각 10 차원인 균등 범주형 변수 10 개로 잠재 변이를 모델링했습니다.
| 패널 | 발견 |
|---|---|
| (a) | 범주형 코드가 연속적 성격의 방위각을 이산화해 포착. 어떤 얼굴도 여러 포즈로 등장하지 않음에도 |
| (b) | 범주형 코드의 일부가 안경 유무를 신호 |
| (c) | 헤어스타일 변이, 대략 머리숱이 적은 쪽에서 많은 쪽으로 |
| (d) | 감정 변화, 대략 굳은 표정에서 행복한 표정으로 |
💡 Key Takeaway InfoGAN 은 지도 방법 DC-IGN 이 찾는 인자를 똑같이 찾을 뿐 아니라, 라벨이 없어 지도 방법이 결코 찾을 수 없는 인자(얼굴 너비, 의자 너비, SVHN 조명)까지 발견했습니다.
Wake-Sleep 과의 연결: “Sleep-Sleep” 해석 (Appendix B)
Helmholtz 머신 관점에서 InfoGAN 을 보면, $P_{G}(x\mid c)$ 가 생성 분포이고 $Q(c\mid x)$ 가 인식 분포입니다. Helmholtz 머신을 학습하는 고전 알고리즘인 Wake-Sleep 은 “wake” 단계와 “sleep” 단계를 번갈아 수행합니다.
🌅 1. Wake 단계와 Sleep 단계
| 단계 | 갱신 대상 | 목적함수 | 데이터 출처 |
|---|---|---|---|
| Wake | 생성기 $G$ | $\max_{G}\mathbb{E}{x\sim Data,\,c\sim Q(c\mid x)}[\log P{G}(x\mid c)]$ ($\log P_{G}(x)$ 의 변분 하한) | 실제 데이터 |
| Sleep | 보조 분포 $Q$ | $\max_{Q}\mathbb{E}{c\sim P(c),\,x\sim P{G}(x\mid c)}[\log Q(c\mid x)]$ | 현재 생성기가 “꿈꾼” 샘플 |
😴 2. InfoGAN 은 왜 “Sleep-Sleep” 인가
- 대리 손실 $L_{I}$ 를 $Q$ 에 대해 최적화하는 단계는 Wake-Sleep 의 sleep 단계 갱신과 정확히 같습니다.
- 차이는 $L_{I}$ 를 $G$ 에 대해 최적화할 때 나타납니다. InfoGAN 은 생성기 $G$ 가 잠재 코드의 전체 사전분포 $P(c)$ 에 대해 코드 $c$ 를 활용하도록 장려합니다. 즉 생성기도 sleep 단계에서 갱신되므로 “Sleep-Sleep” 알고리즘으로 해석할 수 있습니다.
🧭 3. 이 해석이 말해 주는 것
이 해석은 InfoGAN 이 이전 생성 모델링 기법과 다른 점을 부각합니다. 생성기가 잠재 코드에 정보를 실어 나르도록 명시적으로 장려된다는 것이며, 같은 원리가 다른 생성 모델에도 적용될 수 있음을 시사합니다. 논문은 결론에서 상호정보로 표현을 유도하는 핵심 아이디어를 VAE 에 적용하는 것을 유망한 후속 연구로 꼽습니다.
💡 Key Takeaway $Q$ 갱신은 Wake-Sleep 의 sleep 단계 그 자체이고, $G$ 갱신까지 sleep 단계에서 한다는 점이 InfoGAN 의 고유성입니다. 생성기가 코드를 “말하도록” 강제하는 것이 핵심입니다.
한계와 열린 방향
논문의 한계는 본문에 명시된 것과 설계상 내재된 것으로 나눌 수 있습니다. 저자들이 제시한 후속 방향과 함께 정리합니다.
⚠️ 1. 명시된 한계와 가정
| 항목 | 내용 |
|---|---|
| 코드 구조는 사람이 지정 | 코드의 개수·유형·차원(예: MNIST 의 1 범주형 + 2 연속)은 사전 지식으로 명시해야 함. 어떤 인자가 발견될지는 지정할 수 없지만, 몇 개의 어떤 종류 인자가 있는지는 지정해야 함 |
| $H(c)$ 고정 | 코드 분포를 고정하고 엔트로피를 상수로 취급. 최적화 가능하지만 시도하지 않음 |
| 연속 코드의 $\lambda$ | 미분 엔트로피 스케일 때문에 수동 조정 필요. 의자에서는 연속·이산에 다른 계수 필요 |
| 결과 선택 | 3D 얼굴·의자 결과는 5 회 랜덤 실행 중 지도 결과와 가장 닮은 것을 제시. 실행 간 변동성 존재 |
| 베이스라인 가정 | 일반 GAN 의 상호정보가 낮다는 결론은 $Q$ 가 참 사후분포를 잘 근사한다는 가정에 의존. 다른 구조에서는 달라질 수 있음을 저자들도 인정 |
🔬 2. 평가 방법의 한계
- 분리 표현의 품질은 주로 육안 검사(한 코드를 바꿀 때 한 속성만 변하는가)로 평가됩니다. MNIST 의 5% 분류 오류를 제외하면 정량 지표가 없습니다.
- 코드가 포착한 인자에 대한 이름(회전, 너비, 감정)은 사후적으로 사람이 붙인 것입니다.
🔗 3. 저자들이 제안한 확장과 후속 연구
| 방향 | 내용 |
|---|---|
| VAE 로의 확장 | 상호정보로 표현을 유도하는 핵심 아이디어를 VAE 에 적용 |
| 계층적 잠재 표현 | 코드에 계층 구조를 부여 |
| 준지도 학습 | 더 나은 코드로 준지도 학습 개선 |
| 데이터 탐색 도구 | InfoGAN 을 고차원 데이터 발견 도구로 활용 |
이후 $\beta$-VAE 류의 연구가 VAE 측에서 분리 표현을 다루었고, 분리 표현을 정량화하는 지표들이 제안되었습니다. InfoGAN 의 “보조 인식 네트워크를 판별기와 공유한다”는 설계는 조건부 GAN 의 보조 분류기 계열에도 영향을 주었습니다.
💡 Key Takeaway InfoGAN 은 “무엇이 발견될지”는 지정하지 않지만 “몇 개의 어떤 종류 인자를 찾을지“는 지정해야 합니다. 이 설계 선택이 비지도 분리의 강점이자 한계입니다.