 You know maize mean?
Unsupervised Representation Learning with Deep Convolutional Generative Adversarial Networks
0. Summary
기본 정보 : ArXiv,2015.11.19 (ICLR 2016), Unsupervised Representation Learning with Deep Convolutional Generative Adversarial Networks
연구 배경
합성곱 신경망(CNN)을 이용한 지도학습은 컴퓨터 비전에서 폭넓게 채택되었지만, CNN 을 이용한 비지도학습은 상대적으로 주목받지 못했다. 라벨 없는 이미지와 비디오는 사실상 무제한으로 존재하므로, 여기서 좋은 중간 표현을 학습해 분류 같은 지도 과제에 재사용할 수 있다면 큰 이점이 있다. GAN 은 최대우도 기법의 매력적인 대안이고 픽셀 단위 평균제곱오차 같은 휴리스틱 비용 함수가 없다는 점에서 표현 학습에 적합해 보였지만, 학습이 불안정해 종종 의미 없는 출력을 내는 생성기로 끝났고, 다층 GAN 이 무엇을 학습하는지 이해하고 시각화하려는 연구도 거의 없었다. CNN 으로 GAN 을 확장하려던 과거 시도들은 실패했고, 그 때문에 LAPGAN 은 저해상도 이미지를 반복적으로 업스케일하는 우회 접근을 택했다.
제안 방법
저자들은 광범위한 모델 탐색 끝에 다양한 데이터셋에서 안정적으로 학습되고 더 높은 해상도와 더 깊은 생성 모델을 허용하는 구조적 제약(architectural constraints) 의 집합을 찾아내고, 이 구조 계열을 DCGAN(Deep Convolutional GAN) 이라 명명한다. 핵심은 최근 CNN 구조 변화 세 가지를 채택·수정한 것이다. (1) 풀링을 스트라이드 합성곱으로 대체하는 all-convolutional net, (2) 합성곱 특징 위의 완전연결층 제거, (3) 배치 정규화(Batch Normalization). 여기에 생성기에는 ReLU 와 출력층 Tanh, 판별기에는 LeakyReLU 를 쓴다. 학습된 판별기의 합성곱 특징은 선형 분류기의 입력으로 재사용되고, 생성기의 필터와 잠재 공간 $Z$ 는 시각화·벡터 연산으로 분석된다.
발견 사실
Imagenet-1k 로 학습한 DCGAN 판별기의 특징에 L2-SVM 을 얹은 CIFAR-10 분류 정확도는 82.8% 로 모든 K-means 기반 접근을 능가했다(Table 1). SVHN 에서 1000 개 라벨만 쓴 분류는 22.48% 테스트 오류로 당시 최고 성능이었고, 같은 구조의 순수 지도 CNN 은 28.87% 검증 오류에 그쳐 구조 자체가 아니라 적대적 학습이 성능의 원천임을 확인했다(Table 2). LSUN 침실 데이터셋에서 1 에폭만에 그럴듯한 샘플을 생성했고(Figure 2), 잠재 공간을 걸으면 창문이 없는 방이 거대한 창문이 있는 방으로 부드럽게 바뀌는 의미적 전이가 관찰되었다(Figure 4). 창문에 반응하는 생성기 특징 맵을 제거하자 네트워크는 창문을 그리지 않거나 문·거울로 대체했다(Figure 6). 얼굴 샘플의 $Z$ 벡터로 “안경 쓴 남자 - 안경 없는 남자 + 안경 없는 여자 = 안경 쓴 여자” 같은 벡터 산술이 성립했고(Figure 7), 회전 벡터로 포즈를 선형 조작할 수 있었다(Figure 8).
핵심 기여
- 안정적 합성곱 GAN 구조 가이드라인 : 풀링 제거, 배치 정규화, 완전연결 은닉층 제거, 생성기 ReLU/Tanh, 판별기 LeakyReLU 라는 다섯 규칙으로 대부분의 설정에서 안정적으로 학습되는 DCGAN 구조 계열을 제안·평가했다.
- 비지도 표현의 전이 가능성 입증 : 학습된 판별기를 CIFAR-10, SVHN 분류의 특징 추출기로 사용해 다른 비지도 알고리즘과 경쟁하는 성능을 보였고, 학습 도메인과 다른 데이터셋에서도 작동함을 확인했다.
- 생성기 내부의 해석 : 필터 시각화로 특정 필터가 특정 객체(침대, 창문)를 그리도록 학습됨을 보였고, 잠재 공간 보간과 $Z$ 벡터 산술로 생성기가 의미적 속성을 선형적으로 모델링함을 순수 비지도 모델에서 처음 입증했다.
관련 개념
DCGAN 구조 가이드라인
DCGAN 의 구조 가이드라인은 지도학습 문헌에서 흔히 쓰이는 CNN 구조로 GAN 을 확장하려다 겪은 어려움 끝에 발견된 경험 법칙들입니다. 논문은 이를 “안정적인 Deep Convolutional GAN 을 위한 구조 지침”이라는 다섯 항목으로 정리합니다.
🧱 1. 다섯 가지 규칙
| 규칙 | 생성기 | 판별기 | 근거 |
|---|---|---|---|
| 풀링 제거 | 분수 스트라이드 합성곱(fractional-strided convolution) | 스트라이드 합성곱 | all-convolutional net 을 따라 네트워크가 자체 공간 업샘플링·다운샘플링을 학습 |
| 배치 정규화 | 사용 (출력층 제외) | 사용 (입력층 제외) | 초기화 불량에서 오는 학습 문제를 해결하고 깊은 모델의 기울기 흐름 개선 |
| 완전연결 은닉층 제거 | 첫 층만 행렬곱 후 4차원 텐서로 reshape | 마지막 합성곱 층을 flatten 해 단일 시그모이드로 | 전역 평균 풀링은 안정성을 높였지만 수렴 속도를 해침. 최상위 합성곱 특징을 입출력에 직접 연결하는 중간안이 잘 작동 |
| 활성화 (G) | 모든 층 ReLU, 출력층은 Tanh | – | 유계 활성화가 색 공간을 빠르게 포화·커버하도록 학습 |
| 활성화 (D) | – | 모든 층 LeakyReLU | 특히 고해상도 모델링에서 잘 작동. 원래 GAN 논문의 maxout 과 대비 |
🔋 2. 배치 정규화의 역할과 예외
배치 정규화는 각 유닛의 입력을 평균 0, 분산 1 로 정규화해 학습을 안정화합니다. 논문은 이것이 깊은 생성기가 학습을 시작하게 만드는 데 결정적이었다고 보고합니다. 특히 생성기가 모든 샘플을 한 점으로 붕괴시키는 GAN 의 흔한 실패 모드를 막아 주었습니다.
그러나 모든 층에 직접 적용하면 샘플 진동(sample oscillation)과 모델 불안정이 생겼고, 이는 생성기 출력층과 판별기 입력층에 배치 정규화를 적용하지 않음으로써 해결되었습니다.
🏗️ 3. LSUN 생성기 구조 (Figure 1)
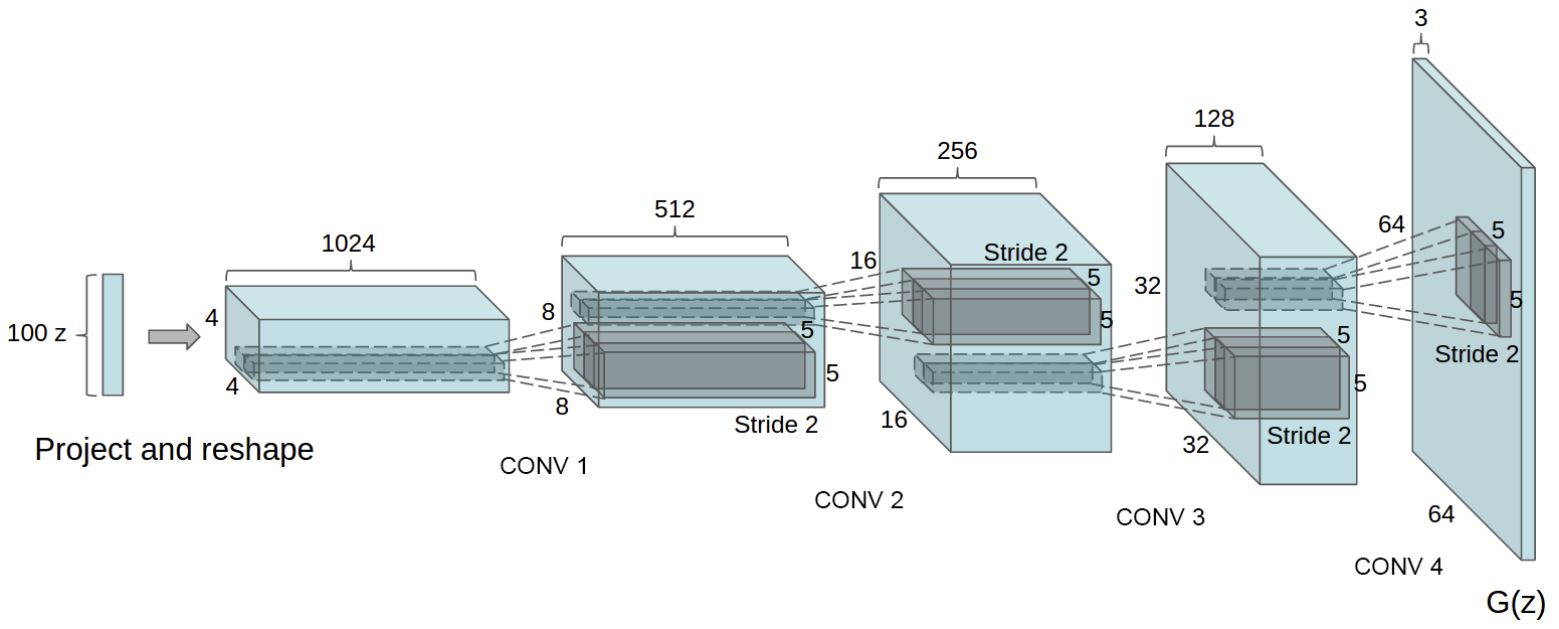
| 단계 | 내용 |
|---|---|
| 입력 | 100 차원 균등분포 $Z$ |
| 사영 | 많은 특징 맵을 가진 작은 공간 크기의 합성곱 표현으로 사영 (행렬곱 후 reshape) |
| 업샘플링 | 네 번의 분수 스트라이드 합성곱 |
| 출력 | $64\times64$ 픽셀 이미지 |
논문은 분수 스트라이드 합성곱이 일부 최근 논문에서 “deconvolution” 이라고 잘못 불린다고 명시합니다. 완전연결층이나 풀링층은 전혀 쓰이지 않습니다.
💡 Key Takeaway DCGAN 의 다섯 규칙은 이론적 유도가 아니라 광범위한 탐색에서 살아남은 경험 법칙입니다. 그럼에도 이후 수년간 GAN 구조의 사실상 표준이 되었습니다.
적대적 학습 세부 설정 (Section 4)
학습 세부 사항은 재현성 측면에서 중요한 부분입니다. 세 데이터셋(LSUN, Imagenet-1k, 자체 수집 Faces)에서 공통 하이퍼파라미터로 학습했습니다.
⚙️ 1. 공통 하이퍼파라미터
| 항목 | 값 | 비고 |
|---|---|---|
| 전처리 | Tanh 범위 $[-1,1]$ 로 스케일링만 | 그 외 전처리 없음 |
| 미니배치 | 128 | 미니배치 SGD |
| 가중치 초기화 | 평균 0, 표준편차 0.02 정규분포 | |
| LeakyReLU 기울기 | 0.2 | 모든 모델 |
| 최적화기 | Adam | 이전 GAN 은 모멘텀 사용 |
| 학습률 | 0.0002 | 권장값 0.001 은 너무 높았음 |
| $\beta_{1}$ | 0.5 | 권장값 0.9 는 학습 진동·불안정 유발 |
이 설정, 특히 Adam 에 학습률 0.0002 와 $\beta_{1}=0.5$ 는 이후 Pix2Pix 를 비롯한 많은 GAN 논문이 그대로 채택했습니다.
🛏️ 2. LSUN 침실과 중복 제거 (Section 4.1)
생성 이미지 모델의 샘플 품질이 좋아지면서 훈련 샘플 과적합·암기에 대한 우려가 커졌습니다. 저자들은 300 만 장이 조금 넘는 LSUN 침실 데이터셋으로 모델이 더 많은 데이터와 더 높은 해상도에 어떻게 확장되는지 보이면서, 동시에 암기가 아님을 입증하려 했습니다.
- 1 에폭 샘플(Figure 2) : 온라인 학습을 모사. 작은 학습률과 미니배치 SGD 로 학습하므로 이론적으로는 암기가 가능해도 경험적으로 그럴 가능성이 낮다고 주장합니다.
- 수렴 후 샘플(Figure 3) : 5 에폭 학습. 일부 침대의 걸레받이처럼 여러 샘플에 반복되는 잡음 질감이 보여 시각적 과소적합(under-fitting) 의 증거로 해석됩니다.
- 중복 제거 : $32\times32$ 다운샘플 중앙 크롭에 3072-128-3072 잡음제거 드롭아웃 정규화 ReLU 오토인코더를 맞추고, 코드 층 활성화를 임계값으로 이진화해 시맨틱 해싱으로 선형 시간 중복 제거를 수행했습니다. 해시 충돌의 육안 검사에서 거짓 양성률은 100 분의 1 미만으로 추정되었고 약 275,000 개의 근사 중복을 제거했습니다.
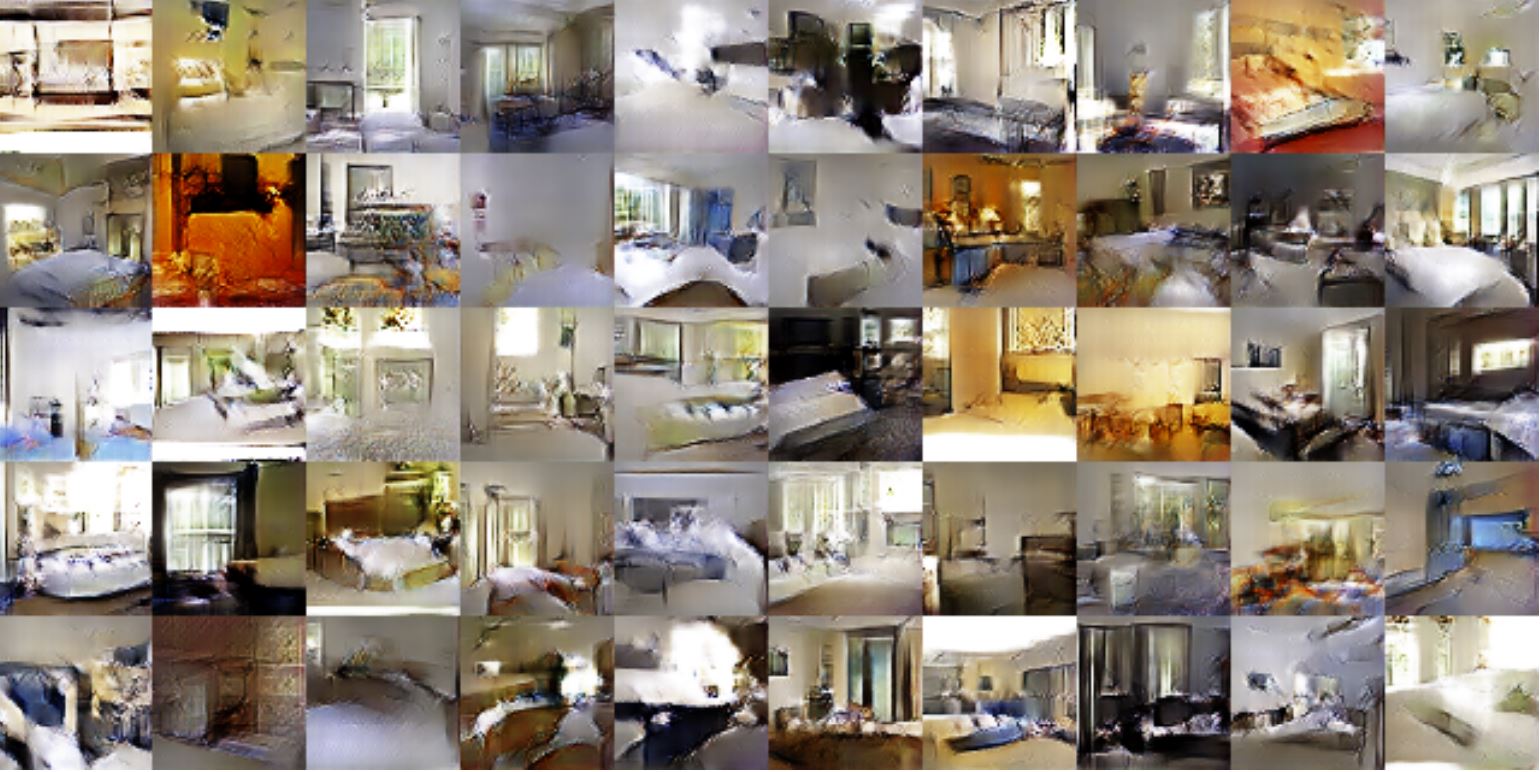
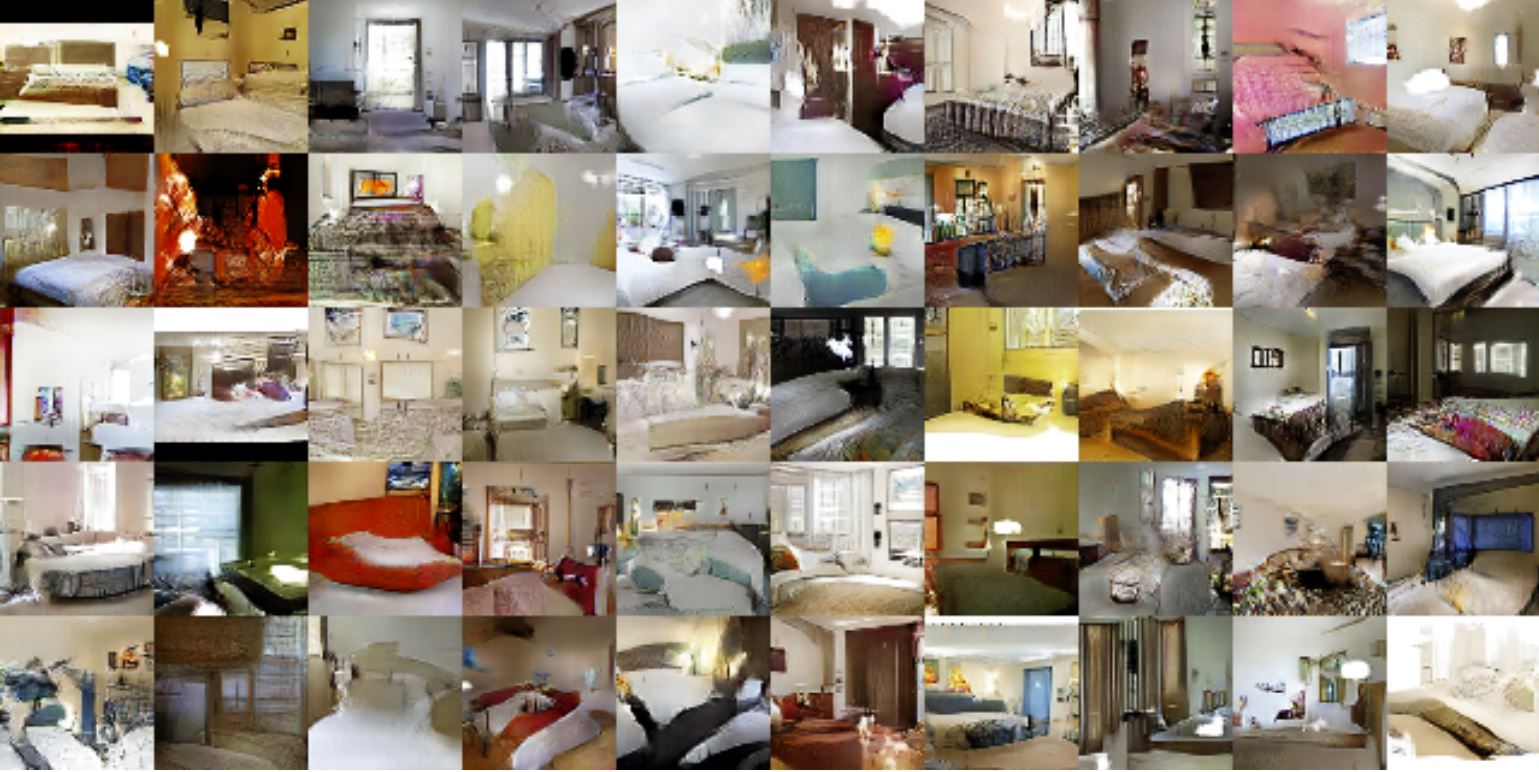
👤 3. Faces 와 Imagenet-1k
| 데이터셋 | 구성 |
|---|---|
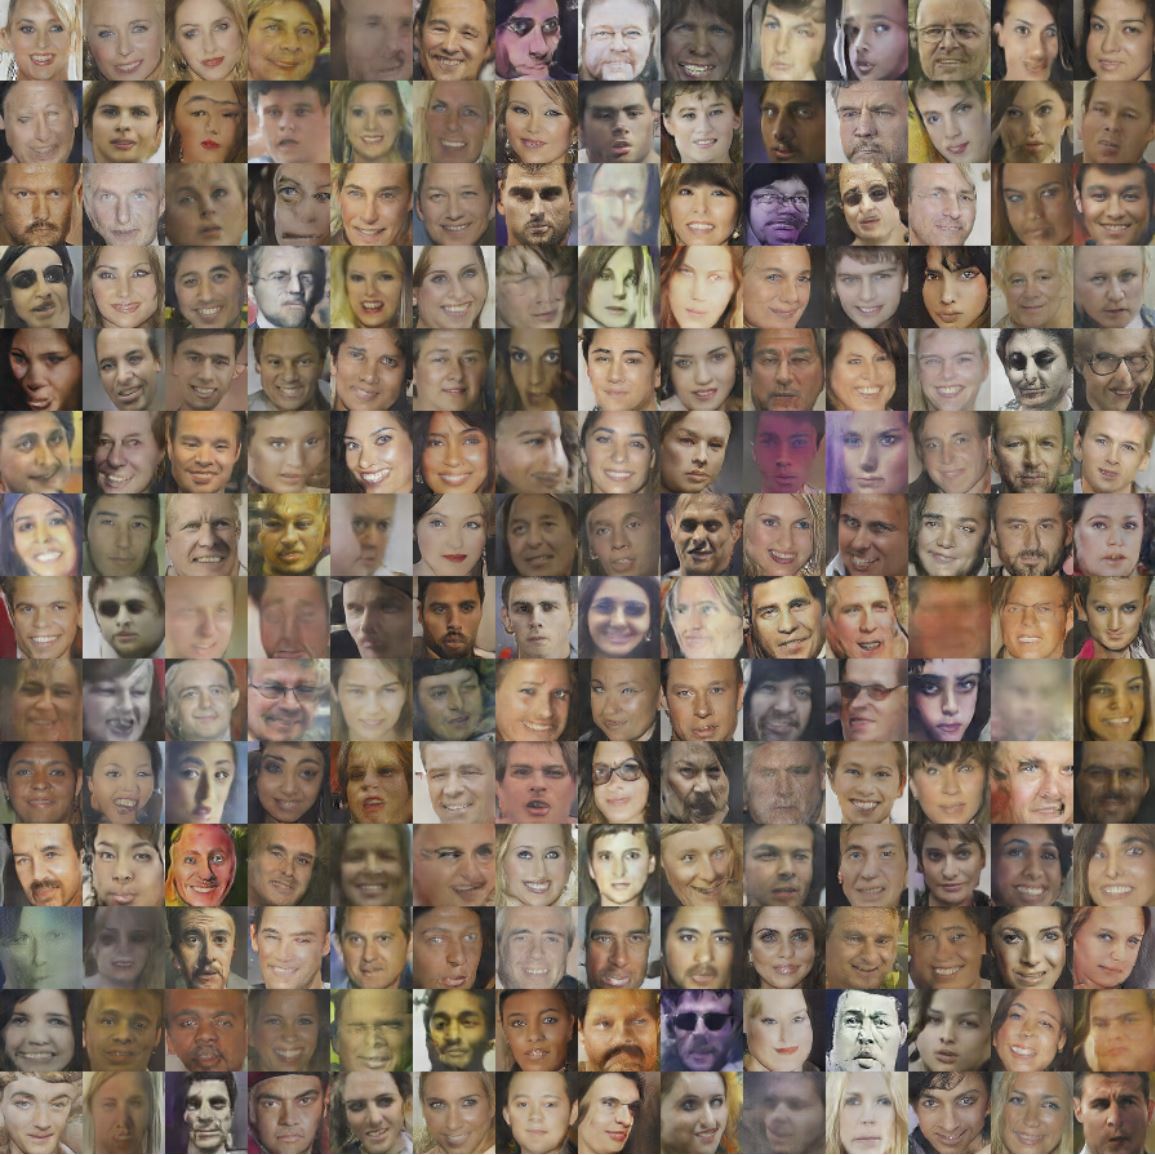
| Faces | dbpedia 에서 현대에 태어난 인물 이름을 얻어 웹 이미지 질의로 수집. 1 만 명의 300 만 장 이미지에 OpenCV 얼굴 검출기를 돌려 충분히 고해상도인 약 350,000 개 얼굴 박스를 학습에 사용 |
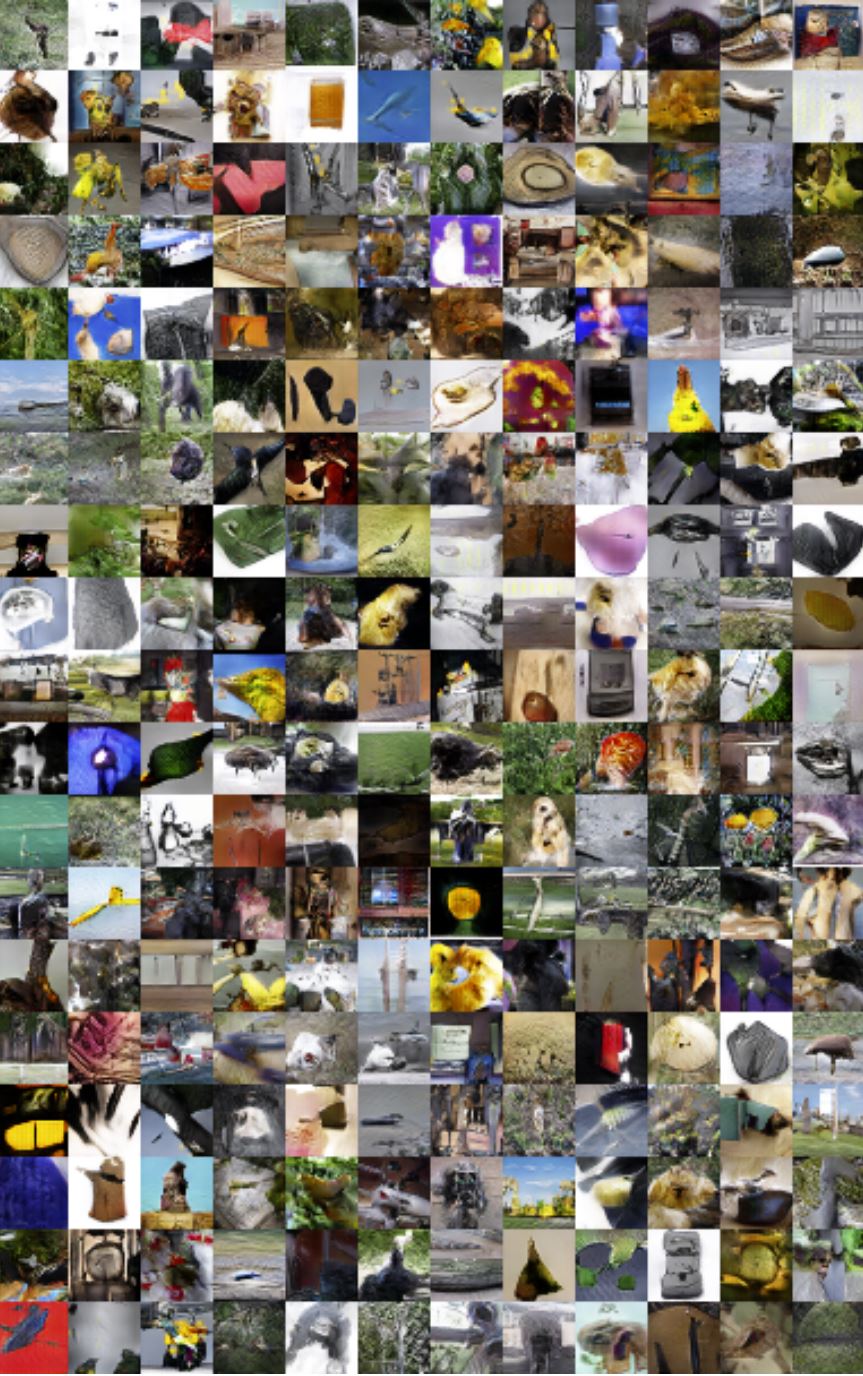
| Imagenet-1k | 자연 이미지 소스. $32\times32$ 최소 리사이즈 중앙 크롭 |
두 데이터셋 모두 데이터 증강은 적용하지 않았습니다.
💡 Key Takeaway “Adam, lr 0.0002, $\beta_{1}$ 0.5, 배치 128, 초기화 std 0.02, LeakyReLU 0.2” 는 DCGAN 이 남긴 GAN 학습 레시피입니다. 중복 제거와 1 에폭 샘플은 암기 논란에 대한 선제적 대응입니다.
판별기를 특징 추출기로: CIFAR-10 과 SVHN (Section 5)
비지도 표현 학습의 품질 평가에서 흔한 기법은 학습된 모델을 지도 데이터셋의 특징 추출기로 쓰고 그 위에 맞춘 선형 모델의 성능을 보는 것입니다. DCGAN 은 Imagenet-1k 에서 학습한 판별기를 이 용도로 사용합니다.
🔬 1. 특징 추출 파이프라인
| 단계 | 내용 |
|---|---|
| 1 | Imagenet-1k 로 DCGAN 학습 |
| 2 | 판별기의 모든 층 합성곱 특징을 사용 |
| 3 | 각 층 표현을 맥스풀링해 $4\times4$ 공간 격자로 만듦 |
| 4 | flatten 후 연결해 28,672 차원 벡터 구성 |
| 5 | 정규화된 선형 L2-SVM 분류기 학습 |
📊 2. CIFAR-10 결과 (Table 1)
| 모델 | 정확도 | 정확도 (클래스당 400) | 최대 특징 유닛 수 |
|---|---|---|---|
| 1 Layer K-means | 80.6% | 63.7% ($\pm0.7\%$) | 4800 |
| 3 Layer K-means Learned RF | 82.0% | 70.7% ($\pm0.7\%$) | 3200 |
| View Invariant K-means | 81.9% | 72.6% ($\pm0.7\%$) | 6400 |
| Exemplar CNN | 84.3% | 77.4% ($\pm0.2\%$) | 1024 |
| DCGAN (ours) + L2-SVM | 82.8% | 73.8% ($\pm0.4\%$) | 512 |
- DCGAN 은 모든 K-means 기반 접근을 능가하지만 Exemplar CNN 에는 미치지 못합니다. Exemplar CNN 은 공격적으로 증강된 예시 샘플을 구별하도록 일반 판별 CNN 을 비지도로 학습하는 기법입니다.
- 판별기의 최상위 층 특징 맵은 512 개로 K-means 기법보다 훨씬 적지만, 여러 층의 $4\times4$ 공간 위치 때문에 총 특징 벡터는 더 큽니다.
- DCGAN 은 CIFAR-10 으로 학습된 적이 없으므로 이 실험은 학습된 특징의 도메인 강건성도 보여줍니다. 판별기 표현을 미세조정하면 더 개선될 수 있지만 후속 연구로 남겼습니다.
🏠 3. SVHN 1000 라벨 결과 (Table 2)
라벨 데이터가 희소한 상황을 가정해, non-extra 집합에서 10,000 개 검증 집합을 분리하고 클래스 균등 분포의 1000 개 훈련 예시만으로 L2-SVM 을 학습했습니다.
| 모델 | 오류율 |
|---|---|
| KNN | 77.93% |
| TSVM | 66.55% |
| M1+KNN | 65.63% |
| M1+TSVM | 54.33% |
| M1+M2 | 36.02% |
| SWWAE without dropout | 27.83% |
| SWWAE with dropout | 23.56% |
| DCGAN (ours) + L2-SVM | 22.48% |
| Supervised CNN with the same architecture | 28.87% (validation) |
핵심 대조 실험은 마지막 행입니다. DCGAN 과 같은 구조의 순수 지도 CNN 을 같은 데이터로 학습하고 64 회 랜덤 서치로 하이퍼파라미터를 최적화했는데도 28.87% 검증 오류로 유의하게 나빴습니다. 즉 성능의 원천은 CNN 구조가 아니라 적대적 학습으로 얻은 표현입니다.
💡 Key Takeaway DCGAN 판별기는 라벨 없이 학습했음에도 K-means 계열을 넘는 특징을 제공했고, 1000 라벨 SVHN 에서 당시 최고 성능을 냈습니다. GAN 이 표현 학습 도구가 될 수 있음을 보인 첫 강력한 증거입니다.
생성기 내부 들여다보기: 잠재 공간과 필터 (Section 6)
네트워크 내부 조사에서 저자들은 두 가지를 의도적으로 하지 않습니다. 훈련 집합에 대한 최근접 이웃 탐색은 픽셀·특징 공간 모두 작은 이미지 변환에 쉽게 속으므로 하지 않고, 로그우도 지표도 나쁜 지표이므로 쓰지 않습니다. 대신 잠재 공간 보행, 판별기 특징 시각화, 생성기 특징 맵 제거로 내부를 분석합니다.
🚶 1. 잠재 공간 걷기 (Section 6.1, Figure 4)
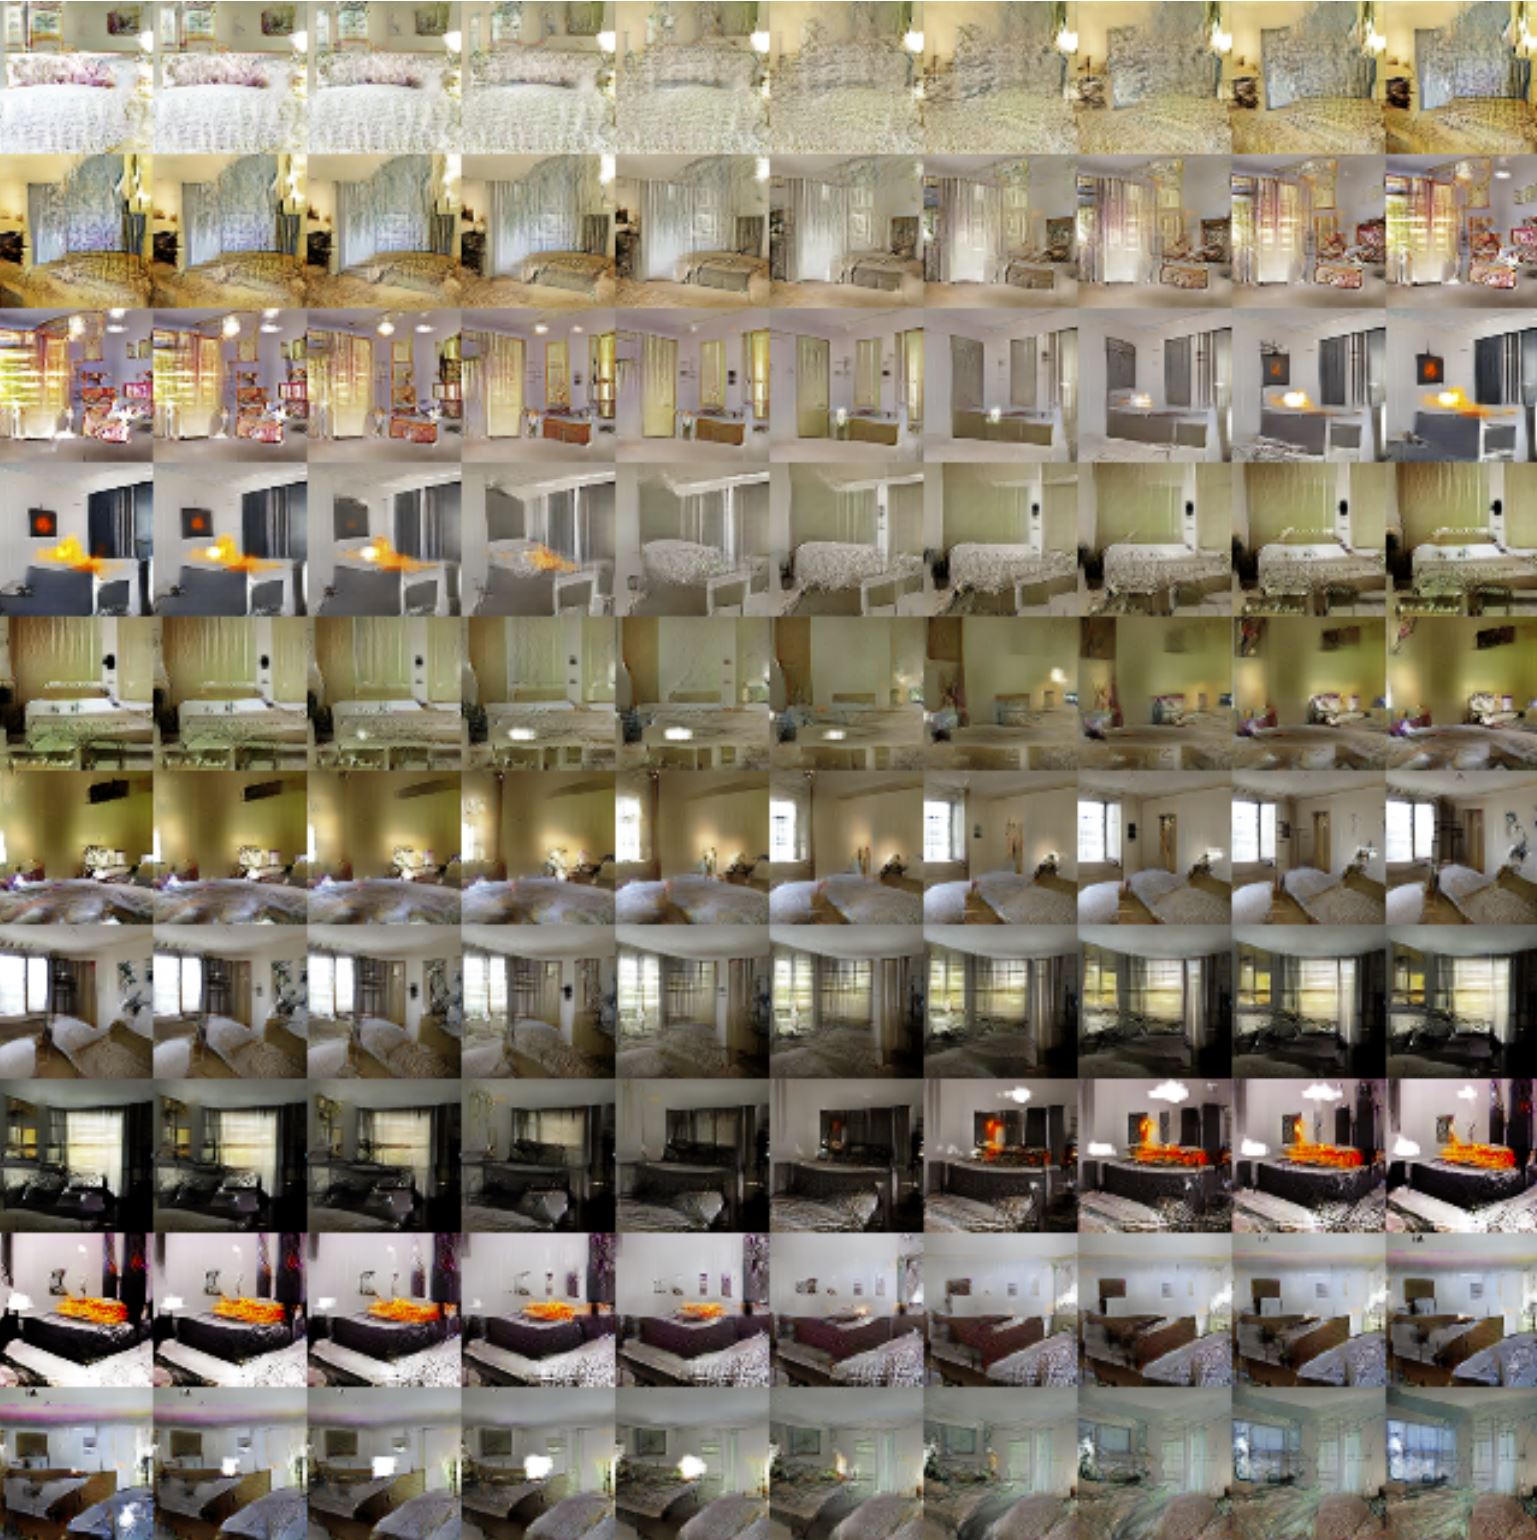
학습된 다양체 위를 걸으면 암기의 징후(급격한 전이) 와 공간이 계층적으로 붕괴하는 방식을 알 수 있습니다. 잠재 공간 보행이 객체의 추가·제거 같은 의미적 변화를 일으킨다면 모델이 관련 있고 흥미로운 표현을 학습했다고 추론할 수 있습니다.
| 관찰 | 내용 |
|---|---|
| 전반 | $Z$ 의 9 개 랜덤 점 사이 보간에서 모든 이미지가 그럴듯한 침실로 보이며 전이가 부드러움 |
| 6 번째 행 | 창문 없는 방이 거대한 창문이 있는 방으로 천천히 변환 |
| 10 번째 행 | TV 처럼 보이는 것이 천천히 창문으로 변환 |
🔍 2. 판별기 특징 시각화 (Figure 5)
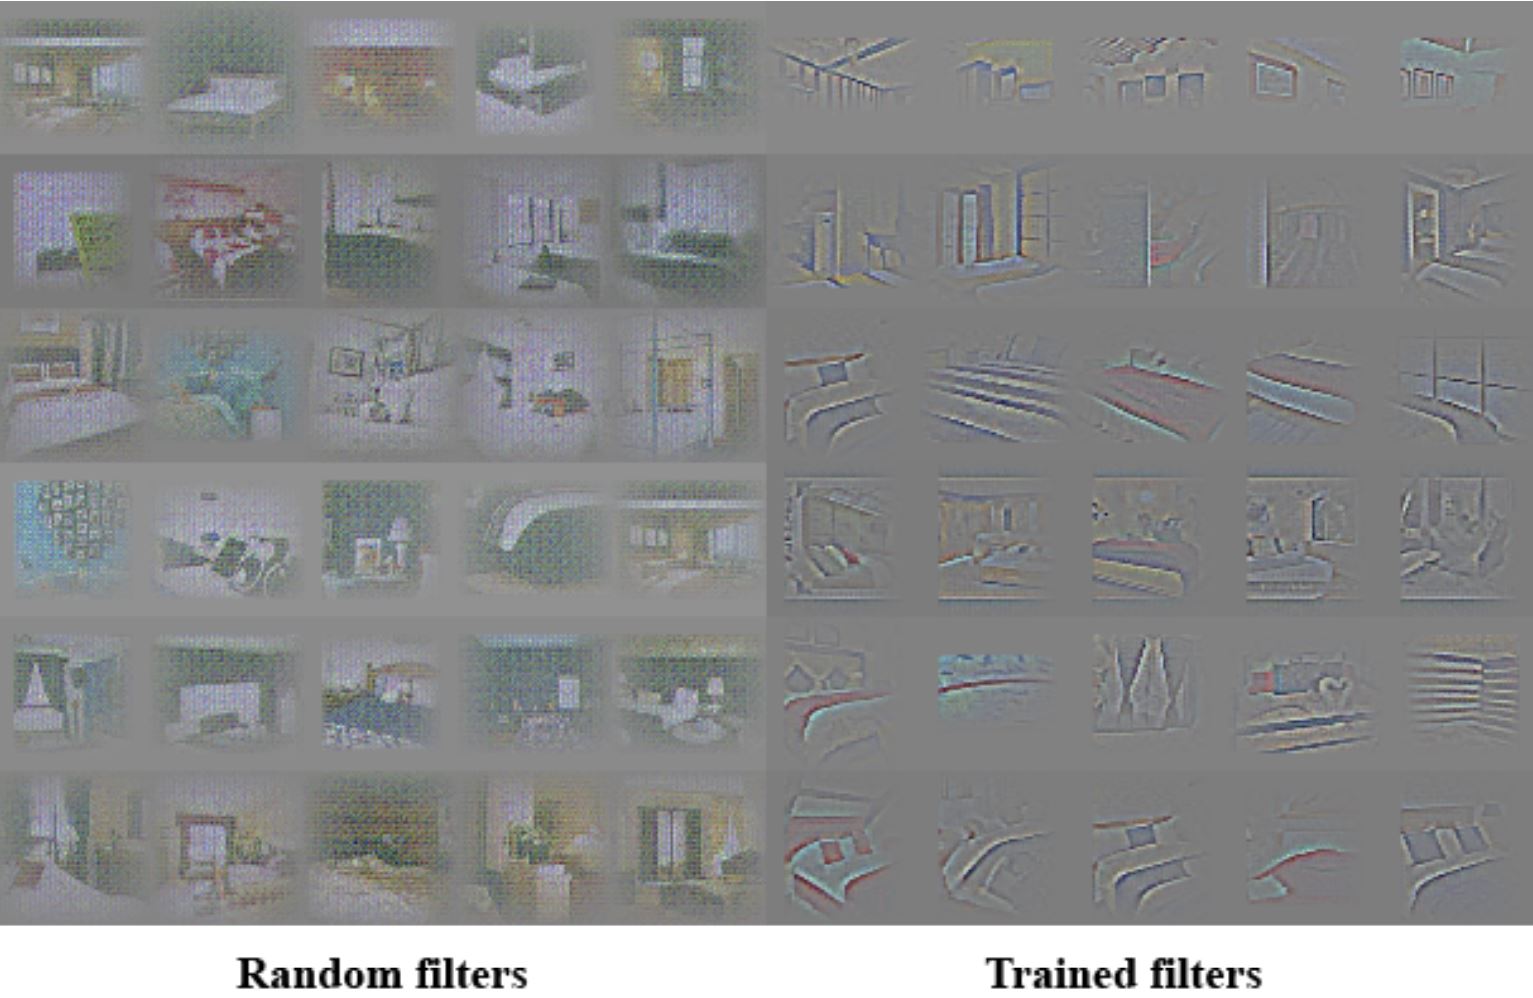
Zeiler & Fergus 류의 역합성곱·최대 활성화 필터링에서 착안해, 판별기 마지막 합성곱 층의 처음 6 개 학습 특징에 대해 guided backpropagation 으로 최대 축 정렬 반응을 시각화했습니다. 상당수 특징이 LSUN 침실의 중심 객체인 침대에 반응합니다. 왼쪽의 랜덤 필터 베이스라인과 비교하면 구별력이 거의 없고 구조가 무작위임을 알 수 있습니다.
🪟 3. 생성기에서 창문 지우기 (Section 6.2, Figure 6)
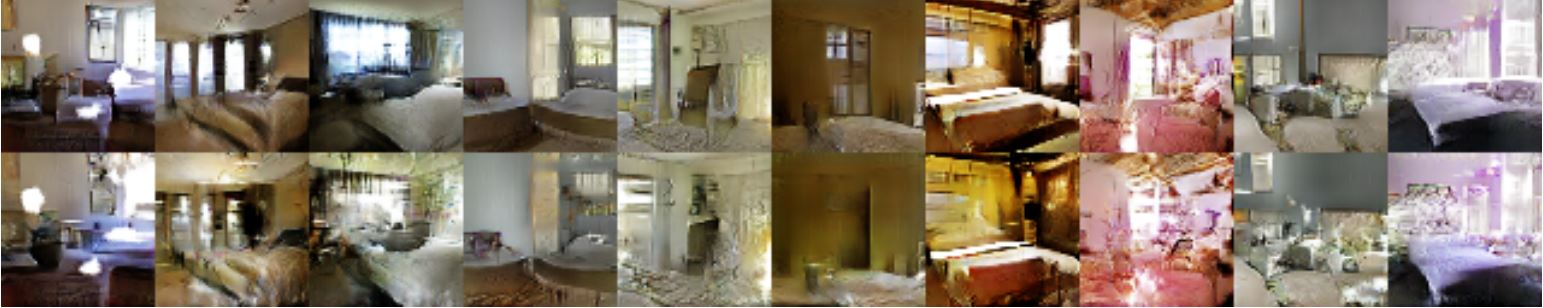
| 단계 | 내용 |
|---|---|
| 1 | 150 개 샘플에 52 개 창문 바운딩 박스를 수동으로 그림 |
| 2 | 두 번째로 높은 합성곱 층 특징에 대해, 박스 안 활성화를 양성, 같은 이미지의 랜덤 샘플을 음성으로 두고 로지스틱 회귀로 “창문 위 활성화인가”를 예측 |
| 3 | 가중치가 0 보다 큰 모든 특징 맵(총 200 개)을 모든 공간 위치에서 제거 |
| 4 | 특징 맵 제거 전후로 새 샘플 생성 |
결과적으로 네트워크는 대부분 침실에 창문을 그리는 것을 잊고 다른 객체로 대체했습니다. 일부 창문은 사라지고 일부는 문이나 거울처럼 시각적으로 유사한 객체로 변했습니다. 시각 품질은 떨어졌지만 전체 장면 구성은 비슷하게 유지되어, 생성기가 장면 표현과 객체 표현을 분리(disentangle) 했음을 시사합니다.
💡 Key Takeaway DCGAN 은 최근접 이웃이나 로그우도 대신 잠재 보행·필터 시각화·특징 제거라는 해석 도구를 제시했습니다. 이 세 기법은 이후 생성 모델 해석의 표준 메뉴가 되었습니다.
잠재 공간의 벡터 산술 (Section 6.3)
벡터 산술(vector arithmetic) 은 word2vec 에서 vector(“King”) - vector(“Man”) + vector(“Woman”) 의 최근접 이웃이 “Queen” 이라는 발견으로 유명해진 분석입니다. 저자들은 생성기의 $Z$ 표현에서도 비슷한 선형 구조가 나타나는지 조사했습니다.
➕ 1. 실험 방법 (Figure 7)
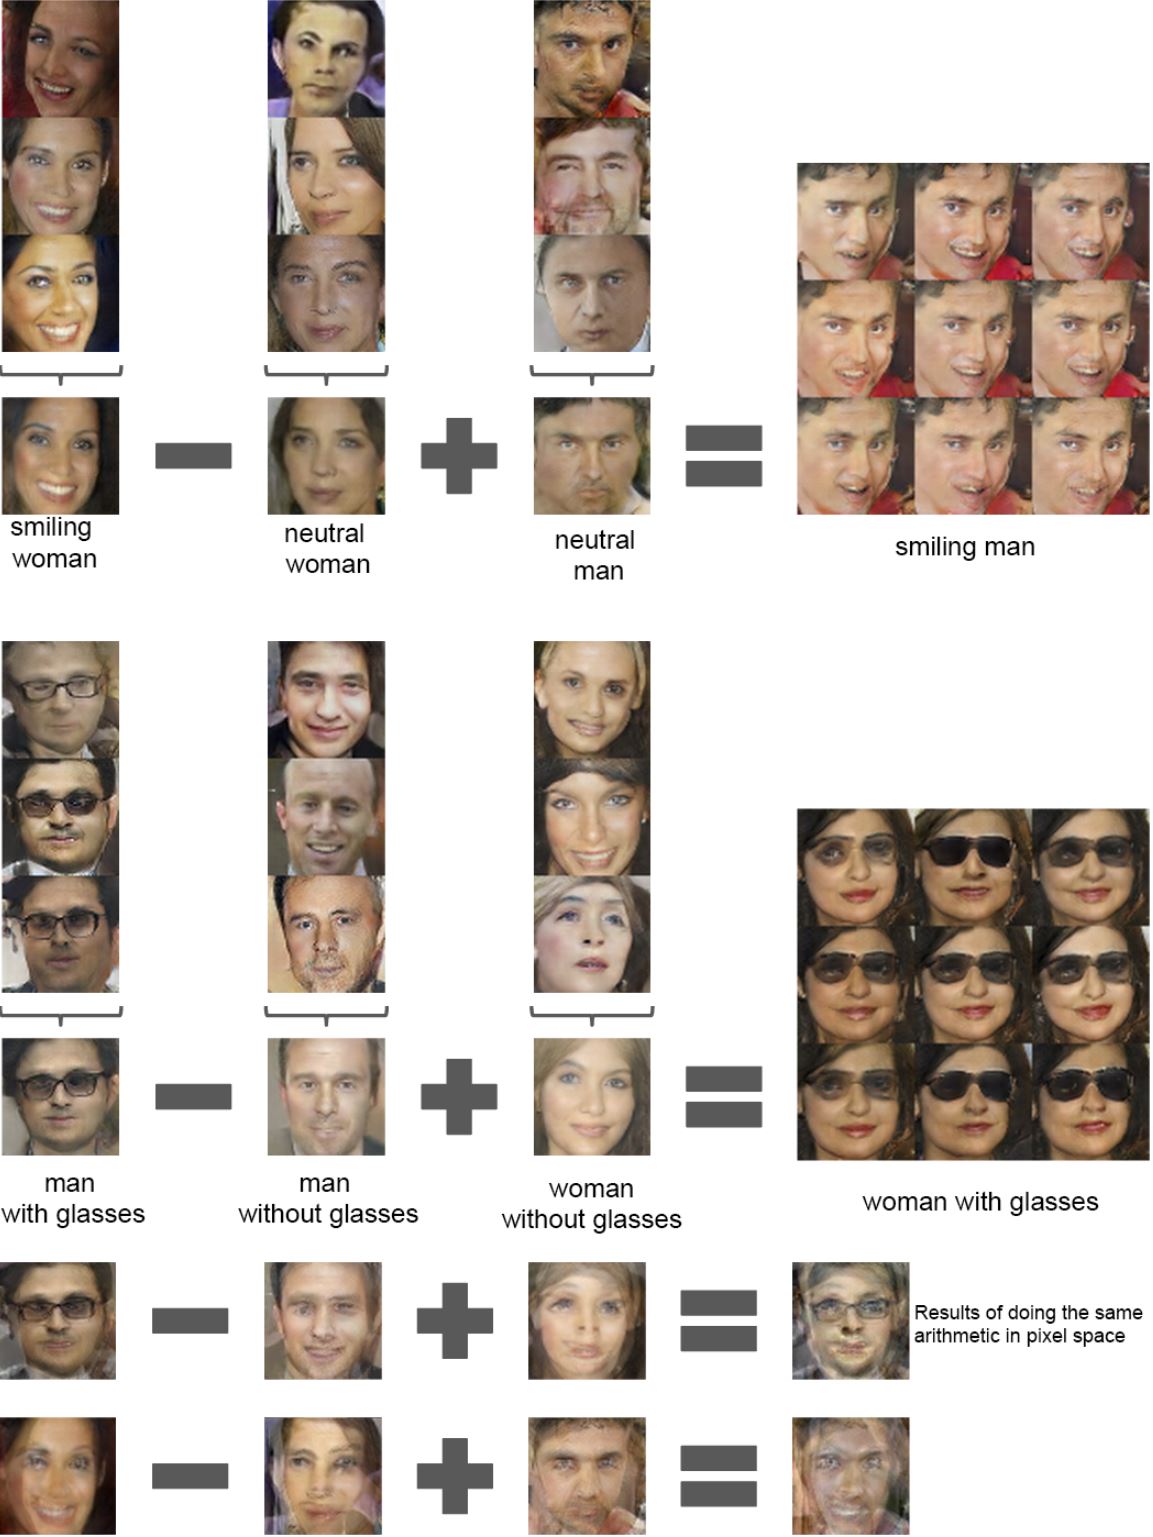
| 단계 | 내용 |
|---|---|
| 1 | 각 시각 개념(예: “안경 쓴 남자”)에 대해 예시 샘플들의 $Z$ 벡터를 평균 |
| 2 | 평균 벡터들에 산술을 적용해 새 벡터 $Y$ 를 만듦 |
| 3 | $Y$ 를 생성기에 입력해 오른쪽 중앙 샘플 생성 |
| 4 | 보간 능력을 보이기 위해 $Y$ 에 스케일 $\pm0.25$ 의 균등 잡음을 더해 8 개 샘플 추가 생성 |
개념당 단일 샘플로 한 실험은 불안정했지만, 세 예시의 $Z$ 벡터를 평균하자 산술을 의미적으로 따르는 일관되고 안정적인 생성이 나왔습니다. 반면 입력(픽셀) 공간에서 같은 산술을 적용하면(Figure 7 하단 두 예시) 정렬 불일치 때문에 잡음 섞인 중첩이 나옵니다.
🔄 2. 얼굴 포즈의 선형 모델링 (Figure 8)
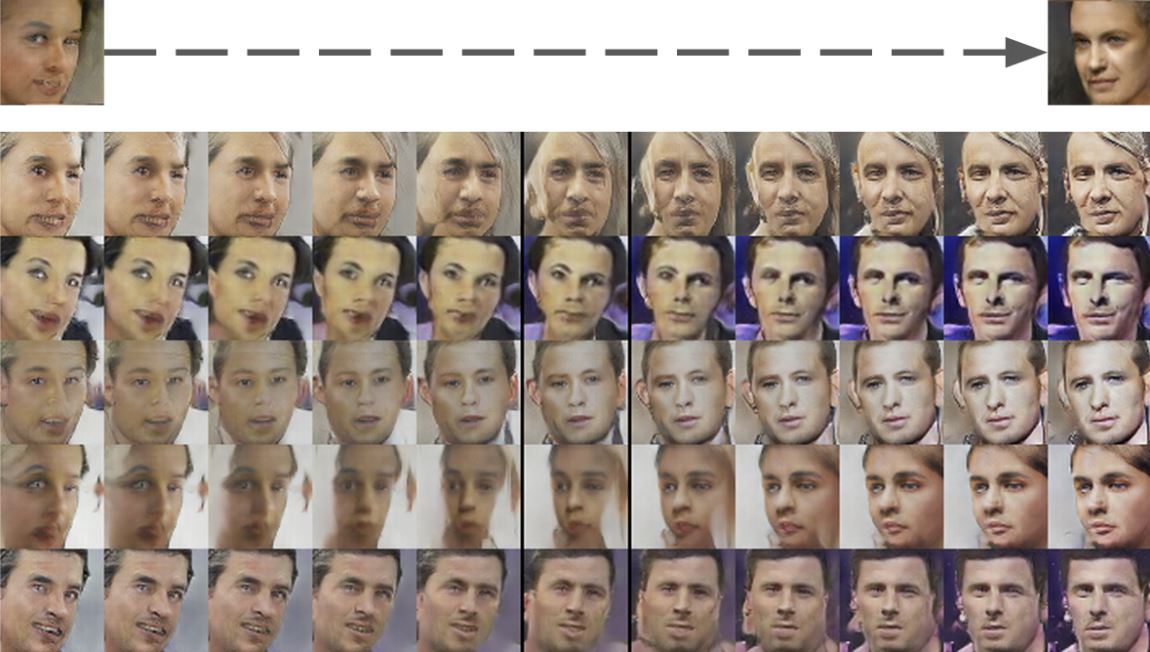
왼쪽을 보는 얼굴과 오른쪽을 보는 얼굴 각 네 개의 평균 샘플로 “회전(turn)” 벡터를 만들고, 이 축을 따라 보간한 값을 랜덤 샘플에 더하자 포즈를 안정적으로 변환할 수 있었습니다. 즉 얼굴 포즈도 $Z$ 공간에서 선형으로 모델링됩니다.
🧭 3. 의의
- 조건부 생성 모델이 크기·회전·위치 같은 객체 속성을 설득력 있게 모델링할 수 있다는 것은 이전에도 알려졌지만, 순수 비지도 모델에서 이런 현상이 나타난 것은 저자들이 아는 한 처음입니다.
- 벡터 산술을 더 탐구·발전시키면 복잡한 이미지 분포의 조건부 생성 모델링에 필요한 데이터 양을 극적으로 줄일 수 있다고 전망합니다.
💡 Key Takeaway $Z$ 공간의 벡터 산술은 생성기가 단순한 암기 장치가 아니라 의미적 속성을 선형 방향으로 부호화하는 표현을 학습했음을 보여줍니다. 이후 StyleGAN 의 잠재 방향 편집 연구로 이어집니다.
조건부 분포 평가와 한계 (Section 7, 8.1)
결론과 보충 자료에서 저자들은 남아 있는 불안정성과, 생성 모델이 데이터 분포를 얼마나 잘 포착했는지를 분류 지표로 평가하는 방법을 제시합니다.
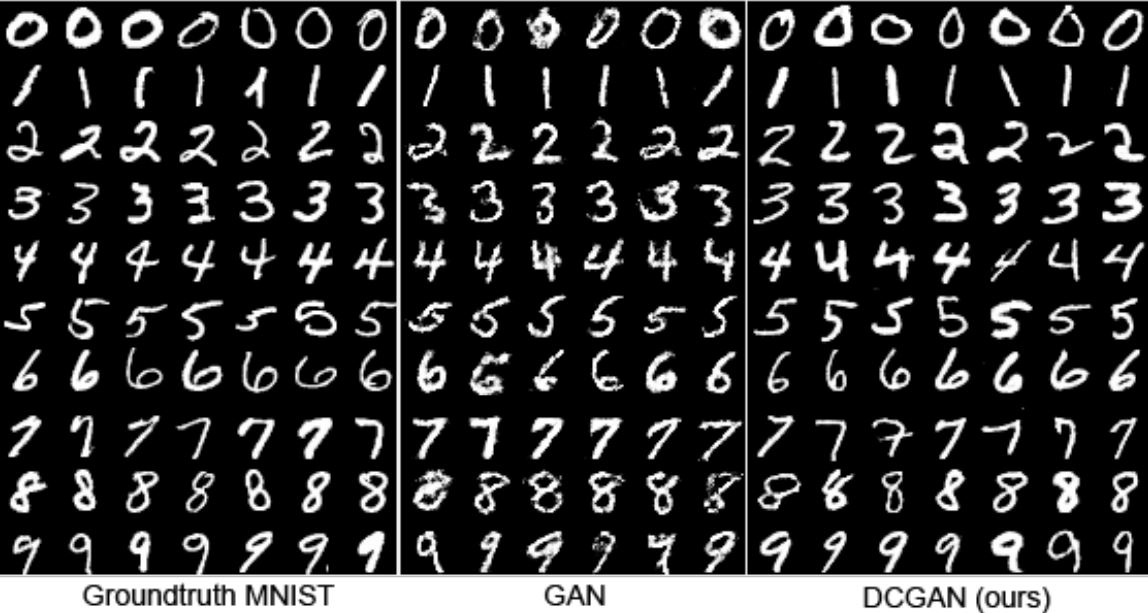
🔢 1. MNIST 조건부 DCGAN 의 최근접 이웃 분류 (Table 3)
조건부 버전의 DCGAN 을 MNIST(검증 1 만 개 분리)에서 학습하고, 실제 데이터와 생성된 조건부 샘플 집합을 최근접 이웃 분류기로 비교했습니다. 비교 대상은 순열 불변(permutation invariant) GAN 베이스라인입니다. 두 모델 모두 배치 정규화의 스케일·바이어스 파라미터를 제거했을 때 결과가 좋았는데, 배치 정규화가 주입하는 잡음이 생성 모델의 분포 탐색을 돕는다고 추측합니다.
| 모델 | 테스트 오류 @50K 샘플 | 테스트 오류 @10M 샘플 |
|---|---|---|
| AlignMNIST | – | 1.4% |
| InfiMNIST | – | 2.6% |
| Real Data | 3.1% | – |
| GAN | 6.28% | 5.65% |
| DCGAN (ours) | 2.98% | 1.48% |
- DCGAN 은 훈련 데이터셋에 맞춘 최근접 이웃 분류기와 같은 수준의 테스트 오류를 달성해 조건부 분포를 매우 잘 모델링했음을 시사합니다.
- 클래스당 100 만 샘플에서 DCGAN 은 이동·탄성 변형을 쓰는 수작업 증강 파이프라인 InfiMNIST 를 능가합니다.
- 클래스별 변환을 학습하는 확률적 생성 증강 기법(AlignMNIST)과는 경쟁 수준이면서, 변환이 아니라 데이터 자체를 직접 모델링하므로 더 일반적입니다.
⚠️ 2. 남은 불안정성과 한계
- 모델을 더 오래 학습하면 때때로 필터 일부가 하나의 진동하는 모드로 붕괴합니다. 이 형태의 불안정성은 후속 연구 과제로 남았습니다.
- 구조 가이드라인은 경험적으로 발견된 것이며 왜 작동하는지에 대한 이론적 설명은 없습니다.
- 평가에서 로그우도를 의도적으로 배제했으므로, 샘플 품질에 대한 정량 지표는 분류 기반 대리 지표에 의존합니다.
- 판별기 특징은 Exemplar CNN 에 미치지 못하며, 미세조정은 시도하지 않았습니다.
🔗 3. 열린 방향과 후속 연구
| 방향 | 논문의 제안 / 이후 전개 |
|---|---|
| 다른 도메인 | 비디오(프레임 예측), 오디오(음성 합성용 사전학습 특징)로 확장 |
| 잠재 공간 | 학습된 잠재 공간의 성질을 더 조사. 이후 InfoGAN 이 상호정보로 잠재 코드에 의미를 부여 |
| 안정성 | WGAN 은 DCGAN 구조를 베이스라인으로 삼아 배치 정규화 없는 생성기·MLP 생성기에서도 안정적인 학습을 보임 |
| 조건부 변환 | Pix2Pix 는 DCGAN 의 convolution-BatchNorm-ReLU 모듈과 학습 설정을 생성기·판별기에 채택 |
💡 Key Takeaway DCGAN 은 GAN 을 “불안정한 호기심”에서 재현 가능한 도구로 바꿨습니다. 남은 장기 학습 불안정성은 목적함수 차원의 해법(WGAN)을 기다리게 됩니다.