 You know maize mean?
Generative Adversarial Nets
0. Summary
기본 정보 : ArXiv,2014.06.10 (NeurIPS 2014), Generative Adversarial Nets
연구 배경
딥러닝의 가장 큰 성과는 고차원 감각 입력을 클래스 라벨로 사상하는 판별 모델(discriminative model) 에서 나왔다. 역전파(backpropagation)와 드롭아웃, 그리고 기울기가 잘 흐르는 구분 선형 유닛(piecewise linear unit)의 조합이 그 성공의 토대였다. 반면 심층 생성 모델(deep generative model) 은 그만큼의 영향력을 갖지 못했다. 최대우도 추정(maximum likelihood estimation)과 관련 전략에서 등장하는 다루기 어려운 확률 계산을 근사해야 하고, 생성 맥락에서는 구분 선형 유닛의 이점을 활용하기도 어려웠기 때문이다. 심층 볼츠만 머신(deep Boltzmann machine)처럼 확률 분포를 매개변수로 명시하는 모델은 우도 함수가 다루기 어려워 수많은 근사가 필요했고, 생성 확률 네트워크(generative stochastic network) 같은 “생성 기계(generative machine)”는 마르코프 체인(Markov chain)에 의존했다.
제안 방법
논문은 생성 모델을 적대자(adversary)와 겨루게 하는 새로운 추정 절차를 제안한다. 생성기 $G$ 는 잠재 잡음 $z$ 를 데이터 공간으로 사상하고, 판별기 $D$ 는 입력이 데이터에서 왔는지 $G$ 에서 왔는지를 판별한다. 저자들은 이를 위조지폐범과 경찰의 경쟁에 비유한다. 두 모델이 모두 다층 퍼셉트론(multilayer perceptron)일 때 전체 시스템은 역전파만으로 학습되며, 학습과 샘플 생성 어느 쪽에도 마르코프 체인이나 펼쳐진 근사 추론 네트워크가 필요 없다. 수학적으로는 가치 함수 $V(D,G)$ 를 둘러싼 2인 미니맥스 게임(two-player minimax game) 으로 정식화되며, 임의 함수 공간에서는 $G$ 가 데이터 분포를 복원하고 $D$ 가 모든 곳에서 $1/2$ 이 되는 유일한 해가 존재한다.
발견 사실
이론적으로 고정된 $G$ 에 대한 최적 판별기는 $D^{*}{G}(x)=p{data}(x)/(p_{data}(x)+p_{g}(x))$ 이며, 이를 대입한 가상 학습 기준 $C(G)$ 는 $-\log 4 + 2\cdot JSD(p_{data}\,|\,p_{g})$ 로 정리되어 $p_{g}=p_{data}$ 에서만 전역 최솟값 $-\log 4$ 에 도달한다(Theorem 1). 실험에서는 MNIST, Toronto Face Database(TFD), CIFAR-10 에서 적대 신경망을 학습했고, 가우시안 Parzen window 로 추정한 테스트 로그우도는 MNIST 에서 $225\pm2$, TFD 에서 $2057\pm26$ 으로 DBN, Stacked CAE, Deep GSN 과 비교해 경쟁력 있는 수치였다(Table 1). 생성 샘플은 훈련 집합을 암기한 것이 아님을 최근접 훈련 예시와 나란히 보여 확인했고(Figure 2), 잠재 공간 $z$ 의 좌표를 선형 보간하면 숫자가 부드럽게 변하는 것을 관찰했다(Figure 3).
핵심 기여
- 적대적 학습 프레임워크 : 생성기와 판별기의 미니맥스 게임이라는, 우도를 명시하지 않고도 생성 모델을 학습하는 새로운 패러다임을 제시했다. 마르코프 체인과 근사 추론 없이 역전파만으로 학습과 샘플링이 가능하다.
- 전역 최적해와 수렴의 이론적 보장 : 비모수 극한에서 최적 판별기의 닫힌 형식(Proposition 1), 전역 최솟값이 $p_{g}=p_{data}$ 에서 유일하게 달성됨(Theorem 1), 그리고 교대 최적화 알고리즘이 수렴함(Proposition 2)을 증명했다.
- 실용적 학습 알고리즘과 경험적 검증 : $k$ 스텝 판별기 갱신과 1 스텝 생성기 갱신을 교대하는 Algorithm 1, 초기 학습의 기울기 포화를 피하는 $\log D(G(z))$ 최대화 트릭을 제안하고, 세 데이터셋에서 Parzen window 로그우도와 샘플 품질로 가능성을 입증했다.
관련 개념
적대 신경망(Adversarial Nets)의 기본 구조
적대 신경망(adversarial nets) 은 생성 모델 $G$ 와 판별 모델 $D$ 를 동시에 학습시키는 프레임워크입니다. 논문은 이 프레임워크가 다양한 모델과 최적화 알고리즘에 적용될 수 있다고 보면서도, 두 모델이 모두 다층 퍼셉트론인 특수한 경우를 “adversarial nets” 라고 부르고 집중적으로 다룹니다.
🎭 1. 두 플레이어의 역할
| 구성 요소 | 정의 | 목표 |
|---|---|---|
| 생성기 $G(z;\theta_{g})$ | 사전 잡음 $p_{z}(z)$ 에서 뽑은 $z$ 를 데이터 공간으로 사상하는 미분 가능 함수 | $D$ 가 실수할 확률을 최대화 |
| 판별기 $D(x;\theta_{d})$ | 단일 스칼라를 출력하며, $x$ 가 $p_{g}$ 가 아닌 데이터에서 왔을 확률을 표현 | 훈련 예시와 $G$ 의 샘플 모두에 올바른 라벨을 부여할 확률을 최대화 |
$G$ 는 $p_{g}$ 를 데이터 $x$ 위의 분포로 암묵적으로(implicitly) 정의합니다. 즉 $z\sim p_{z}$ 일 때 $G(z)$ 의 분포가 $p_{g}$ 입니다. 밀도를 직접 쓰지 않고 샘플만 만들어내는 것이 이후 “implicit generative model” 이라 불리는 계열의 출발점입니다.
🎯 2. 가치 함수와 미니맥스 게임 (Eq. 1)
$D$ 와 $G$ 는 다음 가치 함수 $V(G,D)$ 를 두고 2인 미니맥스 게임을 합니다.
\[\min_{G}\max_{D}V(D,G)=\mathbb{E}_{x\sim p_{data}(x)}[\log D(x)]+\mathbb{E}_{z\sim p_{z}(z)}[\log(1-D(G(z)))]\]| 항 | 의미 |
|---|---|
| $\mathbb{E}{x\sim p{data}}[\log D(x)]$ | 진짜 데이터를 진짜라고 판정할 로그확률 |
| $\mathbb{E}{z\sim p{z}}[\log(1-D(G(z)))]$ | 생성 샘플을 가짜라고 판정할 로그확률 |
$D$ 는 이 값을 키우려 하고 $G$ 는 줄이려 합니다. 논문은 이 게임이 최적화 문제가 아니라 안장점(saddle point)을 찾는 게임이라는 점을 강조합니다. 한 플레이어의 전략에 대해서는 최소, 다른 플레이어의 전략에 대해서는 최대인 지점에서 게임이 끝납니다.
🧩 3. 관련 연구와의 차별점 (Section 2)
| 비교 대상 | 공통점 | 차이점 |
|---|---|---|
| VAE (Kingma & Welling, Rezende et al.) | 미분 가능 생성기 네트워크와 두 번째 네트워크를 짝지음 | VAE 의 두 번째 네트워크는 근사 추론을 수행하는 인식 모델. GAN 은 가시 유닛을 통해 미분하므로 이산 데이터를 다룰 수 없고, VAE 는 은닉 유닛을 통해 미분하므로 이산 잠재변수를 가질 수 없음 |
| Noise-Contrastive Estimation (NCE) | 판별 기준으로 생성 모델을 학습 | NCE 의 “판별기”는 잡음 분포와 모델 분포의 밀도 비로 정의되어 두 밀도를 모두 평가·역전파할 수 있어야 함 |
| Predictability Minimization | 두 네트워크가 경쟁 | PM 은 정규화 항에 불과하고 비교 대상이 스칼라이며 최적화 문제로 기술됨. GAN 은 경쟁이 유일한 학습 기준이고 고차원 벡터를 주고받으며 미니맥스 게임임 |
| Adversarial Examples | 이름이 유사 | 적대적 예시는 생성 모델 학습 메커니즘이 아니라 분류기의 흥미로운 거동을 보이는 분석 도구 |
💡 Key Takeaway GAN 은 “우도를 계산하는” 대신 “판별기를 속이는” 것을 학습 신호로 삼습니다. 생성기는 데이터를 직접 보지 않고 판별기를 통해 흘러오는 기울기만으로 갱신된다는 점이 통계적·계산적 이점의 근원입니다.
최적 판별기와 전역 최적성 (Section 4.1)
이론적 결과는 비모수(nonparametric) 설정, 즉 확률 밀도 함수 공간에서 수렴을 연구하는 무한 용량 모델을 가정합니다. 핵심은 고정된 $G$ 에 대해 $D$ 를 최적화하면 가치 함수가 $p_{g}$ 와 $p_{data}$ 사이의 Jensen-Shannon 발산으로 환원된다는 것입니다.
📐 1. 최적 판별기 (Proposition 1)
$G$ 가 고정되어 있을 때 최적 판별기는
\[D^{*}_{G}(x)=\frac{p_{data}(x)}{p_{data}(x)+p_{g}(x)}\]입니다. 증명은 가치 함수를 $x$ 에 대한 적분으로 바꾸는 데서 출발합니다.
\[V(G,D)=\int_{x}p_{data}(x)\log D(x)\,dx+\int_{z}p_{z}(z)\log(1-D(G(z)))\,dz=\int_{x}\big[p_{data}(x)\log D(x)+p_{g}(x)\log(1-D(x))\big]dx\]임의의 $(a,b)\in\mathbb{R}^{2}\setminus{(0,0)}$ 에 대해 함수 $y\mapsto a\log y+b\log(1-y)$ 는 $[0,1]$ 에서 $y=a/(a+b)$ 일 때 최대가 되므로, 피적분 함수를 점별로 최대화하면 위 결과가 나옵니다. $D$ 는 $\mathrm{Supp}(p_{data})\cup\mathrm{Supp}(p_{g})$ 바깥에서는 정의될 필요가 없습니다.
이 학습 목표는 $x$ 가 $p_{data}$ 에서 왔는지($Y=1$) $p_{g}$ 에서 왔는지($Y=0$)를 나타내는 조건부 확률 $P(Y=y\mid x)$ 를 추정하는 로그우도 최대화로도 해석됩니다.
🏔️ 2. 가상 학습 기준 $C(G)$ 와 전역 최솟값 (Theorem 1)
최적 판별기를 대입하면 미니맥스 게임은 $G$ 만의 함수로 재정식화됩니다 (Eq. 4).
\[C(G)=\max_{D}V(G,D)=\mathbb{E}_{x\sim p_{data}}\Big[\log\frac{p_{data}(x)}{p_{data}(x)+p_{g}(x)}\Big]+\mathbb{E}_{x\sim p_{g}}\Big[\log\frac{p_{g}(x)}{p_{data}(x)+p_{g}(x)}\Big]\]Theorem 1 은 $C(G)$ 의 전역 최솟값이 $p_{g}=p_{data}$ 일 때, 그리고 그때만 달성되며 그 값이 $-\log 4$ 라고 말합니다.
| 단계 | 내용 |
|---|---|
| (i) | $p_{g}=p_{data}$ 이면 $D^{*}_{G}(x)=1/2$ 이므로 $C(G)=\log\frac12+\log\frac12=-\log 4$ |
| (ii) | $\mathbb{E}{x\sim p{data}}[-\log 2]+\mathbb{E}{x\sim p{g}}[-\log 2]=-\log 4$ 를 $C(G)$ 에서 빼면 두 KL 항이 남음 |
| (iii) | $C(G)=-\log 4+KL\big(p_{data}\,|\,\tfrac{p_{data}+p_{g}}{2}\big)+KL\big(p_{g}\,|\,\tfrac{p_{data}+p_{g}}{2}\big)$ |
| (iv) | 이는 Jensen-Shannon 발산의 정의이므로 $C(G)=-\log 4+2\cdot JSD(p_{data}\,|\,p_{g})$ |
JSD 는 항상 비음수이고 두 분포가 같을 때만 0 이므로, $C^{*}=-\log 4$ 가 전역 최솟값이며 유일한 해는 $p_{g}=p_{data}$ 입니다. 즉 GAN 의 생성기는 (최적 판별기 아래에서) 데이터 분포와의 JS 발산을 최소화합니다.
🔁 3. Algorithm 1 의 수렴 (Proposition 2)
$G$ 와 $D$ 의 용량이 충분하고, 각 스텝에서 $D$ 가 주어진 $G$ 에 대해 최적에 도달하며, $p_{g}$ 가 기준 $\mathbb{E}{x\sim p{data}}[\log D^{}_{G}(x)]+\mathbb{E}_{x\sim p_{g}}[\log(1-D^{}{G}(x))]$ 를 개선하도록 갱신되면 $p{g}$ 는 $p_{data}$ 로 수렴합니다.
- $U(p_{g},D)=V(G,D)$ 는 $p_{g}$ 에 대해 볼록(convex) 합니다.
- 볼록 함수들의 상한(supremum)의 하위미분(subderivative)은 최댓값이 달성되는 지점에서의 도함수를 포함합니다. 따라서 최적 $D$ 에서 $p_{g}$ 에 대한 경사하강은 $\sup_{D}U(p_{g},D)$ 의 하위기울기 방향입니다.
- $\sup_{D}U(p_{g},D)$ 는 Theorem 1 에 의해 유일한 전역 최적해를 가진 볼록 함수이므로 충분히 작은 갱신으로 수렴합니다.
단, 실제로는 $p_{g}$ 자체가 아니라 $\theta_{g}$ 를 최적화하므로 이 증명이 그대로 적용되지는 않습니다. 논문은 다층 퍼셉트론의 뛰어난 실전 성능이 이론적 보장의 부재에도 불구하고 합리적인 선택임을 시사한다고 덧붙입니다.
💡 Key Takeaway 최적 판별기를 대입하면 GAN 의 목적함수는 $-\log 4+2\cdot JSD(p_{data}|p_{g})$ 입니다. 이 사실은 이후 WGAN 이 “JS 발산은 지지집합이 겹치지 않으면 포화한다”고 비판하는 출발점이 됩니다.
학습 절차: Algorithm 1 과 실전 트릭
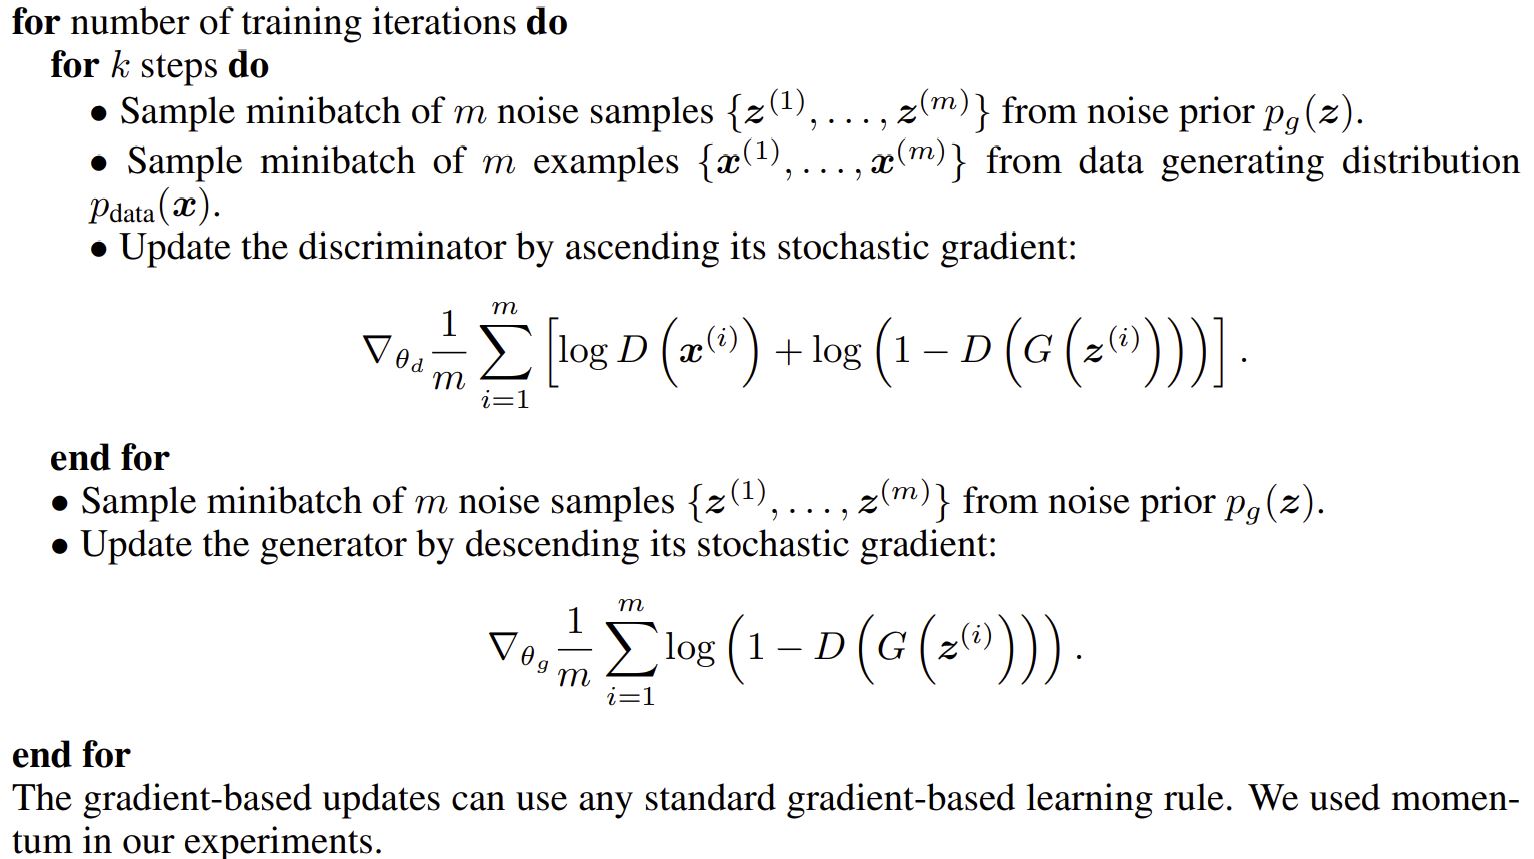
Algorithm 1 은 미니배치 확률적 경사하강으로 적대 신경망을 학습하는 절차입니다. 내부 루프에서 $D$ 를 끝까지 최적화하는 것은 계산적으로 불가능하고 유한 데이터셋에서는 과적합을 일으키므로, $D$ 를 $k$ 스텝, $G$ 를 1 스텝 교대로 갱신합니다.
🔄 1. 교대 갱신 절차
| 단계 | 내용 |
|---|---|
| 판별기 갱신 ($k$ 회) | 잡음 미니배치 ${z^{(1)},\dots,z^{(m)}}$ 와 데이터 미니배치 ${x^{(1)},\dots,x^{(m)}}$ 를 뽑아, $\frac1m\sum_{i}\big[\log D(x^{(i)})+\log(1-D(G(z^{(i)})))\big]$ 의 확률적 기울기를 상승시킴 |
| 생성기 갱신 (1 회) | 잡음 미니배치를 뽑아 $\frac1m\sum_{i}\log(1-D(G(z^{(i)})))$ 의 확률적 기울기를 하강시킴 |
| 하이퍼파라미터 | $k$ 는 하이퍼파라미터. 실험에서는 가장 저렴한 $k=1$ 사용. 기울기 기반 갱신은 어떤 표준 규칙도 가능하며 실험에서는 모멘텀 사용 |
이렇게 하면 $G$ 가 충분히 천천히 변하는 한 $D$ 는 최적해 근처에 유지됩니다. 볼츠만 머신 학습에서 음의 체인(negative chain)을 학습 스텝 사이에 최신 상태로 유지하는 것과 같은 원리입니다.
🚀 2. 포화 문제와 $-\log D(G(z))$ 트릭
학습 초기에 $G$ 의 품질이 낮으면 $D$ 는 생성 샘플이 훈련 데이터와 명백히 다르므로 높은 확신으로 거부할 수 있습니다. 이때 $\log(1-D(G(z)))$ 가 포화(saturate) 하여 $G$ 에 충분한 기울기를 주지 못합니다.
| 목적 | 식 | 특징 |
|---|---|---|
| 원래 (minimax) | $G$ 가 $\log(1-D(G(z)))$ 를 최소화 | Eq. 1 그대로. 초기에 기울기 소실 |
| 대안 (non-saturating) | $G$ 가 $\log D(G(z))$ 를 최대화 | $G$, $D$ 동역학의 고정점은 동일하지만 초기 학습에서 훨씬 강한 기울기 |
이 “$-\log D$ 트릭”은 이후 거의 모든 GAN 구현에서 기본값이 되었고, WGAN 논문에서도 표준 GAN 베이스라인은 이 트릭을 쓴 것으로 명시됩니다.
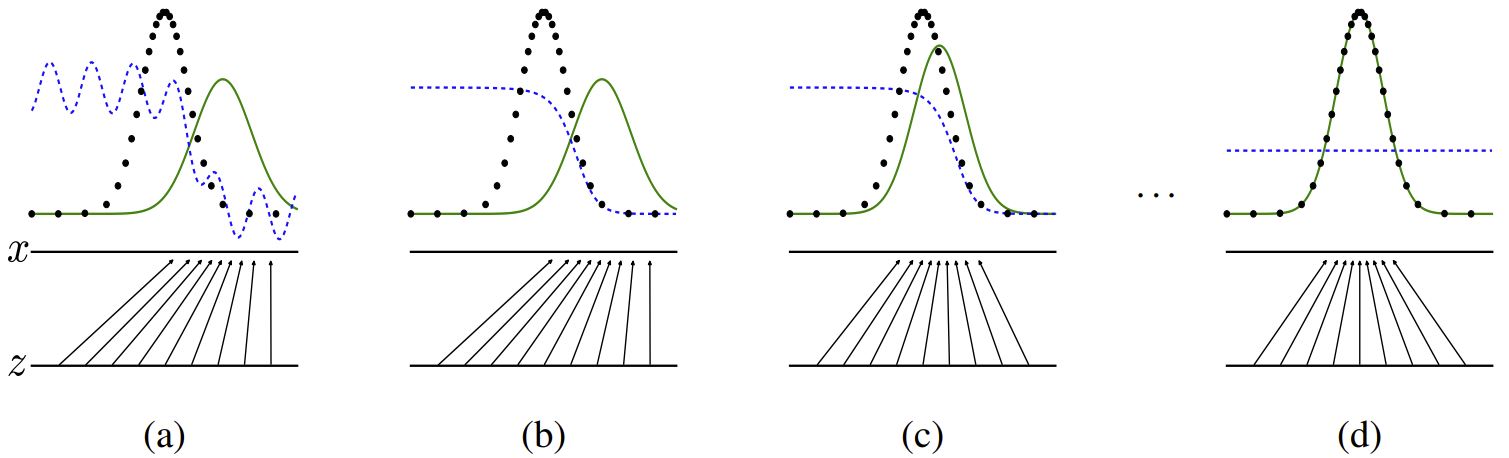
🖼️ 3. Figure 1 의 교육적 설명
| 패널 | 상황 |
|---|---|
| (a) | 수렴 근처의 적대 쌍. $p_{g}$ 는 $p_{data}$ 와 유사하고 $D$ 는 부분적으로 정확한 분류기 |
| (b) | 내부 루프에서 $D$ 가 데이터와 샘플을 구별하도록 학습되어 $D^{*}(x)=p_{data}(x)/(p_{data}(x)+p_{g}(x))$ 로 수렴 |
| (c) | $G$ 갱신 후, $D$ 의 기울기가 $G(z)$ 를 데이터로 분류될 가능성이 높은 영역으로 흐르게 함 |
| (d) | 충분한 용량이면 $p_{g}=p_{data}$ 에 도달해 둘 다 개선 불가. $D(x)=1/2$ |
아래 수평선은 $z$ 가 (여기서는 균등하게) 샘플링되는 정의역, 위 수평선은 $x$ 의 정의역 일부이며, 화살표는 $x=G(z)$ 가 변환된 샘플에 비균등 분포 $p_{g}$ 를 부과하는 방식을 보여줍니다. $G$ 는 $p_{g}$ 의 고밀도 영역에서 수축하고 저밀도 영역에서 팽창합니다.
💡 Key Takeaway $k$ 스텝 $D$, 1 스텝 $G$ 의 교대 갱신과 non-saturating 손실은 이론과 실전 사이의 간극을 메우는 두 장치입니다. $D$ 와 $G$ 의 동기화가 이후 모든 GAN 학습 안정성 논의의 핵심 변수가 됩니다.
실험 설정과 Parzen Window 평가 (Section 5)
실험은 MNIST, Toronto Face Database(TFD), CIFAR-10 세 데이터셋에서 수행되었습니다. 우도를 명시적으로 표현하지 않는 모델이므로 평가 역시 간접적일 수밖에 없는데, 논문은 당시 가능한 최선의 방법으로 가우시안 Parzen window 로그우도 추정을 채택합니다.
🧪 1. 네트워크 구성
| 구성 요소 | 설정 |
|---|---|
| 생성기 활성화 | ReLU(rectifier linear) 와 시그모이드의 혼합 |
| 판별기 활성화 | maxout |
| 정규화 | 판별기 학습에 드롭아웃 적용 |
| 잡음 주입 | 이론상 생성기 중간층에도 드롭아웃·잡음을 쓸 수 있지만, 실험에서는 생성기 최하층 입력에만 잡음 사용 |
| CIFAR-10 변형 | 완전연결 모델과, 합성곱 판별기 + “역합성곱(deconvolutional)” 생성기 모델 두 가지 (Figure 2c, 2d) |
📊 2. Parzen Window 로그우도 (Table 1)
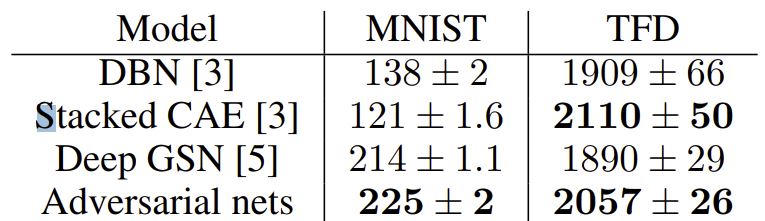
$G$ 로 생성한 샘플에 가우시안 Parzen window 를 맞추고, 그 분포 아래에서 테스트 집합의 로그우도를 보고합니다. 가우시안의 $\sigma$ 는 검증 집합에서 교차검증으로 정했습니다.
| 모델 | MNIST | TFD |
|---|---|---|
| DBN | $138\pm2$ | $1909\pm66$ |
| Stacked CAE | $121\pm1.6$ | $2110\pm50$ |
| Deep GSN | $214\pm1.1$ | $1890\pm29$ |
| Adversarial nets | $225\pm2$ | $2057\pm26$ |
MNIST 의 오차는 예시 간 평균의 표준오차, TFD 의 오차는 폴드 간 표준오차이며 폴드마다 다른 $\sigma$ 를 선택했습니다. MNIST 는 이진이 아닌 실수값 버전으로 비교했습니다. 저자들은 이 추정법이 분산이 다소 크고 고차원 공간에서는 잘 작동하지 않지만 당시 알려진 최선의 방법이었다고 명시하며, 샘플링은 가능하지만 우도를 직접 추정할 수 없는 생성 모델의 발전이 평가 방법 연구를 촉진해야 한다고 적습니다.
🖼️ 3. 샘플의 질적 평가 (Figure 2, 3)

- Figure 2 의 각 패널에서 가장 오른쪽 열은 인접 샘플의 최근접 훈련 예시로, 모델이 훈련 집합을 암기하지 않았음을 보여줍니다.
- 샘플은 체리피킹 없이 공정하게 무작위로 뽑았습니다.
- 대부분의 심층 생성 모델 시각화와 달리, 은닉 유닛 샘플이 주어진 조건부 평균이 아니라 모델 분포의 실제 샘플입니다.
- 샘플링 과정이 마르코프 체인 혼합에 의존하지 않으므로 샘플들이 서로 상관되어 있지 않습니다.
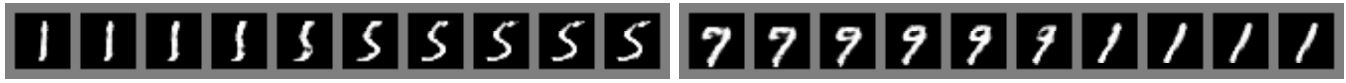
Figure 3 은 전체 모델의 $z$ 공간 좌표 사이를 선형 보간해 얻은 숫자들입니다. 저자들은 이 샘플이 기존 방법보다 낫다고 주장하지는 않지만, 문헌의 우수한 생성 모델과 적어도 경쟁할 만하며 적대적 프레임워크의 잠재력을 보여준다고 평가합니다.
💡 Key Takeaway 2014 년 시점의 GAN 평가는 Parzen window 로그우도와 육안 검사에 의존했습니다. 저자들 스스로 이 평가법의 한계를 인정했고, 이는 이후 Inception Score, FID 같은 샘플 기반 지표 개발의 동기가 됩니다.
장점과 단점: 다른 생성 모델링 접근과의 비교 (Section 6)
장단점 비교는 이 논문의 가장 솔직한 부분입니다. 저자들은 새로운 프레임워크가 기존 접근 대비 갖는 계산적 이점과 함께, 명시적 밀도가 없고 학습 동기화가 까다롭다는 약점을 분명히 밝힙니다.
⚖️ 1. 단점
| 단점 | 설명 |
|---|---|
| $p_{g}(x)$ 의 명시적 표현 부재 | 우도 평가가 불가능하고 Parzen 추정 같은 간접 방법에 의존 |
| $D$ 와 $G$ 의 동기화 필요 | $D$ 를 갱신하지 않은 채 $G$ 를 과도하게 학습하면 안 됨 |
| “Helvetica 시나리오” | $G$ 가 너무 많은 $z$ 값을 같은 $x$ 로 붕괴시켜 $p_{data}$ 를 모델링할 다양성을 잃는 실패 모드. 이후 모드 붕괴(mode collapse) 라 불림 |
✅ 2. 장점
| 장점 | 설명 |
|---|---|
| 마르코프 체인 불필요 | 기울기는 역전파만으로 얻고 학습 중 추론이 필요 없음 |
| 모델 설계 자유도 | 매우 다양한 함수를 모델에 통합 가능. 이론적으로 어떤 미분 가능 함수도 허용 |
| 통계적 이점 | 생성기가 데이터 예시로 직접 갱신되지 않고 판별기를 통해 흐르는 기울기로만 갱신되므로 입력 성분이 생성기 파라미터로 직접 복사되지 않음 |
| 날카로운 분포 표현 | 마르코프 체인 기반 방법은 체인이 모드 사이를 혼합하려면 분포가 다소 흐릿해야 하지만, 적대 신경망은 매우 날카롭거나 퇴화된(degenerate) 분포도 표현 가능 |
🗂️ 3. 생성 모델링의 도전 과제 요약 (Table 2)

Table 2 는 심층 볼츠만 머신, 생성 확률 네트워크, VAE, 적대 신경망을 학습·추론·샘플링·$p(x)$ 평가·모델 설계의 다섯 축으로 비교합니다. 적대 모델 열의 내용은 다음과 같습니다.
| 축 | 적대 모델 |
|---|---|
| 학습 | 판별기와 생성기의 동기화. Helvetica 시나리오 |
| 추론 | 학습된 근사 추론 (보조 네트워크로 가능) |
| 샘플링 | 어려움 없음 |
| $p(x)$ 평가 | 명시적으로 표현되지 않으며 Parzen 밀도 추정으로 근사 가능 |
| 모델 설계 | 이론상 어떤 미분 가능 함수도 허용 |
💡 Key Takeaway GAN 의 강점은 샘플링의 자유와 설계의 유연성, 약점은 우도 부재와 학습 불안정입니다. 이 양면성이 이후 10 년간의 GAN 연구 지형을 결정했습니다.
한계와 열린 방향: 논문이 제안한 확장들 (Section 7)
결론과 후속 연구에서 저자들은 이 프레임워크가 허용하는 다섯 가지 직접적인 확장을 열거합니다. 흥미롭게도 이 목록의 상당수가 이후 수년 안에 독립 논문으로 실현되었습니다.
🧭 1. 논문이 제시한 다섯 가지 확장
| 번호 | 제안 | 이후 실현 |
|---|---|---|
| 1 | $c$ 를 $G$ 와 $D$ 의 입력에 추가해 조건부 생성 모델 $p(x\mid c)$ 를 얻음 | Conditional GAN (Mirza & Osindero, 2014) |
| 2 | $x$ 가 주어졌을 때 $z$ 를 예측하는 보조 네트워크로 학습된 근사 추론. wake-sleep 의 추론 네트워크와 유사하지만 생성기 학습이 끝난 뒤 고정된 생성기에 대해 학습 가능 | BiGAN, ALI 등 |
| 3 | 파라미터를 공유하는 조건부 모델 계열로 모든 조건부 $p(x_{S}\mid x_{\not S})$ 를 근사. 결정론적 MP-DBM 의 확률적 확장 | 인페인팅 계열 |
| 4 | 준지도 학습 : 라벨이 적을 때 판별기나 추론 네트워크의 특징으로 분류기 성능 향상 | DCGAN 의 특징 추출 실험, SGAN, Improved GAN |
| 5 | 효율 개선 : $G$ 와 $D$ 를 조정하는 더 나은 방법이나 학습 중 $z$ 를 샘플링할 더 나은 분포 | WGAN 등 안정화 연구 |
⚠️ 2. 이론과 실전의 간극
- 수렴 증명(Proposition 2)은 $p_{g}$ 를 밀도 함수 공간에서 직접 갱신한다고 가정하지만, 실제로는 $G(z;\theta_{g})$ 라는 제한된 함수족의 $\theta_{g}$ 를 최적화합니다. 따라서 증명이 그대로 적용되지 않습니다.
- 최적 판별기 가정도 실전에서는 $k$ 스텝 갱신으로만 근사됩니다.
- 적대적 예시의 존재는 현대 판별 네트워크가 사람이 인지할 수 있는 속성을 전혀 흉내내지 않고도 어떤 클래스를 확신 있게 인식할 수 있음을 보이므로, GAN 학습이 비효율적일 수 있음을 시사한다고 저자들은 적습니다.
🔗 3. 후속 연구로의 연결
- 구조 안정화 : DCGAN 은 합성곱 구조 제약으로 학습 안정성을 높이고 판별기 특징을 분류에 재사용했습니다.
- 목적함수 교체 : WGAN 은 JS 발산 대신 Earth-Mover 거리를 써서 지지집합이 겹치지 않을 때의 기울기 소실과 모드 붕괴 문제에 대응했습니다.
- 표현 학습 : InfoGAN 은 잠재 코드와 생성 이미지 사이의 상호정보를 최대화해 해석 가능한 표현을 비지도로 학습했습니다.
- 조건부 이미지 변환 : Pix2Pix 는 조건부 GAN 과 L1 손실, U-Net 생성기, PatchGAN 판별기를 결합해 범용 이미지 대 이미지 변환을 구현했습니다.
💡 Key Takeaway 이 논문의 결론부는 사실상 GAN 연구 로드맵입니다. 조건부 생성, 추론 네트워크, 준지도 학습, 학습 안정화라는 네 갈래가 모두 여기서 출발했습니다.